Durante años, la segmentación de redes ha sido el eje que facilita el aislamiento de amenazas, la diferenciación de la calidad del servicio, la respuesta ante incidentes y su análisis, las auditorías de cumplimiento y muchas otras funciones clave de interoperabilidad. Sin embargo, mientras ensalzamos los principios de confianza cero y nos apresuramos a implantar la IA, ¿hemos descuidado este elemento esencial de la infraestructura de red que constituye la base de la ciberseguridad moderna y de las operaciones de servicio?
Anteriormente, en nuestra serie sobre fábricas de IA, definimos una fábrica de IA como una enorme inversión en almacenamiento, redes y computación destinada a satisfacer las necesidades de entrenamiento e inferencia de alto volumen y alto rendimiento. Para rentabilizar esta inversión, las fábricas de IA programan dinámicamente el uso de unidades de procesamiento gráfico (GPU) de alto valor y de recursos informáticos para llevar a cabo estas tareas de entrenamiento e inferencia. La programación de las GPU requiere diseñar varios «inquilinos» de servicios de IA por cada clúster de IA. Esto plantea un problema que muchos equipos de operaciones no ven venir hasta que, a menudo, ya es demasiado tarde.
Alineación de los recursos del clúster de la fábrica de IA con la segmentación de red
Dentro de un clúster de IA, podemos segmentar lógicamente los recursos según el contexto de cada inquilino, lo que permite establecer cuotas por inquilino, límites de consumo de recursos, medidas de seguridad para los sistemas host y controles de acceso basados en roles (RBAC) para la administración. Sin embargo, los servicios de red básicos que gestionan el tráfico de entrada y salida entre el clúster de IA y el resto de la red de la fábrica de IA no exponen los contextos de los inquilinos. Sin este contexto, la segmentación de red, piedra angular de la ciberseguridad en el centro de datos, opera a ciegas. Los métodos habituales para exponer los contextos de inquilino necesarios reducen considerablemente la capacidad de computación de alto valor de la fábrica de IA o ralentizan las rutas de red por debajo de los límites exigidos de latencia del servicio, ancho de banda o concurrencia. Nos vemos ante una falsa disyuntiva entre utilizar de forma eficiente los valiosos recursos de la fábrica de IA e integrar correctamente a los inquilinos en la red.
En las infraestructuras de nube pública, los diseños de red multiinquilino orquestados constituyen la base de todos los servicios de una región de nube y se implementan mediante nubes privadas virtuales (VPC). Esta segmentación de red virtualizada es clave para la seguridad y la medición del uso de los recursos. Los proveedores de nube pública mantienen esta función mediante equipos de desarrolladores de software de red y hardware de red especializado, incluidas las SmartNIC y las unidades de procesamiento de datos (DPU). Los clústeres de fábricas de IA en nubes públicas están diseñados para aprovechar la orquestación de la red VPC de la infraestructura subyacente. El coste de mantener las VPC es bastante elevado, pero constituye un elemento esencial del modelo de negocio de la nube pública.
La pregunta que surge es: ¿Cómo puede una organización maximizar su inversión en una fábrica de IA y programar dinámicamente las GPU y los recursos informáticos sin realizar el mismo nivel de inversión que un proveedor de nube pública?
El primer paso del sector en este recorrido fue utilizar la virtualización de servidores para crear máquinas virtuales (VM). Las VM utilizan el acceso directo al hardware para conectarse a redes segmentadas del centro de datos. Basta con colocar todas las máquinas virtuales en las mismas VLAN para poder seguir operando con normalidad si solo tenemos que ocuparnos de un único inquilino en un único clúster de IA.
Las máquinas virtuales también permiten abordar la segmentación de las GPU, ya que los proveedores de GPU ofrecen mecanismos para subdividir estos dispositivos en conjuntos de núcleos y memoria y asignarlos posteriormente a máquinas virtuales específicas. Sin embargo, la segmentación de los dispositivos GPU no es dinámica y requiere reiniciar la máquina virtual. Además, este diseño limita la posibilidad de crear un conjunto de recursos de GPU cuyo uso pueda medirse entre múltiples inquilinos. Estos son inconvenientes importantes de esta solución.
Alineación de la segmentación de red con clústeres de fábricas de IA multiinquilino
¿Qué ocurre con nuestros clústeres de fábricas de IA cuando dejan de poder prestar servicio a un único inquilino? El problema se traslada al centro de datos. De forma predeterminada, en los clústeres de fábricas de IA, a todo el tráfico de red saliente hacia el centro de datos se le aplica una traducción de direcciones de red de origen (SNAT) para asignarle la dirección IP del nodo concreto del clúster en el que se esté ejecutando la carga de trabajo en contenedores que emite la solicitud de red, lo que oculta de hecho el origen real. A continuación, el tráfico se origina desde el segmento de red en el que se implementó dicho nodo. En un clúster multiinquilino, esto implica que perdemos el contexto del inquilino y obtenemos un flujo mezclado de tráfico saliente de varios inquilinos que resulta imposible de clasificar, proteger, diagnosticar o auditar.
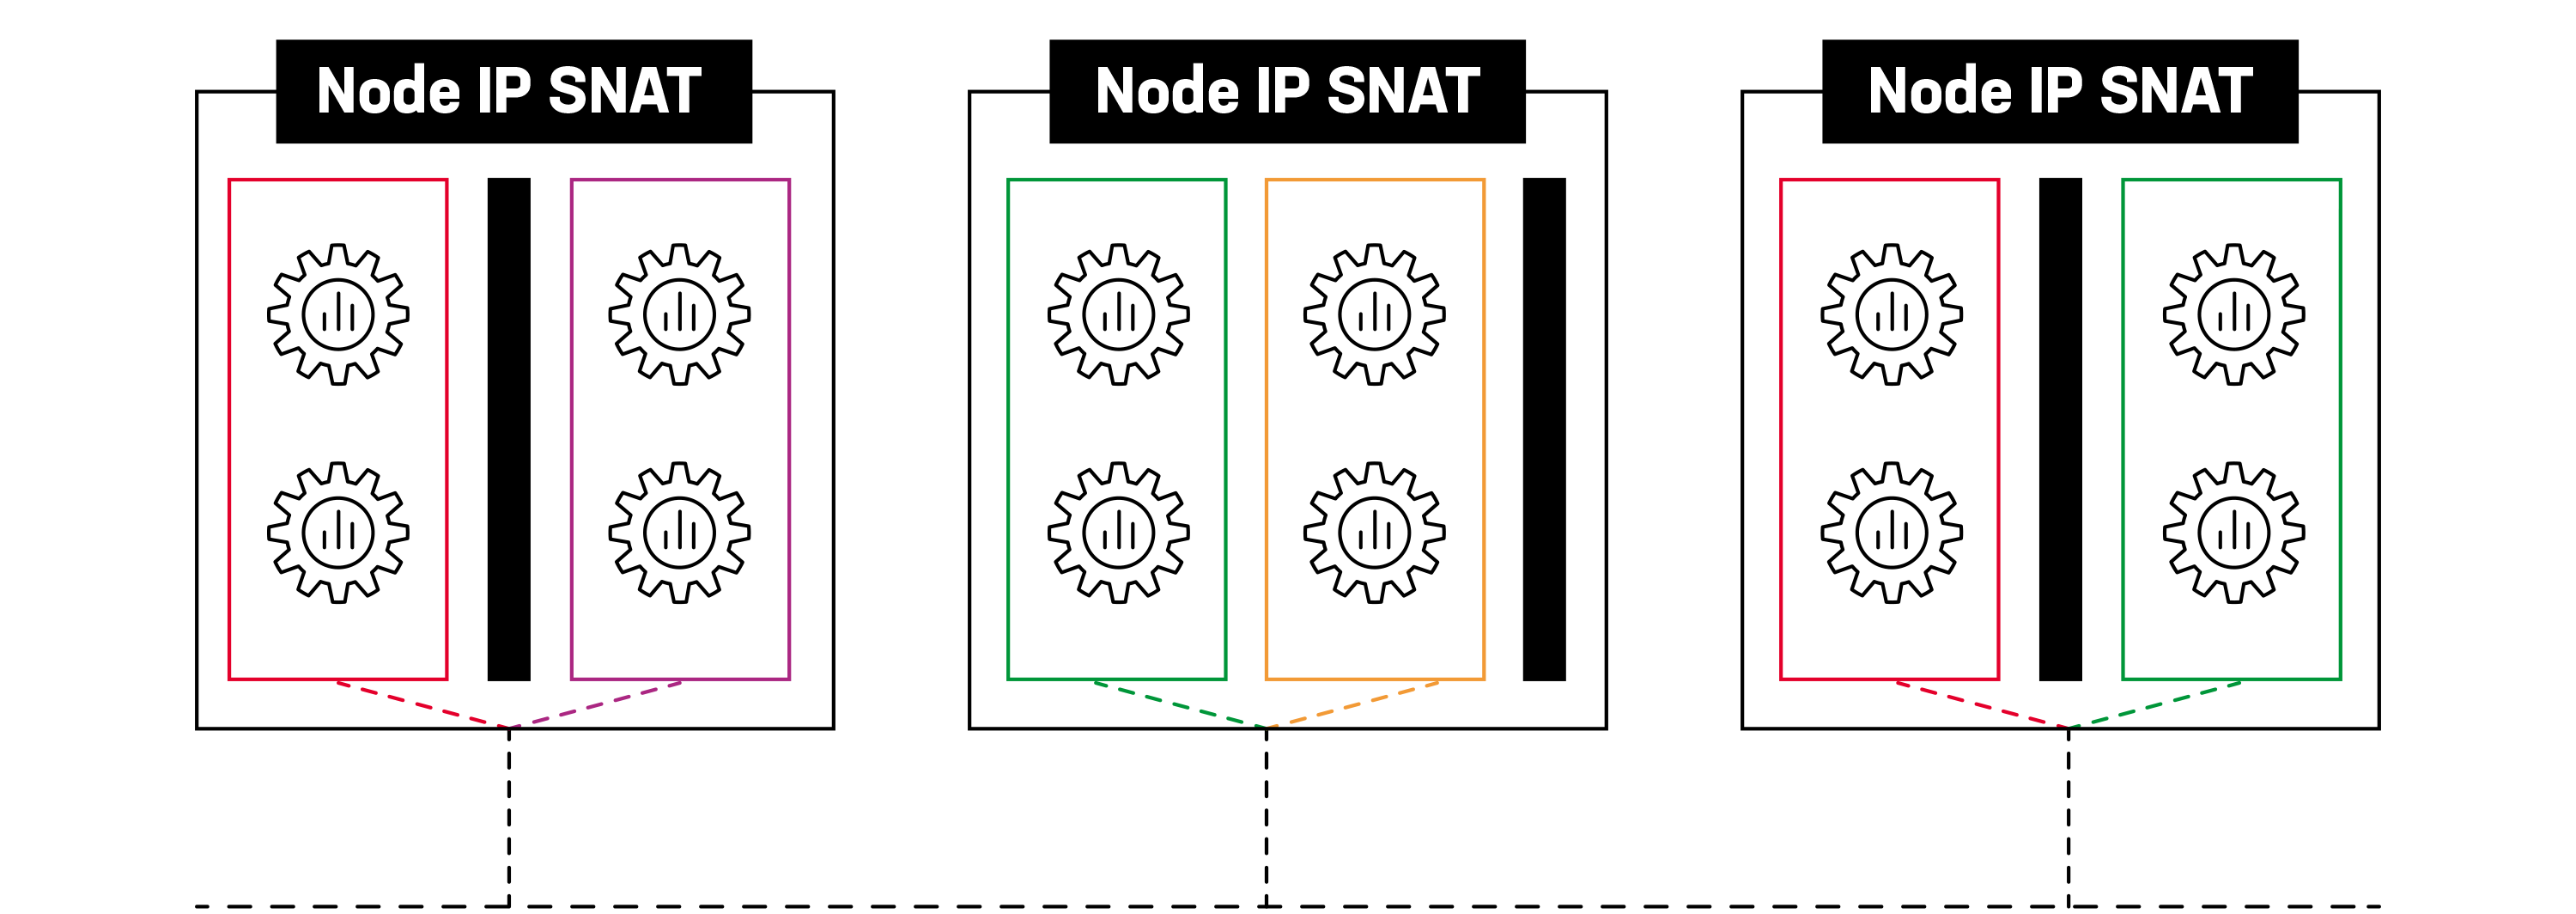
De forma predeterminada, el contexto del inquilino del clúster se pierde al salir.
Este problema se agrava cuando se incluye el tráfico entrante. Aunque este tráfico puede ser más fácil de gestionar, ya que procede de un centro de datos previamente segmentado, ¿cómo se correlaciona el tráfico entrante de un único inquilino con su tráfico saliente? La respuesta gira en torno a la generación aumentada por recuperación (RAG) y los servicios agénticos, que se comunican de forma intensiva para obtener datos externos y utilizar servicios externos. Esto requiere la colaboración de varios equipos, con ingenieros de plataforma y NetOps trabajando para identificar un problema que afecta a un cliente o intentando superar auditorías de seguridad.
Las empresas pueden preguntarse: «¿Por qué no podemos limitarnos a utilizar una tecnología de superposición de redes definidas por software (SDN) y crear redes VPC como hacen los proveedores de hiperescala?». Sin duda, es posible, pero esto traslada los costes al mantenimiento de las redes VPC basadas en SDN sobre la infraestructura existente del centro de datos. Si se desea una segmentación de capa 2 (por ejemplo, VxLAN), el problema pasa a ser la orquestación de los túneles con los conmutadores de la parte superior del rack y el aprovisionamiento de dichos conmutadores para que se ajusten a la segmentación de la red. Por este motivo, los proveedores de hiperescala optaron por las SmartNIC y pasaron a una orquestación a nivel de host a host, dejando las redes de los centros de datos rápidas y sin inteligencia.
La mayoría de las organizaciones no cuentan con profesionales especializados en programación de redes ni desean asumir una orquestación tan compleja a nivel de host, o simplemente no pueden renunciar a la visibilidad de la red troncal necesaria para garantizar la calidad del servicio. Las soluciones de enrutamiento de capa 3 (por ejemplo, IP) propuestas para estos problemas han llevado a los equipos de redes a convertir cada nodo del clúster de IA en un par de enrutamiento dinámico (BGP) del centro de datos, con varios reflectores de rutas que intentan proporcionar un aislamiento básico entre inquilinos mediante subredes IP. Esto también expone a los operadores a problemas de enrutamiento y auditorías de seguridad muy complejos, y ha provocado interrupciones en regiones enteras.
Segmentación de red orquestada y consciente del clúster para fábricas de IA
Las fábricas de IA deben planificar una solución de red con numerosas funcionalidades, programable, segura y de baja latencia, que sea escalable tanto en ancho de banda como en concurrencia. Los contextos de los tenants en la capa 2 (p. ej., VLAN, VxLAN) y la capa 3 (p. ej., subredes, interfaces IPSEC) deben extenderse desde el interior de un clúster hasta la red de la fábrica de IA. Las métricas de observabilidad, los registros y las herramientas de depuración deben estar a disposición de NetOps.
Tradicionalmente, muchas de estas soluciones de aislamiento y visibilidad de aplicaciones las proporciona F5 BIG-IP. F5 BIG-IP Container Ingress Services (CIS) detecta dinámicamente los servicios de Kubernetes y los expone a los centros de datos como servidores virtuales, un objeto de configuración con el que los administradores de BIG-IP estarán familiarizados por haberlo configurado para presentar servidores físicos y máquinas virtuales. Aunque BIG-IP sí ofrece gran parte de las prestaciones que buscamos en una solución, no gestiona el tráfico de salida del clúster de IA hacia la red de la fábrica de IA, algo necesario para mantener la segmentación.
Para abordar este problema, diseñamos F5 BIG-IP Next for Kubernetes, una solución para clústeres informáticos multiinquilino basada en nuestra plataforma de nueva generación BIG-IP Next.
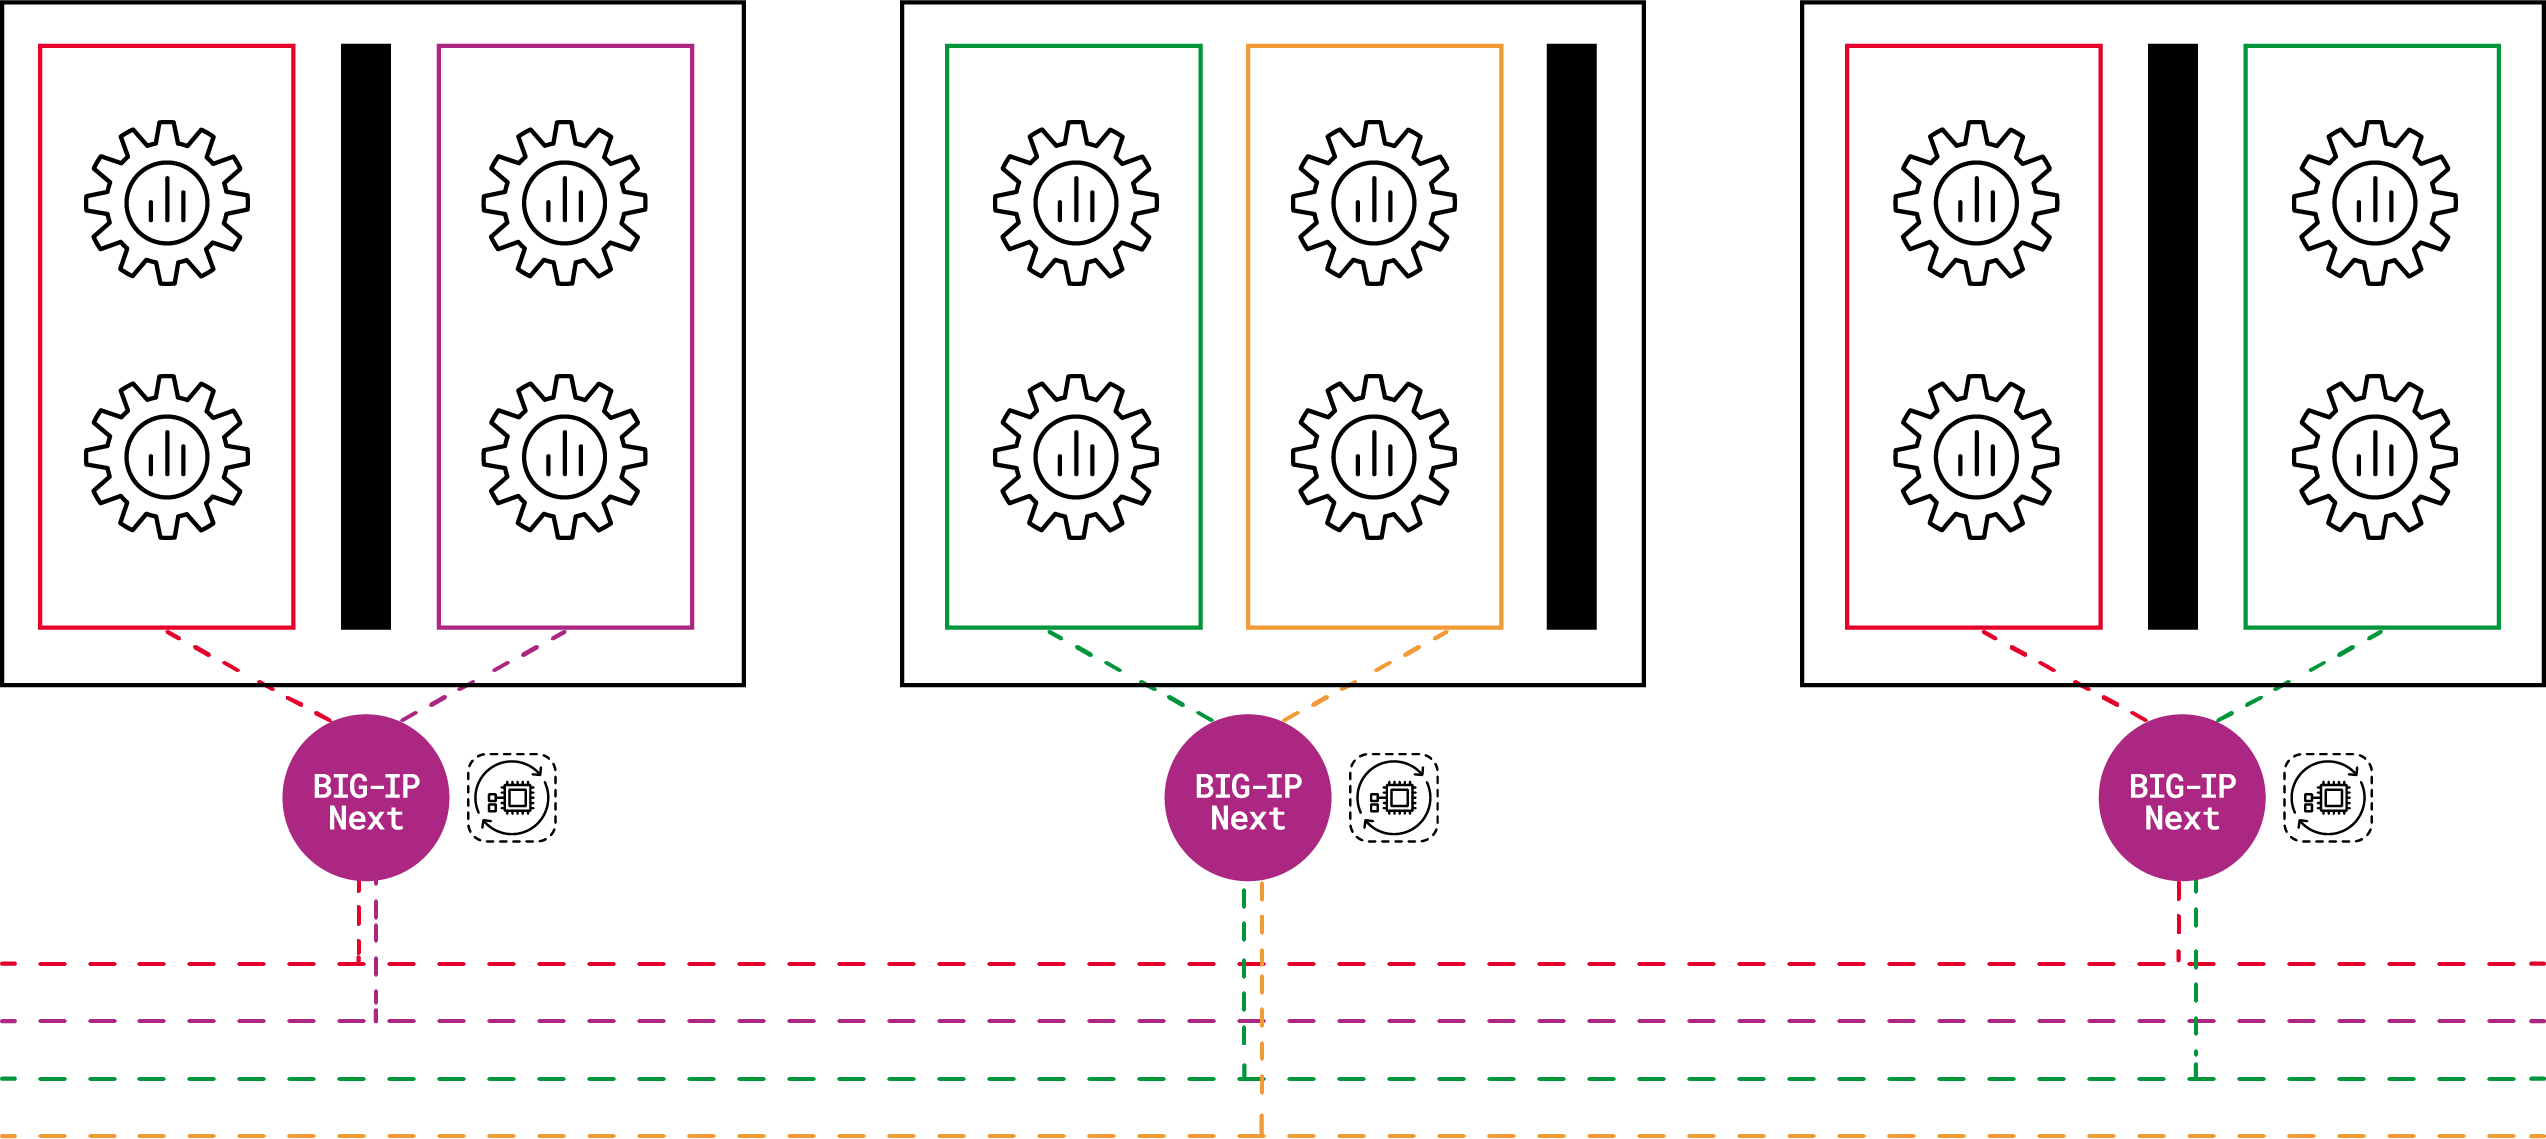
BIG-IP Next for Kubernetes permite a NetOps asociar los tenants del clúster a segmentos de red.
BIG-IP Next for Kubernetes se gestiona íntegramente a través del plano de control de Kubernetes y admite la autenticación de gestión de Kubernetes y el control de acceso basado en roles (RBAC) para todos los recursos declarados. Además, reconoce la tenencia de Kubernetes mediante espacios de nombres para permitir la segmentación de red necesaria tanto para el tráfico de entrada como para el de salida. Esto es fundamental para arquitecturas centradas en la orquestación, como las fábricas de IA.
BIG-IP Next for Kubernetes ofrece a los equipos de NetOps una forma simplificada de definir las correspondencias entre los espacios de nombres de Kubernetes y los segmentos de red. El emparejamiento dinámico de rutas entre la red de la fábrica de IA y las instancias de BIG-IP Next utiliza una sintaxis conocida para la configuración de rutas. Los equipos de NetOps cuentan con la capacidad exclusiva de solucionar de forma segura problemas en flujos de red activos para el tráfico de entrada y salida del clúster. Los equipos de SecOps disponen de listas de control de acceso (ACL) del cortafuegos para el tráfico de entrada y salida de cada inquilino del clúster, así como de funciones de protección contra ataques distribuidos de denegación de servicio (DDoS) y de prevención de intrusiones (IPS).
Para los equipos de ingeniería de plataformas, BIG-IP Next for Kubernetes libera recursos informáticos al descargar funciones de red como el procesamiento del tráfico de entrada y salida de datos, así como la NAT de origen y las funciones de cortafuegos. Esto ayuda a reducir los costes operativos, al tiempo que mantiene los servicios disponibles y eficientes.
BIG-IP Next for Kubernetes también es compatible con Kubernetes Gateway API, la primera API de entrada de la comunidad diseñada para funciones organizativas específicas de NetOps, ingeniería de plataformas, DevOps y MLOps. Mediante Gateway API, BIG-IP Next for Kubernetes amplía los servicios de entrada habituales basados en puertos de capa 4 o en rutas HTTP(S) de capa 7 con un conjunto de opciones para DevOps/MLOps, concretamente TCPRoute, UDPRoute, HTTPRoute, TLSRoute y GRPCRoute, todas ellas controladas mediante la misma automatización de CI/CD en los principales frameworks de IA.
Desde el punto de vista de la gestión, BIG-IP Next for Kubernetes permite que los equipos de NetOps, SecOps, ingeniería de plataformas, DevOps y MLOps colaboren eficazmente mediante declaraciones de la API de Kubernetes. Ofrece todo lo que cabe esperar de BIG-IP, pero desde la perspectiva de Kubernetes y con compatibilidad con la segmentación de red.
El auge de la DPU
Las unidades de procesamiento de datos (DPU) han ganado terreno de forma exponencial en las fábricas de IA. Como se explicó en una entrada anterior de nuestro blog perteneciente a la serie sobre fábricas de IA, una DPU es un procesador programable diseñado para gestionar el movimiento y el procesamiento de grandes volúmenes de datos mediante aceleración por hardware a la velocidad de línea de la red. Gracias a la innovación de productos de F5 y a la colaboración con NVIDIA, lanzamos BIG-IP Next for Kubernetes para descargar los flujos de datos del tráfico de entrada y salida, al tiempo que permite la segmentación de la red y ofrece funciones de seguridad mediante su implementación en las DPU NVIDIA BlueField-3 con las API DOCA de NVIDIA. Esto maximiza la inversión en una fábrica de IA al garantizar que los clústeres de IA reciban un suministro continuo de datos.
Fábricas de IA impulsadas por F5
Al invertir en fábricas de IA, es imprescindible garantizar que la infraestructura esté optimizada, sea eficiente y pueda escalar. F5 BIG-IP Next for Kubernetes, implementado en DPU NVIDIA BlueField-3, proporciona la segmentación de red necesaria para la programación dinámica de GPU y recursos informáticos, al tiempo que ofrece escalabilidad de alto rendimiento para maximizar el retorno de las inversiones en IA. Para obtener más información, póngase en contacto con F5 para comunicarse con su gestor de cuentas y su ingeniero o arquitecto de soluciones de F5.
¿Te interesa saber más sobre las fábricas de IA? Descubre otras en nuestra serie de artículos sobre fábricas de IA:
- ¿Qué es una fábrica de IA? ›
- Generación aumentada por recuperación (RAG) para fábricas de IA ›
- Optimice la gestión del tráfico para la ingesta de datos de fábricas de IA ›
- Conexión óptima de fuentes de datos en el edge con fábricas de IA ›
- La escalabilidad y la flexibilidad multinube respaldan las fábricas de IA ›
- La potencia y el significado de la DPU NVIDIA BlueField para las fábricas de IA ›
- Protección de API para fábricas de IA: el primer paso hacia la seguridad de la IA ›
- Las fábricas de IA producen las aplicaciones más modernas: aplicaciones de IA ›
Sobre el autor
Artículos relacionados del blog

Cree servicios públicos seguros, resilientes y preparados para la IA con F5 y AWS
Descubre cómo las organizaciones del sector público pueden modernizar de forma segura sus aplicaciones y soluciones de IA, al tiempo que gestionan los sistemas heredados, el cumplimiento normativo y el riesgo operativo.

Protección de los sistemas de IA: por qué la seguridad debe avanzar al ritmo de la innovación
Desde acelerar avances revolucionarios en medicina y educación hasta transformar la vida cotidiana, la IA está cambiando nuestra forma de vivir y trabajar. Pero también ofrece grandes oportunidades a los ciberdelincuentes.
Avanzar hacia la optimización digital tras la transformación
Descubre estrategias de optimización digital para garantizar políticas de seguridad coherentes, impulsar la madurez de la transformación digital y superar los retos de la transformación.
Proyecto de código abierto destacado: mayor observabilidad con F5 Cloud Logger iApp
En el punto de mira del código abierto: cómo aumentar la observabilidad. Lee el blog de F5 para descubrir cómo exportar fácilmente la telemetría de BIG-IP a plataformas modernas de análisis en la nube.
El estado de la entrega de aplicaciones en 2018: la transformación digital impulsa la automatización y la multinube pese a las preocupaciones de seguridad
Descubre las principales conclusiones del cuarto informe anual de F5 sobre el estado de la entrega de aplicaciones.
Estado de la entrega de aplicaciones en 2017: automatización, API y DevOps
Descubre el informe sobre el estado de la entrega de aplicaciones de 2017. Lee el blog retrospectivo de F5 sobre los inicios del auge de las redes declarativas y los flujos de DevOps.