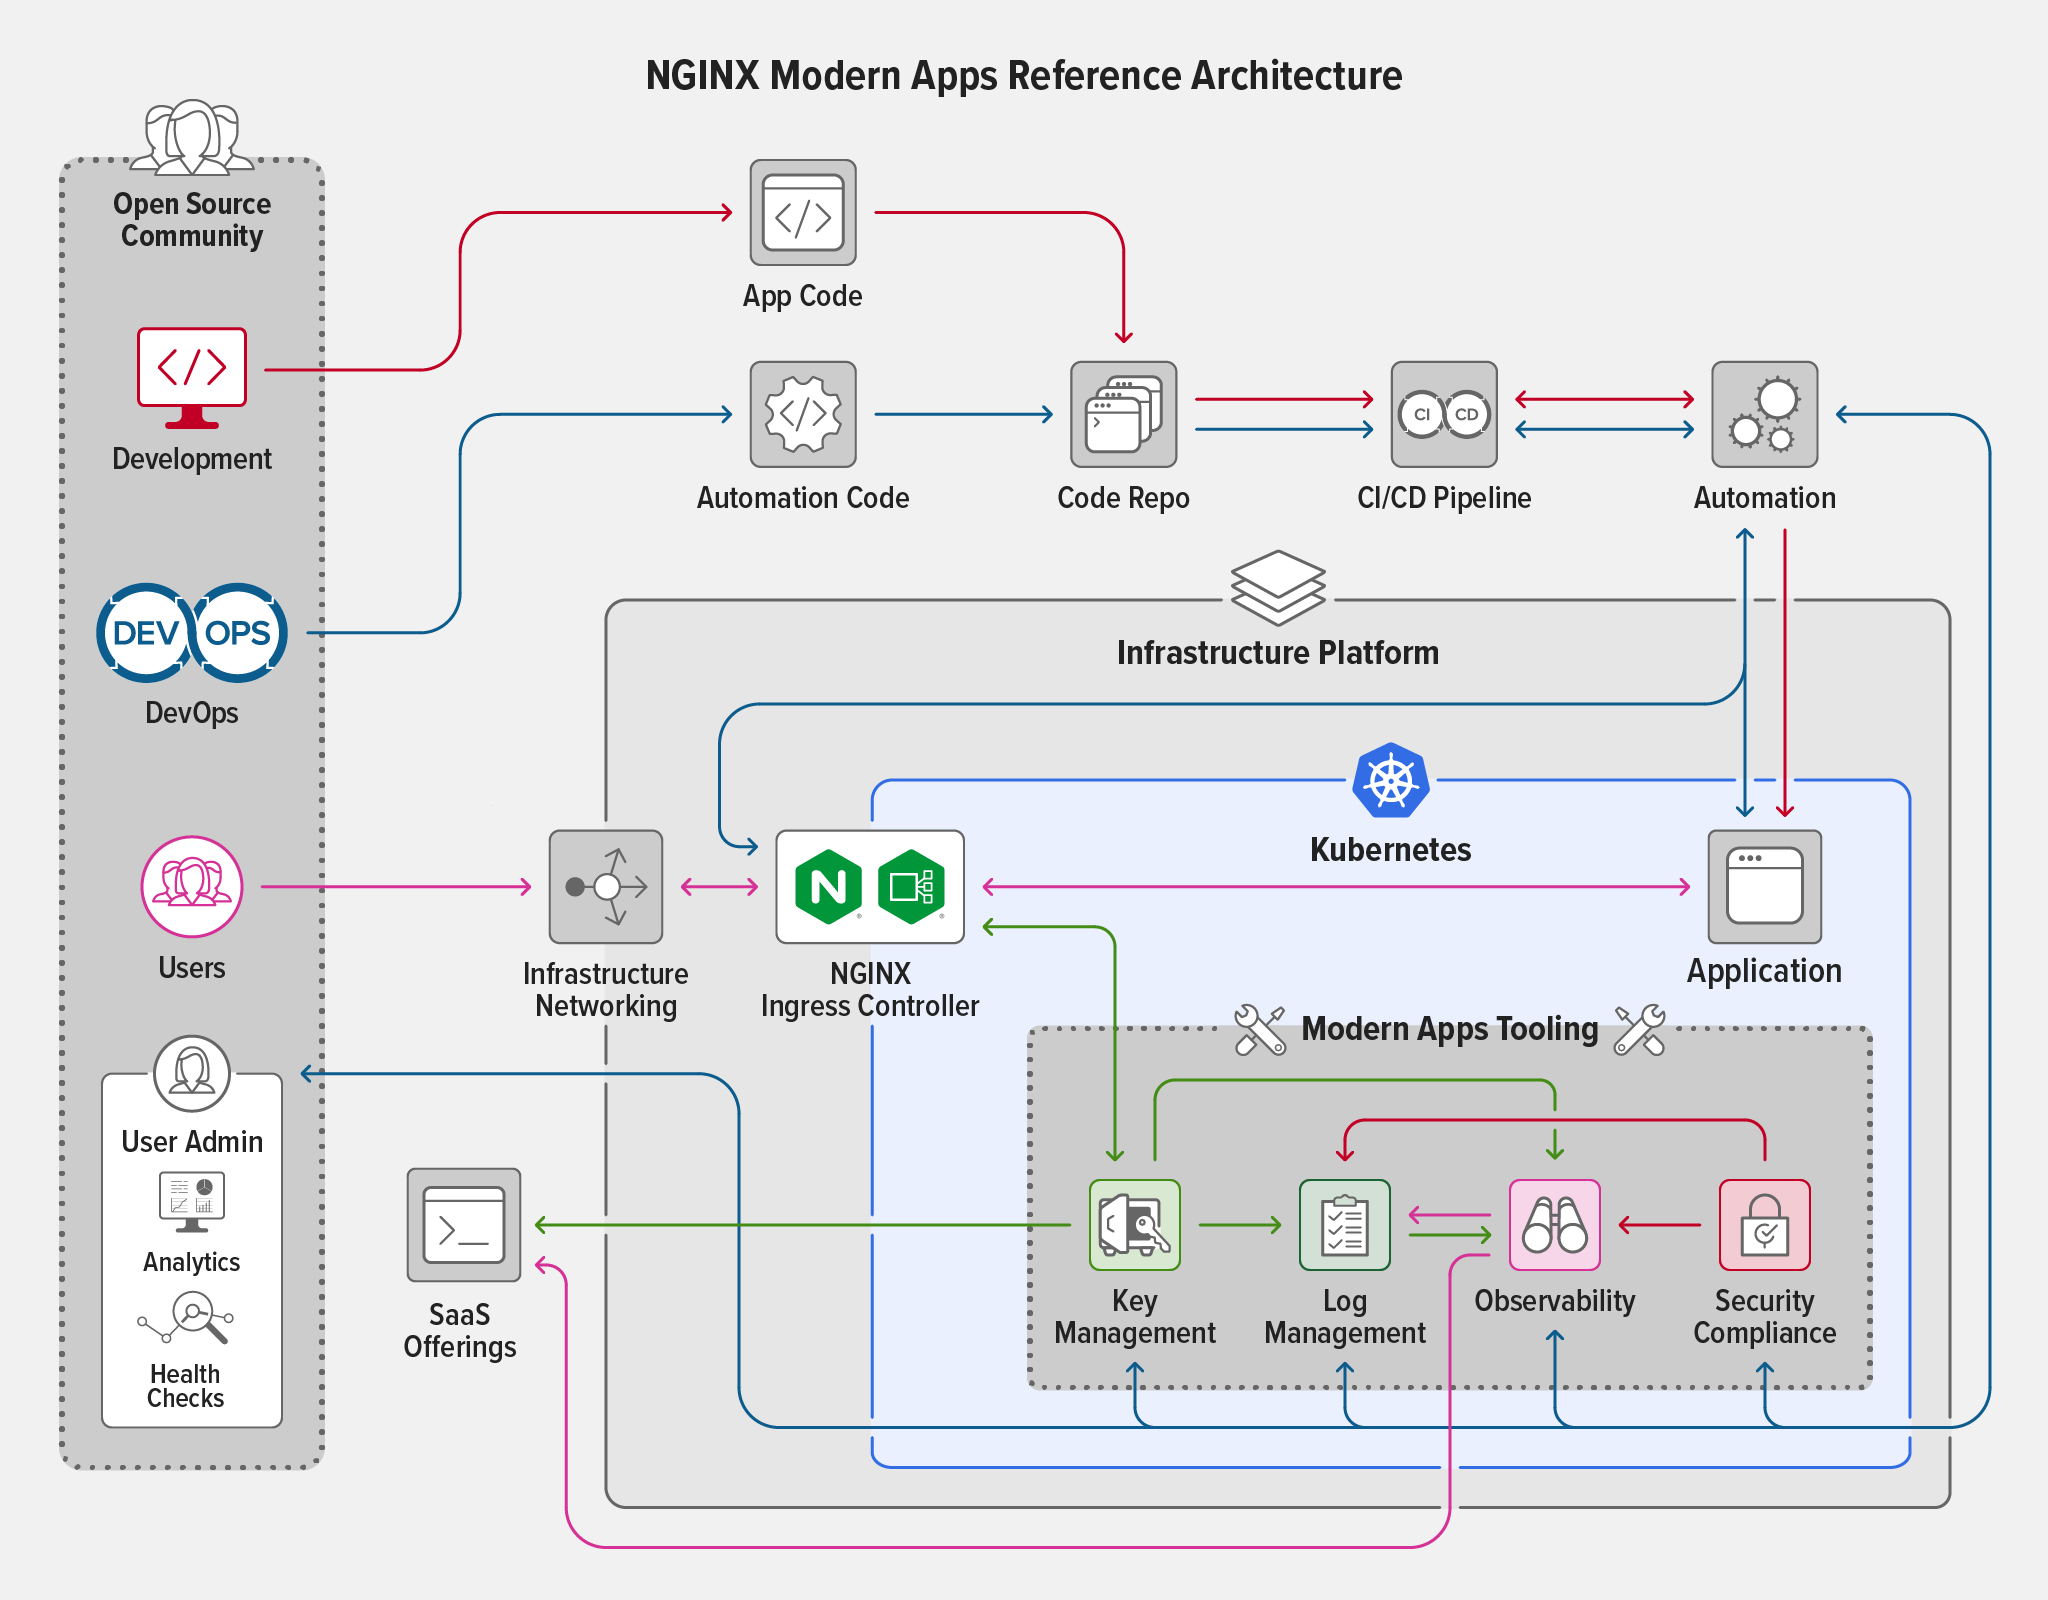
Fuimos claros respecto a nuestros objetivos de diseño cuando presentamos la Arquitectura de referencia para aplicaciones modernas (MARA) de NGINX en Sprint 2.0, en agosto de 2021. Queríamos crear un ejemplo de arquitectura de aplicaciones modernas que se ejecutara en Kubernetes y estuviera diseñada para ofrecer seguridad, escalabilidad, fiabilidad, supervisión e introspección. Este proyecto debía poder implementarse en distintas infraestructuras mediante un enfoque «plug and play» que permitiera combinar componentes funcionales sin dedicar demasiado tiempo a tareas de integración.
En los meses transcurridos desde Sprint, hemos seguido avanzando en nuestra hoja de ruta. Como en cualquier proyecto, hemos tenido éxitos y fracasos, y hemos incorporado nuestros logros a MARA, al tiempo que mantenemos una lista cada vez mayor de lecciones aprendidas. Esperamos evitar que otros se encuentren con los mismos problemas documentándolos y diseñando teniendo en cuenta estas lecciones.
Recientemente hemos alcanzado un hito con MARA versión 1.0.0, que reorganiza el directorio del proyecto y modifica el proceso de creación y eliminación del entorno. Hemos eliminado el código duplicado, creado una estructura de directorios que permite incorporar fácilmente futuras ampliaciones y estandarizado los scripts de gestión. Dado que esta versión marca un momento importante en la historia de MARA, queríamos hacer una pausa para informar a la comunidad sobre nuestros avances, destacar algunas de las lecciones aprendidas que consideramos más importantes y ofrecer información sobre nuestra hoja de ruta de cara al futuro.
Telemetría: métricas, registro y trazabilidad
Los principales colaboradores de MARA tienen experiencia en la ejecución de software a gran escala y saben lo que implica prestar servicios desde las perspectivas operativa, técnica y de gestión. Conocen esa angustiosa sensación que se tiene cuando una aplicación no funciona como debería y no hay una forma sencilla de determinar exactamente cuál es el problema. Una cita que circula por el mundo de DevOps resume la cuestión de forma concisa: «Depurar microservicios es como resolver una serie de misterios de asesinato».
Teniendo esto en cuenta, convertimos la incorporación de la observabilidad en una prioridad absoluta de nuestra hoja de ruta a corto plazo. En este contexto, la observabilidad incluye la gestión de registros, las métricas y los datos de trazabilidad. Sin embargo, no basta con recopilar datos: hay que poder analizarlos en profundidad y tomar decisiones fundamentadas sobre lo que está ocurriendo en el entorno.
Nuestro análisis de las opciones de rastreo nos llevó a OpenTelemetry (OTEL), ya que admite todo el espectro de datos de telemetría: registros, métricas y trazas. Ideamos una implementación en la que el agente de OTEL recopila, procesa y elimina los duplicados de todos los datos de rastreo antes de enviarlos al recopilador de OTEL para su agregación y exportación, con un sistema de visualización al final del flujo de trabajo que permite aprovechar los datos. Este enfoque ofrece a los usuarios la mayor variedad de opciones para visualizar y analizar los datos, al tiempo que aprovecha el estándar OTEL para simplificar las etapas anteriores (recopilación, agregación, etc.).
Desarrollamos la implementación en dos fases:
- Implementar el OpenTelemetry Operator for Kubernetes para gestionar un recopilador de OTEL en el entorno
- Instrumenta la aplicación Bank of Sirius para que emita trazas y métricas
La versión original de MARA utilizaba Elasticsearch junto con Filebeat para el registro y, aunque nos planteamos sustituirlos por Grafana Loki, decidimos mantener la opción original por el momento. En cuanto a las métricas, nos dimos cuenta de que debíamos revisar el despliegue original basado en Prometheus y Grafana, sustituyendo la configuración personalizada de Prometheus que habíamos utilizado inicialmente por el chart de Helm kube-prometheus-stack, mantenido por la comunidad, que despliega un entorno completo de Prometheus, incluidos Grafana, exportadores de nodos y una serie de paneles preconfigurados y objetivos de recopilación adecuados para gestionar un entorno de Kubernetes. A esto añadimos algunos paneles adicionales para F5 NGINX Ingress Controller y la aplicación Bank of Sirius.
Este es solo un breve resumen de la ingente cantidad de trabajo necesaria para implementar OTEL. Para evitar que otros tengan que enfrentarse a la misma pronunciada curva de aprendizaje, hemos documentado todo el proceso en Integración de OpenTelemetry en la arquitectura de referencia de aplicaciones modernas: informe de progreso en nuestro blog.
Opciones de despliegue – Kubeconfig
En la versión inicial de MARA elegimos Amazon Elastic Kubernetes Service (EKS) como entorno de despliegue. Desde entonces, muchos usuarios nos han comentado que, por motivos de coste, quieren ejecutar MARA en entornos «locales» que requieran menos recursos, como un laboratorio o una estación de trabajo. La portabilidad era uno de los objetivos principales del proyecto original (y sigue siéndolo), así que esta era nuestra oportunidad de demostrar que podíamos conseguirlo. Para facilitar la tarea, decidimos diseñar un procedimiento de despliegue que pudiera ejecutarse en cualquier clúster de Kubernetes que cumpliera unos requisitos mínimos.
Como primer paso, añadimos a MARA un nuevo proyecto de Pulumi que lee un archivo kubeconfig para comunicarse con el clúster de Kubernetes. Este proyecto actúa como intermediario entre los proyectos de Kubernetes de Pulumi y los proyectos de infraestructura (por ejemplo, los proyectos para AWS y Digital Ocean). En la práctica, la creación del proyecto kubeconfig facilita la integración de nuevos proyectos de infraestructura. Si un proyecto de infraestructura puede proporcionar al proyecto kubeconfig un archivo kubeconfig, el nombre del clúster y el contexto del clúster, el resto del procedimiento de despliegue de MARA funciona sin problemas.
Para nuestras pruebas, utilizamos varias distribuciones de Kubernetes fáciles de instalar y con pocos requisitos de CPU y memoria, entre ellas K3s, Canonical MicroK8s y minikube. Todas las distribuciones se implementaron en una máquina virtual (VM) con Ubuntu 21.10, 2 CPU y 16 GB de RAM. Además, todas se configuraron para proporcionar volúmenes persistentes y compatibilidad con Kubernetes LoadBalancer.
La parte más difícil de este proceso fue trabajar con el registro privado utilizado para el controlador de entrada NGINX personalizado que forma parte del proyecto. (Tenga en cuenta que, al implementar MARA, puede utilizar tanto el controlador de entrada NGINX estándar basado en NGINX Open Source o NGINX Plus como este controlador de entrada NGINX personalizado). Descubrimos que teníamos que desvincular nuestra lógica de registro de Amazon Elastic Container Registry (ECR) para adoptar un enfoque más independiente de la plataforma, una tarea que está actualmente en curso. También nos dimos cuenta de que nuestra lógica para obtener el nombre de host de la dirección de salida era muy específica de AWS Elastic Load Balancing (ELB) y que debía reescribirse para adaptarla a otros casos de uso.
Los scripts de gestión de MARA y los proyectos de Pulumi utilizan actualmente una lógica específica para sortear los problemas descritos anteriormente. Por ahora, las implementaciones basadas en la configuración de Kubernetes deben utilizar NGINX Ingress Controller (basado en NGINX Open Source o NGINX Plus) de los registros oficiales de NGINX.
Hemos añadido varios parámetros de ajuste a los archivos de configuración de MARA para adaptarlos a implementaciones locales que no disponen de los recursos necesarios para una implementación en la nube. La mayoría de los parámetros están relacionados con el número de réplicas solicitadas para los distintos componentes de Elastic Stack. A medida que avancen las pruebas, se añadirán más parámetros para ajustar MARA en función de las limitaciones de recursos del entorno de implementación.
Con estos cambios implementados, podemos realizar correctamente despliegues en K3s, MicroK8s y Minikube, y hemos probado satisfactoriamente la lógica en Azure Kubernetes Service (AKS), Digital Ocean, Google Kubernetes Engine, Linode y Harvester de Rancher. Para obtener más información, consulte la página de estado de proveedores de MARA y MARA: ahora disponible en una estación de trabajo cerca de usted en nuestro blog.
Colaboración con socios
Nuestros socios se han mostrado muy receptivos y han respaldado firmemente nuestro trabajo con MARA. Muchos de ellos se han puesto en contacto con nosotros para obtener más información sobre el proyecto, preguntar cómo pueden aprovecharlo en sus productos o incluso añadir funcionalidades.
Elegimos Pulumi como parte fundamental de MARA por su facilidad de uso y su compatibilidad con Python. Este último es un lenguaje tan popular que permite que una amplia comunidad comprenda fácilmente el código de MARA. Además, la activa comunidad de Pulumi y su implicación en el proyecto sirvieron como modelo para la participación comunitaria que esperamos lograr con MARA.
A finales de 2021, colaboramos con Sumo Logic para integrar MARA en su solución de monitorización en la nube con NGINX Ingress Controller. Esta fue una oportunidad para poner a prueba nuestra afirmación de que MARA admite componentes intercambiables. El reto consistía en sustituir Grafana, Prometheus y Elastic en MARA por la solución de Sumo Logic. Nos complació poder implementar correctamente la solución utilizando la misma lógica que empleamos en otras implementaciones y configurarla no solo para conectarse al SaaS de Sumo Logic, sino también para recopilar métricas de nuestro entorno.
Como parte de nuestro trabajo con OpenTelemetry, colaboramos con Lightstep y reconfiguramos fácilmente nuestro recopilador de OTEL para exportar trazas y métricas a la solución SaaS de Lightstep. Es un ámbito que nos interesa seguir investigando, ya que creemos firmemente que OTEL es el futuro de la observabilidad.
Lecciones aprendidas… hasta ahora
La principal lección que hemos aprendido hasta ahora es la conveniencia de adoptar un enfoque modular. El trabajo con Sumo Logic demuestra que podemos combinar con éxito los componentes de MARA. Esperamos obtener una mayor confirmación a medida que integremos OTEL más plenamente en el entorno. Ya mencionamos que estamos considerando sustituir Elasticsearch por Grafana Loki como entorno de gestión de registros, ya que reduce los recursos que consume la pila. Dicho esto, abogamos por una «modularidad pragmática» en lugar de llegar al extremo de convertirlo todo en un microservicio. Por ejemplo, aunque tiene sentido disponer de un servicio especializado capaz de procesar los registros de muchas aplicaciones, no está tan claro que sean necesarios microservicios independientes para la recopilación, el almacenamiento y la visualización de registros.
También hemos aprendido que resulta útil establecer los valores predeterminados incluyéndolos explícitamente en la configuración, en lugar de limitarse a omitir el parámetro correspondiente. Esto facilita la labor de los administradores de dos maneras: no tienen que recordar los valores predeterminados y pueden cambiarlos fácilmente con solo modificar un parámetro que ya aparece con la sintaxis correcta y en el lugar adecuado de la configuración.
Otra dura lección que aprendimos es que algunas soluciones son populares no porque sean las mejores, sino porque son las más fáciles de instalar o cuentan con el mejor tutorial. Por eso es tan importante cuestionar nuestras propias suposiciones y consultar con los compañeros durante el proceso de diseño: una cultura de comunicación abierta contribuye en gran medida a detectar y solucionar los problemas desde el principio.
Dicho esto, en varias ocasiones implementamos una lógica que funcionaba, pero que nos dejaba sin margen de maniobra o provocaba otros problemas. Por ejemplo, cuando empezamos a desplegar aplicaciones mediante Pulumi, utilizábamos manifiestos YAML para los ConfigMaps, y recurríamos a las transformaciones de Pulumi para actualizar las variables. Funcionaba, pero no era lo ideal por varios motivos, entre ellos la dificultad de mantenimiento. En la siguiente iteración, mejoramos la legibilidad y la facilidad de mantenimiento del código utilizando kube2pulumi para transformar los manifiestos en código de Pulumi que después podíamos usar para crear los ConfigMaps.
Otra lección surgió cuando una fusión introdujo configuraciones no válidas en el YAML de despliegue. Nos vimos obligados a reescribir y revisar minuciosamente grandes partes del YAML para asegurarnos de que el código fuera sintácticamente correcto y se comportara como queríamos, un proceso frustrante y laborioso. Para evitar problemas en el futuro, ahora hemos automatizado tanto el linting y la validación de YAML genérico como los específicos de Kubernetes durante el proceso de envío de cambios a GitHub.
Por último, desde el principio nuestro objetivo ha sido garantizar que nuestra rama principal siempre se pueda ejecutar. Resulta frustrante clonar un proyecto nuevo y tener que resolver un problema que los responsables del mantenimiento han introducido en la rama principal. Por desgracia, no siempre lo hemos conseguido, como demuestran estos ejemplos relacionados con el submódulo Bank of Sirius:
- Por error, olvidamos cambiar el esquema de la URL de ssh:// a https://. Esto no supuso ningún problema para nosotros, porque todos usamos
sshpara conectarnos a GitHub. Sin embargo, los usuarios que no tenían una clave SSH para GitHub recibieron una avalancha de mensajes de error al intentar inicializar el submódulo. - Una versión de los scripts de gestión dependía de un paquete común que supusimos erróneamente que estaría instalado en los equipos de todo el mundo, como lo está en los nuestros.
- Durante una reescritura de la lógica de inicio, olvidamos incluir una comprobación del código fuente del submódulo. El submódulo contiene los manifiestos necesarios para desplegar Bank of Sirius y, por desgracia, los errores y avisos que se generaban cuando estos manifiestos no estaban disponibles eran tan poco claros que nos embarcaron en una odisea de varios días depurando comportamientos extraños antes de descubrir la causa raíz.
Próximos pasos
Tenemos grandes planes para los próximos meses de desarrollo, entre ellos, la refactorización de la compilación de NGINX Ingress Controller, la publicación en el registro y la lógica del nombre de host y la dirección IP de Ingress.
Algo que hemos observado cada vez que ponemos en marcha MARA es la rapidez con la que empezamos a detectar análisis y ataques contra NGINX Ingress Controller. Esto nos ha llevado a comenzar a integrar NGINX Ingress Controller con NGINX App Protect WAF en MARA. Esto plantea el reto y la oportunidad de determinar la mejor forma de gestionar los registros generados por App Protect.
Otro cambio que tenemos previsto realizar en los próximos meses es hacer que todos los módulos obtengan los secretos de Kubernetes, en lugar de obtenerlos tanto de Pulumi como de Kubernetes. De este modo, todos los módulos utilizarán un repositorio de secretos común y el administrador podrá controlar cómo se incorporan los secretos. Estamos desarrollando un nuevo módulo que leerá los secretos de un repositorio elegido por el usuario y creará los secretos de Kubernetes correspondientes.
Actualmente, MARA incluye una herramienta para generar carga que es una versión mejorada y ligeramente modificada de la herramienta basada en Locust que incorpora la aplicación original Bank of Anthos, a partir de la cual creamos la bifurcación Bank of Sirius. La nueva herramienta de pruebas que estamos desarrollando, Cicada Swarm, no solo genera carga, sino que también supervisa y notifica cuándo las métricas superan los umbrales que hayas establecido, lo que la convierte en un marco para realizar pruebas rápidas de rendimiento de productos de software en la nube. Utiliza técnicas de paralelización para ofrecer resultados de pruebas con el nivel de confianza que necesitas, una mayor precisión y análisis de regresión personalizables que permiten determinar si las compilaciones de tus canalizaciones de CI/CD se han completado correctamente o han fallado.
Por último, no podemos hablar de pruebas de carga sin explicar cómo vamos a medir su impacto, lo que nos lleva de nuevo a la telemetría. Nos entusiasma el potencial de OpenTelemetry y esperamos contar pronto con una implementación más completa. Incluso sin una implementación completa, nuestro objetivo es poder ejecutar una prueba, medir su impacto y tomar decisiones operativas basándonos en lo que nos indiquen los datos.
Como siempre, agradecemos vuestros pull requests, informes de incidencias y comentarios. Nuestro objetivo con MARA es inspirar a la comunidad para que colabore debatiendo, probando, evaluando y perfeccionando distintas soluciones posibles, con el fin de comprender mejor cómo desplegar y gestionar una aplicación moderna.
Publicaciones relacionadas
Esta publicación forma parte de una serie. A medida que vayamos incorporando nuevas funcionalidades a MARA, publicaremos todos los detalles en el blog:
- Una nueva arquitectura de referencia de código abierto para aplicaciones modernas
- Integración de OpenTelemetry en la arquitectura de referencia para aplicaciones modernas: informe de progreso
- MARA: ahora disponible en una estación de trabajo cerca de ti
- Presentamos la versión 1.0.0 de la arquitectura de referencia de NGINX para aplicaciones modernas (esta publicación)
Sobre el autor
Artículos relacionados del blog

Únete a F5 NGINX en AppWorld 2024
Descubre las numerosas razones para asistir al evento insignia de F5, que incluirá un emocionante anuncio sobre la cartera de productos NGINX.
Rotación de certificados SSL/TLS sin reinicios en NGINX Open Source
La función de diccionario compartido permite configurar NGINX sin necesidad de reiniciarlo al renovar los certificados SSL/TLS.
Exposición de APIs en Kubernetes
La unidad 2 de Microservices March 2022 se centra en cómo exponer tus API en Kubernetes. Aquí tienes enlaces a los recursos que necesitas: la retransmisión en directo del 14 de marzo, artículos de blog y otros recursos de preparación, y el laboratorio práctico «Protege las API de Kubernetes mediante la limitación de solicitudes».
NGINX Sprint 2.0: visión clara, código renovado y nuevos compromisos con el código abierto
Hoy, en NGINX Sprint 2.0, anunciamos cómo respaldaremos nuestra visión del futuro de las aplicaciones modernas con una mayor presencia en la comunidad de código abierto, incluida la participación en el proyecto comunitario Kubernetes, nuevos proyectos de software de código abierto y la arquitectura de referencia para aplicaciones modernas.
Presentamos NGINX Plus R22
NGINX Plus R22 incorpora nuevas funcionalidades, como la compatibilidad con OCSP para verificar la revocación de certificados en TLS mutuo, el uso de varios proveedores de identidad OIDC en una configuración, el seguimiento en tiempo real de la limitación de solicitudes y conexiones en el panel de NGINX Plus y mejoras en NGINX JavaScript.
Presentamos NGINX Plus R17
NGINX Plus R17 incorpora compatibilidad con la limitación de velocidad en dos fases y con TLS 1.3, la versión más reciente del protocolo Transport Layer Security. La configuración de OpenID Connect es más sencilla y NGINX ModSecurity WAF es el doble de rápido que antes. También se ha actualizado el módulo JavaScript de NGINX.