Cuando presentamos el proyecto de arquitectura de referencia de NGINX para aplicaciones modernas (MARA) el pasado otoño en Sprint 2.0, hicimos hincapié en que no queríamos que fuera un «juguete», como algunas arquitecturas, sino una solución «sólida, probada y lista para desplegarse en aplicaciones de producción reales que se ejecutan en entornos de Kubernetes». Para un proyecto así, las herramientas de observabilidad son un requisito imprescindible. Todos los miembros del equipo de MARA hemos experimentado de primera mano cómo la falta de visibilidad sobre el estado y el rendimiento convierte el desarrollo y la entrega de aplicaciones en una experiencia frustrante. Enseguida llegamos al consenso de que MARA debía incluir instrumentación para la depuración y el seguimiento de trazas en un entorno de producción.
Otro de los principios rectores de MARA es la preferencia por las soluciones de código abierto. En esta entrada, describimos cómo nuestra búsqueda de una herramienta de observabilidad multifuncional y de código abierto nos llevó a OpenTelemetry, y después detallamos las ventajas e inconvenientes, las decisiones de diseño, las técnicas y las tecnologías que utilizamos para integrar OpenTelemetry con una aplicación de microservicios desarrollada con Python, Java y NGINX.
Esperamos que conocer nuestras experiencias os ayude a evitar posibles dificultades y a acelerar vuestra adopción de OpenTelemetry. Tened en cuenta que esta publicación es un informe de progreso cuya vigencia es limitada: prevemos que las tecnologías que comentamos alcancen la madurez en el plazo de un año. Además, aunque señalamos las carencias actuales de algunos proyectos, agradecemos enormemente todo el trabajo que se está realizando en el ámbito del código abierto y nos entusiasma ver cómo avanza.
Nuestra aplicación
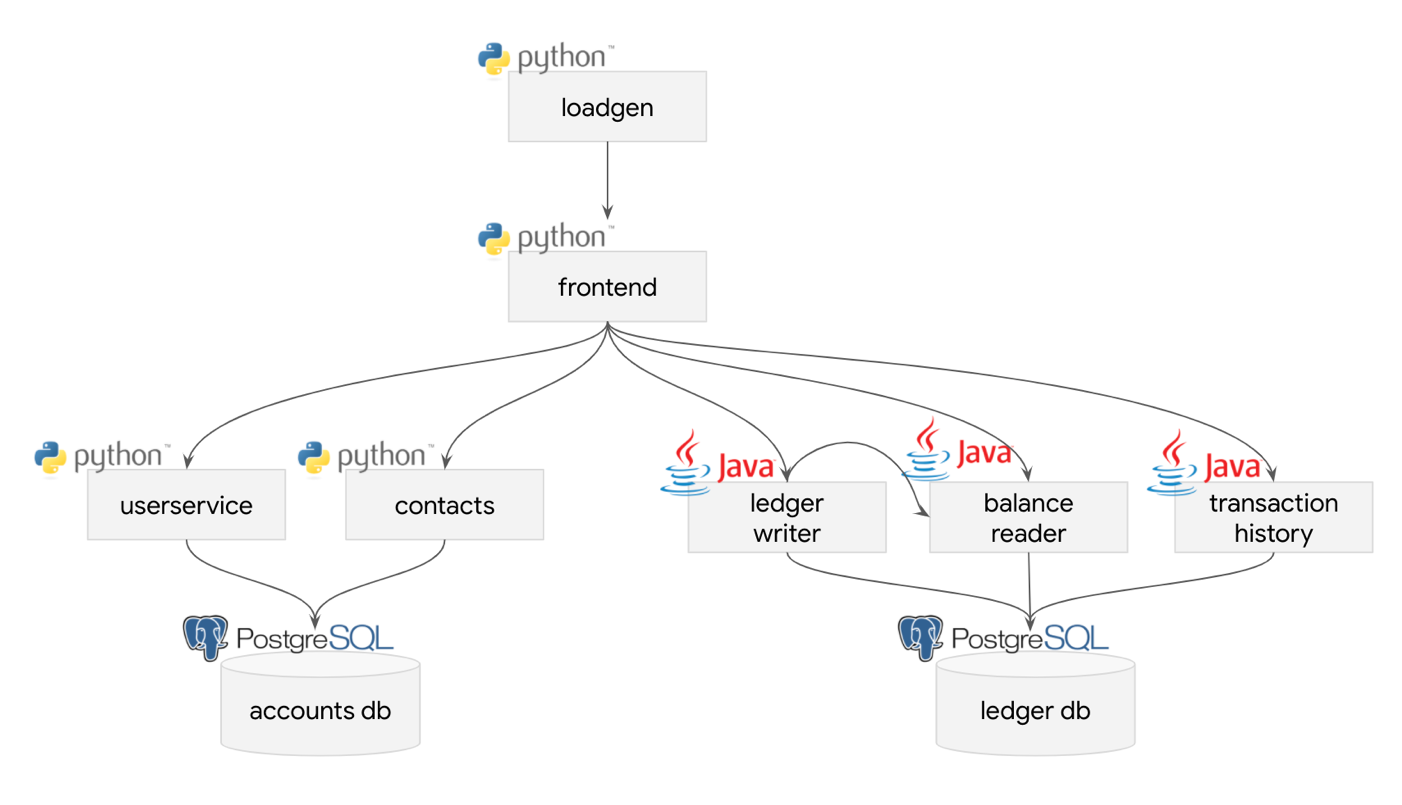
Como aplicación para integrar con una solución de observabilidad, elegimos Bank of Sirius, nuestra bifurcación de Bank of Anthos, la aplicación de ejemplo de Google. Es una aplicación web con una arquitectura de microservicios que se puede desplegar mediante infraestructura como código. Esta aplicación se puede mejorar de muchas maneras en cuanto a rendimiento y fiabilidad, pero es lo bastante madura como para considerarse una aplicación brownfield. Por ello, creemos que es un buen ejemplo para mostrar cómo integrar OpenTelemetry en una aplicación, porque, en teoría, el rastreo distribuido aporta información valiosa sobre las deficiencias de la arquitectura de una aplicación.
Como se muestra en el diagrama, los servicios que sustentan la aplicación son relativamente sencillos.
Cómo elegimos OpenTelemetry
El camino que nos llevó a elegir OpenTelemetry fue bastante sinuoso y constó de varias etapas.
Crear una lista de funcionalidades deseadas
Antes de evaluar las herramientas de observabilidad de código abierto disponibles, identificamos qué aspectos de la observabilidad nos interesaban. A partir de nuestras experiencias previas, elaboramos la siguiente lista.
- Registro de logs – Tal como lo utilizamos aquí, este término se refiere a la generación de los conjuntos tradicionales de mensajes de las aplicaciones, separados por saltos de línea; la aplicación Bank of Sirius estructura sus logs en formato Bunyan
- Trazabilidad distribuida – Tiempos y metadatos de cada componente del conjunto de la aplicación, como los que proporcionan los proveedores de gestión del rendimiento de aplicaciones (APM)
- Métricas – Mediciones recopiladas durante un periodo de tiempo y representadas gráficamente como series temporales
- Agregación y notificación de excepciones y errores – Una recopilación de las excepciones y los errores más frecuentes, que debe permitir búsquedas para que podamos determinar qué errores de la aplicación son los más habituales
- Comprobaciones de estado – Sondeos periódicos enviados a los servicios para determinar si funcionan correctamente dentro de la aplicación
- Introspección del estado de ejecución – Un conjunto de API visibles solo para los administradores que devuelven información sobre el estado de ejecución de la aplicación
- Volcados de memoria heap/core – Instantáneas completas del estado de un servicio en tiempo de ejecución; lo importante para nuestros fines es la facilidad con la que se pueden obtener estos volcados bajo demanda o cuando un servicio falla
Comparación de las funcionalidades de las herramientas con la lista de características deseadas
Por supuesto, no esperábamos que una sola herramienta o enfoque de código abierto incluyera todas estas características, pero al menos nos proporcionó una referencia ideal con la que comparar las herramientas disponibles. Consultamos la documentación de cada herramienta para averiguar cuáles de las siete características de nuestra lista de deseos ofrecía. La tabla resume nuestras conclusiones.
Tecnología Registro de eventos Trazado distribuido Métricas Agregación de errores Comprobaciones de estado Introspección en tiempo de ejecución Volcados de memoria heap/coreELK + Elastic APM ✅ ✅ ✅ ✅ ✅ ❌ ❌Grafana ✅ ✅ ✅ ✅ ✅ ❌ ❌Graylog ✅ ❌ ❌ ❌ ❌ ❌ ❌Jaeger ❌ ✅ ❌ ✅ ❌ ❌ ❌OpenCensus ❌ ❌ ✅ ❌ ❌ ❌ ❌OpenTelemetry Beta ✅ ✅ ✅ ✅ * ❌ ❌Prometheus ❌ ❌ ✅ ❌ ❌ ❌ ❌StatsD ❌ ❌ ✅ ❌ ❌ ❌ ❌Zipkin ❌ ✅ ❌ ✅ ❌ ❌ ❌
* Como extensión
Elaborar esta tabla nos abrió los ojos de golpe. Las distintas herramientas difieren tanto en sus capacidades y en los fines para los que están diseñadas que no podíamos considerarlas todas parte de la misma categoría: ¡era como comparar manzanas con tostadoras!
Por ejemplo, ELK (Elasticsearch-Logstash-Kibana, junto con Filebeat) y Zipkin hacen cosas tan distintas que intentar compararlos no hace más que generar confusión. Por desgracia, la ampliación progresiva de su alcance no hace sino complicar aún más las cosas: sin duda en respuesta a las peticiones de los usuarios, se han añadido funciones secundarias respecto al propósito principal de cada herramienta, lo que genera solapamientos con otras herramientas. A primera vista, ELK se ocupa del almacenamiento y la visualización de registros, mientras que Zipkin se dedica al rastreo distribuido. Pero, en cuanto profundizas un poco en la cartera de productos de Elastic, enseguida te encuentras con Elastic APM, que permite el rastreo distribuido e incluso es compatible con Jaeger.
Más allá del problema de la ampliación del alcance original, muchas de las herramientas pueden integrarse entre sí, lo que da lugar a distintas combinaciones de recopiladores, agregadores, paneles de control, etc. Algunas de estas tecnologías son compatibles entre sí y otras no.
Realización de una investigación cualitativa
Por tanto, esta tabla comparativa no nos ofrecía una visión lo bastante precisa como para fundamentar nuestra elección. Necesitábamos realizar un análisis cualitativo de los objetivos, los principios rectores y el posible rumbo futuro de cada proyecto, partiendo de la idea de que cuanto más se parecieran los valores de un proyecto a los nuestros, más probable sería que siguiéramos siendo compatibles a lo largo del tiempo. Al visitar las páginas de los proyectos, nos llamó inmediatamente la atención lo siguiente en la página de OpenCensus.
OpenCensus y OpenTracing se han fusionado para formar OpenTelemetry, que constituye la siguiente versión principal de OpenCensus y OpenTracing. OpenTelemetry ofrecerá compatibilidad con las integraciones existentes de OpenCensus, y seguiremos publicando parches de seguridad para las bibliotecas existentes de OpenCensus durante dos años.
Para nosotros, ese era un dato clave. Sabíamos que no podíamos garantizar que nuestra elección resistiera el paso del tiempo, pero al menos queríamos saber que seguiría contando con un sólido respaldo de la comunidad. Con esta información, podíamos tachar OpenCensus de nuestra lista de candidatos. Probablemente tampoco fuera buena idea utilizar Jaeger, ya que es la implementación de referencia del proyecto OpenTracing, que ya se ha declarado oficialmente obsoleto: la mayor parte de las nuevas contribuciones irá a parar a OpenTelemetry.
Después nos informamos sobre OpenTelemetry Collector.
OpenTelemetry Collector ofrece una implementación independiente del proveedor para recibir, procesar y exportar datos de telemetría. Además, elimina la necesidad de ejecutar, gestionar y mantener varios agentes o colectores para admitir formatos de datos de telemetría de código abierto (como Jaeger, Prometheus, etc.) y enviarlos a múltiples backends de código abierto o comerciales.
OpenTelemetry Collector actúa como un agregador que nos permite combinar distintos métodos de recopilación de datos de observabilidad e instrumentación con diferentes backends. Básicamente, nuestra aplicación puede recopilar trazas con Zipkin y métricas de Prometheus, que después podemos enviar a un backend configurable y visualizar con Grafana. Este diseño admite muchas otras combinaciones, por lo que podemos probar distintos enfoques para ver qué tecnologías se adaptan mejor a nuestro caso de uso.
Integrar OpenTelemetry como estrategia de futuro
Básicamente, OpenTelemetry Collector nos convenció porque, en teoría, nos permite cambiar de una tecnología de observabilidad a otra. A pesar de la relativa inmadurez del proyecto, decidimos lanzarnos de lleno y utilizar OpenTelemetry únicamente con integraciones de código abierto, porque la única forma de comprender el panorama es utilizar las tecnologías.
Sin embargo, OpenTelemetry Collector carece de algunas funcionalidades, por lo que tenemos que recurrir a otras tecnologías para cubrirlas. En las siguientes secciones resumimos nuestras elecciones y los motivos que las justifican.
- Implementación del registro de logs
- Implementación del rastreo distribuido
- Implementación de la recopilación de métricas
- Implementación de la agregación de errores
- Implementación de comprobaciones de estado e introspección en tiempo de ejecución
- Implementación de volcados de memoria heap y de núcleo
Implementación del registro de eventos
El registro de logs es una parte de la observabilidad que parece sencilla, pero que enseguida obliga a tomar decisiones complejas. Es sencilla porque solo hay que recopilar los logs que generan los contenedores, pero se complica cuando hay que decidir dónde almacenar los datos, cómo trasladarlos hasta allí, cómo indexarlos para que resulten útiles y durante cuánto tiempo conservarlos. Para que los archivos de log sean útiles, deben permitir realizar búsquedas fácilmente según un conjunto de criterios lo bastante amplio como para satisfacer las necesidades de los distintos usuarios.
Analizamos la compatibilidad del OpenTelemetry Collector con la gestión de registros y, en el momento de redactar este texto, todavía se encuentra en una fase beta muy temprana. Decidimos utilizar ELK para la gestión de registros a corto plazo mientras seguimos investigando otras opciones.
Al no haber ninguna razón de peso para no hacerlo, optamos por utilizar las herramientas de Elasticsearch, lo que nos permitió dividir el despliegue en nodos de ingesta, de coordinación, maestros y de datos. Para facilitar el despliegue, utilizamos un chart de Bitnami. Para transportar los datos, desplegamos Filebeat como parte de un DaemonSet de Kubernetes. Añadimos la funcionalidad de búsqueda desplegando Kibana y aprovechando los índices, las búsquedas, las visualizaciones y los paneles precargados.
Pronto quedó claro que, aunque esta solución funcionaba, la configuración predeterminada consumía bastantes recursos, lo que dificultaba su ejecución en entornos con menos recursos, como K3S o Microk8s. La posibilidad de ajustar el número de réplicas de cada componente permitió resolver este problema, pero provocó algunos fallos que podrían deberse al agotamiento de los recursos o a un volumen excesivo de datos.
Lejos de sentirnos decepcionados por ello, lo vemos como una oportunidad para evaluar el rendimiento de nuestro sistema de registro con distintas configuraciones, así como para investigar otras opciones como Grafana Loki y Graylog. Es muy posible que descubramos que las soluciones de registro más ligeras no ofrecen todas las funcionalidades que algunos usuarios necesitan y que sí encuentran en herramientas que consumen más recursos. Dada la naturaleza modular de MARA, probablemente desarrollaremos módulos adicionales para estas opciones con el fin de ofrecer más alternativas a los usuarios.
Implementación del rastreo distribuido
Además de determinar qué herramienta ofrece la funcionalidad de trazado que buscamos, teníamos que plantearnos cómo implementar la solución y qué tecnologías debían integrarse con ella.
En primer lugar, queríamos asegurarnos de que la instrumentación no afectara negativamente a la calidad del servicio de la propia aplicación. Todos habíamos trabajado con sistemas cuyo rendimiento caía de forma predecible una vez por hora al exportarse los registros, y no teníamos ningún deseo de repetir esa experiencia. La arquitectura de OpenTelemetry Collector resultaba atractiva en este sentido, ya que permite ejecutar una instancia por host. Cada colector recibe datos de los clientes y agentes de las distintas aplicaciones que se ejecutan en el host (en contenedores o no). El colector agrega los datos y, si procede, los comprime antes de enviarlos a un backend de almacenamiento, lo que nos parecía ideal.
A continuación, evaluamos la compatibilidad con OpenTelemetry en los distintos lenguajes de programación y frameworks que utilizamos en la aplicación. Aquí, las cosas se complicaron un poco. A pesar de utilizar únicamente los dos lenguajes de programación y sus frameworks asociados que se muestran en la tabla, el nivel de complejidad era sorprendentemente alto.
Lenguaje Framework Número de serviciosJava Spring Boot 3Python Flask 3
Para añadir trazas a nivel de lenguaje, primero probamos los agentes de instrumentación automática de OpenTelemetry, pero sus resultados nos parecieron desordenados y confusos. Estamos seguros de que esto mejorará a medida que maduren las bibliotecas de instrumentación automática, pero, por el momento, descartamos los agentes de OpenTelemetry y decidimos integrar las trazas en nuestro código.
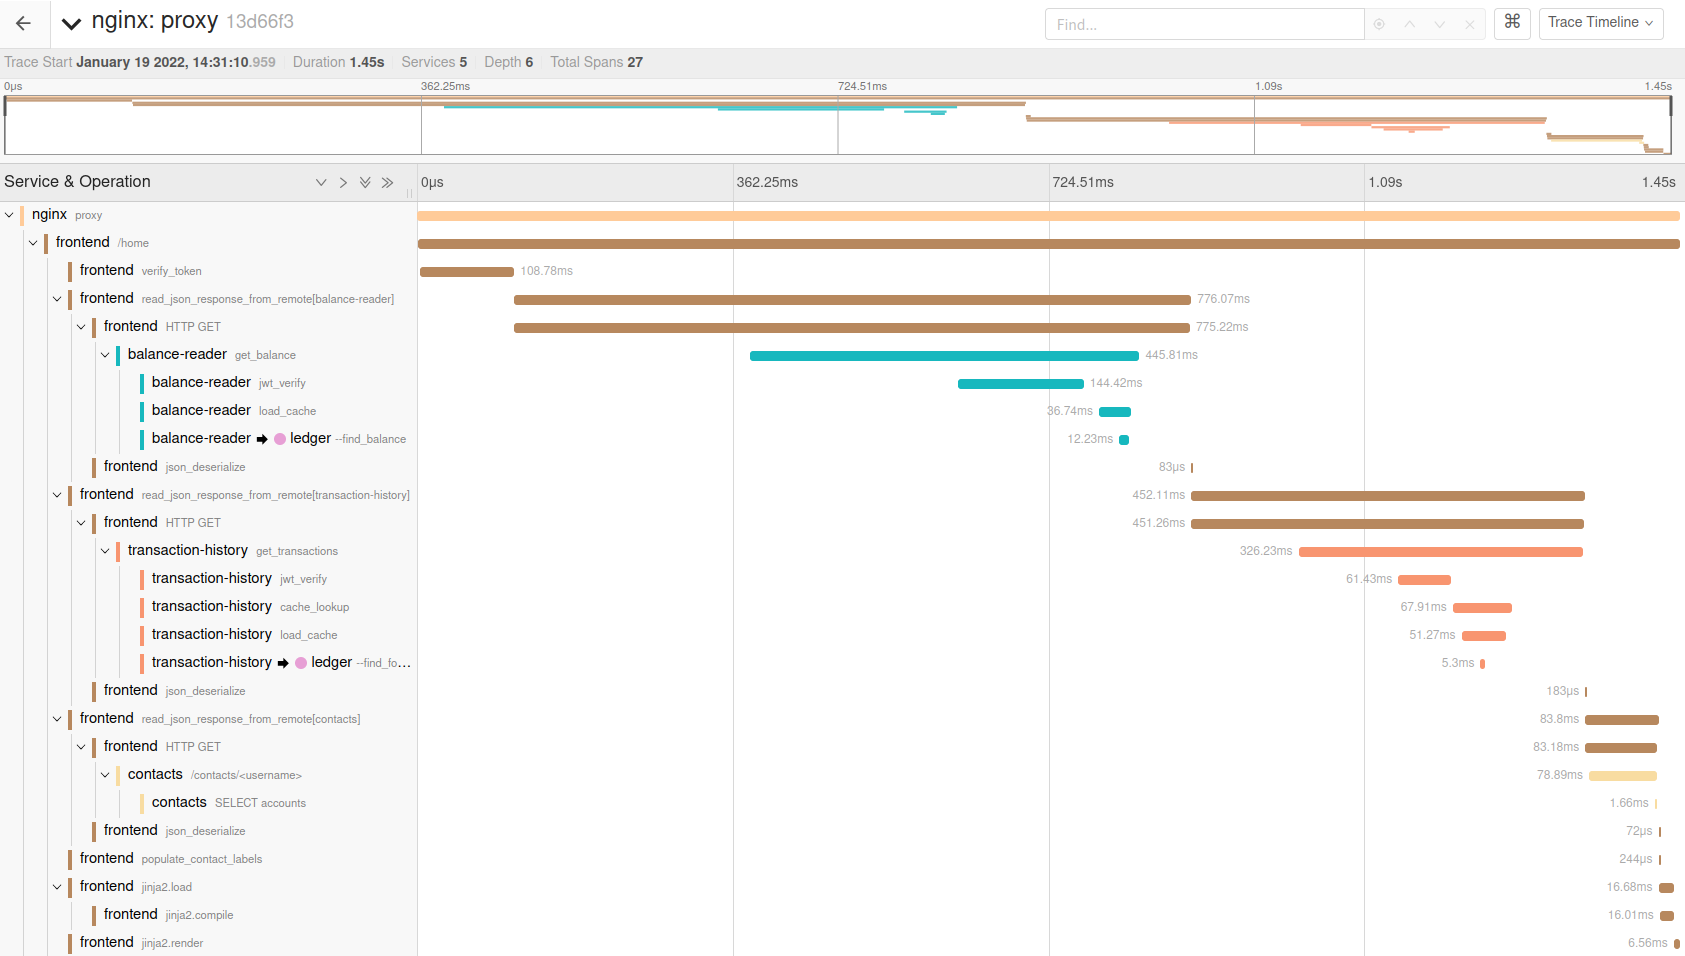
Antes de lanzarnos a implementar el trazado directamente en el código, configuramos OpenTelemetry Collector para que enviara todos los datos de trazado a una instancia de Jaeger que se ejecutaba en local, donde podíamos ver los resultados con mayor facilidad. Esto nos resultó muy útil, ya que nos permitió experimentar con la presentación visual de los datos de trazado mientras averiguábamos cómo integrar OpenTelemetry por completo. Por ejemplo, si detectábamos que una biblioteca de cliente HTTP no incluía datos de trazado al realizar llamadas a un servicio del que dependíamos, añadíamos el problema de inmediato a nuestra lista de correcciones pendientes. Jaeger ofrece una vista muy clara de todos los segmentos que componen una misma traza:
Trazado distribuido para Python
Añadir trazas a nuestro código Python fue relativamente sencillo. Añadimos dos archivos de código fuente Python a los que hacen referencia todos nuestros servicios y actualizamos los respectivos archivos requirements.txt para incluir las dependencias opentelemetry-instrumentation-* pertinentes. Esto nos permitió utilizar la misma configuración de trazado para todos los servicios Python, así como incluir el ID de traza de cada solicitud en los mensajes de registro e incorporarlo en las solicitudes a los servicios dependientes.
Trazabilidad distribuida para Java
A continuación, nos centramos en los servicios Java. Utilizar las bibliotecas de OpenTelemetry para Java directamente en un proyecto que parte de cero es relativamente sencillo: solo hay que importar las bibliotecas necesarias y utilizar directamente la API de trazado. Sin embargo, si utilizas Spring, como nosotros, tendrás que tomar algunas decisiones adicionales.
Spring ya cuenta con una API de trazabilidad distribuida, Spring Cloud Sleuth. Proporciona una fachada sobre la implementación subyacente de trazabilidad distribuida que hace lo siguiente, según se describe en la documentación:
- Añade los identificadores de traza y de span al MDC de Slf4J, para que puedas extraer todos los registros de una traza o un span determinados en un agregador de registros.
- Instrumenta los puntos habituales de entrada y salida de las aplicaciones Spring (filtro de servlets, plantilla REST, acciones programadas, canales de mensajes, cliente Feign).
- Si
spring-cloud-sleuth-zipkinestá disponible, … [genera y envía] trazas compatibles con Zipkin a través de HTTP. De forma predeterminada, las envía a un servicio de recopilación de Zipkin en localhost (puerto 9411). Configure la ubicación del servicio mediantespring.zipkin.baseUrl.
La API también nos permite añadir trazas a las tareas anotadas con @Scheduled.
En otras palabras, solo con usar Spring Cloud Sleuth obtenemos trazas a nivel de los endpoints de los servicios HTTP sin necesidad de configuración adicional, lo cual es una gran ventaja. Como nuestro proyecto ya utiliza Spring, decidimos mantenerlo todo dentro de ese framework y aprovechar las funcionalidades que ofrece. Sin embargo, detectamos algunos problemas al integrarlo todo con Maven:
- El módulo Autoconfigure de Spring Cloud Sleuth sigue en una versión preliminar de tipo milestone.
- El módulo Spring Cloud Sleuth Autoconfigure depende de una versión alfa obsoleta de
opentelemetry-instrumentation-api. Actualmente no hay ninguna versión 1.x reciente de esta biblioteca que no sea alfa. - El proyecto debe obtener el modelo de objetos del proyecto (POM) padre
spring-cloud-buildde los repositorios Spring Snapshot debido a la forma en que Spring Cloud Sleuth codifica sus referencias a dependencias para las versiones preliminares de tipo milestone.
Esto complicó un poco la definición de nuestro proyecto Maven, ya que tuvimos que configurar Maven para que obtuviera las dependencias tanto de los repositorios de Spring como de Maven Central, una clara señal de lo incipiente que era la compatibilidad con OpenTelemetry en Spring Cloud. Aun así, seguimos adelante y creamos un módulo común de telemetría para configurar el rastreo distribuido con Spring Cloud Sleuth y OpenTelemetry, que incluía diversas funciones auxiliares y extensiones relacionadas con la telemetría.
En el módulo común de telemetría, ampliamos la funcionalidad de trazado que ofrecen las bibliotecas Spring Cloud Sleuth y OpenTelemetry mediante:
- Compatibles con Spring
Autoconfigurationclases que configuran el seguimiento y las funciones ampliadas del proyecto, y cargan atributos adicionales de los recursos de seguimiento. - Implementaciones de interfaces NoOp, para que podamos desactivar el seguimiento al iniciar inyectando instancias de NoOp en todas las interfaces de Spring Cloud Sleuth.
- Un interceptor de nombres de trazas para normalizar los nombres de las trazas.
- Un gestor de errores que muestra los errores mediante slf4j y el seguimiento de Spring Cloud Sleuth.
- Una implementación mejorada de los atributos de trazabilidad que codifica información adicional en cada traza emitida, como la versión del servicio, el ID de la instancia del servicio, el ID de la máquina, el nombre del pod, el ID del contenedor, el nombre del contenedor y el nombre del espacio de nombres.
- Un inspector de sentencias con trazabilidad que inserta los identificadores de traza en los comentarios que preceden a las sentencias SQL emitidas por Hibernate. Al parecer, ahora esto se puede hacer con SQLCommenter, pero aún no hemos migrado a esta herramienta.
Además, implementamos un cliente HTTP compatible con Spring basado en Apache HTTP Client, porque queríamos disponer de más métricas y opciones de personalización al realizar llamadas HTTP entre servicios. En esta implementación, los identificadores de traza y de span se transmiten en las cabeceras al llamar a los servicios dependientes, lo que permite incluirlos en los datos de trazabilidad. Además, esta implementación proporciona métricas del pool de conexiones HTTP que OpenTelemetry agrega.
En definitiva, integrar el seguimiento de trazas con Spring Cloud Sleuth y OpenTelemetry fue una tarea ardua, pero creemos que mereció la pena. Esperamos que este proyecto y este artículo sirvan de guía a quienes quieran seguir este camino.
Trazabilidad distribuida para NGINX
Para obtener trazas que conectaran todos los servicios durante todo el ciclo de vida de una solicitud, necesitábamos integrar OpenTelemetry en NGINX. Para ello, utilizamos el módulo de OpenTelemetry para NGINX (aún en fase beta). Como preveíamos que podría resultar difícil conseguir archivos binarios del módulo que funcionaran con todas las versiones de NGINX, creamos un repositorio de GitHub con imágenes de contenedor que incorporan módulos de NGINX sin soporte. Realizamos compilaciones nocturnas y distribuimos el archivo binario del módulo mediante imágenes de Docker desde las que se puede importar fácilmente.
Aún no hemos integrado este proceso en el proceso de compilación de NGINX Ingress Controller en el proyecto MARA, pero tenemos previsto hacerlo pronto.
Implementación de la recopilación de métricas
Tras completar la integración de trazas con OpenTelemetry, nos centramos en las métricas. Nuestras aplicaciones basadas en Python no contaban con métricas y decidimos posponer su incorporación por el momento. En el caso de las aplicaciones Java, el código fuente original de Bank of Anthos, que utiliza Micrometer junto con Stackdriver de Google Cloud, es compatible con la recopilación de métricas. Sin embargo, eliminamos ese código de Bank of Sirius tras crear una bifurcación de Bank of Anthos, porque no nos permitía configurar un backend de métricas. Aun así, el hecho de que ya existieran puntos de instrumentación para las métricas ponía de manifiesto la necesidad de integrarlas adecuadamente.
Para dar con una solución configurable y práctica, primero analizamos la compatibilidad con métricas de las bibliotecas de OpenTelemetry para Java y de Micrometer. Al buscar comparaciones entre ambas tecnologías, encontramos varios resultados que enumeraban las carencias de OpenTelemetry como API de métricas en la JVM, aunque, en el momento de redactar este artículo, las métricas de OpenTelemetry aún se encuentran en fase alfa. Micrometer es una capa de abstracción de métricas consolidada para la JVM, similar a slf4j, ya que proporciona una API común que actúa como interfaz de una implementación de métricas configurable, en lugar de ofrecer una implementación propia. Curiosamente, es la API de métricas predeterminada de Spring.
En ese momento, estábamos sopesando los siguientes hechos:
- El recopilador de OpenTelemetry puede recibir métricas de prácticamente cualquier fuente, incluidos Prometheus, StatsD y el protocolo nativo OpenTelemetry Protocol (OTLP)
- Micrometer también es compatible con numerosos backends de métricas, incluidos Prometheus y StatsD
- El SDK de métricas de OpenTelemetry para la JVM permite enviar métricas a través de OTLP
Tras realizar algunas pruebas, decidimos que el enfoque más pragmático era utilizar la fachada de Micrometer con una implementación subyacente de Prometheus y configurar el Collector de OpenTelemetry para que utilizara la API de Prometheus para obtener las métricas de la aplicación. Sabíamos, por numerosos artículos, que la falta de algunos tipos de métricas en OpenTelemetry puede causar problemas, pero nuestros casos de uso no requieren esos tipos, por lo que la solución de compromiso era aceptable.
Descubrimos algo interesante sobre el OpenTelemetry Collector: aunque lo habíamos configurado para recibir trazas a través de OTLP y métricas a través de la API de Prometheus, también se puede configurar para enviar ambos tipos de datos a un receptor de datos externo mediante OTLP o cualquier otro protocolo compatible. Esto nos permitió probar fácilmente nuestra aplicación con LightStep.
En general, programar las métricas en Java fue bastante sencillo porque lo hicimos siguiendo la API de Micrometer, para la que hay numerosos ejemplos y tutoriales disponibles. Probablemente, lo más difícil, tanto para las métricas como para las trazas, fue configurar correctamente el grafo de dependencias de Maven en el archivo pom.xml de telemetry-common.
Implementación de la agregación de errores
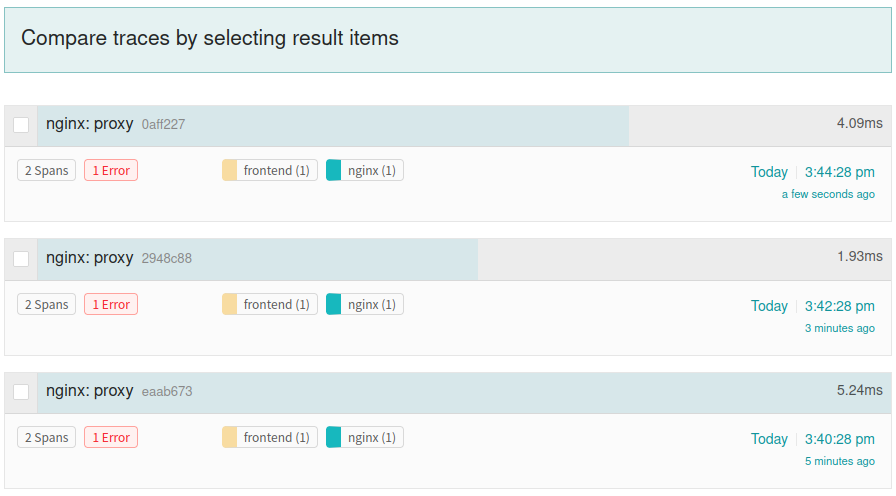
El proyecto OpenTelemetry no incluye la agregación de errores entre sus objetivos como tal, ni ofrece una implementación del etiquetado de errores tan elegante como la de soluciones como Sentry o Honeybadger.io. Aun así, decidimos utilizar OpenTelemetry para la agregación de errores a corto plazo en lugar de añadir otra herramienta. Con una herramienta como Jaeger, podemos buscar error=true para encontrar todas las trazas que contengan un error. Esto, al menos, nos da una idea de los fallos más habituales. En el futuro, puede que nos planteemos incorporar una integración con Sentry.
Implementación de comprobaciones de estado e introspección en tiempo de ejecución
En el contexto de nuestra aplicación, las comprobaciones de estado permiten a Kubernetes saber si un servicio funciona correctamente o ha completado su fase de arranque. Si el servicio no funciona correctamente, Kubernetes puede configurarse para detener o reiniciar las instancias. En nuestra aplicación, decidimos no utilizar las comprobaciones de estado de OpenTelemetry porque consideramos que la documentación era insuficiente.
En su lugar, para los servicios de la JVM utilizamos un proyecto de Spring llamado Spring Boot Actuator, que no solo proporciona endpoints de comprobación de estado, sino también de introspección en tiempo de ejecución y de volcado de memoria. Para los servicios de Python, utilizamos el módulo Flask Management Endpoints, que ofrece un subconjunto de las funcionalidades de Spring Boot Actuator. Actualmente, solo proporciona información personalizable sobre la aplicación y comprobaciones de estado.
Spring Boot Actuator se integra con la JVM y Spring para ofrecer endpoints de introspección, monitorización y comprobación del estado. Además, proporciona un marco para añadir información personalizada a los datos predeterminados que expone en sus endpoints. Estos permiten inspeccionar en tiempo de ejecución aspectos como el estado de la caché, el entorno de ejecución, las migraciones de bases de datos, las comprobaciones del estado, la información personalizable de la aplicación, las métricas, las tareas periódicas, el estado de las sesiones HTTP y los volcados de hilos.
Los endpoints de comprobación de estado implementados por Spring Boot Actuator tienen una configuración modular, de modo que el estado de un servicio puede determinarse mediante varias comprobaciones individuales clasificadas como comprobaciones de actividad (liveness) o de disponibilidad (readiness). También hay disponible una comprobación de estado completa que muestra todos los módulos de comprobación y que suele tener un aspecto como este.
Los endpoints de información se definen en un documento JSON mediante un único objeto JSON de nivel superior y una serie de claves y valores jerárquicos. Por lo general, el documento especifica el nombre y la versión del servicio, la arquitectura, el nombre del host, la información del sistema operativo, el ID del proceso, el nombre del ejecutable y detalles sobre el host, como un ID de máquina o un ID único del servicio.
Implementación de volcados de memoria heap y de núcleo
Quizá recuerdes, por la tabla de Comparación de las funciones de las herramientas con la lista de deseos, que ninguna de las herramientas permite la introspección en tiempo de ejecución ni los volcados de heap o de memoria. Sin embargo, Spring, el framework en el que se basa nuestra aplicación, admite ambas funciones, aunque integrar las funciones de observabilidad en la aplicación requirió cierto trabajo. Como se detalla en la sección anterior, para la introspección en tiempo de ejecución utilizamos un módulo de Python junto con Spring Boot Actuator.
Del mismo modo, para los volcados de memoria heap utilizamos los endpoints de volcado de hilos que proporciona Spring Boot Actuator para implementar parte de las funcionalidades que buscábamos. No podemos obtener volcados de memoria del proceso bajo demanda ni volcados de memoria heap de la JVM con el nivel de granularidad que nos gustaría, pero conseguimos parte de la funcionalidad deseada con poco esfuerzo adicional. Por desgracia, los volcados de memoria del proceso para los servicios de Python requerirán bastante trabajo adicional, que hemos pospuesto para más adelante.
Resumen
Después de mucho llorar y de cuestionarnos nuestras decisiones vitales, nos hemos puesto de acuerdo en utilizar las siguientes tecnologías para la observabilidad en MARA (en lo que sigue, OTel significa OpenTelemetry):
- Registro de logs (para todos los contenedores) – Filebeat → Elasticsearch / Kibana
- Trazabilidad distribuida
- Java – Spring Cloud Sleuth → exportador de Spring Cloud Sleuth para OTel → OTel Collector → exportadores conectables como Jaeger, Lightstep, Splunk, etc.
- Python – Bibliotecas de OTel para Python → OTel Collector → almacenamiento intercambiable
- NGINX y NGINX Plus (NGINX Ingress Controller aún no es compatible) – módulo OTel de NGINX → OTel Collector → exportador intercambiable
- Recopilación de métricas
- Java – Micrometer a través de Spring → exportador de Prometheus → recopilador de OTel
- Python – Aún no hay implementación
- Python WSGI – GUnicorn StatsD → Prometheus (a través de StatsD / ServiceMonitor)
- NGINX – Punto de acceso de Prometheus → Prometheus (a través de ServiceMonitor)
- Agregación de errores – trazas distribuidas de OTel → exportador conectable → función de búsqueda del exportador para encontrar trazas marcadas con
error - Comprobaciones de estado
- Java – Spring Boot Actuator → Kubernetes
- Python – módulo Flask Management Endpoints → Kubernetes
- Introspección en tiempo de ejecución
- Java – Spring Boot Actuator
- Python – módulo Flask Management Endpoints
- Volcados de memoria heap/core
- Java – Compatibilidad de Spring Boot Actuator con los volcados de hilos
- Python – Aún no es compatible
Esta implementación refleja el estado actual. Sin duda, cambiará y evolucionará a medida que avance el desarrollo. Pronto someteremos la aplicación a pruebas de carga exhaustivas. Esperamos aprender mucho sobre las carencias de nuestro enfoque de observabilidad y añadir nuevas funciones de observabilidad.
Prueba la arquitectura de referencia para aplicaciones modernas y la aplicación de ejemplo (Bank of Sirius). Si tienes ideas sobre cómo podemos mejorar, ¡tus contribuciones serán bienvenidas en nuestro repositorio de GitHub!
Artículos relacionados
Esta publicación forma parte de una serie. A medida que incorporamos nuevas funcionalidades a MARA, vamos publicando los detalles en el blog:
- Una nueva arquitectura de referencia de código abierto para aplicaciones modernas
- Integración de OpenTelemetry en la arquitectura de referencia de aplicaciones modernas: informe de progreso (esta entrada)
- MARA: ahora en una estación de trabajo cerca de ti
- Presentamos la versión 1.0.0 de la arquitectura de referencia de NGINX para aplicaciones modernas
Artículos relacionados del blog

Únete a F5 NGINX en AppWorld 2024
Descubre las numerosas razones para asistir al evento insignia de F5, que incluirá un emocionante anuncio sobre la cartera de productos NGINX.
Rotación de certificados SSL/TLS sin reinicios en NGINX Open Source
La función de diccionario compartido permite configurar NGINX sin necesidad de reiniciarlo al renovar los certificados SSL/TLS.
Exposición de APIs en Kubernetes
La unidad 2 de Microservices March 2022 se centra en cómo exponer tus API en Kubernetes. Aquí tienes enlaces a los recursos que necesitas: la retransmisión en directo del 14 de marzo, artículos de blog y otros recursos de preparación, y el laboratorio práctico «Protege las API de Kubernetes mediante la limitación de solicitudes».
NGINX Sprint 2.0: visión clara, código renovado y nuevos compromisos con el código abierto
Hoy, en NGINX Sprint 2.0, anunciamos cómo respaldaremos nuestra visión del futuro de las aplicaciones modernas con una mayor presencia en la comunidad de código abierto, incluida la participación en el proyecto comunitario Kubernetes, nuevos proyectos de software de código abierto y la arquitectura de referencia para aplicaciones modernas.
Presentamos NGINX Plus R22
NGINX Plus R22 incorpora nuevas funcionalidades, como la compatibilidad con OCSP para verificar la revocación de certificados en TLS mutuo, el uso de varios proveedores de identidad OIDC en una configuración, el seguimiento en tiempo real de la limitación de solicitudes y conexiones en el panel de NGINX Plus y mejoras en NGINX JavaScript.
Presentamos NGINX Plus R17
NGINX Plus R17 incorpora compatibilidad con la limitación de velocidad en dos fases y con TLS 1.3, la versión más reciente del protocolo Transport Layer Security. La configuración de OpenID Connect es más sencilla y NGINX ModSecurity WAF es el doble de rápido que antes. También se ha actualizado el módulo JavaScript de NGINX.