Editor – Esta es la segunda parte de una serie sobre almacenamiento en caché de alta capacidad y alta disponibilidad:
- Cachés compartidas con clústeres de caché de NGINX Plus, parte 1
- Cachés compartidas con clústeres de caché de NGINX Plus, parte 2 (esta publicación)
¿Cómo se puede crear un clúster de caché de gran capacidad y alta disponibilidad con NGINX o NGINX Plus? En este artículo se explica cómo utilizar dos o más servidores de caché NGINX o NGINX Plus para crear un clúster de caché de alta disponibilidad. (Salvo que se indique lo contrario, el método descrito aquí se aplica por igual a NGINX Open Source y NGINX Plus, pero, para abreviar, nos referiremos únicamente a NGINX Plus).
Repaso: la solución de caché fragmentada
La primera parte de esta serie describía un patrón para crear clústeres de caché fragmentados de gran tamaño.
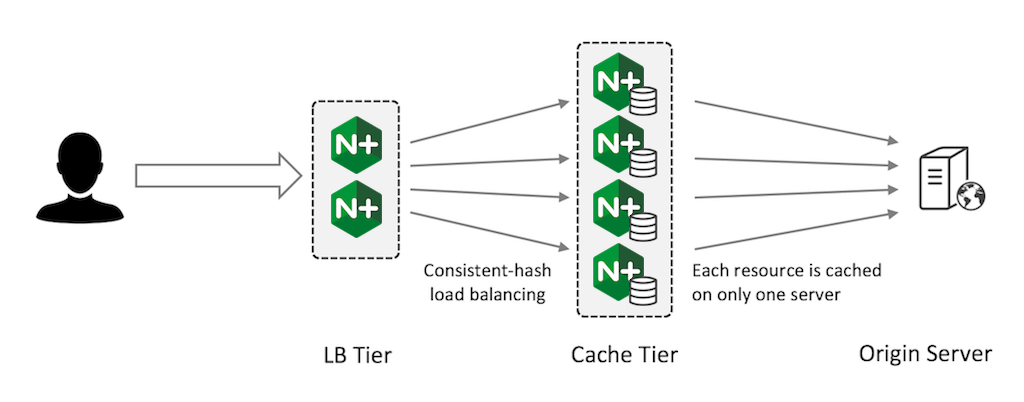
Este patrón resulta eficaz cuando se necesita crear una caché de gran capacidad que pueda ampliarse según sea necesario. Dado que cada recurso solo se almacena en caché en un servidor, no ofrece una tolerancia a fallos completa, pero el balanceo de carga mediante hash coherente garantiza que, si un servidor falla, solo se invalide la parte del contenido almacenado en caché que le corresponde.
Creación de un clúster de caché de alta disponibilidad
Si su principal objetivo es minimizar a toda costa el número de solicitudes a sus servidores de origen, la solución de fragmentación de la caché no es la mejor opción. En su lugar, una solución basada en una configuración minuciosa de las instancias principales y secundarias de NGINX Plus puede satisfacer sus requisitos:
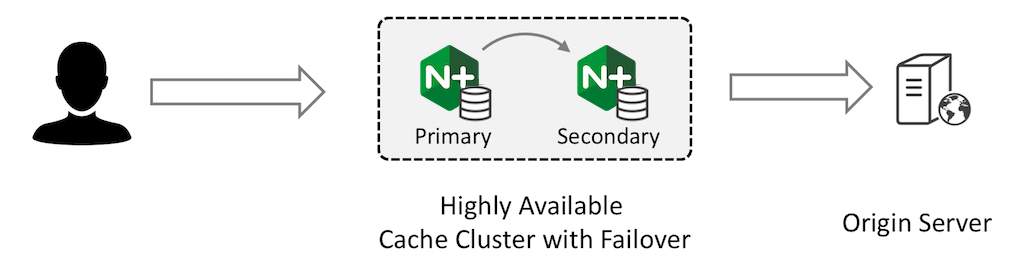
La instancia principal de NGINX Plus recibe todo el tráfico y reenvía las solicitudes a la instancia secundaria. La instancia secundaria recupera el contenido del servidor de origen y lo almacena en caché; la instancia principal también almacena en caché la respuesta de la secundaria y la devuelve al cliente.
Ambos dispositivos tienen las cachés completamente llenas, y estas se actualizan según los tiempos de espera configurados.
Configuración del servidor de caché principal
Configure el servidor de caché principal para que reenvíe todas las solicitudes al servidor secundario y almacene en caché las respuestas. Tal como indica el parámetro backup de la directiva server en el grupo de servidores upstream, el servidor principal reenvía las solicitudes directamente al servidor de origen en caso de que falle el servidor secundario:
proxy_cache_path /tmp/mycache keys_zone=mycache:10m;
server {
    status_zone mycache;          # for NGINX Plus extended status

    listen 80;

    proxy_cache mycache;
    proxy_cache_valid 200 15s;

    location / {
        proxy_pass http://secondary;
    }
}

upstream secondary {
    zone secondary 128k;          # for NGINX Plus extended status

    server 192.168.56.11;         # secondary
    server 192.168.56.12 backup;  # origin
}
Configuración del servidor de caché secundario
Configure el servidor de caché secundario para que reenvíe las solicitudes al servidor de origen y almacene en caché las respuestas.
proxy_cache_path /tmp/mycache keys_zone=mycache:10m;
server {
    status_zone mycache;          # for NGINX Plus extended status

    listen 80;

    proxy_cache mycache;
    proxy_cache_valid 200 15s;

    location / {
        proxy_pass http://origin;
    }
}

upstream origin {
    zone origin 128k;            # for NGINX Plus extended status

    server 192.168.56.12;        # origin
}
Configuración de la alta disponibilidad
Por último, debe configurar la alta disponibilidad (HA) para que el servidor secundario gestione el tráfico entrante si falla el primario; cuando este se recupere, volverá a gestionar el tráfico.
En este ejemplo, utilizamos la solución de alta disponibilidad activa-pasiva para NGINX Plus. La dirección IP virtual anunciada externamente es 192.168.56.20, y el servidor de caché principal actúa como nodo principal de alta disponibilidad en el clúster. Si utiliza NGINX Open Source, puede instalar y configurar manualmente keepalived u otra solución de alta disponibilidad.
Escenarios de conmutación por error
Recordemos que queremos crear un clúster de caché de alta disponibilidad que siga funcionando aunque falle un servidor de caché. Tampoco queremos que aumente la carga del servidor de origen, ni cuando falle un servidor de caché ni cuando se recupere y necesite actualizar contenido obsoleto.
Supongamos que el servidor principal falla y la solución de alta disponibilidad de NGINX Plus transfiere la dirección IP externa al servidor secundario.
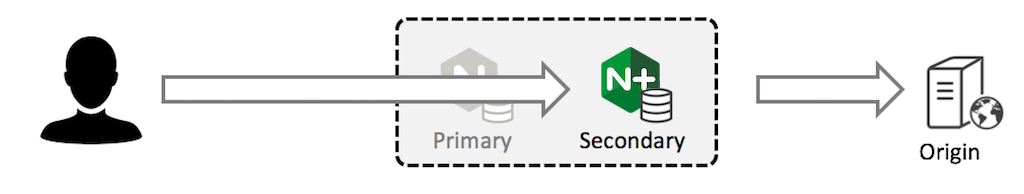
El servidor secundario dispone de una caché completa y sigue funcionando con normalidad. El servidor de origen no soporta ninguna carga adicional.
Cuando el servidor de caché principal se recupere y empiece a recibir tráfico de clientes, su caché estará desactualizada y muchas entradas habrán caducado. El servidor principal actualizará su caché local desde el servidor de caché secundario; como la caché del servidor secundario ya está actualizada, no aumentará el tráfico hacia el servidor de origen.
Supongamos ahora que falla el servidor secundario. El servidor primario lo detecta (mediante una comprobación de estado configurada como parte de la solución de alta disponibilidad) y reenvía el tráfico directamente al servidor de respaldo (que es el servidor de origen).
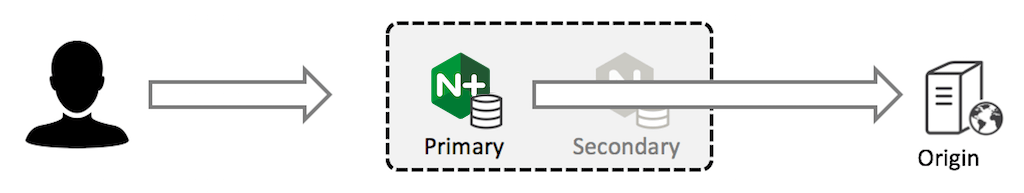
El servidor principal dispone de una caché completa y sigue funcionando con normalidad. Una vez más, no se genera ninguna carga adicional en el servidor de origen.
Cuando el servidor secundario se recupere, su caché estará desactualizada. Sin embargo, solo recibirá solicitudes del servidor principal cuando caduque la caché de este último, momento en el que la copia del servidor secundario también habrá caducado. Aunque el servidor secundario tenga que solicitar contenido al servidor de origen, esto no aumenta la frecuencia de las solicitudes al origen. El servidor de origen no se ve afectado negativamente.
Prueba del comportamiento de conmutación por error
Para probar nuestra solución de alta disponibilidad, configuramos el servidor de origen para que registre las solicitudes y devuelva la hora actual en cada solicitud. Esto significa que la respuesta del servidor de origen cambia cada segundo:
access_log /var/log/nginx/access.log;
location / {
    return 200 "It's now $time_localn";
}
Los servidores de caché principal y secundario ya están configurados para almacenar en caché las respuestas con el código de estado 200 durante 15 segundos. Esto suele hacer que la caché se actualice cada 15 o 16 segundos.
proxy_cache_valid 200 15s;Verificación del comportamiento de la caché
Una vez por segundo, enviamos una solicitud HTTP a la dirección IP virtual de alta disponibilidad del clúster de caché. La respuesta no cambia hasta que caducan las cachés de los servidores principal y secundario y la respuesta se actualiza desde el servidor de origen. Esto ocurre cada 15 o 16 segundos.
$ while sleep 1 ; do curl http://192.168.56.20/ ; done
It's now 9/Feb/2017:06:35:03 -0800
It's now 9/Feb/2017:06:35:03 -0800
It's now 9/Feb/2017:06:35:03 -0800
It's now 9/Feb/2017:06:35:19 -0800
It's now 9/Feb/2017:06:35:19 -0800
^C
También podemos consultar los registros del servidor de origen para confirmar que solo recibe una solicitud cada 15 o 16 segundos.
Verificación de la conmutación por error
Podemos comprobar que la conmutación por error funciona correctamente deteniendo el servidor principal o el secundario, por ejemplo, deteniendo los procesos de nginx. La prueba de carga constante continúa ejecutándose y la respuesta se almacena en caché de forma sistemática.
Al inspeccionar el registro de acceso del servidor de origen, se confirma que solo recibe una solicitud cada 15 o 16 segundos, independientemente de cuál de los servidores de caché falle o se recupere.
Frecuencia de actualización de la caché
En una situación estable, el contenido almacenado en caché suele actualizarse cada 15 o 16 segundos. El contenido caduca al cabo de 15 segundos y puede transcurrir hasta 1 segundo antes de que se reciba la siguiente solicitud, lo que provoca una actualización de la caché.
En ocasiones, puede parecer que la caché se actualiza más lentamente (pueden transcurrir hasta 30 segundos entre los cambios de contenido). Esto ocurre si el contenido del servidor de caché principal caduca y este recupera del servidor secundario contenido almacenado en caché que está a punto de caducar. Si esto supone un problema, puede configurar un tiempo de espera de caché más corto en el servidor secundario.
Resumen
Organizar las cachés en niveles entre dos o más servidores de caché NGINX, tal como hemos descrito aquí, es una forma eficaz de crear un clúster de caché de alta disponibilidad que minimice la carga de los servidores de origen y los proteja frente a picos de tráfico cuando uno de los servidores de caché falla o se recupera.
La capacidad total de la caché está limitada a la capacidad de un único servidor de caché. La primera parte de esta serie describe un patrón alternativo de caché fragmentada que distribuye una caché entre un clúster de servidores de caché. En ese caso, la capacidad total es la suma de las capacidades de todos los servidores de caché, pero el contenido no se replica para proteger el servidor de origen frente a picos de tráfico si falla un servidor de caché.
Pruebe el almacenamiento en caché de alta disponibilidad en sus propios servidores: empiece hoy mismo su prueba gratuita de 30 días o póngase en contacto con nosotros para hablar sobre sus casos de uso.
Sobre el autor
Artículos relacionados del blog

Únete a F5 NGINX en AppWorld 2024
Descubre las numerosas razones para asistir al evento insignia de F5, que incluirá un emocionante anuncio sobre la cartera de productos NGINX.
Rotación de certificados SSL/TLS sin reinicios en NGINX Open Source
La función de diccionario compartido permite configurar NGINX sin necesidad de reiniciarlo al renovar los certificados SSL/TLS.
Exposición de APIs en Kubernetes
La unidad 2 de Microservices March 2022 se centra en cómo exponer tus API en Kubernetes. Aquí tienes enlaces a los recursos que necesitas: la retransmisión en directo del 14 de marzo, artículos de blog y otros recursos de preparación, y el laboratorio práctico «Protege las API de Kubernetes mediante la limitación de solicitudes».
NGINX Sprint 2.0: visión clara, código renovado y nuevos compromisos con el código abierto
Hoy, en NGINX Sprint 2.0, anunciamos cómo respaldaremos nuestra visión del futuro de las aplicaciones modernas con una mayor presencia en la comunidad de código abierto, incluida la participación en el proyecto comunitario Kubernetes, nuevos proyectos de software de código abierto y la arquitectura de referencia para aplicaciones modernas.
Presentamos NGINX Plus R22
NGINX Plus R22 incorpora nuevas funcionalidades, como la compatibilidad con OCSP para verificar la revocación de certificados en TLS mutuo, el uso de varios proveedores de identidad OIDC en una configuración, el seguimiento en tiempo real de la limitación de solicitudes y conexiones en el panel de NGINX Plus y mejoras en NGINX JavaScript.
Presentamos NGINX Plus R17
NGINX Plus R17 incorpora compatibilidad con la limitación de velocidad en dos fases y con TLS 1.3, la versión más reciente del protocolo Transport Layer Security. La configuración de OpenID Connect es más sencilla y NGINX ModSecurity WAF es el doble de rápido que antes. También se ha actualizado el módulo JavaScript de NGINX.