Este blog es la continuación de «¿Cómo debe ser un buen plano de control para gestionar un gran número de clústeres de Kubernetes?». El blog anterior describía el enfoque único de operaciones de flota de Volterra para gestionar un conjunto de ubicaciones de infraestructura y aplicaciones. Este blog en concreto aborda un reto clave al que se enfrenta un equipo de operaciones: la desviación de la configuración al realizar cambios de configuración en un gran número de clústeres o ubicaciones. A este reto lo denomino «tiempo hasta que surte efecto».
¿Qué es el tiempo hasta que surte efecto?
Puede describirse sencillamente como el tiempo que tarda en hacerse efectiva la intención de una operación. Algunos ejemplos son:
- ¿Cuánto tardará la configuración de mi política de seguridad en aplicarse en todos mis sitios?
- ¿Cuánto tardará la última versión de mi aplicación en propagarse a todos los sitios?
- ¿Cuánto tiempo llevará actualizar el sistema operativo o el software de infraestructura en todos mis sitios distribuidos por todo el mundo?
¿Por qué es importante?
Esta pregunta puede responderse con algunos ejemplos de clientes reales:
- Meltdown y Spectre: tras conocerse la noticia sobre estas vulnerabilidades, la principal preocupación de todos los CISO era cómo aplicar rápidamente los parches del sistema operativo en toda su infraestructura. Cada hora se medía cuánto tardaba el equipo de operaciones en hacer efectivo su objetivo (es decir, actualizar la versión del sistema operativo).
- Seguro que has oído hablar de la flota de máquinas expendedoras que provocó un ataque de denegación de servicio contra una universidad. Aquí tienes un resumen por si no seguiste el ataque: unos hackers aprovecharon una vulnerabilidad de día cero e instalaron malware que se conectó con otras máquinas expendedoras, creando así una flota de bots. A continuación, enviaron enormes volúmenes de tráfico y provocaron un ataque de denegación de servicio contra la universidad. Al detectar el ataque, la universidad tuvo que configurar reglas de política de red en cada máquina expendedora, una por una, para impedir el acceso al servidor de mando y control. Para detener el ataque, era de vital importancia que su objetivo (es decir, bloquear el acceso a un sitio web concreto) se aplicara de inmediato en todas las máquinas expendedoras.
El tiempo hasta que los cambios surtan efecto es importante en múltiples categorías, como el software de infraestructura, el software de aplicaciones, las políticas de red y las políticas de seguridad.
¿Cuál es el reto?
La gravedad del problema se hace más patente cuando el equipo de operaciones tiene que gestionar
- Un gran número de sitios
- Sitios distribuidos por todo el mundo
- Entornos heterogéneos, es decir, sitios en nubes privadas, públicas y de telecomunicaciones, así como dispositivos en el extremo
- Conectividad irregular de los sitios
Un buen ejemplo sería el equipo de operaciones de un fabricante de equipos originales (OEM) del sector de la automoción, responsable de actualizar el software y gestionar la conectividad de sus vehículos (en adelante, «sitios del cliente»). Una implementación típica incluiría un centro de datos privado desde el que el equipo de operaciones controla sus vehículos a escala mundial (o regional, según la estructura organizativa).
Para comprender el reto, veamos las soluciones de las que dispone el equipo de operaciones. La mayoría ofrecen software de gestión alojado en el centro de datos privado del cliente para gestionar de forma centralizada un gran número de ubicaciones distribuidas. Cuando el fabricante de automóviles configura una política que debe aplicarse a todos los vehículos, el software de gestión central descarga básicamente un script de configuración en cada vehículo, uno por uno. El script de configuración puede ser un playbook de Ansible o un chart de Helm que ejecute una serie de comandos de configuración en cada ubicación. Esto puede visualizarse como se muestra en el siguiente diagrama.
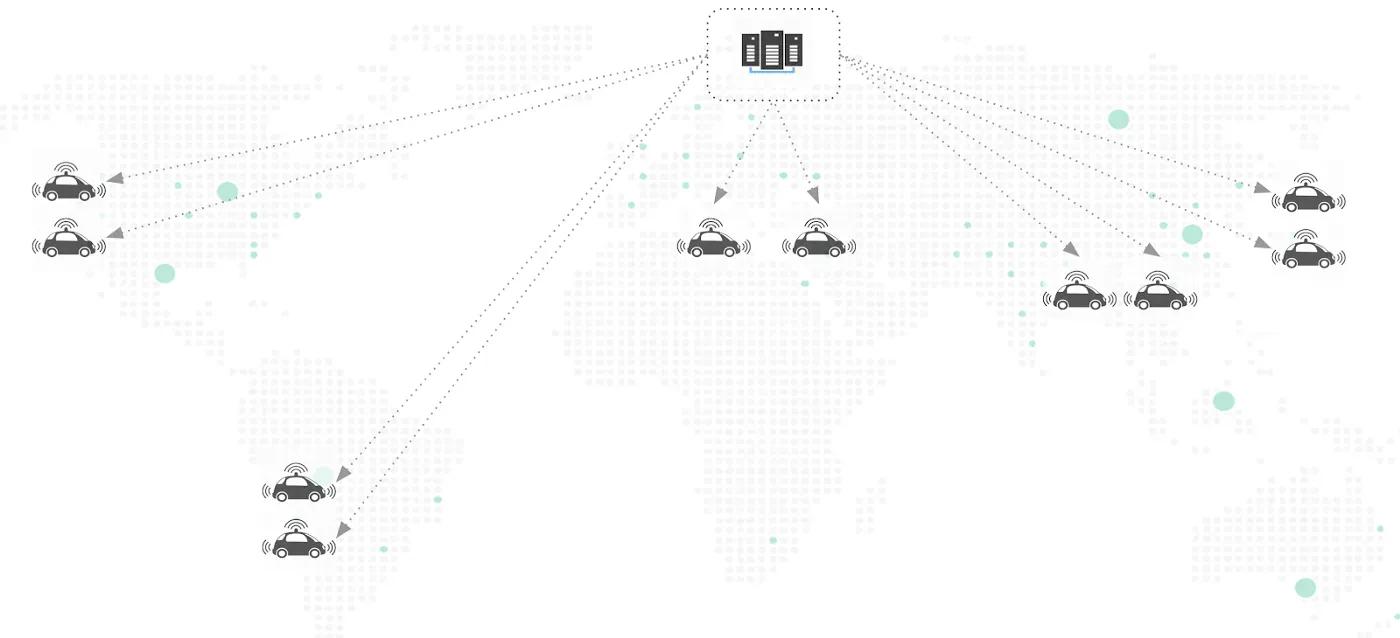
El problema es que el tiempo hasta que los cambios surtan efecto es directamente proporcional al número de sitios. Los proveedores de software de gestión centralizada argumentarán que, siempre que todas las operaciones puedan realizarse de forma remota y automatizada, esto es lo mejor que se puede conseguir.
Volterra discrepa, y podemos demostrarlo en este blog. Hemos creado un plano de control distribuido con un enfoque arquitectónico jerárquico y escalable horizontalmente, diseñado para garantizar un tiempo de aplicación mínimo.
Arquitectura de Volterra para minimizar el tiempo de aplicación
Los componentes fundamentales para lograr un tiempo hasta el efecto mínimo son:
- Arquitectura jerárquica basada en árboles
- Plano de control distribuido diseñado específicamente
A continuación se muestra una visión general de la arquitectura.
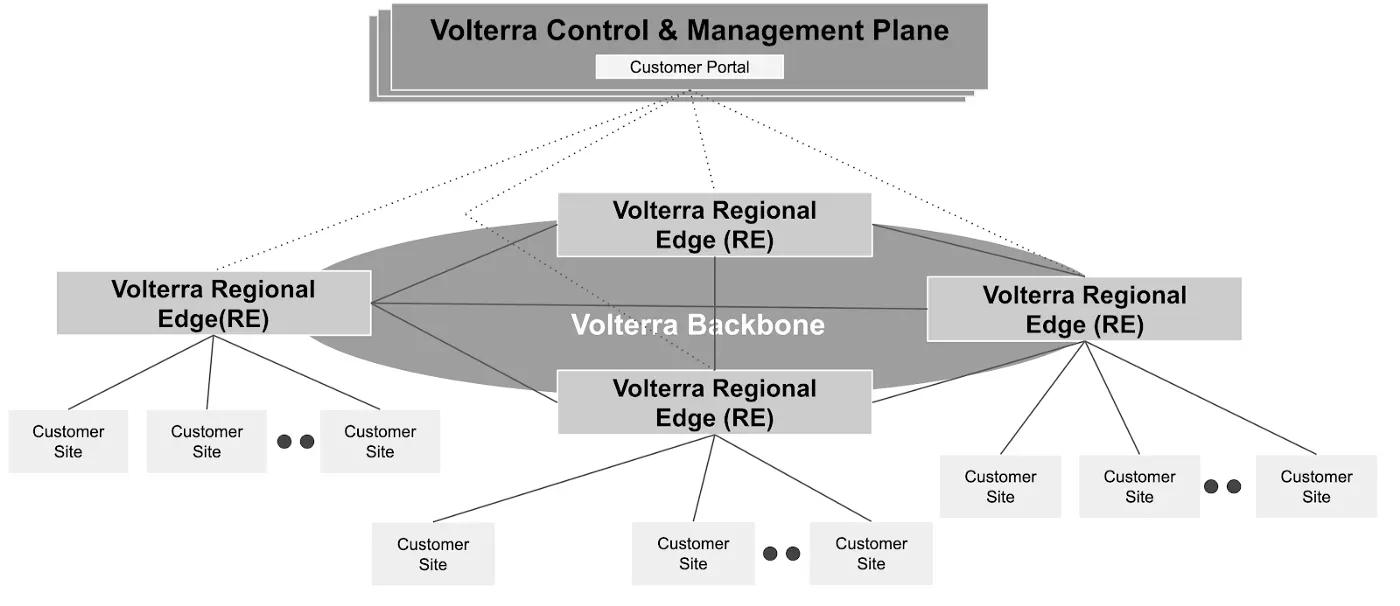
El enfoque de arquitectura jerárquica de Volterra consiste en crear un árbol de nodos para distribuir la configuración. Cada nodo aplica un mecanismo de almacenamiento y reenvío; es decir, almacena la configuración localmente y, a continuación, la reenvía a sus nodos secundarios. La mejor forma de explicarlo es mediante un ejemplo. Cuando un usuario configura un objeto, como una política de red, en Volterra Console, el plano de control y gestión distribuye la configuración a los nodos secundarios inmediatos, los Regional Edges (RE). Cada RE almacena la configuración localmente y la reenvía a sus nodos secundarios. Los nodos secundarios de los RE son los sitios de clientes conectados a cada RE.
Una arquitectura jerárquica basada en árbol garantiza un tiempo de aplicación mínimo. El tiempo de aplicación está limitado por el número de niveles del árbol y el número de nodos secundarios por nodo. El número máximo de niveles del árbol es tres (controlador → RE → sitio del cliente). El número de nodos secundarios por nodo es directamente proporcional al número de sitios conectados al RE. En el RE se crea una instancia de servicio para gestionar la configuración de un conjunto de sitios. El plano de control escalable horizontalmente de Volterra crea nuevas instancias de servicio bajo demanda si aumenta el número de sitios conectados al RE.
Configuración de la prueba
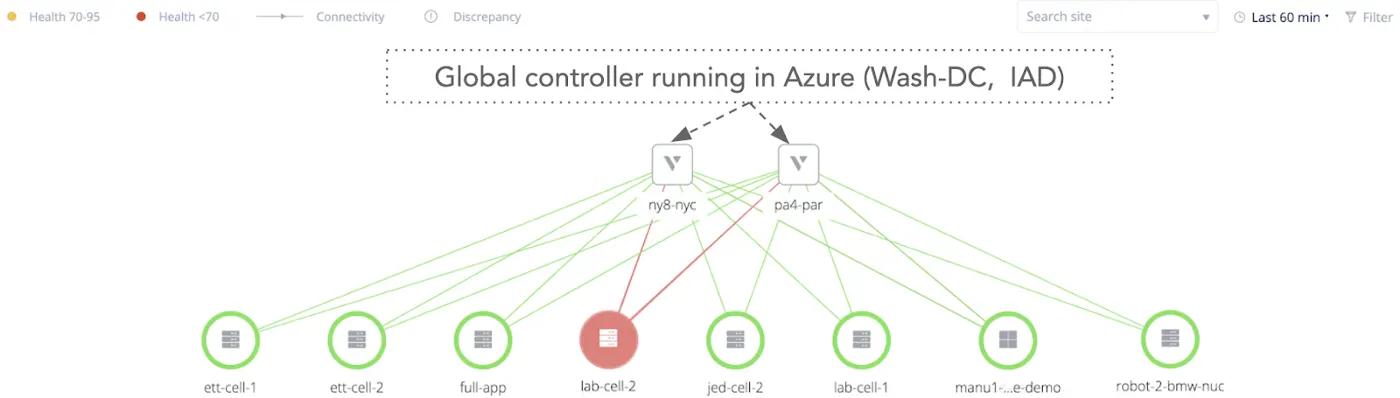
La medición del tiempo hasta que los cambios surtieran efecto se realizó a gran escala en sitios de clientes conectados a dos nodos regionales ubicados en Nueva York (NY8-NYC) y París (PA4-PAR). Los sitios de los clientes estaban distribuidos por todo el mundo, en lugares como Santa Clara (California), Houston (Texas), Madrid (España), Praga (República Checa), Londres (Reino Unido), etc. Además, abarcaban entornos heterogéneos, como AWS, máquinas virtuales (ESXi) y puertas de enlace perimetrales, incluidos dispositivos Intel NUC y Fitlet2.
El portal de clientes y el plano de control global de Volterra se ejecutaban en Azure (Washington-IAD). Los sitios de los clientes estaban distribuidos entre varios espacios de nombres e inquilinos para representar un entorno operativo real.
Las condiciones de fallo se simularon deteniendo instancias de servicio en el RE y utilizando enlaces de conectividad de baja calidad entre el RE y los sitios de los clientes. En la Figura 3 se muestra una instantánea de un segmento de toda la flota en un único espacio de nombres.
Metodología de las pruebas
Los registros de auditoría, con marcas de tiempo, se recopilan en el sistema Volterra cada vez que se configuran objetos en la consola de Volterra y se aplica la configuración en cada sitio del cliente. El tiempo de propagación se midió como la diferencia de tiempo entre la configuración en el portal y su aplicación en el sitio del cliente. A continuación, se describe detalladamente el proceso paso a paso.
- Configure los objetos en el portal del cliente.
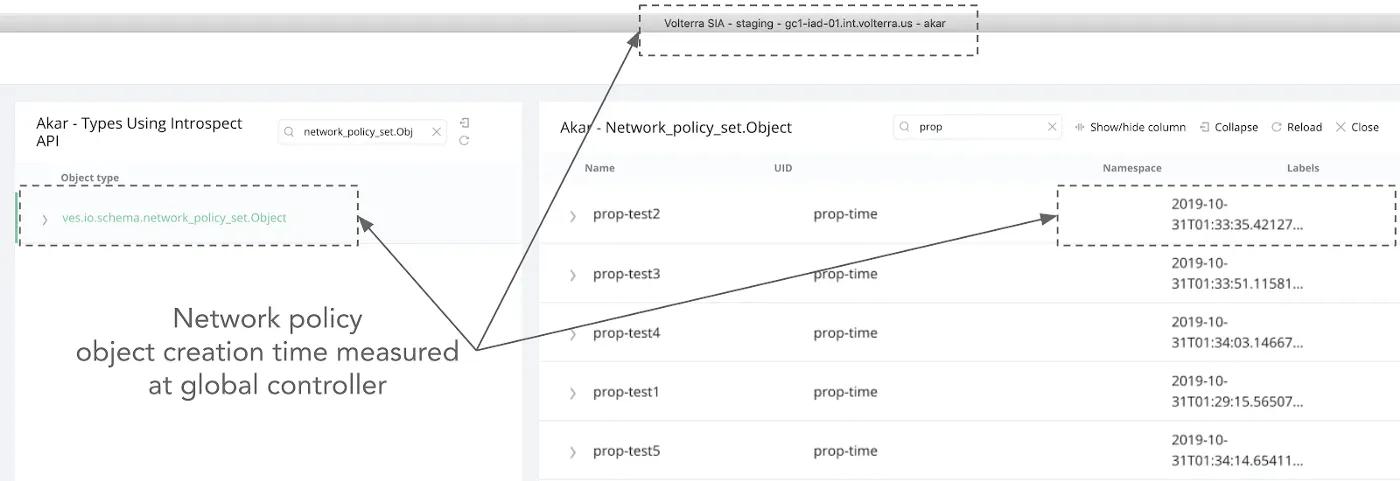
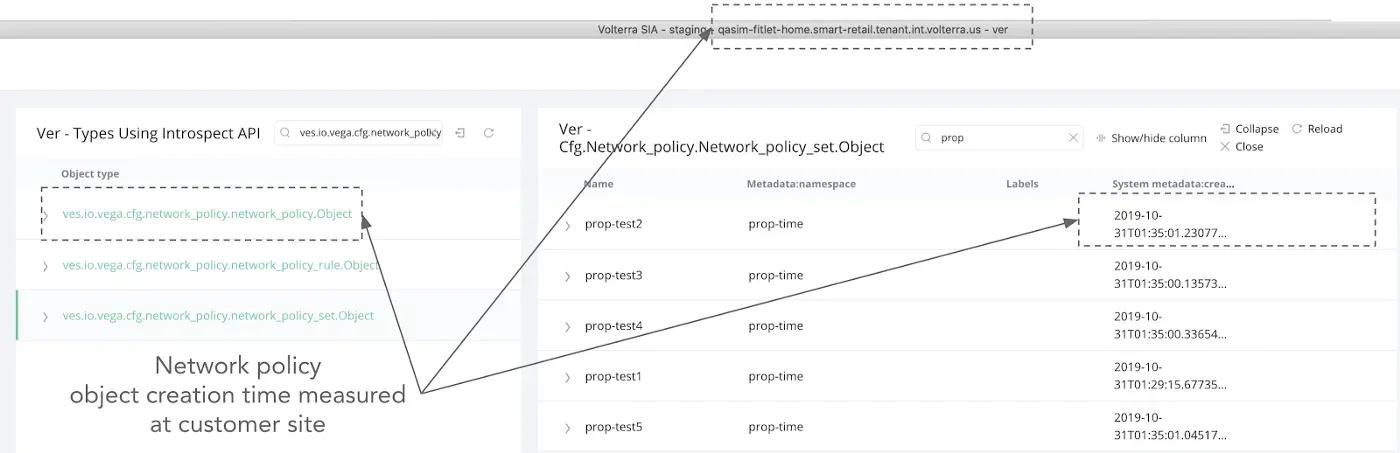
- Mida el tiempo de inicio tomando como referencia la hora de creación del objeto en el portal del cliente (denominado en lo sucesivo «Volterra Global Controller»). Consulte la figura 4 como ejemplo.
- Mida la hora de finalización tomando como referencia la hora de creación del objeto en el sitio del cliente. Véase la figura 5 como ejemplo.
Tenga en cuenta que las capturas de pantalla mostradas son ejemplos y no corresponden a la misma iteración de medición.
Hora de inicio de la configuración
Hora de finalización de la configuración
Resultados de las pruebas
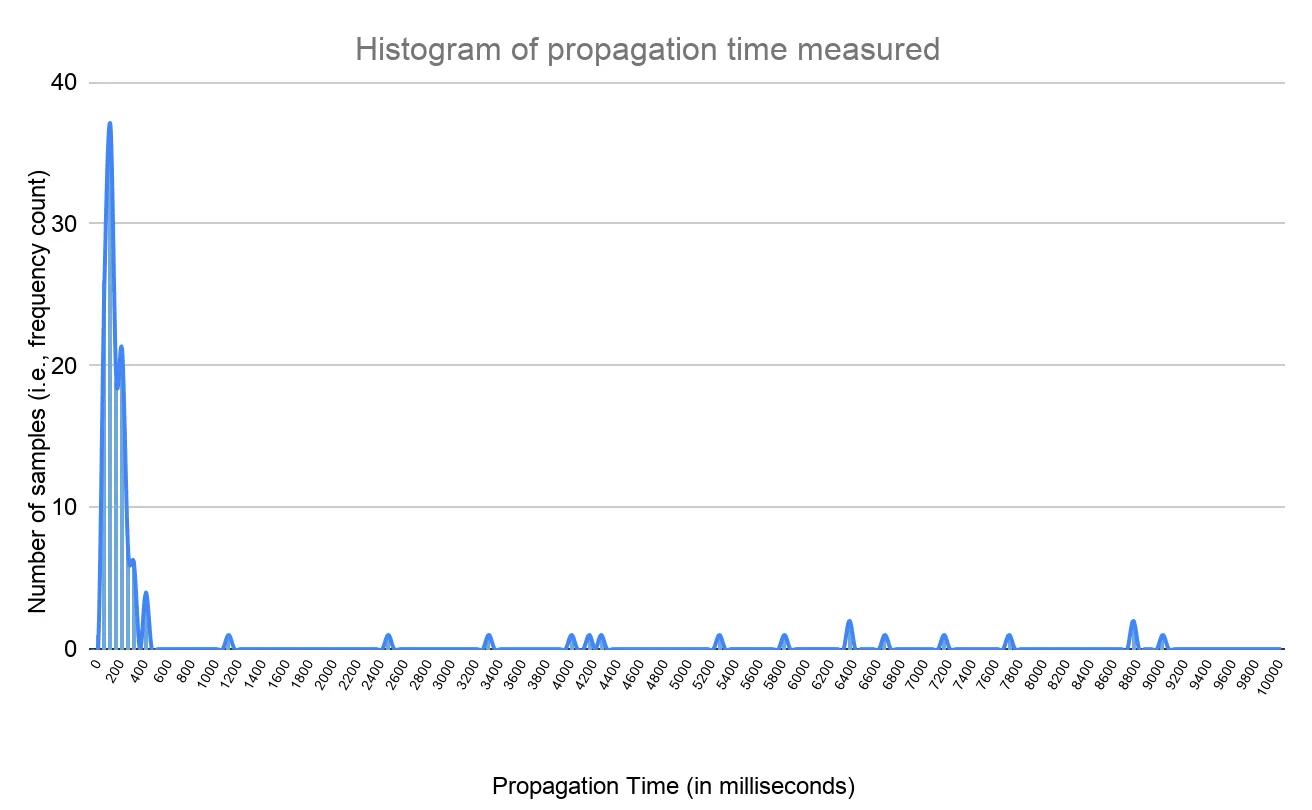
Los resultados de las pruebas de los tiempos de propagación se muestran en las figuras 6 y 7. El gráfico de la figura 6 indica que la mayoría de las muestras de medición tuvieron un tiempo de propagación de entre 0 y 400 ms. Esto significa que todos los sitios de clientes se actualizan con una nueva configuración en un plazo de entre 0 y 400 ms. Como se ha mencionado anteriormente, se simularon condiciones de fallo reiniciando servicios en el RE e introduciendo fallos o retrasos de conectividad en el sitio del cliente. En estas condiciones de fallo, el tiempo de propagación de la configuración es mayor y, en estas pruebas concretas, osciló entre 600 ms y 9 segundos, según el tipo de fallo. Por ejemplo, un fallo de conectividad entre el RE y los sitios de clientes aumentará el tiempo que tarda la configuración en llegar al sitio del cliente. Sin embargo, la ventaja del plano de control distribuido de Volterra es que sigue el paradigma de la configuración con coherencia eventual; es decir, continúa reintentándolo para garantizar que la configuración de todos los sitios de clientes se ajuste a la intención definida por el cliente.
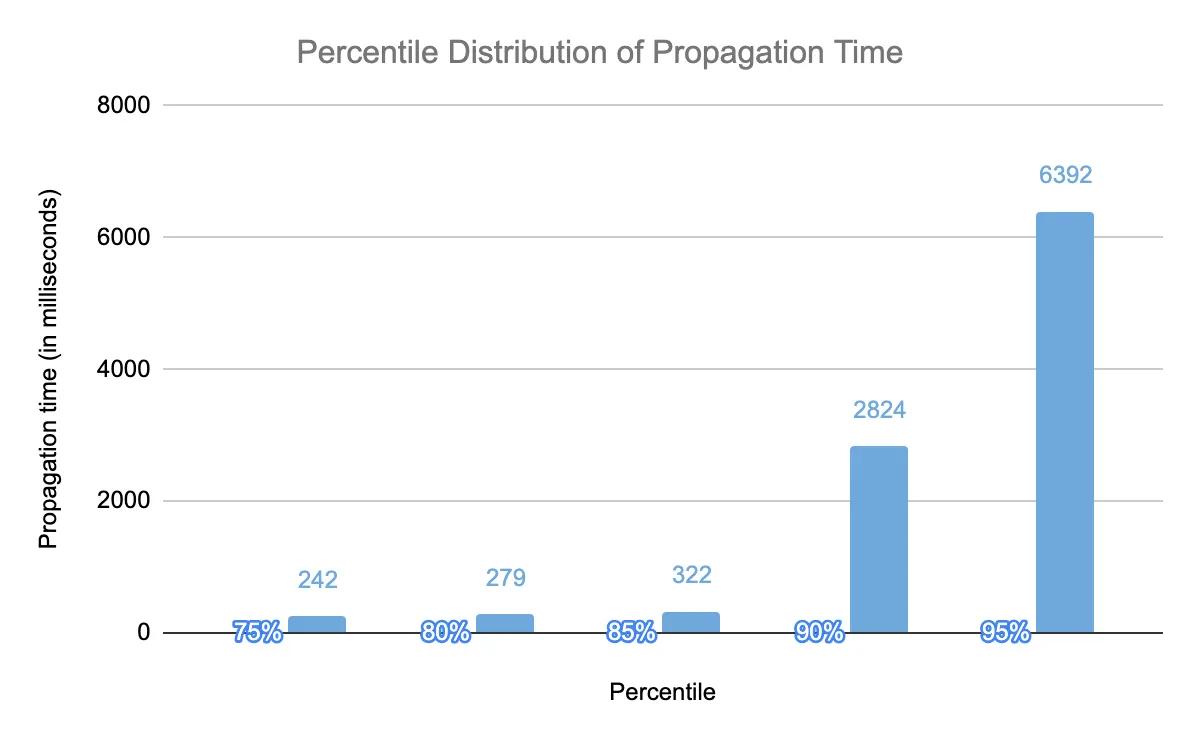
El gráfico de la figura 7 indica que, en el 85 % de los casos, todos los sitios de los clientes se actualizan con una nueva configuración en un plazo de 322 milisegundos. Cuando se producen fallos, algunos sitios de clientes podrían experimentar un tiempo de propagación de entre 3 y 9 segundos aproximadamente.
Aviso legal: Estas mediciones están estrechamente vinculadas a la topología, la escala, el entorno de despliegue y las situaciones de fallo simuladas. No medimos todas las situaciones de fallo posibles ni otros entornos. Por lo tanto, no podemos hacer afirmaciones sobre el retraso de propagación en otras situaciones o entornos que no se hayan probado. Por ejemplo, si se produce un fallo en un clúster de Kubernetes, el sistema tendría que esperar a que se detectara el fallo, reiniciarse y volver a intentar aplicar la configuración, lo que daría lugar a un mayor retraso de propagación.
Blogs relacionados
Sobre el autor
Artículos relacionados del blog

Cree servicios públicos seguros, resilientes y preparados para la IA con F5 y AWS
Descubre cómo las organizaciones del sector público pueden modernizar de forma segura sus aplicaciones y soluciones de IA, al tiempo que gestionan los sistemas heredados, el cumplimiento normativo y el riesgo operativo.

Protección de los sistemas de IA: por qué la seguridad debe avanzar al ritmo de la innovación
Desde acelerar avances revolucionarios en medicina y educación hasta transformar la vida cotidiana, la IA está cambiando nuestra forma de vivir y trabajar. Pero también ofrece grandes oportunidades a los ciberdelincuentes.
Avanzar hacia la optimización digital tras la transformación
Descubre estrategias de optimización digital para garantizar políticas de seguridad coherentes, impulsar la madurez de la transformación digital y superar los retos de la transformación.
Proyecto de código abierto destacado: mayor observabilidad con F5 Cloud Logger iApp
En el punto de mira del código abierto: cómo aumentar la observabilidad. Lee el blog de F5 para descubrir cómo exportar fácilmente la telemetría de BIG-IP a plataformas modernas de análisis en la nube.
El estado de la entrega de aplicaciones en 2018: la transformación digital impulsa la automatización y la multinube pese a las preocupaciones de seguridad
Descubre las principales conclusiones del cuarto informe anual de F5 sobre el estado de la entrega de aplicaciones.
Estado de la entrega de aplicaciones en 2017: automatización, API y DevOps
Descubre el informe sobre el estado de la entrega de aplicaciones de 2017. Lee el blog retrospectivo de F5 sobre los inicios del auge de las redes declarativas y los flujos de DevOps.