
Esta entrada de blog es la tercera de una serie sobre el suministro de datos para la IA.
La IA generativa puede parecer sencilla a primera vista. Sin embargo, detrás de cada modelo exitoso hay una canalización de datos tan compleja y delicada como una refinería industrial.
Los líderes en IA señalan sistemáticamente que el mayor obstáculo para ampliar la IA no son los modelos, sino el flujo de datos que los alimenta. McKinsey & Company estima que la demanda empresarial de infraestructuras de datos preparadas para la IA crece más de un 30 % al año, mientras que las necesidades de datos de los entornos de entrenamiento de modelos aumentan aún más rápido. Por eso, cuando estas canalizaciones fallan, incluso las GPU más avanzadas permanecen inactivas.
Una breve analogía ayuda a contextualizar el reto.
“Piense en un flujo de datos de IA como si fuera una moderna cadena de montaje industrial. Las materias primas (los datos empresariales) deben recopilarse, inspeccionarse y prepararse correctamente antes de entrar en la cadena.”
A continuación, se perfeccionan mediante una serie de procesos de precisión —limpieza, etiquetado, conversión y validación— para que cumplan estrictos estándares de calidad. Por último, los componentes terminados deben dirigirse de forma eficiente a las estaciones de producción adecuadas en el momento oportuno. Si alguna fase presenta incoherencias, retrasos o desajustes, toda la operación se atasca, igual que una cadena de montaje se detiene cuando falla una de sus estaciones de trabajo.
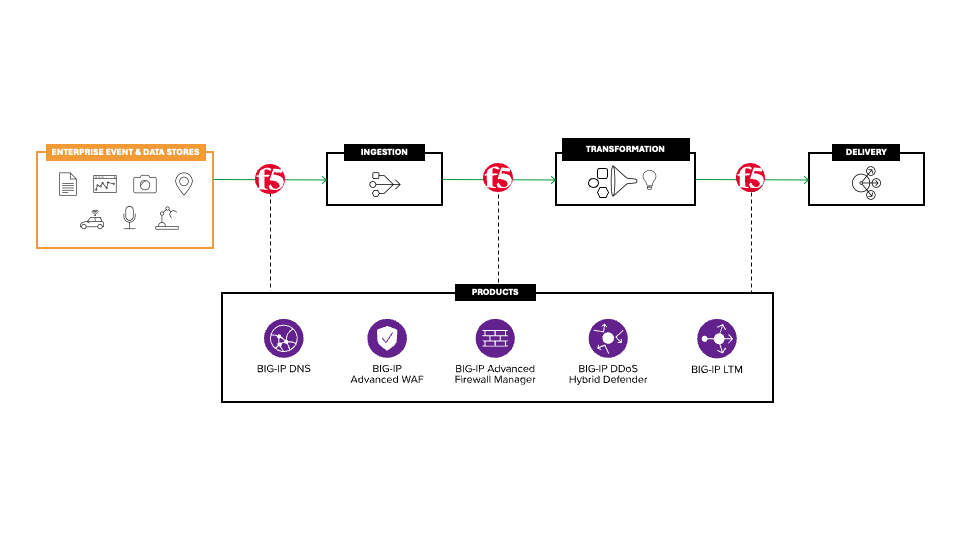
Al igual que las materias primas deben recopilarse, refinarse y entregarse en la estación de producción, los datos empresariales deben pasar por las fases de ingesta, transformación y entrega antes de poder utilizarse para entrenar o ajustar modelos, o para la generación aumentada por recuperación (RAG). Si alguna etapa se contamina o se retrasa, todo el sistema de IA se ve comprometido, lo que repercute negativamente en el negocio y reduce el retorno de la inversión.
Este artículo analiza esas tres etapas y explica cómo F5 BIG-IP y el almacenamiento de objetos compatible con S3 respaldan los flujos de trabajo de las fábricas de modelos en los que confían actualmente las empresas.
Fase 1: Ingesta: captura y consolidación del material en bruto
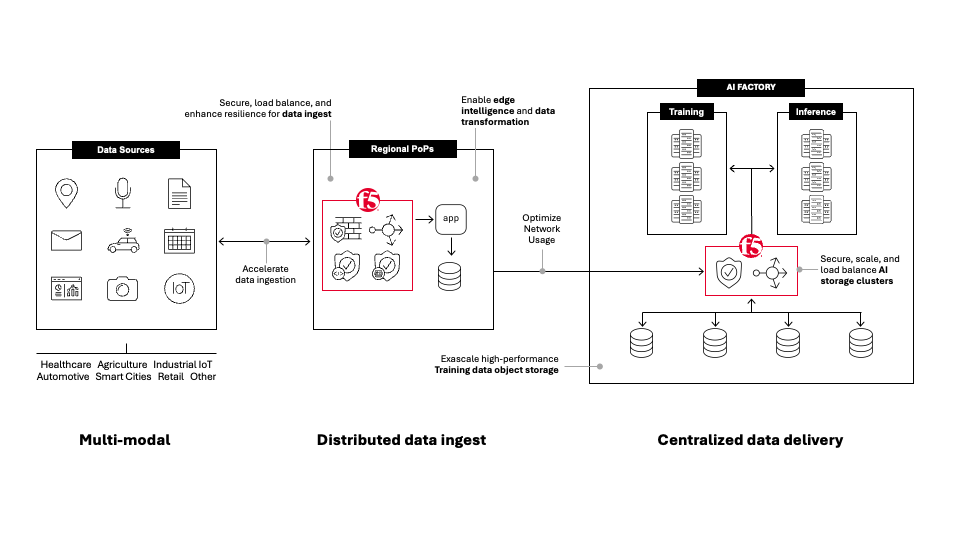
La ingesta es el momento en que los datos entran en el ecosistema de la IA. Las empresas rara vez cuentan con una única fuente de información fiable; sus «materias primas» se encuentran repartidas entre sistemas departamentales, servicios en la nube, almacenes de objetos, herramientas SaaS, registros, API e incluso datos externos de terceros. Gran parte de estos datos llega en distintos formatos, con diferentes frecuencias y con niveles de integridad variables.
Durante esta fase, los datos deben identificarse, autenticarse, normalizarse y validarse a medida que se incorporan a almacenes de objetos centralizados o distribuidos. Se añaden metadatos, se establecen correspondencias entre esquemas y se realizan controles de calidad preliminares. Si la ingesta es deficiente, el resto del flujo de procesamiento hereda esas deficiencias. La deriva de los modelos —es decir, su degradación con el tiempo—, las alucinaciones y la inestabilidad de las tareas de entrenamiento suelen deberse a una ingesta incoherente o mal gestionada.
Aquí es también donde la fragilidad de las conexiones se convierte en un problema real. En muchos entornos altamente distribuidos, las conexiones de larga duración con sistemas remotos se interrumpen de forma inesperada. Sin las medidas de protección adecuadas, estos fallos dejan abiertas sesiones abandonadas en el entorno de almacenamiento de objetos, lo que consume recursos poco a poco y afecta a la fiabilidad del entorno.
F5 BIG-IP aporta estabilidad en este ámbito al gestionar esas conexiones, evitar el consumo descontrolado de recursos y garantizar que las transferencias de datos se completen de forma predecible, incluso cuando la red de origen es deficiente. Las capacidades consolidadas de BIG-IP —autenticación integrada (incluidas la validación de tokens, la integración de identidades y la autenticación TLS mutua), gestión del tráfico, protección de API y defensa contra ataques DDoS— también protegen los datos confidenciales que se incorporan a la organización.
Con estas medidas de protección, los datos llegan de forma fiable a los sistemas de almacenamiento compatibles con S3 que alimentan la siguiente fase.
Fase 2: Transformación: perfeccionamiento de los datos para que estén listos para el modelo
Si la ingesta carga la materia prima, la transformación es la refinería que la convierte en activos de datos de alta calidad listos para los modelos. El trabajo que se realiza aquí es mucho más complejo de lo que muchos equipos esperan, y un número sorprendente de proyectos de IA fracasa en esta fase. Los entornos de creación de modelos dependen de datos coherentes y bien gobernados; cuando los datos contienen ruido, son incoherentes, tienen un formato deficiente o están mal etiquetados, el entrenamiento se vuelve inestable y la calidad del modelo disminuye.
La transformación implica limpiar, convertir y preparar los datos para que puedan utilizarse en el entrenamiento y el ajuste fino de modelos, o en la generación aumentada por recuperación (RAG).
Los documentos y archivos PDF se convierten en texto estructurado o embeddings vectoriales. Las imágenes y los registros se procesan en formatos estándar. Se corrigen los valores ausentes. La información confidencial se oculta o cifra. Se registra el linaje de los datos para que los organismos reguladores puedan rastrear cómo se produjeron o modificaron determinados activos. En los flujos de trabajo de RAG, también es aquí donde se llevan a cabo la estrategia de fragmentación, la generación de embeddings y las actualizaciones de los índices.
Tradicionalmente, la transformación se realizaba en un entorno centralizado, pero este modelo está cambiando. A medida que el volumen de datos crece de forma exponencial, cada vez tiene más sentido realizar parte de la transformación en el extremo de la red o cerca de las fuentes de datos.
F5 BIG-IP permite enriquecer y depurar los datos de forma distribuida mediante formatos flexibles que pueden situarse más cerca de sus puntos de origen. Al combinarlo con un almacenamiento de objetos flexible y compatible con S3 implementado en el perímetro, las organizaciones pueden filtrar y depurar los datos antes de enviarlos de vuelta al canal de procesamiento central. Esto reduce los costes de tráfico y minimiza el riesgo de transferir contenido innecesario o que no cumpla la normativa.
Una vez completada la transformación, la organización dispone de activos depurados, fiables y seguros, listos para los sistemas de procesamiento posteriores.
Fase 3: Entrega: trasladar los datos optimizados a los recursos informáticos adecuados en el momento oportuno
La entrega es el punto en el que los datos depurados llegan a los clústeres de GPU, las tareas de ajuste fino, las bases de datos vectoriales o los procesos de RAG que dependen de ellos.
Los usuarios y los operadores perciben de inmediato la calidad de la entrega. Si los datos llegan demasiado despacio, las GPU se quedan sin datos que procesar. Si el enrutamiento es ineficiente, los trabajos permanecen en cola más tiempo del previsto. Si los controles de acceso son deficientes, los conjuntos de datos confidenciales quedan expuestos.
Una etapa de entrega bien diseñada garantiza que los datos se transfieran de forma rápida y uniforme desde el almacenamiento hasta los recursos de computación. Las rutas de acceso de alto rendimiento permiten que los trabajos de entrenamiento distribuido lean datos en paralelo desde el almacenamiento de objetos. El almacenamiento inteligente en caché mejora el rendimiento.
Los flujos de trabajo automatizados programan las ejecuciones de entrenamiento, escalan los recursos y enrutan las consultas de búsqueda semántica. Las herramientas de monitorización realizan un seguimiento de la latencia, el rendimiento y las anomalías de funcionamiento.
La seguridad sigue siendo fundamental en este punto. El acceso debe controlarse en el momento de uso, no solo durante la ingesta, para garantizar que cada conjunto de datos esté disponible únicamente para los modelos, procesos o usuarios adecuados.
F5 BIG-IP contribuye a ello aplicando políticas, validando tokens y supervisando los patrones de las solicitudes. También optimiza la distribución del tráfico para que los datos fluyan hacia los recursos informáticos de la forma más eficiente posible.
Cuando se combinan con un almacenamiento escalable compatible con S3, estas capacidades crean un entorno que suministra datos de forma continua a las tareas de entrenamiento y ajuste fino, lo que reduce el tiempo de inactividad de las GPU y mantiene un rendimiento predecible.
Cómo se integran las tres etapas
Aunque la ingesta, la transformación y la entrega son procesos distintos, funcionan como un ciclo continuo.
La ingesta garantiza que datos actualizados y sujetos a gobernanza procedentes de toda la empresa entren en el sistema. La transformación depura esos datos para convertirlos en activos de alta calidad aptos para el entrenamiento, la indexación RAG o el ajuste fino. La entrega traslada esos activos a los recursos informáticos adecuados con rapidez e integridad.
La debilidad en cualquiera de las áreas ralentiza toda la operación. Además, los fallos en los flujos de datos son generalizados. En conjunto, más del 80 % de los proyectos empresariales de IA fracasan, según diversas fuentes, muchas de las cuales también señalan que entre el 70 % y el 80 % de esos fracasos se atribuyen a una calidad de los datos deficiente o insuficiente.
Pero cuando el flujo de trabajo funciona sin problemas de principio a fin, respaldado por servicios de red seguros y resilientes como BIG-IP y por un almacenamiento escalable compatible con S3, las organizaciones pueden entrenar modelos más rápido, perfeccionarlos con mayor confianza y operar entornos de creación de modelos a escala industrial.
F5 distribuye y protege aplicaciones de IA en cualquier lugar
Para obtener más información sobre nuestras soluciones de suministro de datos para IA, visite nuestra página de Soluciones de suministro de datos e infraestructura para IA .
El enfoque de F5 en la IA no se limita a la entrega de datos. Descubre cómo F5 protege y distribuye aplicaciones de IA en cualquier entorno.
No te pierdas las demás entradas de nuestro blog de la serie sobre entrega de datos para IA:
Impulsando el flujo de datos de IA con F5 y almacenamiento compatible con S3
Por qué el almacenamiento para IA exige un nuevo enfoque del equilibrio de carga
Prácticas recomendadas para optimizar la infraestructura de IA a gran escala
Implementación de aplicaciones de IA a gran escala: el papel de los ADC
Proteja su canalización de datos de IA sin ralentizarla
Sobre los autores
Mark Menger es arquitecto de soluciones en F5 y está especializado en alianzas tecnológicas en los ámbitos de la IA y la seguridad. Lidera el desarrollo de la arquitectura de referencia de IA de F5, impulsando soluciones de IA seguras y escalables. Gracias a su experiencia como arquitecto de soluciones globales e ingeniero de soluciones, Mark contribuyó a la arquitectura de nube segura de F5 y participó en el desarrollo de su arquitectura distribuida de cuatro niveles. Como coautor de Solving IT Complexity, aporta su experiencia en la resolución de retos de TI. Anteriormente, trabajó como desarrollador de aplicaciones y arquitecto empresarial, centrándose en las aplicaciones modernas, la automatización y la aceleración del valor obtenido de las inversiones en IA.
Más artículos de Mark MengerArtículos relacionados del blog

IA agéntica en ciberseguridad: promesas y riesgos
Descubre por qué el uso de la IA agéntica en ciberseguridad es esencial para combatir las amenazas impulsadas por IA y por qué los agentes también generan nuevos riesgos empresariales.

Cómo los clientes de F5 del sector financiero abordan la soberanía digital sin frenar la innovación
¿Cómo se materializa la soberanía digital en el mundo real? Dos proyectos recientes de F5 con clientes muestran cómo distintas empresas están afrontando estos retos.

Soberanía operativa: cómo desarrollar resiliencia en un mundo impredecible
Para muchas organizaciones, la cuestión ya no consiste únicamente en controlar los datos, sino en mantener la capacidad de operar, adaptarse y recuperarse a medida que evolucionan las leyes y las circunstancias.

No se puede proteger una conversación con un cortafuegos: cómo el red teaming de IA se volvió esencial
Dado que las implementaciones de IA avanzan a la velocidad de las máquinas, los métodos tradicionales de prueba de software ya no resultan adecuados.

Protege tu canalización de datos de IA sin ralentizarla
Proteger el flujo de datos de la IA no es opcional. Eso está claro. Lo que resulta mucho menos evidente —y mucho más difícil— es cómo protegerlo adecuadamente.

Las extranets no están muertas; solo necesitan una actualización
Modernice su extranet: descubra cómo F5 y Equinix ofrecen una conectividad para partners repetible, segura y escalable, sin la complejidad de las redes tradicionales.