Esta entrada del blog es la segunda de una serie sobre el suministro de datos para la IA.
A medida que se acelera el uso de la IA, las canalizaciones de datos deben escalar aún más rápido para evitar cuellos de botella y mantener el rendimiento. Estudios recientes de empresas como McKinsey & Company indican que se prevé que la demanda de capacidad de centros de datos preparados para la IA crezca aproximadamente un 33 % anual hasta 2030. Esto significa que incluso las mejores arquitecturas de modelos carecerán de datos suficientes si la canalización que los suministra no escala al mismo ritmo.
Sin embargo, a medida que aumentan las cargas de trabajo de IA, las organizaciones están descubriendo rápidamente una realidad sorprendente: las ralentizaciones rara vez se deben al propio proceso de entrenamiento o ajuste fino de los modelos; su origen está en la canalización de datos previa, que debe abastecer continuamente a la fábrica de modelos con grandes volúmenes de datos de alta calidad.
“Las últimas innovaciones permiten a F5 BIG-IP ofrecer la gestión inteligente del tráfico, la optimización de las rutas de datos y los controles de seguridad necesarios para mantener un flujo de datos de IA de gran volumen y a alta velocidad en los procesos de entrenamiento, generación de embeddings y ajuste fino.”
Los sistemas de IA modernos dependen de un movimiento rápido y predecible de los datos entre almacenes de objetos, capas de recuperación, canalizaciones de características y flujos de trabajo de generación de embeddings, así como hacia los puntos de conexión de inferencia, cuando corresponda. Cuando este «flujo» se ralentiza, el rendimiento se desploma, las GPU quedan inactivas y la empresa tarda más de lo previsto en empezar a obtener valor.
Una analogía útil es la de los oleoductos, a la que recurrimos en la primera entrada de blog de esta serie. Puede que disponga de la refinería más avanzada del mundo, es decir, del modelo de lenguaje de gran tamaño (LLM), del motor de búsqueda vectorial o del clúster de creación de modelos multimodales utilizado para entrenar, ajustar o generar embeddings. Pero si los conductos que abastecen esa refinería son estrechos, tienen fugas o están congestionados, la producción se paraliza. El problema no es el proceso de refinado, sino el sistema de transporte. Las canalizaciones de IA actuales funcionan según el mismo principio: el flujo de datos determina el rendimiento del sistema.
Dónde se originan realmente los cuellos de botella de la IA
Los flujos de procesamiento de IA rara vez fallan en un único punto; se ralentizan a lo largo de una cadena de microinteracciones. Un solo flujo de trabajo puede implicar extraer conjuntos de datos de entrenamiento, repositorios de conocimiento empresarial o embeddings del almacenamiento de objetos, transformar esos datos para su ingesta, consultar una base de datos vectorial, realizar llamadas a varios microservicios y, solo entonces, pasar a las fases de ajuste fino o creación de modelos.
Cada paso puede introducir fricciones. Por separado, los retrasos parecen insignificantes, pero, en conjunto, alargan los tiempos de procesamiento de principio a fin y privan a las GPU de los datos que necesitan, especialmente en tareas de entrenamiento o de aumento de datos a gran escala.
Es como un oleoducto que sufre una caída de presión, válvulas desajustadas y subidas de presión inesperadas. El flujo se vuelve irregular y las instalaciones situadas más adelante nunca reciben un suministro constante y predecible. Los sistemas de producción de modelos de IA experimentan el mismo fenómeno cuando los nodos de almacenamiento se ralentizan, las rutas de red se degradan o las cargas de trabajo aumentan de forma imprevisible.
Los estudios disponibles lo dejan meridianamente claro: los problemas de rendimiento de la IA suelen tener su origen en el flujo de procesamiento de datos, no en el modelo. En una encuesta de Fivetran, el 42 % de las empresas indicó que más de la mitad de sus proyectos de IA se habían retrasado, habían rendido por debajo de lo esperado o habían fracasado porque sus datos no estaban preparados o no eran accesibles a tiempo.
Otro estudio de Broadcom reveló que el 96 % de las organizaciones afirma que los problemas de rendimiento de sus flujos de procesamiento de datos perjudicaron directamente sus objetivos de IA, lo que provocó retrasos en los flujos de trabajo de entrenamiento y preparación, una menor automatización y costosas repeticiones del trabajo.
Estas cifras ponen de manifiesto una realidad fundamental: cuando los datos no pueden circular de forma rápida o fiable por el flujo de procesamiento, ni siquiera las operaciones de producción de modelos más sofisticadas pueden ofrecer resultados consistentes.
Cómo F5 BIG-IP moderniza la entrega de datos para la IA
Con el lanzamiento de F5 BIG-IP versión 21, BIG-IP ha evolucionado mucho más allá de su función como controlador de entrega de aplicaciones (ADC) tradicional. Ahora es un ADC totalmente modernizado, diseñado para canalizaciones de datos impulsadas por IA, especialmente las basadas en almacenamiento de objetos compatible con S3.
Las nuevas innovaciones permiten a F5 BIG-IP ofrecer la gestión inteligente del tráfico, la optimización de las rutas de datos y los controles de seguridad necesarios para mantener los datos de IA en movimiento a gran escala y a alta velocidad en los flujos de trabajo de entrenamiento, generación de embeddings y ajuste fino, y no solo de inferencia.
Está diseñado para estabilizar y acelerar todo el flujo. Al actuar como una capa de entrega entre el almacenamiento de objetos y la pila de aplicaciones de IA, garantiza que la entrada, la recuperación y el enrutamiento de los datos se mantengan fluidos, seguros y resilientes, incluso bajo cargas intensas.
BIG-IP supervisa continuamente el estado de los nodos de almacenamiento y redirige automáticamente el tráfico para evitar los puntos de conexión lentos o con fallos. Sus optimizaciones específicas para S3, como los perfiles TCP/TLS mejorados para cargas multiparte de gran tamaño, ayudan a reducir la sobrecarga de las solicitudes y a acelerar las lecturas de grandes volúmenes de datos. El tráfico también puede dirigirse en función de metadatos, como el tamaño del objeto, el prefijo o el bucket, lo que permite a las organizaciones asignar distintas prioridades a los conjuntos de datos de ajuste fino, los artefactos de entrenamiento o los datos de embeddings para RAG según las necesidades operativas.
Pilares clave: enrutamiento basado en la ubicación, almacenamiento en caché y seguridad
Otro factor importante en la eficacia de BIG-IP es cómo gestiona el enrutamiento basado en la ubicación. Cuando una región de almacenamiento experimenta latencia o un clúster está en mantenimiento, los flujos se redirigen de forma transparente a un sitio que funciona correctamente, sin necesidad de modificar las propias aplicaciones. Esto mantiene un suministro continuo de datos al flujo de procesamiento de IA, independientemente de lo que ocurra en la capa de almacenamiento subyacente.
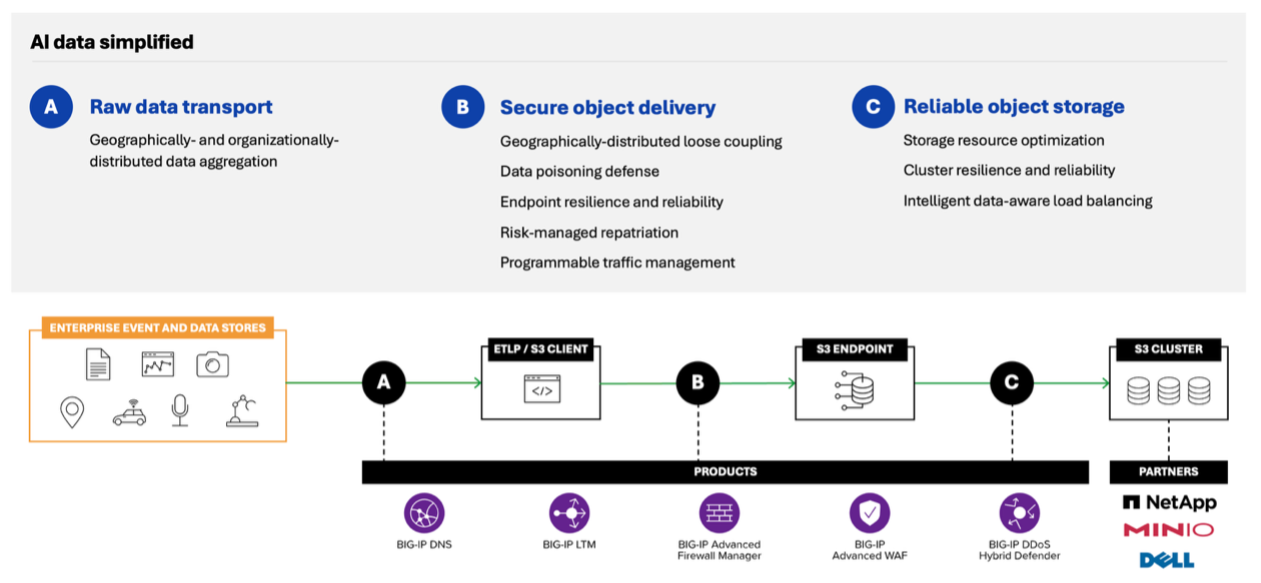
La gestión del tráfico y la seguridad deben estar plenamente integradas en el ecosistema de transporte de datos. Los puntos de conexión de datos de IA son costosos de mantener operativos y constituyen objetivos valiosos para los atacantes. Como se muestra en el siguiente diagrama, BIG-IP proporciona funciones clave de entrega y seguridad a los flujos de procesamiento de datos de IA. La protección avanzada contra ataques DDoS, las funciones de WAF y la gobernanza granular de las API hacen que la seguridad forme parte del flujo de procesamiento de datos, en lugar de convertirse en un cuello de botella.
La importancia de la resiliencia y la fiabilidad
Incluso las canalizaciones optimizadas sufren interrupciones. Los picos de tráfico, los fallos de los nodos, las ráfagas de replicación y los cambios en la red pueden degradar el rendimiento de la IA. La resiliencia es la capacidad de mantener el flujo de datos a pesar de estas condiciones. BIG-IP destaca en este ámbito al ofrecer conmutación por error activa, vaciado del tráfico durante las tareas de mantenimiento y políticas de enrutamiento programables que mantienen estable la canalización.
En la práctica, esto significa que los almacenes de datos siguen estando disponibles y accesibles. Los ciclos de entrenamiento mantienen su ritmo. Los procesos de generación de embeddings para RAG y de aumento de datos se completan según lo previsto. Y la empresa evita los fallos en cascada que se producen cuando una capa de la pila de IA se sobrecarga o deja de estar disponible.
BIG-IP actúa como el sistema de control de presión, equilibrado de caudal y válvulas de seguridad de toda la canalización de datos de IA. Garantiza que la refinería, es decir, la factoría de modelos de IA, disponga siempre del flujo constante de «petróleo» de alta calidad que necesita.
F5 distribuye y protege las aplicaciones de IA en cualquier entorno
La optimización del rendimiento de la IA no se limita a la inferencia de modelos. Se trata de garantizar que los enormes volúmenes de datos necesarios para los flujos de trabajo de entrenamiento, ajuste fino y generación de embeddings se transfieran de forma rápida, predecible y segura.
Para obtener más información sobre nuestras soluciones de entrega de datos de IA, visita la sección «Soluciones de entrega de datos e infraestructura de IA» de nuestro sitio web.
El compromiso de F5 con la IA va más allá de la entrega de datos. Descubra cómo F5 protege y distribuye aplicaciones de IA en cualquier lugar.
No te pierdas las demás entradas de nuestra serie del blog sobre la entrega de datos para la IA:
Impulsar el flujo de datos de IA con F5 y almacenamiento compatible con S3
Seguimiento de los flujos de datos de IA desde la ingesta hasta la entrega
Por qué el almacenamiento para la IA exige un nuevo enfoque del equilibrio de carga
Buenas prácticas para optimizar la infraestructura de IA a gran escala
Despliegue de aplicaciones de IA a gran escala: el papel de los ADC
Protege tus flujos de datos de IA sin ralentizarlos
Sobre el autor
Hunter Smit es director sénior de marketing de producto para soluciones y estrategia en F5. Lidera el marketing de soluciones de toda la cartera de F5, incluidas la infraestructura de IA y la seguridad de aplicaciones, e impulsa la entrada de F5 en el mercado emergente de la entrega de datos para IA. Hunter es miembro del Consejo Asesor de la Escuela de Negocios de la Universidad Whitworth y ha ejercido como profesor adjunto de marketing de producto. Obtuvo un MBA y un grado en Administración y Dirección de Empresas, con especialización en gestión, por la Universidad Whitworth.
Más artículos de Hunter SmitArtículos relacionados del blog
IA agéntica en ciberseguridad: promesas y riesgos
Descubre por qué el uso de la IA agéntica en ciberseguridad es esencial para combatir las amenazas impulsadas por IA y por qué los agentes también generan nuevos riesgos empresariales.
Cómo los clientes de F5 del sector financiero abordan la soberanía digital sin frenar la innovación
¿Cómo se materializa la soberanía digital en el mundo real? Dos proyectos recientes de F5 con clientes muestran cómo distintas empresas están afrontando estos retos.
Soberanía operativa: cómo desarrollar resiliencia en un mundo impredecible
Para muchas organizaciones, la cuestión ya no consiste únicamente en controlar los datos, sino en mantener la capacidad de operar, adaptarse y recuperarse a medida que evolucionan las leyes y las circunstancias.
No se puede proteger una conversación con un cortafuegos: cómo el red teaming de IA se volvió esencial
Dado que las implementaciones de IA avanzan a la velocidad de las máquinas, los métodos tradicionales de prueba de software ya no resultan adecuados.
Protege tu canalización de datos de IA sin ralentizarla
Proteger el flujo de datos de la IA no es opcional. Eso está claro. Lo que resulta mucho menos evidente —y mucho más difícil— es cómo protegerlo adecuadamente.

Las extranets no están muertas; solo necesitan una actualización
Modernice su extranet: descubra cómo F5 y Equinix ofrecen una conectividad para partners repetible, segura y escalable, sin la complejidad de las redes tradicionales.