Qu’advient-il du score de sécurité de votre modèle d’IA lorsque vous cessez de le tester ?
La plupart des équipes pensent que la réponse est « rien », car elles ont mené une évaluation red team avant le lancement, obtenu un bon score, puis sont passées à autre chose. Pourtant, toutes les organisations font évoluer simultanément les trois mêmes dimensions : la vitesse, l’échelle et la sécurité. Elles veulent déployer rapidement des fonctionnalités d’IA, préserver leur fiabilité et atteindre ces deux objectifs sur un parc croissant de modèles, d’agents et d’intégrations, sans aucun compromis.
Mais dans la pratique, privilégier fortement l’un de ces aspects se fait presque toujours au détriment d’un autre. Une équipe qui déploie un modèle mis à jour toutes les quelques semaines ne peut pas consacrer six semaines à un examen manuel à chaque fois. Les résultats du mois précédent sont donc considérés comme toujours valables, ou un modèle non validé reste exposé. Le Red teaming était autrefois une simple case à cocher avant le lancement, mais les tests statiques et ponctuels ne peuvent désormais plus suivre le rythme auquel évoluent les menaces liées à l’IA.
“Le red teaming appliqué à l’IA est une pratique continue qui doit évoluer au même rythme que les systèmes qu’il protège.”
Les tests génériques et standardisés ne permettent pas de suivre l’évolution des risques propres aux processus, au secteur d’activité et aux contraintes réglementaires de chaque organisation. C’est précisément pourquoi les professionnels ont besoin d’exercices de red teaming adaptés à leur environnement spécifique, et pourquoi certains clients les intègrent déjà directement à leurs pipelines et à leur infrastructure.
Ce que mesurent réellement les scores CASI et ARS
Les tests statiques peuvent vous indiquer qu’un modèle a réussi à un instant donné, mais pas comment il résiste à des attaques prolongées, sophistiquées ou évolutives. C’est pourquoi F5 Labs a développé deux indicateurs objectifs, le Comprehensive AI Security Index (CASI) et l’Agentic Resistance Score (ARS), afin de permettre aux équipes de sécurité d’évaluer clairement les modèles, de suivre l’évolution de leur niveau de sécurité et de rendre compte des risques à la direction. Voici ce que chacun mesure réellement.
Indice global de sécurité de l’IA (CASI) – Le CASI est un indicateur composite conçu pour mesurer la sécurité globale d’un modèle (méthodologie ici). Il prend notamment en compte le nombre d’attaques réussies, la gravité des conséquences qu’elles auraient pu avoir et les efforts nécessaires à un attaquant pour parvenir à ses fins. Plus le score est élevé, plus le niveau global de sécurité du modèle est robuste.
Score de résistance agentique (ARS) – L’ARS mesure la capacité de l’ensemble du système d’IA à résister lorsqu’une équipe d’agents d’attaque autonomes tente activement de le compromettre, d’en extraire des informations sensibles, d’en cartographier l’architecture ou de manipuler le modèle par ingénierie sociale. Un ARS élevé signifie que le système maintient ses garde-fous même face à une pression ciblée et prolongée, et pas seulement lors d’une tentative isolée.
Comment nous voyons CASI, ARS et F5 AI Red Team utilisés en pratique
La plupart des équipes de sécurité utilisent déjà des outils traditionnels tels que les tests statiques de sécurité des applications (SAST) pour analyser le code source, et les tests dynamiques de sécurité des applications (DAST) pour tester l’application en cours d’exécution. Aucun de ces outils n’a été conçu pour déterminer si le modèle d’IA sous-jacent à l’application peut être trompé, manipulé ou progressivement affaibli.
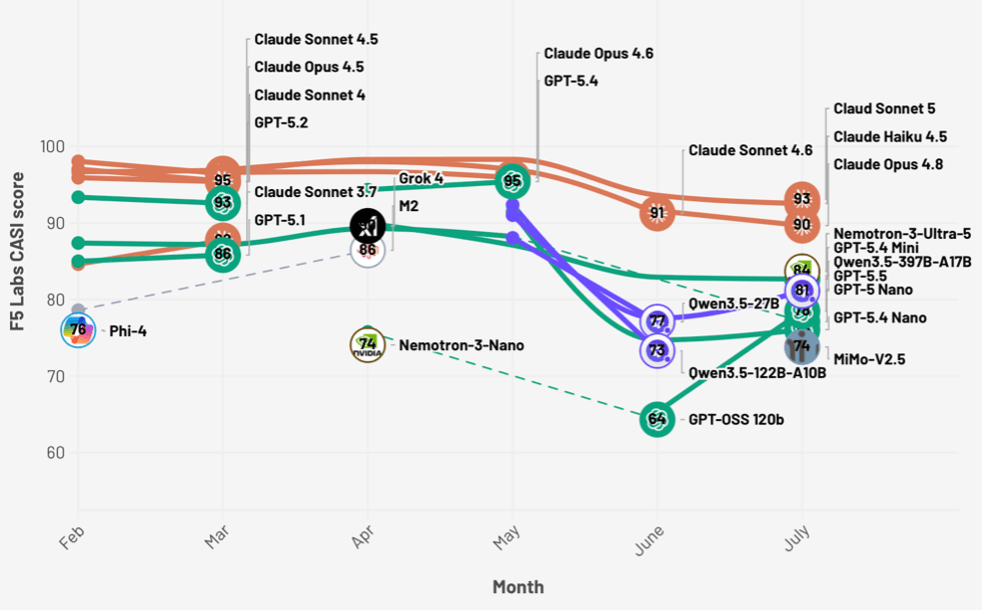
Un score CASI est exact au moment où il est mesuré, mais les modèles et les menaces ne restent pas figés. Un modèle obtenant un score d’environ 93 lors d’un cycle de test peut tomber entre 73 et 77 quelques mois plus tard. Cela représente une variation de 15 à 20 points sans aucune modification du code côté client, simplement parce que le modèle sous-jacent a évolué. C’est pourquoi certains clients de F5 AI Red Team intègrent directement de nouveaux tests à leur pipeline de livraison CI/CD. À chaque déploiement d’une nouvelle version du modèle ou d’une variante affinée, ou lorsqu’un délai suffisant s’est écoulé, les valeurs de référence CASI et ARS sont à nouveau vérifiées, plutôt que de supposer que le score du trimestre précédent est toujours valable.
Régulation des intentions personnalisées
Une exécution standard de CASI permet d’évaluer la résistance d’un modèle face à une vaste bibliothèque d’attaques connues, mais elle ne détecte pas automatiquement les risques liés à une nouvelle fonctionnalité ou à une exigence légale spécifique. Par exemple, l’ajout d’un outil d’évaluation des symptômes à un chatbot de santé ou la possibilité, pour un agent financier, d’effectuer un virement bancaire présentent des risques qu’un test générique n’a aucune raison de rechercher. Dans ce type de scénario, les clients créent des intentions d’attaque personnalisées et ciblées autour d’une fonctionnalité ou d’une exigence réglementaire spécifique.
Par exemple, un outil multinational de gestion des contrats pourrait devoir être testé au regard des obligations du règlement européen sur l’IA dans une région, et d’une norme totalement différente en matière de données à caractère personnel ailleurs. Les intentions personnalisées permettent aux équipes de tester précisément la règle ou la fonctionnalité dont elles doivent démontrer la conformité, plutôt que de s’appuyer sur une couverture générale.
Créer un centre d’excellence interne dédié au red teaming
Certaines grandes organisations (dont au moins un grand cabinet d’avocats) sont allées encore plus loin en créant une petite équipe interne dédiée, dont la mission consiste exclusivement à soumettre à des tests d’intrusion les applications d’IA utilisées dans le reste de l’entreprise. Cette équipe connaît à la fois le paysage des menaces auquel l’organisation est confrontée et ses résultats CASI et ARS, et collabore directement avec les équipes chargées des produits et de la gestion des vulnérabilités lors du développement de nouvelles fonctionnalités d’IA.
Les équipes de sécurité communiquent les résultats CASI aux développeurs d’applications afin de faire passer un message simple : tous les modèles ne présentent pas le même niveau de sécurité, et supposer le contraire ouvre la voie aux risques. Cela permet de combler un manque de connaissances entre les équipes InfoSec et DevOps, qui pourraient autrement ne pas du tout prendre en compte les risques propres à chaque modèle.
Ce qu’il faut retenir ici, c’est que le paysage des menaces évolue plus vite que la plupart des équipes de sécurité ne peuvent le suivre manuellement. Le red teaming appliqué à l’IA est une pratique continue qui doit évoluer au même rythme que les systèmes qu’il protège. Il doit :
- Être continue : Les campagnes de tests manuels qui s’étendent sur plusieurs semaines ne peuvent pas suivre le rythme d’évolution des modèles et des agents.
- Réduisez le délai entre la détection d’un risque et sa correction : Les résultats des tests d’intrusion alimentent directement les mesures correctives, transformant les tests, jusque-là simples rapports statiques, en moteurs d’actions plus rapides et hiérarchisées face aux risques réels.
- Donnez aux équipes de sécurité les moyens de démontrer le travail accompli : Chaque évaluation génère un score CASI et un score ARS, offrant ainsi aux équipes un moyen objectif et comparable de suivre l’évolution de leur posture de sécurité et de communiquer clairement les risques à la direction.
Le paysage actuel de la cybersécurité évolue plus vite que quiconque ne peut le prévoir, mais grâce à F5 AI Red Team, à CASI et à ARS, les équipes de sécurité peuvent bénéficier en permanence de garde-fous fondés sur les menaces.
Pour en savoir plus, consultez les pages Web de F5 AI Red Team et des classements CASI et ARS de F5 Labs.
À propos de l’auteur
Articles de blog associés

F5 rejoint le projet PQC du NIST pour contribuer à l’élaboration de normes résistantes aux attaques quantiques
En rejoignant le consortium du projet « Migration to PQC » du NIST, F5 contribue à élaborer des recommandations pratiques pour un monde résistant aux menaces quantiques.

La dernière version de F5 Distributed Cloud Bot Defense offre des fonctionnalités et des améliorations de nouvelle génération
Les mises à jour de la console de F5 Distributed Cloud Bot Defense améliorent la gestion des menaces automatisées et l’intégration dans des cadres de sécurité plus larges.

La nouvelle surface de risque liée à l’IA : invisible, autonome et déjà à l’intérieur
James White, vice-président de l’ingénierie chez F5 À mi-parcours de l’année 2025, le moment est bien choisi pour dresser un état des lieux de l’adoption de l’IA en entreprise et de la sécurité de l’IA. L’utilisation de l’IA générative est désormais la norme dans les entreprises De manière générale, les entreprises possèdent au moins une compréhension élémentaire de l’IA générative. Elles savent ce qu’elle est et où elle peut […]
Évaluation des LLM : renforcer la confiance grâce à la notation de sécurité
À mesure que l’adoption de l’IA s’accélère dans les entreprises, l’évaluation des LLM ne porte plus uniquement sur leurs performances, mais aussi sur la confiance qu’ils inspirent. Les équipes de sécurité doivent évaluer non seulement les performances d’un modèle, mais aussi la sûreté de son comportement. Pourtant, la plupart des cadres d’évaluation se concentrent sur des critères de précision, laissant les facteurs de sécurité et de risque dans le flou ou sans mesure.
Évaluer le niveau de préparation de votre organisation à la sécurité de l’IA
Dans un paysage de l’intelligence artificielle (IA) en constante évolution, il est non seulement important, mais impératif de savoir si votre organisation est prête à instaurer et à soutenir une culture de la sécurité de l’IA. À mesure que les technologies d’IA progressent, elles font émerger une multitude de nouveaux défis de sécurité qui, pour être gérés efficacement, exigent une approche réfléchie, globale et proactive […]
Déployer des LLM en entreprise : via une API dans un cloud privé
Pris isolément, sans mesures de protection spécialisées ni protocoles de sécurité en place, le déploiement de modèles d’IA générative (GenAI), en particulier de grands modèles de langage (LLM), à l’échelle de l’entreprise représente pour toute organisation une opportunité à haut risque, mais potentiellement très rentable. La manière précise dont votre organisation doit franchir ce grand pas dans l’univers de la GenAI nécessite une planification mûrement réfléchie. Peut-être serait-il […]