Si les clusters de GPU et les usines d’IA font la une, les activités essentielles des entreprises dépendent de pipelines de stockage objet moins visibles. Les processus d’archivage et de sauvegarde des bases de données doivent fonctionner de manière fiable. Si ces pipelines se bloquent, les applications perdent l’accès aux données critiques et les processus métier s’arrêtent immédiatement. Pour les DSI, les goulets d’étranglement du stockage ne sont pas de simples détails d’infrastructure : ils menacent la continuité d’activité. Ces pipelines contribuent à la conformité réglementaire et à la reprise après sinistre.
L’acheminement des données pour l’IA accentue cette pression opérationnelle. Les grands modèles de langage et les systèmes de génération augmentée par récupération (RAG) exigent un accès rapide et fiable aux données. Par conséquent, l’enjeu principal n’est plus la quantité de données que vous pouvez stocker, mais la rapidité et la sécurité avec lesquelles vous pouvez les transférer entre les plateformes et les modèles.
Les pipelines de stockage objet auxquels personne ne pense avant qu’ils ne tombent en panne
Le stockage objet d’entreprise répond à des charges de travail variées. Certaines prennent en charge des projets d’IA de premier plan, tandis que d’autres assurent les opérations quotidiennes. Ces pipelines opérationnels retiennent rarement l’attention des dirigeants, mais ils déterminent votre capacité à rétablir vos services après une panne et à atteindre vos objectifs de niveau de service.
Ces pipelines couvrent quatre grands domaines de responsabilité opérationnelle. Si l’un d’eux tombe en panne, les activités de l’entreprise s’arrêtent :
- Continuité des activités : Journaux de transactions (WAL) et sauvegardes des bases de données. Traditionnellement, les WAL étaient écrits sur des disques SSD locaux. Aujourd’hui, les bases de données cloud modernes peuvent écrire les WAL sur un stockage compatible S3. Ensemble, ces processus permettent aux équipes de restaurer les systèmes essentiels immédiatement après une défaillance.
- Opérations de sécurité : journaux SIEM et preuves numériques. Les équipes de réponse aux incidents et de détection des menaces s’appuient sur ces données pour enquêter sur les attaques en cours.
- Conformité et gouvernance : Archives réglementaires et coffres-forts immuables. Pour ces charges de travail, la disponibilité des données constitue une obligation légale stricte plutôt qu’une préférence opérationnelle.
- Plateformes de données d’entreprise : Lacs de données et bases de connaissances pour la RAG. Ces pipelines alimentent les applications et les moteurs d’apprentissage automatique sur lesquels reposent vos produits.
Aucune de ces charges de travail backend n’a quoi que ce soit de prestigieux. Pourtant, ce sont précisément ces flux qui déterminent si votre entreprise reste conforme et prête à faire face à une crise.
Les risques cachés se trouvent sur le chemin des données
Bien que traditionnellement géré comme une infrastructure back-end, le stockage objet moderne est en réalité un service réseau actif. Que vous utilisiez Amazon S3 ou des systèmes de stockage objet privés, les applications interrogent le stockage via HTTP/S à l’aide d’API REST. Cette réalité architecturale signifie que les pipelines de stockage objet héritent exactement des mêmes risques en matière de performances et de sécurité que ceux qui menacent les applications et services web modernes.
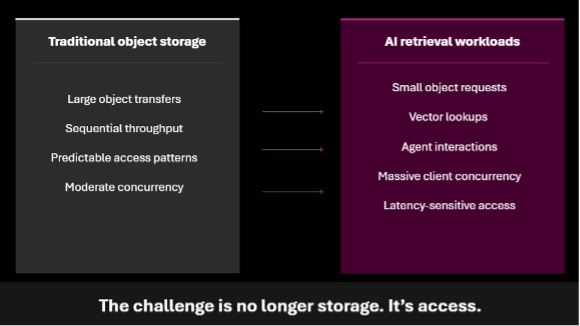
Les risques d’indisponibilité surviennent lorsque des pics de trafic saturent les interfaces réseau ou que les contrôleurs de stockage tombent en panne. Les goulets d’étranglement nuisent tout autant aux performances. Les pics de latence et la congestion du réseau dégradent les flux de travail critiques du backend, même lorsque les disques de stockage sous-jacents sont en bon état. Par exemple, un retard dans un flux d’archivage de base de données peut interrompre la journalisation anticipée, ce qui dégrade les performances de la base de données et provoque une interruption soudaine du service. Le véritable risque ne réside pas dans la défaillance initiale, mais dans l’étendue de sa propagation. Sans isolation du chemin de données, un problème dans un pipeline se transforme en panne généralisée du système.
L’utilisation d’API web pour accéder au stockage élargit la surface d’attaque de votre entreprise. Ces points de terminaison sont vulnérables aux attaques DDoS. Les équipes de sécurité et les développeurs s’appuyant sur le stockage objet pour alimenter les analyses en temps réel et les modèles d’IA, une compromission de la sécurité au niveau des API de stockage entraîne de graves conséquences opérationnelles.
La gestion de la capacité brute n’est plus le principal obstacle. Le défi technique majeur consiste à garder le contrôle sur les flux de données entre les applications et les référentiels. La sécurisation et l’optimisation de ce parcours sont désormais tout aussi importantes que la maintenance de la plateforme de stockage sous-jacente.
Appliquer la rigueur de l’ingénierie aux pipelines de données du stockage objet
Moderniser l’infrastructure de données pour l’analytique et l’IA implique de ne plus considérer le stockage objet comme un simple référentiel passif. Vous devez gérer le chemin de données lui-même. Tout comme vous utilisez un contrôleur de mise à disposition d’applications (ADC) pour sécuriser les applications web destinées aux utilisateurs, vous avez besoin de points de contrôle équivalents pour les pipelines de stockage backend qui assurent votre mise à disposition des données pour l’IA. En plaçant F5 BIG-IP devant vos compartiments de stockage, vous transformez un point de terminaison d’API passif et vulnérable en un pipeline de mise à disposition des données hautement disponible, sécurisé et accéléré.
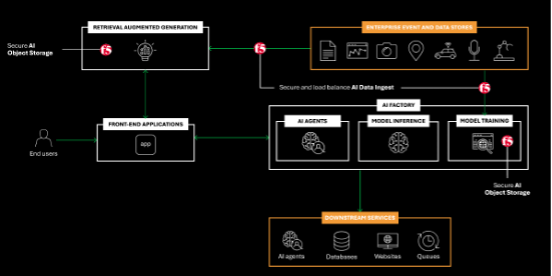
Comme le stockage objet moderne est accessible sur le réseau via des API HTTP/S, il se comporte exactement comme une application web. Un contrôleur de distribution d’applications (ADC) tel que F5 BIG-IP est donc l’outil naturellement adapté à sa gestion. En tant que couche de contrôle entre les applications et les systèmes de stockage de données, BIG-IP sécurise et stabilise les transferts de données.
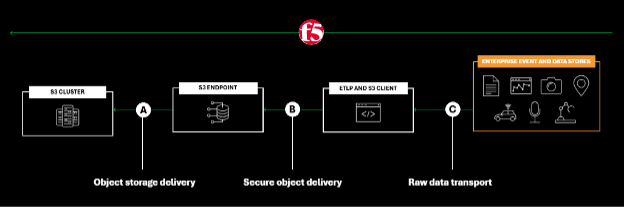
Cette architecture offre des avantages opérationnels considérables sans nécessiter de refactoriser vos applications ni de repenser vos plateformes de stockage :
- Aucune refonte du stockage : Faire évoluer le stockage pour y intégrer la sécurité et le routage est un projet coûteux qui s’étend sur plusieurs années. Placer BIG-IP en amont du stockage permet de bénéficier immédiatement de fonctions de routage et de journalisation de niveau entreprise, sans aucune modification du stockage sous-jacent ni du code des applications.
- Des performances accélérées grâce à la décharge des traitements réseau : Les systèmes de stockage sont conçus pour lire et écrire des données, et non pour gérer la surcharge liée au réseau. BIG-IP prend en charge les tâches gourmandes en ressources processeur, comme le déchiffrement SSL/TLS. En déchargeant la baie de stockage de ces tâches réseau exigeantes, vous permettez à son processeur de se concentrer sur les entrées-sorties et de réduire les temps de réponse aux requêtes d’IA.
- Protection de sécurité active: La sécurité traditionnelle du stockage est passive et repose sur des clés d’accès qui ne peuvent pas détecter les requêtes malveillantes. BIG-IP agit comme un bouclier actif en inspectant le trafic entrant des API de stockage à l’aide d’un pare-feu d’applications Web (WAF) afin de bloquer les injections SQL et les attaques DDoS avant que ces menaces n’atteignent la couche de stockage.
Pour garantir une haute disponibilité, BIG-IP surveille l’état des points de terminaison et achemine le trafic en évitant les nœuds hors ligne. Il répartit également les requêtes de manière dynamique entre les centres de données. Cela limite l’impact des défaillances de composants et maintient des niveaux de service prévisibles à mesure que les volumes de données et les besoins des modèles d’IA augmentent.
La fiabilité des transferts de données est désormais un impératif pour les entreprises
En plaçant une couche de contrôle pilotée par un ADC entre les applications et le stockage, vous établissez un chemin de données résilient et maîtrisable. Ce choix architectural applique aux pipelines de stockage objet la même rigueur d’ingénierie que celle que vous mettez déjà en œuvre pour vos principales applications et API destinées aux clients.
Les pipelines de données les plus critiques de l’entreprise sont souvent les moins visibles. Que vous assuriez la reprise après sinistre ou le maintien de la conformité, la stabilité opérationnelle dépend entièrement de la fiabilité avec laquelle les données circulent sur votre réseau.
Face aux exigences croissantes en matière de performances, vous ne pouvez plus évaluer le stockage objet uniquement selon sa capacité et son évolutivité. Pour les dirigeants d’entreprise, l’objectif n’est pas simplement de stocker davantage de données, mais aussi de garantir que celles qui alimentent vos opérations critiques et vos initiatives d’IA restent disponibles et sécurisées en permanence. Le stockage des données n’est qu’une première étape ; vous devez concevoir le cheminement même des données de manière à en assurer la résilience, la maîtrise et le cloisonnement.
L’engagement de F5 en faveur de l’IA ne s’arrête pas là : découvrez comment F5 sécurise et distribue les applications d’IA partout.
À propos de l’auteur
Articles de blog associés
F5 rejoint le projet PQC du NIST pour contribuer à l’élaboration de normes résistantes aux attaques quantiques
En rejoignant le consortium du projet « Migration to PQC » du NIST, F5 contribue à élaborer des recommandations pratiques pour un monde résistant aux menaces quantiques.
La dernière version de F5 Distributed Cloud Bot Defense offre des fonctionnalités et des améliorations de nouvelle génération
Les mises à jour de la console de F5 Distributed Cloud Bot Defense améliorent la gestion des menaces automatisées et l’intégration dans des cadres de sécurité plus larges.

La nouvelle surface de risque liée à l’IA : invisible, autonome et déjà à l’intérieur
James White, vice-président de l’ingénierie chez F5 À mi-parcours de l’année 2025, le moment est bien choisi pour dresser un état des lieux de l’adoption de l’IA en entreprise et de la sécurité de l’IA. L’utilisation de l’IA générative est désormais la norme dans les entreprises De manière générale, les entreprises possèdent au moins une compréhension élémentaire de l’IA générative. Elles savent ce qu’elle est et où elle peut […]
Évaluation des LLM : renforcer la confiance grâce à la notation de sécurité
À mesure que l’adoption de l’IA s’accélère dans les entreprises, l’évaluation des LLM ne porte plus uniquement sur leurs performances, mais aussi sur la confiance qu’ils inspirent. Les équipes de sécurité doivent évaluer non seulement les performances d’un modèle, mais aussi la sûreté de son comportement. Pourtant, la plupart des cadres d’évaluation se concentrent sur des critères de précision, laissant les facteurs de sécurité et de risque dans le flou ou sans mesure.
Évaluer le niveau de préparation de votre organisation à la sécurité de l’IA
Dans un paysage de l’intelligence artificielle (IA) en constante évolution, il est non seulement important, mais impératif de savoir si votre organisation est prête à instaurer et à soutenir une culture de la sécurité de l’IA. À mesure que les technologies d’IA progressent, elles font émerger une multitude de nouveaux défis de sécurité qui, pour être gérés efficacement, exigent une approche réfléchie, globale et proactive […]
Déployer des LLM en entreprise : via une API dans un cloud privé
Pris isolément, sans mesures de protection spécialisées ni protocoles de sécurité en place, le déploiement de modèles d’IA générative (GenAI), en particulier de grands modèles de langage (LLM), à l’échelle de l’entreprise représente pour toute organisation une opportunité à haut risque, mais potentiellement très rentable. La manière précise dont votre organisation doit franchir ce grand pas dans l’univers de la GenAI nécessite une planification mûrement réfléchie. Peut-être serait-il […]