La rédaction – Cette série d’articles en sept parties est désormais complète :
- Introduction aux microservices
- Créer des microservices : utiliser une passerelle API
- Créer des microservices : la communication interprocessus dans une architecture de microservices (cet article)
- Découverte de services dans une architecture de microservices
- Gestion des données pilotée par les événements pour les microservices
- Choisir une stratégie de déploiement des microservices
- Refactoriser un monolithe en microservices
Vous pouvez également télécharger l’ensemble des articles, ainsi que des informations sur la mise en œuvre de microservices avec NGINX Plus, sous forme de livre numérique – Microservices : de la conception au déploiement. Consultez également la nouvelle page des solutions de microservices.
Voici le troisième article de notre série consacrée à la création d’applications reposant sur une architecture de microservices. Le premier article présente le modèle d’architecture de microservices, le compare au modèle d’architecture monolithique et examine les avantages et les inconvénients de l’utilisation des microservices. Le deuxième article décrit comment les clients d’une application communiquent avec les microservices par l’intermédiaire d’une passerelle API. Dans cet article, nous examinons comment les services d’un système communiquent entre eux. Le quatrième article explore la question étroitement liée de la découverte de services.
Introduction
Dans une application monolithique, les composants s’appellent les uns les autres par le biais d’appels de méthodes ou de fonctions au niveau du langage. En revanche, une application fondée sur des microservices est un système distribué s’exécutant sur plusieurs machines. Chaque instance de service correspond généralement à un processus. Par conséquent, comme le montre le schéma suivant, les services doivent interagir au moyen d’un mécanisme de communication interprocessus (IPC).
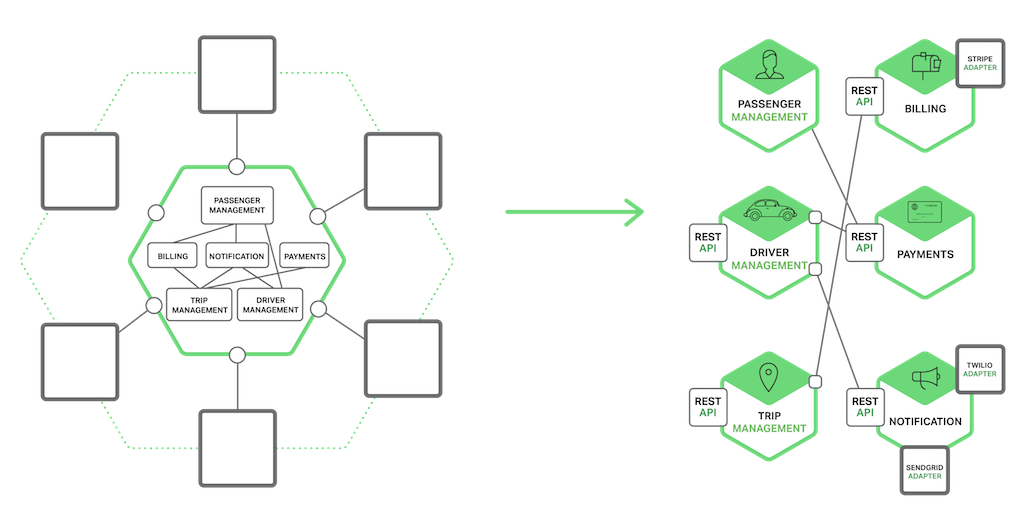
Nous examinerons plus loin des technologies IPC spécifiques, mais commençons par explorer différentes questions de conception.
Modes d’interaction
Lors du choix d’un mécanisme de communication interprocessus (IPC) pour un service, il est utile de réfléchir d’abord à la manière dont les services interagissent. Il existe différents modes d’interaction client⇔service. Ils peuvent être classés selon deux dimensions. La première consiste à déterminer si l’interaction est de type un-à-un ou un-à-plusieurs :
- Un à un – Chaque requête client est traitée par une seule instance de service.
- Un-à-plusieurs – Chaque requête est traitée par plusieurs instances de service.
La deuxième dimension consiste à déterminer si l’interaction est synchrone ou asynchrone :
- Synchrone – Le client attend une réponse rapide du service et peut même se bloquer en attendant.
- Asynchrone – Le client ne se bloque pas en attendant une réponse, et celle-ci, le cas échéant, n’est pas nécessairement envoyée immédiatement.
Le tableau suivant présente les différents modes d’interaction.
| Un à un | Un à plusieurs | |
|---|---|---|
| Synchrone | Requête/réponse | — |
| Asynchrone | Notification | Publication/abonnement |
| Requête/réponse asynchrone | Publication/réponses asynchrones |
Il existe les types d’interactions un à un suivants :
- Requête/réponse – Un client envoie une requête à un service et attend une réponse. Le client s’attend à recevoir cette réponse dans un délai raisonnable. Dans une application utilisant des threads, le thread qui envoie la requête peut même se bloquer pendant l’attente.
- Notification (également appelée requête unidirectionnelle) – Un client envoie une requête à un service, mais aucune réponse n’est attendue ni envoyée.
- Requête/réponse asynchrone – Un client envoie une requête à un service, qui répond de manière asynchrone. Le client ne reste pas bloqué pendant l’attente et est conçu pour tenir compte du fait que la réponse peut mettre un certain temps à arriver.
Il existe les types d’interactions un-à-plusieurs suivants :
- Publication/abonnement – Un client publie un message de notification, qui est consommé par zéro, un ou plusieurs services intéressés.
- Publication/réponses asynchrones – Un client publie un message de requête, puis attend pendant un certain temps les réponses des services intéressés.
Chaque service utilise généralement une combinaison de ces modes d’interaction. Pour certains services, un seul mécanisme de communication interprocessus (IPC) suffit. D’autres peuvent nécessiter une combinaison de plusieurs mécanismes IPC. Le schéma suivant montre comment les services d’une application de réservation de taxi peuvent interagir lorsque l’utilisateur demande une course.
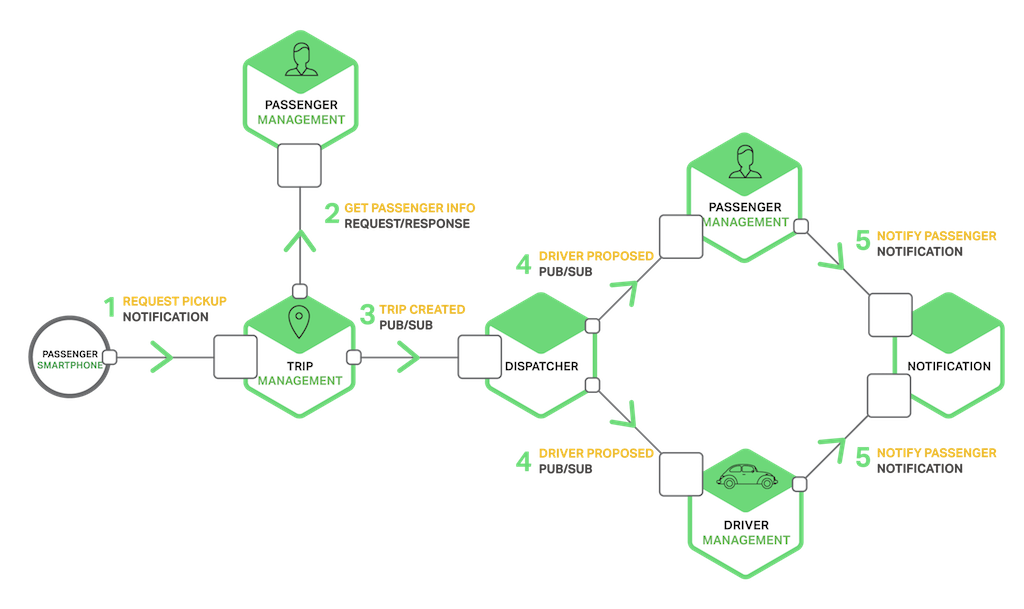
Les services combinent les notifications, le modèle requête/réponse et le modèle publication/abonnement. Par exemple, le smartphone du passager envoie une notification au service de gestion des trajets pour demander une prise en charge. Le service de gestion des trajets vérifie que le compte du passager est actif en utilisant le modèle requête/réponse pour appeler le service des passagers. Il crée ensuite le trajet et utilise le modèle publication/abonnement pour avertir les autres services, notamment le service de répartition, qui recherche un chauffeur disponible.
Maintenant que nous avons examiné les styles d’interaction, voyons comment définir des API.
Définir des API
L’API d’un service est un contrat entre le service et ses clients. Quel que soit le mécanisme de communication interprocessus (IPC) choisi, il est important de définir précisément l’API d’un service à l’aide d’un langage de définition d’interface (IDL). Il existe même de solides arguments en faveur d’une approche API-first pour définir les services. Vous commencez le développement d’un service par la rédaction de la définition de son interface, puis vous l’examinez avec les développeurs des applications clientes. Ce n’est qu’après plusieurs itérations sur la définition de l’API que vous implémentez le service. Ce travail de conception en amont augmente vos chances de créer un service qui répond aux besoins de ses clients.
Comme vous le verrez plus loin dans cet article, la nature de la définition de l’API dépend du mécanisme de communication interprocessus (IPC) que vous utilisez. Si vous utilisez une messagerie, l’API se compose des canaux et des types de messages. Si vous utilisez HTTP, l’API se compose des URL et des formats des requêtes et des réponses. Nous présenterons plus en détail certains langages de définition d’interface (IDL) par la suite.
Faire évoluer les API
L’API d’un service évolue inévitablement au fil du temps. Dans une application monolithique, il est généralement simple de modifier l’API et de mettre à jour tous les composants qui l’appellent. Dans une application basée sur des microservices, c’est beaucoup plus difficile, même si tous les consommateurs de votre API sont d’autres services de la même application. En général, vous ne pouvez pas imposer à tous les clients de se mettre à niveau en même temps que le service. De plus, vous allez probablement déployer progressivement de nouvelles versions d’un service, de sorte que les anciennes et les nouvelles versions fonctionneront simultanément. Il est important de disposer d’une stratégie pour gérer ces difficultés.
La manière de gérer une modification d’API dépend de son ampleur. Certaines modifications sont mineures et rétrocompatibles avec la version précédente. Vous pouvez, par exemple, ajouter des attributs aux requêtes ou aux réponses. Il est judicieux de concevoir les clients et les services de façon à ce qu’ils respectent le principe de robustesse. Les clients qui utilisent une ancienne API doivent continuer à fonctionner avec la nouvelle version du service. Le service fournit des valeurs par défaut pour les attributs manquants dans les requêtes, et les clients ignorent les attributs supplémentaires dans les réponses. Il est important d’utiliser un mécanisme de communication interprocessus (IPC) et un format de message qui permettent de faire évoluer facilement vos API.
Cependant, il est parfois nécessaire d’apporter à une API des modifications majeures qui rompent la compatibilité avec les versions précédentes. Comme vous ne pouvez pas obliger les clients à passer immédiatement à la nouvelle version, un service doit prendre en charge les anciennes versions de l’API pendant un certain temps. Si vous utilisez un mécanisme basé sur HTTP, comme REST, une approche consiste à intégrer le numéro de version dans l’URL. Chaque instance du service peut gérer plusieurs versions simultanément. Vous pouvez également déployer différentes instances, chacune prenant en charge une version particulière.
Gestion des défaillances partielles
Prenons, par exemple, le scénario de consultation des détails d’un produit présenté dans cet article. Imaginons que le service de recommandation ne réponde plus. Une implémentation naïve du client pourrait rester bloquée indéfiniment dans l’attente d’une réponse. Non seulement cela dégraderait l’expérience utilisateur, mais, dans de nombreuses applications, cela mobiliserait également une ressource précieuse, comme un thread. À terme, l’environnement d’exécution épuiserait tous les threads disponibles et ne répondrait plus, comme le montre la figure suivante.
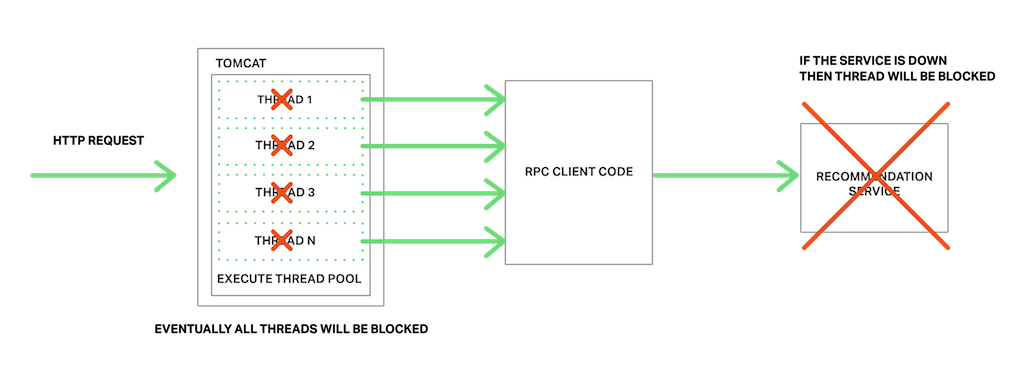
Pour éviter ce problème, il est essentiel de concevoir vos services de manière à gérer les défaillances partielles.
Une bonne approche à suivre est celle décrite par Netflix. Les stratégies permettant de gérer les défaillances partielles comprennent :
- Délais d’attente réseau – Ne bloquez jamais indéfiniment et définissez toujours un délai d’attente lorsque vous attendez une réponse. L’utilisation de délais d’attente garantit que les ressources ne restent jamais mobilisées indéfiniment.
- Limitation du nombre de requêtes en cours – Fixez une limite supérieure au nombre de requêtes qu’un client peut avoir en cours auprès d’un service donné. Si cette limite est atteinte, il est probablement inutile d’envoyer des requêtes supplémentaires, et ces tentatives doivent échouer immédiatement.
- Modèle du disjoncteur – Comptabilisez les requêtes réussies et celles qui ont échoué. Si le taux d’erreur dépasse un seuil configuré, ouvrez le disjoncteur afin que les tentatives suivantes échouent immédiatement. Si un grand nombre de requêtes échouent, cela indique que le service est probablement indisponible et qu’il est inutile d’envoyer des requêtes. Après un délai d’attente, le client doit réessayer et, si la tentative réussit, refermer le disjoncteur.
- Prévoir des solutions de repli – Appliquer une logique de repli lorsqu’une requête échoue. Par exemple, renvoyer des données mises en cache ou une valeur par défaut, comme un ensemble vide de recommandations.
Netflix Hystrix est une bibliothèque open source qui implémente ces modèles de conception ainsi que d’autres. Si vous utilisez la JVM, vous devriez sérieusement envisager d’utiliser Hystrix. Et si votre environnement ne repose pas sur la JVM, vous devriez utiliser une bibliothèque équivalente.
Technologies IPC
Il existe de nombreuses technologies de communication interprocessus (IPC). Les services peuvent utiliser des mécanismes de communication synchrones fondés sur un modèle requête-réponse, comme REST sur HTTP ou Thrift. Ils peuvent également utiliser des mécanismes de communication asynchrones fondés sur l’échange de messages, comme AMQP ou STOMP. Il existe aussi différents formats de messages. Les services peuvent utiliser des formats textuels lisibles par l’humain, comme JSON ou XML. Ils peuvent aussi opter pour un format binaire, plus efficace, comme Avro ou Protocol Buffers. Nous examinerons plus loin les mécanismes IPC synchrones, mais abordons d’abord les mécanismes IPC asynchrones.
Communication asynchrone basée sur les messages
Avec la messagerie, les processus communiquent en échangeant des messages de manière asynchrone. Un client adresse une requête à un service en lui envoyant un message. Si une réponse est attendue du service, celui-ci envoie un message distinct au client. La communication étant asynchrone, le client ne reste pas bloqué dans l’attente d’une réponse. Il est au contraire conçu pour fonctionner en partant du principe que la réponse ne sera pas reçue immédiatement.
Un message se compose d’en-têtes (des métadonnées telles que l’expéditeur) et d’un corps de message. Les messages sont échangés via des canaux. Un nombre quelconque de producteurs peut envoyer des messages à un canal. De même, un nombre quelconque de consommateurs peut recevoir des messages depuis un canal. Il existe deux types de canaux : les canaux point à point et les canaux de publication-abonnement. Un canal point à point transmet chaque message à un seul des consommateurs qui lisent les messages sur ce canal. Les services utilisent les canaux point à point pour les modes d’interaction un à un décrits précédemment. Un canal de publication-abonnement transmet chaque message à tous les consommateurs qui y sont abonnés. Les services utilisent les canaux de publication-abonnement pour les modes d’interaction un à plusieurs décrits ci-dessus.
Le schéma suivant montre comment l’application de réservation de taxis pourrait utiliser des canaux de publication-abonnement.
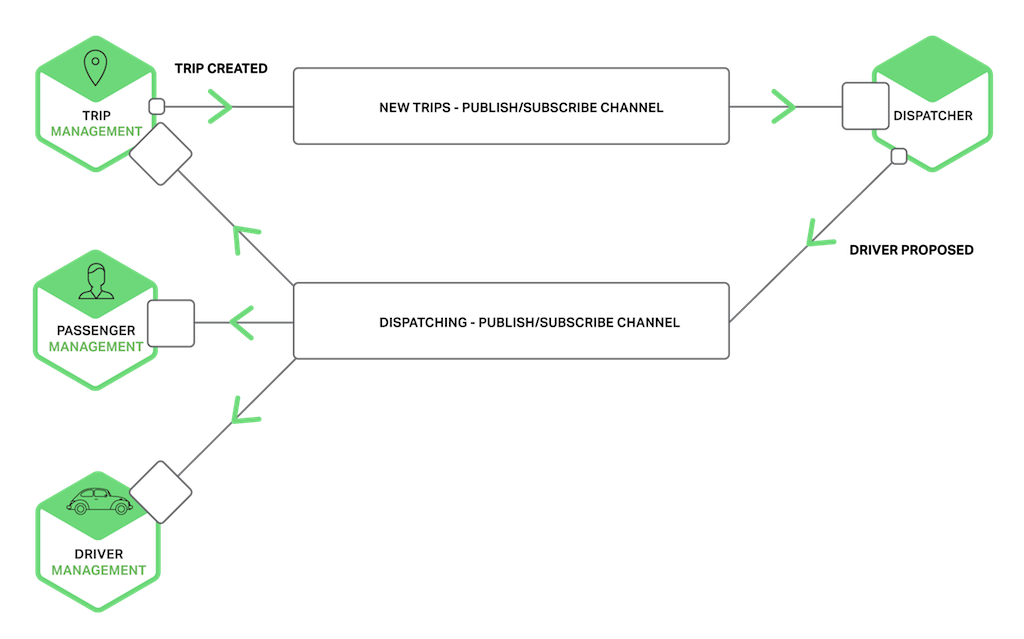
Le service de gestion des courses informe les services concernés, tels que le service de répartition, de la création d’une nouvelle course en publiant un message « Course créée » sur un canal de publication-abonnement. Le service de répartition trouve un chauffeur disponible et en informe les autres services en publiant un message « Chauffeur proposé » sur un canal de publication-abonnement.
Il existe de nombreux systèmes de messagerie. Il est conseillé d’en choisir un qui prend en charge plusieurs langages de programmation. Certains systèmes de messagerie prennent en charge des protocoles standard tels qu’AMQP et STOMP. D’autres utilisent des protocoles propriétaires, mais documentés. Le choix de systèmes de messagerie open source est vaste et comprend notamment RabbitMQ, Apache Kafka, Apache ActiveMQ et NSQ. Dans les grandes lignes, tous prennent en charge une certaine forme de messages et de canaux. Tous visent à offrir fiabilité, performances élevées et capacité à passer à l’échelle. Toutefois, les modèles de messagerie des différents courtiers présentent des différences importantes dans leurs détails.
L’utilisation de la messagerie présente de nombreux avantages :
- Découple le client du service – Un client effectue une requête simplement en envoyant un message au canal approprié. Le client n’a aucune connaissance des instances du service. Il n’a pas besoin d’utiliser un mécanisme de découverte pour déterminer l’emplacement d’une instance du service.
- Mise en mémoire tampon des messages – Avec un protocole de requête/réponse synchrone, tel que HTTP, le client et le service doivent tous deux être disponibles pendant toute la durée de l’échange. À l’inverse, un courtier de messages met en file d’attente les messages publiés sur un canal jusqu’à ce que le consommateur puisse les traiter. Cela signifie, par exemple, qu’une boutique en ligne peut accepter les commandes de ses clients même lorsque le système de traitement des commandes est lent ou indisponible. Les messages de commande sont simplement placés en file d’attente.
- Interactions client-service flexibles – La messagerie prend en charge tous les modes d’interaction décrits précédemment.
- Communication interprocessus explicite – Les mécanismes fondés sur les RPC tentent de faire en sorte que l’appel à un service distant ressemble à l’appel à un service local. Toutefois, en raison des lois de la physique et du risque de défaillance partielle, ces deux opérations sont en réalité très différentes. La messagerie rend ces différences très explicites afin que les développeurs ne se laissent pas bercer par un faux sentiment de sécurité.
L’utilisation de la messagerie présente toutefois certains inconvénients :
- Complexité opérationnelle accrue – Le système de messagerie est un composant supplémentaire du système qu’il faut installer, configurer et exploiter. Il est essentiel que le courtier de messages soit hautement disponible, faute de quoi la fiabilité du système est compromise.
- Complexité de la mise en œuvre d’interactions de type requête/réponse – La mise en œuvre d’interactions de type requête/réponse demande un certain travail. Chaque message de requête doit contenir un identifiant de canal de réponse et un identifiant de corrélation. Le service écrit un message de réponse contenant l’identifiant de corrélation dans le canal de réponse. Le client utilise cet identifiant pour associer la réponse à la requête. Il est souvent plus simple d’utiliser un mécanisme de communication interprocessus (IPC) qui prend directement en charge les échanges de type requête/réponse.
Maintenant que nous avons vu comment utiliser la communication interprocessus (IPC) fondée sur la messagerie, examinons celle fondée sur le modèle requête/réponse.
IPC synchrone de type requête/réponse
Lorsqu’un mécanisme de communication interprocessus (IPC) synchrone, fondé sur le modèle requête/réponse, est utilisé, un client envoie une requête à un service. Le service traite la requête et renvoie une réponse. Dans de nombreux clients, le thread qui émet la requête reste bloqué en attendant la réponse. D’autres clients peuvent utiliser du code asynchrone et événementiel, éventuellement encapsulé dans des Futures ou des Observables Rx. Toutefois, contrairement à la communication par messages, le client suppose que la réponse arrivera dans un délai raisonnable. De nombreux protocoles sont disponibles. REST et Thrift sont deux protocoles courants. Examinons d’abord REST.
REST
Aujourd’hui, il est courant de développer des API dans le style RESTful. REST est un mécanisme de communication interprocessus (IPC) qui utilise (presque toujours) HTTP. Un concept clé de REST est la ressource, qui représente généralement un objet métier tel qu’un client ou un produit, ou un ensemble d’objets métier. REST utilise les verbes HTTP pour manipuler les ressources, qui sont référencées par une URL. Par exemple, une requête GET renvoie la représentation d’une ressource, qui peut prendre la forme d’un document XML ou d’un objet JSON. Une requête POST crée une nouvelle ressource et une requête PUT met à jour une ressource. Pour citer Roy Fielding, le créateur de REST :
« REST fournit un ensemble de contraintes architecturales qui, appliquées dans leur globalité, mettent l’accent sur la capacité des interactions entre composants à passer à l’échelle, la généricité des interfaces, le déploiement indépendant des composants et le recours à des composants intermédiaires pour réduire la latence des interactions, garantir la sécurité et encapsuler les systèmes existants. »
Le schéma suivant illustre l’une des façons dont l’application de réservation de taxis pourrait utiliser REST.
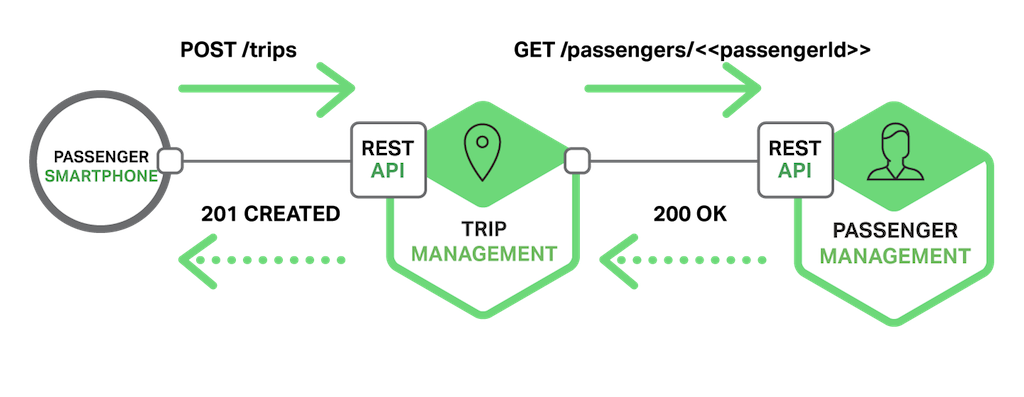
Le smartphone du passager demande une course en envoyant une requête POST à la ressource /trips du service de gestion des courses. Ce service traite la requête en envoyant une requête GET au service de gestion des passagers pour obtenir des informations sur le passager. Après avoir vérifié que le passager est autorisé à créer une course, le service de gestion des courses crée la course et renvoie une réponse 201 au smartphone.
De nombreux développeurs affirment que leurs API basées sur HTTP sont RESTful. Cependant, comme l’explique Fielding dans cet article de blog, ce n’est pas toujours le cas. Leonard Richardson (aucun lien de parenté) définit un modèle de maturité REST très utile, qui comprend les niveaux suivants.
- Niveau 0 – Les clients d’une API de niveau 0 invoquent le service en envoyant des requêtes HTTP
POSTà son unique point de terminaison URL. Chaque requête précise l’action à effectuer, la cible de l’action (par exemple, l’objet métier) et les éventuels paramètres. - Niveau 1 – Une API de niveau 1 prend en charge la notion de ressources. Pour effectuer une action sur une ressource, un client envoie une requête
POSTqui précise l’action à effectuer ainsi que les éventuels paramètres. - Niveau 2 – Une API de niveau 2 utilise les verbes HTTP pour effectuer des actions :
GETpour récupérer,POSTpour créer etPUTpour mettre à jour. Les paramètres de requête dans l’URL et le corps de la requête, le cas échéant, précisent les paramètres de l’action. Cela permet aux services de tirer parti de l’infrastructure web, notamment de la mise en cache pour les requêtesGET. - Niveau 3 – La conception d’une API de niveau 3 repose sur le principe au nom particulièrement mal choisi HATEOAS (Hypertext As The Engine Of Application State, soit « l’hypertexte comme moteur de l’état de l’application »). L’idée de base est que la représentation d’une ressource renvoyée par une requête
GETcontient des liens permettant d’effectuer les actions autorisées sur cette ressource. Par exemple, un client peut annuler une commande à l’aide d’un lien figurant dans la représentation de la commande renvoyée en réponse à la requêteGETenvoyée pour récupérer cette commande. Les avantages de HATEOAS incluent notamment le fait de ne plus avoir à coder les URL en dur dans le code client. Autre avantage : comme la représentation d’une ressource contient des liens vers les actions autorisées, le client n’a pas à deviner quelles actions peuvent être effectuées sur une ressource dans son état actuel.
L’utilisation d’un protocole basé sur HTTP présente de nombreux avantages :
- HTTP est simple et familier.
- Vous pouvez tester une API HTTP depuis un navigateur à l’aide d’une extension telle que Postman ou depuis la ligne de commande avec
curl(à condition d’utiliser JSON ou un autre format texte). - Il prend directement en charge les communications de type requête/réponse.
- HTTP est, bien sûr, compatible avec les pare-feu.
- Il ne nécessite pas de courtier intermédiaire, ce qui simplifie l’architecture du système.
L’utilisation de HTTP présente quelques inconvénients :
- Il ne prend directement en charge que les interactions de type requête/réponse. Vous pouvez utiliser HTTP pour les notifications, mais le serveur doit toujours envoyer une réponse HTTP.
- Comme le client et le service communiquent directement (sans intermédiaire pour mettre les messages en mémoire tampon), ils doivent tous deux être en cours d’exécution pendant toute la durée de l’échange.
- Le client doit connaître l’emplacement (c’est-à-dire l’URL) de chaque instance de service. Comme l’explique l’article précédent sur la passerelle API, il s’agit d’un problème complexe dans une application moderne. Les clients doivent utiliser un mécanisme de découverte de services pour localiser les instances de service.
La communauté des développeurs a récemment redécouvert l’intérêt d’un langage de définition d’interface pour les API RESTful. Plusieurs options existent, notamment RAML et Swagger. Certains langages de définition d’interface (IDL), comme Swagger, permettent de définir le format des messages de requête et de réponse. D’autres, comme RAML, nécessitent l’utilisation d’une spécification distincte, telle que JSON Schema. En plus de décrire les API, les IDL disposent généralement d’outils permettant de générer des souches côté client et des squelettes côté serveur à partir d’une définition d’interface.
Thrift
Apache Thrift est une alternative intéressante à REST. Ce framework permet de développer des clients et des serveurs RPC dans différents langages. Thrift fournit un langage de définition d’interfaces (IDL) de style C pour définir vos API. Le compilateur Thrift permet de générer des stubs côté client et des squelettes côté serveur. Il génère du code pour divers langages, notamment C++, Java, Python, PHP, Ruby, Erlang et Node.js.
Une interface Thrift se compose d’un ou de plusieurs services. La définition d’un service est analogue à une interface Java. Il s’agit d’un ensemble de méthodes fortement typées. Les méthodes Thrift peuvent soit renvoyer une valeur (éventuellement de type void), soit être définies comme unidirectionnelles. Les méthodes qui renvoient une valeur mettent en œuvre un mode d’interaction de type requête/réponse. Le client attend une réponse et peut lever une exception. Les méthodes unidirectionnelles correspondent à un mode d’interaction de type notification. Le serveur n’envoie pas de réponse.
Thrift prend en charge plusieurs formats de messages : JSON, binaire et binaire compact. Le format binaire est plus efficace que JSON, car il est plus rapide à décoder. Et, comme son nom l’indique, le format binaire compact occupe peu d’espace. JSON est, bien sûr, facilement lisible par les humains et bien adapté aux navigateurs. Thrift vous permet également de choisir parmi plusieurs protocoles de transport, notamment TCP brut et HTTP. TCP brut est généralement plus efficace que HTTP. Cependant, HTTP est compatible avec les pare-feu et les navigateurs, et plus facile à utiliser pour les humains.
Formats de message
Maintenant que nous avons étudié HTTP et Thrift, examinons la question des formats de message. Si vous utilisez un système de messagerie ou REST, vous pouvez choisir votre format de message. D’autres mécanismes de communication interprocessus (IPC), comme Thrift, peuvent ne prendre en charge qu’un nombre limité de formats de message, voire un seul. Dans tous les cas, il est important d’utiliser un format de message compatible avec plusieurs langages de programmation. Même si vous écrivez aujourd’hui vos microservices dans un seul langage, il est probable que vous en utiliserez d’autres à l’avenir.
Il existe deux grands types de formats de message : textuels et binaires. JSON et XML sont des exemples de formats textuels. Ces formats présentent l’avantage d’être non seulement lisibles par l’être humain, mais aussi autodescriptifs. En JSON, les attributs d’un objet sont représentés par un ensemble de paires nom-valeur. De même, en XML, les attributs sont représentés par des éléments nommés et des valeurs. Cela permet au consommateur d’un message de sélectionner les valeurs qui l’intéressent et d’ignorer les autres. Par conséquent, il est facile d’apporter des modifications mineures au format des messages tout en préservant la rétrocompatibilité.
La structure des documents XML est définie par un schéma XML. Au fil du temps, la communauté des développeurs a pris conscience que JSON avait également besoin d’un mécanisme similaire. Une possibilité consiste à utiliser JSON Schema, soit de manière autonome, soit dans le cadre d’un langage de définition d’interface (IDL) tel que Swagger.
L’un des inconvénients des formats de messages textuels est leur tendance à être verbeux, en particulier XML. Les messages étant autodescriptifs, chacun contient le nom des attributs en plus de leurs valeurs. Un autre inconvénient est le surcoût lié à l’analyse du texte. Il peut donc être judicieux d’envisager l’utilisation d’un format binaire.
Plusieurs formats binaires sont disponibles. Si vous utilisez Thrift RPC, vous pouvez utiliser le format binaire de Thrift. Si vous avez le choix du format des messages, les options les plus courantes comprennent Protocol Buffers et Apache Avro. Ces deux formats proposent un langage de définition d’interface (IDL) typé pour définir la structure de vos messages. Ils présentent toutefois une différence : Protocol Buffers utilise des champs étiquetés, tandis qu’un consommateur Avro doit connaître le schéma pour interpréter les messages. Il est donc plus facile de faire évoluer une API avec Protocol Buffers qu’avec Avro. Cet article de blog propose une excellente comparaison de Thrift, Protocol Buffers et Avro.
Résumé
Les microservices doivent communiquer au moyen d’un mécanisme de communication interprocessus. Lorsque vous concevez la manière dont vos services communiqueront, vous devez tenir compte de plusieurs aspects : les interactions entre les services, la définition de l’API de chaque service, l’évolution des API et la gestion des défaillances partielles. Les microservices peuvent utiliser deux types de mécanismes de communication interprocessus (IPC) : la messagerie asynchrone et le modèle requête-réponse synchrone. Dans le prochain article de cette série, nous examinerons la question de la découverte de services dans une architecture de microservices.
La rédaction – Cette série de sept articles est désormais complète :
- Introduction aux microservices
- Créer des microservices : utiliser une passerelle API
- Concevoir des microservices : communication interprocessus dans une architecture de microservices (cet article)
- Découverte de services dans une architecture de microservices
- Gestion des données pilotée par les événements pour les microservices
- Choisir une stratégie de déploiement des microservices
- Refactoriser un monolithe en microservices
Vous pouvez également télécharger l’ensemble des articles, ainsi que des informations sur la mise en œuvre de microservices avec NGINX Plus, sous forme d’ebook – Microservices : de la conception au déploiement.
Chris Richardson, auteur invité sur ce blog, est le fondateur de la plateforme d’origine CloudFoundry.com, l’une des premières PaaS (plateformes en tant que service) Java pour Amazon EC2. Il accompagne aujourd’hui les entreprises pour les aider à améliorer leurs méthodes de développement et de déploiement d’applications. Il publie également régulièrement des articles sur les microservices sur http://microservices.io.
À propos de l’auteur
Articles de blog associés
Tendances actuelles des technologies cloud natives, de l’ingénierie de plateforme et de l’IA
Découvrez les principaux enseignements tirés des réponses à l’enquête annuelle F5 NGINX sur les dernières tendances en matière de technologies cloud natives, de sécurité, d’ingénierie de plateforme et d’IA.

Quels contrôleurs Ingress NGINX sont affectés par les vulnérabilités CVE-2022-4886, CVE-2023-5043 et CVE-2023-5044 ?
Lorsque de nouvelles CVE sont signalées, il est facile de ne plus savoir si elles concernent un outil de contrôleur Ingress NGINX particulier, car il existe plusieurs projets. Cet article présente les CVE et explique comment distinguer les différents projets de contrôleurs Ingress afin de dissiper toute confusion.
Votre API est-elle en temps réel ? Testez sa latence avec l’outil rtapi de NGINX
Votre API répond-elle aux requêtes en moins de 30 ms ? Si ce n’est pas le cas, il ne s’agit pas d’une API en temps réel offrant la faible latence exigée par la grande majorité des organisations. Mesurez la latence de votre API avec l’outil rtapi de NGINX et découvrez comment NGINX peut l’aider à offrir une réactivité en temps réel.
Un testeur d’expressions régulières pour NGINX et NGINX Plus
Le testeur d’expressions régulières (regex) pour NGINX et NGINX Plus vous évite de tâtonner en vous indiquant si une expression régulière utilisée dans un bloc location ou map correspond aux valeurs comme prévu. Il génère la configuration appropriée et affiche les valeurs des groupes de capture.
Caches partagés avec les clusters de cache NGINX Plus, partie 1
Optimisez la capacité de votre cache web en le répartissant entre plusieurs serveurs de cache web NGINX ou NGINX Plus. Découvrez comment procéder dans cet article.
Introduction aux microservices
Les microservices suscitent actuellement beaucoup d’intérêt. Cet article de blog est le premier d’une série de sept consacrée à la conception, au développement et au déploiement de microservices.