Rédacteur – Cette série de sept articles est désormais terminée :
- Introduction aux microservices
- Créer des microservices : utiliser une passerelle API
- Création de microservices : communication interprocessus dans une architecture de microservices
- Découverte de services dans une architecture de microservices
- Gestion des données pilotée par les événements pour les microservices
- Choisir une stratégie de déploiement des microservices
- Refactoriser un monolithe en microservices (cet article)
Vous pouvez également télécharger l’ensemble des articles, ainsi que des informations sur la mise en œuvre de microservices avec NGINX Plus, sous forme d’ebook : « Microservices : de la conception au déploiement ». Consultez également notre série sur l’architecture de référence des microservices et la page des solutions de microservices.
Voici le septième et dernier article de ma série consacrée au développement d’applications à l’aide de microservices. Le premier article présente le modèle d’architecture de microservices et examine les avantages et les inconvénients de l’utilisation des microservices. Les articles suivants abordent différents aspects de l’architecture de microservices : l’utilisation d’une passerelle API<.htmla>, la communication interprocessus, la découverte de services, la gestion des données basée sur les événements, ainsi que le déploiement de microservices. Dans cet article, nous examinons les stratégies permettant de migrer une application monolithique vers des microservices.
J’espère que cette série d’articles vous a permis de bien comprendre l’architecture de microservices, ses avantages et ses inconvénients, ainsi que les situations dans lesquelles l’utiliser. Peut-être l’architecture de microservices est-elle bien adaptée à votre organisation.
Cependant, il est fort probable que vous travailliez sur une application monolithique volumineuse et complexe. Au quotidien, le développement et le déploiement de votre application sont lents et laborieux. Les microservices semblent être un nirvana inaccessible. Heureusement, il existe des stratégies pour sortir de l’enfer monolithique. Dans cet article, j’explique comment remanier progressivement une application monolithique pour la transformer en un ensemble de microservices.
Vue d’ensemble de la refactorisation vers les microservices
Le processus de transformation d’une application monolithique en microservices est une forme de modernisation des applications. C’est une pratique à laquelle les développeurs ont recours depuis des décennies. Nous pouvons donc réutiliser certains concepts lors de la refactorisation d’une application en microservices.
Une stratégie à éviter est la réécriture « Big Bang ». Elle consiste à concentrer tous vos efforts de développement sur la création de A à Z d’une nouvelle application basée sur des microservices. Bien que cette approche puisse sembler séduisante, elle est extrêmement risquée et se soldera probablement par un échec. Comme Martin Fowler l’aurait déclaré : « La seule chose qu’une réécriture Big Bang garantit, c’est un Big Bang ! »
Au lieu de procéder à une réécriture « Big Bang », vous devriez remanier progressivement votre application monolithique. Vous développez peu à peu une nouvelle application composée de microservices et l’exécutez parallèlement à votre application monolithique. Au fil du temps, les fonctionnalités assurées par l’application monolithique diminuent, jusqu’à ce que celle-ci disparaisse complètement ou ne devienne plus qu’un microservice parmi d’autres. Cette stratégie revient à entretenir votre voiture tout en roulant sur l’autoroute à 110 km/h : c’est difficile, mais bien moins risqué que de tenter une réécriture « Big Bang ».
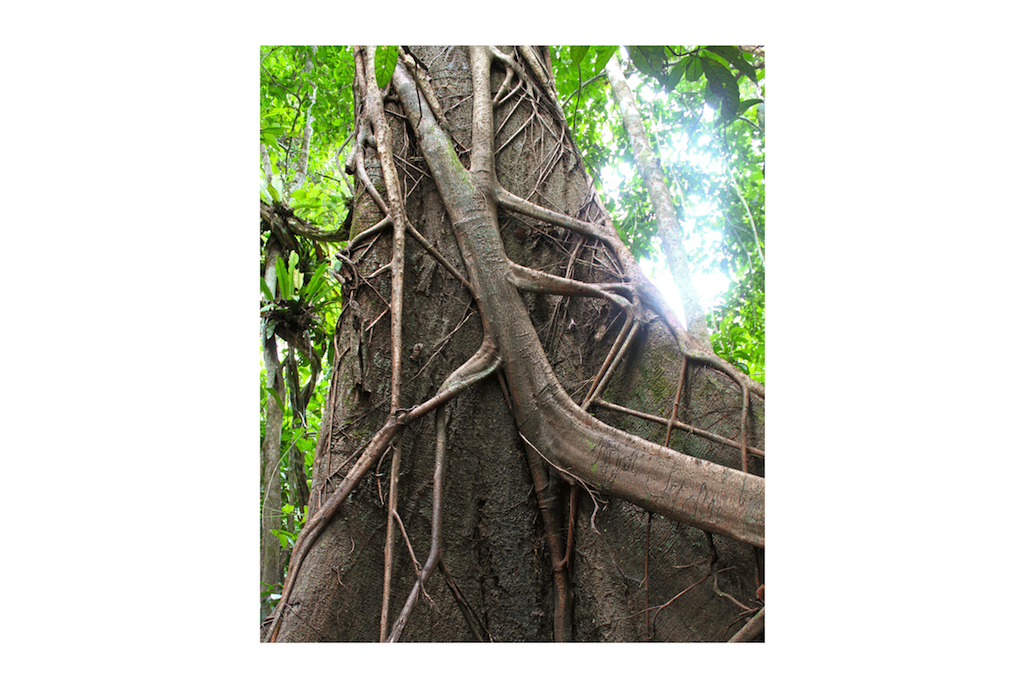
Martin Fowler désigne cette stratégie de modernisation des applications sous le nom d’« application étrangleuse ». Ce nom vient de la liane étrangleuse (également appelée figuier étrangleur) que l’on trouve dans les forêts tropicales. Une liane étrangleuse pousse autour d’un arbre afin d’atteindre la lumière du soleil au-dessus de la canopée. Il arrive que l’arbre meure, ne laissant derrière lui qu’une liane en forme d’arbre. La modernisation des applications suit le même principe. Nous allons construire autour de l’application existante une nouvelle application composée de microservices, jusqu’à ce que l’ancienne finisse par disparaître.
Examinons différentes stratégies pour y parvenir.
Stratégie 1 – Arrêtez de creuser
La loi des trous dit que lorsque vous êtes dans un trou, vous devez arrêter de creuser. C’est un excellent conseil à suivre lorsque votre application monolithique est devenue ingérable. Autrement dit, vous devez cesser d’agrandir le monolithe. Cela signifie que lorsque vous implémentez une nouvelle fonctionnalité, vous ne devez pas ajouter davantage de code au monolithe. L’idée maîtresse de cette stratégie consiste plutôt à placer ce nouveau code dans un microservice autonome. Le schéma suivant présente l’architecture du système après l’application de cette approche.
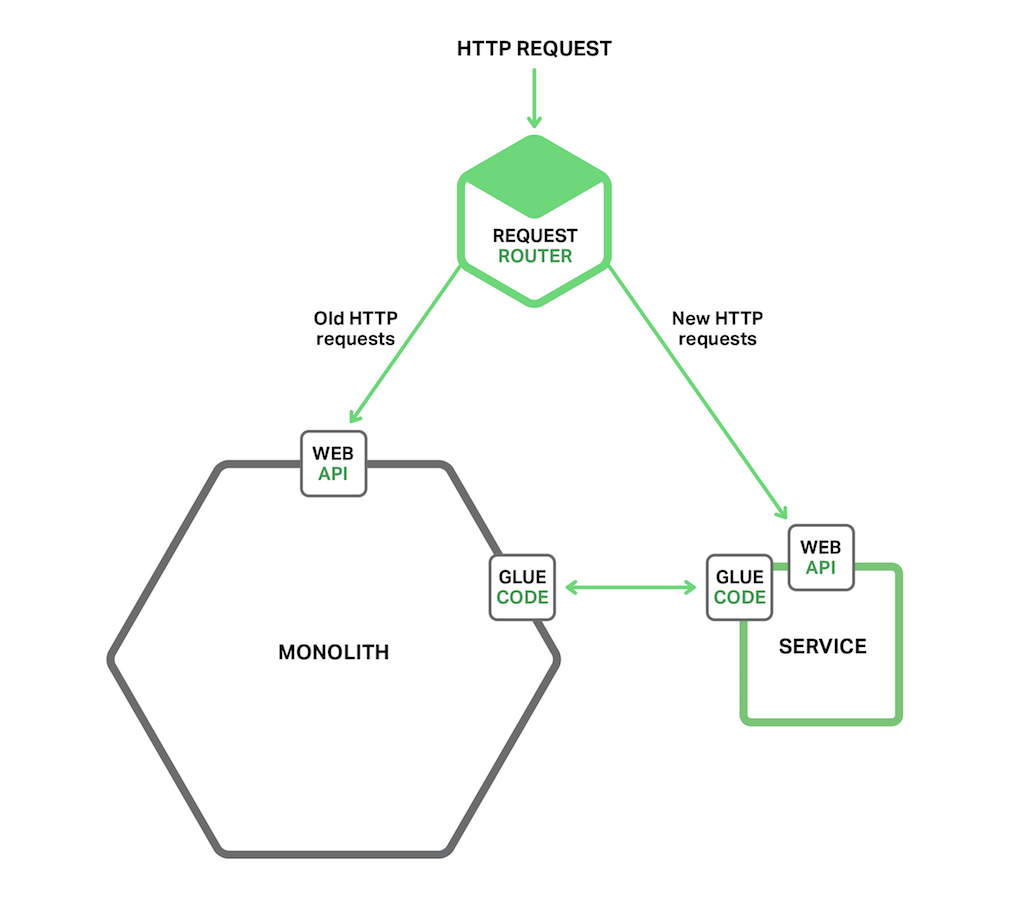
Outre le nouveau service et le monolithe existant, il existe deux autres composants. Le premier est un routeur de requêtes, qui traite les requêtes entrantes (HTTP). Il est similaire à la passerelle API décrite dans un article précédent<.htmla>. Le routeur envoie au nouveau service les requêtes correspondant aux nouvelles fonctionnalités. Il achemine les requêtes existantes vers le monolithe.
L’autre composant est le code de liaison, qui assure l’intégration du service avec le monolithe. Un service existe rarement de manière isolée et doit souvent accéder à des données détenues par le monolithe. Le code de liaison, qui réside dans le monolithe, dans le service ou dans les deux, est responsable de l’intégration des données. Le service utilise le code de liaison pour lire et écrire les données détenues par le monolithe.
Un service peut utiliser trois stratégies pour accéder aux données du monolithe :
- Appeler une API distante fournie par le monolithe
- Accéder directement à la base de données du monolithe
- Conserver sa propre copie des données, synchronisée avec la base de données du monolithe
Le code d’adaptation est parfois appelé une « couche anticorruption ». En effet, il empêche que le modèle de domaine propre au service soit contaminé par des concepts issus du modèle de domaine du monolithe existant. Le code d’adaptation assure la traduction entre ces deux modèles distincts. Le terme « couche anticorruption » est apparu pour la première fois dans l’ouvrage incontournable Domain Driven Design d’Eric Evans, avant d’être approfondi dans un livre blanc. Développer une couche anticorruption peut s’avérer complexe. Mais sa création est indispensable si vous voulez sortir progressivement de l’enfer monolithique.
La mise en œuvre de nouvelles fonctionnalités sous la forme d’un service léger présente plusieurs avantages. Elle évite que le monolithe ne devienne encore plus difficile à gérer. Le service peut être développé, déployé et mis à l’échelle indépendamment du monolithe. Vous bénéficiez des avantages de l’architecture de microservices pour chaque nouveau service que vous créez.
Cependant, cette approche ne résout en rien les problèmes liés au monolithe. Pour y remédier, vous devez décomposer le monolithe. Examinons les stratégies permettant d’y parvenir.
Stratégie 2 – Séparer le frontend et le backend
Une stratégie permettant de réduire l’application monolithique consiste à séparer la couche de présentation des couches de logique métier et d’accès aux données. Une application d’entreprise classique se compose d’au moins trois types de composants différents :
- Couche de présentation – Composants qui traitent les requêtes HTTP et mettent en œuvre soit une API (REST), soit une interface utilisateur web basée sur HTML. Dans une application dotée d’une interface utilisateur sophistiquée, la couche de présentation représente souvent une part importante du code.
- Couche de logique métier – Composants qui constituent le cœur de l’application et mettent en œuvre les règles métier.
- Couche d’accès aux données – Composants qui accèdent aux composants d’infrastructure tels que les bases de données et les courtiers de messages.
Il existe généralement une séparation nette entre la logique de présentation, d’une part, et la logique métier et d’accès aux données, d’autre part. La couche métier dispose d’une API à granularité grossière composée d’une ou de plusieurs façades qui encapsulent les composants de logique métier. Cette API constitue une frontière naturelle permettant de scinder le monolithe en deux applications plus petites. L’une contient la couche de présentation. L’autre contient la logique métier et la logique d’accès aux données. Après cette scission, l’application de logique de présentation effectue des appels distants à l’application de logique métier. Le schéma suivant illustre l’architecture avant et après le remaniement.
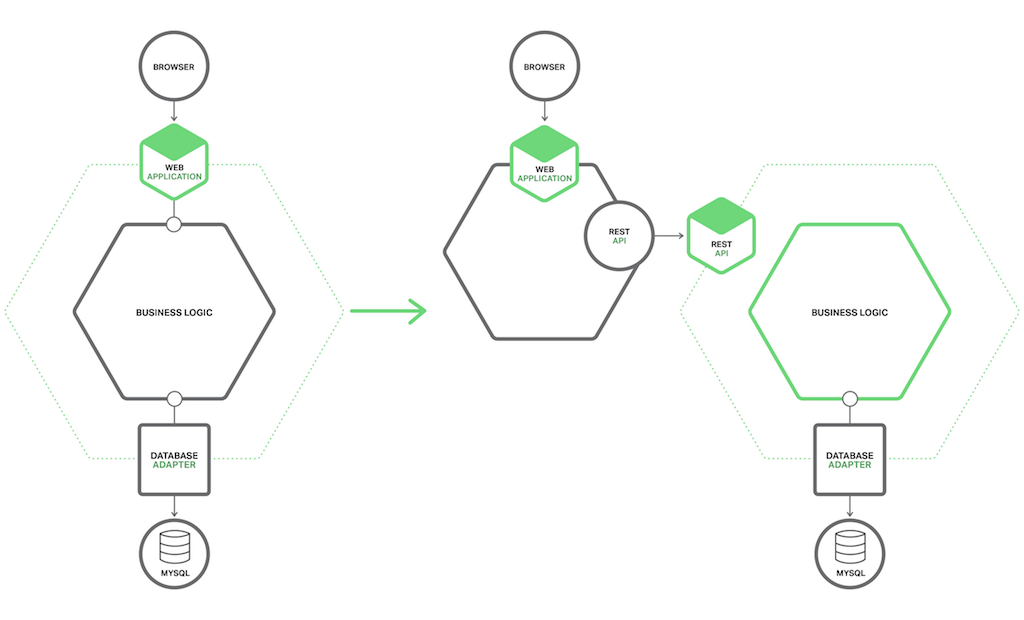
La décomposition d’un monolithe de cette manière présente deux avantages principaux. Elle permet de développer, de déployer et de faire évoluer les deux applications indépendamment l’une de l’autre. Elle permet notamment aux développeurs de la couche de présentation d’itérer rapidement sur l’interface utilisateur et, par exemple, d’effectuer facilement des tests A/B. Cette approche présente un autre avantage : elle expose une API distante qui peut être appelée par les microservices que vous développez.
Cette stratégie ne constitue toutefois qu’une solution partielle. Il est fort probable que l’une des applications, voire les deux, forme un monolithe ingérable. Vous devez recourir à la troisième stratégie pour éliminer le ou les monolithes restants.
Stratégie 3 – Extraire des services
La troisième stratégie de refactorisation consiste à transformer les modules existants au sein du monolithe en microservices autonomes. Chaque fois que vous extrayez un module pour le transformer en service, le monolithe se réduit. Une fois que vous aurez converti suffisamment de modules, le monolithe ne posera plus de problème. Soit il disparaîtra complètement, soit il deviendra suffisamment petit pour n’être plus qu’un service parmi d’autres.
Déterminer les modules à convertir en services en priorité
Une application monolithique volumineuse et complexe se compose de dizaines, voire de centaines de modules, qui peuvent tous être extraits. Il est souvent difficile de déterminer quels modules convertir en premier. Une bonne approche consiste à commencer par quelques modules faciles à extraire. Vous pourrez ainsi acquérir de l’expérience sur les microservices en général et sur le processus d’extraction en particulier. Vous pourrez ensuite extraire les modules qui vous apporteront le plus de bénéfices.
La transformation d’un module en service prend généralement du temps. Il convient de classer les modules en fonction des avantages que vous en retirerez. Il est généralement judicieux d’extraire les modules qui changent fréquemment. Une fois un module transformé en service, vous pouvez le développer et le déployer indépendamment du monolithe, ce qui accélérera le développement.
Il est également avantageux d’extraire les modules dont les besoins en ressources diffèrent sensiblement de ceux du reste du monolithe. Par exemple, il peut être utile de transformer en service un module doté d’une base de données en mémoire, afin de pouvoir ensuite le déployer sur des hôtes disposant de grandes quantités de mémoire. De même, il peut être judicieux d’extraire les modules qui mettent en œuvre des algorithmes nécessitant une puissance de calcul importante, puisque le service peut alors être déployé sur des hôtes dotés de nombreux processeurs. En transformant en services les modules ayant des besoins particuliers en ressources, vous pouvez considérablement faciliter la mise à l’échelle de votre application.
Pour déterminer quels modules extraire, il est utile de rechercher les frontières à gros grain existantes (également appelées « points de découplage »). Elles permettent de transformer plus facilement et à moindre coût les modules en services. Un module qui communique avec le reste de l’application uniquement par l’intermédiaire de messages asynchrones constitue un exemple de ce type de frontière. Transformer ce module en microservice peut alors être relativement simple et peu coûteux.
Comment extraire un module
La première étape de l’extraction d’un module consiste à définir une interface à granularité grossière entre le module et le monolithe. Il s’agira très probablement d’une API bidirectionnelle, puisque le monolithe aura besoin des données détenues par le service, et inversement. La mise en œuvre d’une telle API est souvent complexe en raison de l’enchevêtrement des dépendances et des interactions à granularité fine entre le module et le reste de l’application. La logique métier mise en œuvre à l’aide du patron Modèle de domaine est particulièrement difficile à remanier en raison des nombreuses associations entre les classes du modèle de domaine. Vous devrez souvent apporter des modifications importantes au code pour rompre ces dépendances. Le diagramme suivant illustre ce remaniement.
Une fois l’interface à granularité grossière implémentée, vous transformez le module en un service autonome. Pour ce faire, vous devez écrire du code permettant au monolithe et au service de communiquer par l’intermédiaire d’une API utilisant un mécanisme de communication interprocessus (IPC). Le diagramme suivant présente l’architecture avant, pendant et après le remaniement.
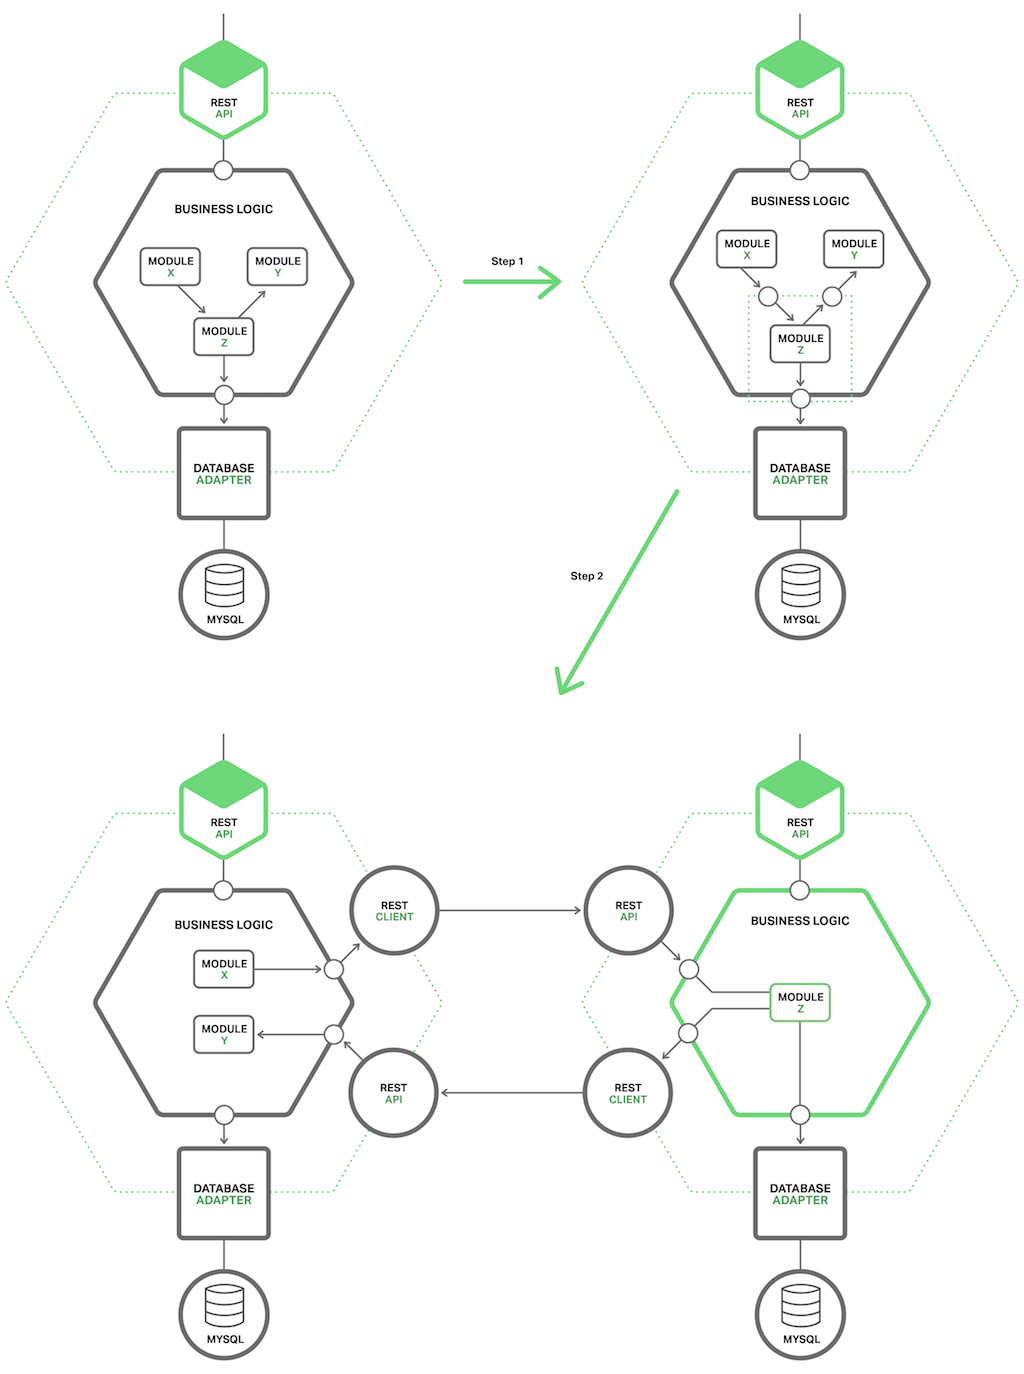
Dans cet exemple, le module Z est le module candidat à l’extraction. Ses composants sont utilisés par le module X, tandis qu’il utilise lui-même le module Y. La première étape de la refactorisation consiste à définir deux API à granularité grossière. La première est une interface entrante utilisée par le module X pour appeler le module Z. La seconde est une interface sortante utilisée par le module Z pour appeler le module Y.
La deuxième étape de refactorisation transforme le module en un service autonome. Les interfaces entrante et sortante sont implémentées par du code qui utilise un mécanisme IPC. Vous devrez très probablement créer le service en combinant le module Z avec un framework de châssis de microservices qui prend en charge des préoccupations transversales telles que la découverte de services.
Une fois que vous avez extrait un module, vous disposez d’un nouveau service qui peut être développé, déployé et mis à l’échelle indépendamment du monolithe et de tout autre service. Vous pouvez même réécrire le service de zéro ; dans ce cas, le code de l’API qui intègre le service au monolithe devient une couche anticorruption assurant la traduction entre les deux modèles de domaine. Chaque fois que vous extrayez un service, vous faites un pas de plus vers les microservices. Au fil du temps, le monolithe se réduira et le nombre de microservices augmentera.
Résumé
Le processus de migration d’une application existante vers une architecture de microservices constitue une forme de modernisation applicative. Vous ne devez pas adopter les microservices en réécrivant entièrement votre application. Vous devez plutôt remanier progressivement votre application pour la transformer en un ensemble de microservices. Trois stratégies s’offrent à vous : implémenter les nouvelles fonctionnalités sous forme de microservices ; séparer les composants de présentation des composants métier et d’accès aux données ; et convertir en services les modules existants de l’application monolithique. Au fil du temps, le nombre de microservices augmentera, tout comme l’agilité et la rapidité de votre équipe de développement.
La rédaction – Cette série de sept articles est désormais terminée :
- Introduction aux microservices
- Créer des microservices : utiliser une passerelle API
- Créer des microservices : communication interprocessus dans une architecture de microservices
- Découverte de services dans une architecture de microservices
- Gestion des données pilotée par les événements pour les microservices
- Choisir une stratégie de déploiement des microservices
- Refactoriser un monolithe en microservices (cet article)
Vous pouvez également télécharger l’ensemble des articles, ainsi que des informations sur la mise en œuvre de microservices avec NGINX Plus, sous forme d’ebook – Microservices : de la conception au déploiement. Consultez également notre série sur l’architecture de référence des microservices ainsi que la page des solutions de microservices.
Le blogueur invité Chris Richardson est le fondateur du site original CloudFoundry.com, l’une des premières plateformes Java en tant que service (PaaS) pour Amazon EC2. Il conseille aujourd’hui des organisations afin d’améliorer leurs méthodes de développement et de déploiement d’applications. Il publie également régulièrement des articles sur les microservices à l’adresse https://microservices.io
À propos de l’auteur
Articles de blog associés
Tendances actuelles des technologies cloud natives, de l’ingénierie de plateforme et de l’IA
Découvrez les principaux enseignements tirés des réponses à l’enquête annuelle F5 NGINX sur les dernières tendances en matière de technologies cloud natives, de sécurité, d’ingénierie de plateforme et d’IA.

Quels contrôleurs Ingress NGINX sont affectés par les vulnérabilités CVE-2022-4886, CVE-2023-5043 et CVE-2023-5044 ?
Lorsque de nouvelles CVE sont signalées, il est facile de ne plus savoir si elles concernent un outil de contrôleur Ingress NGINX particulier, car il existe plusieurs projets. Cet article présente les CVE et explique comment distinguer les différents projets de contrôleurs Ingress afin de dissiper toute confusion.
Votre API est-elle en temps réel ? Testez sa latence avec l’outil rtapi de NGINX
Votre API répond-elle aux requêtes en moins de 30 ms ? Si ce n’est pas le cas, il ne s’agit pas d’une API en temps réel offrant la faible latence exigée par la grande majorité des organisations. Mesurez la latence de votre API avec l’outil rtapi de NGINX et découvrez comment NGINX peut l’aider à offrir une réactivité en temps réel.
Un testeur d’expressions régulières pour NGINX et NGINX Plus
Le testeur d’expressions régulières (regex) pour NGINX et NGINX Plus vous évite de tâtonner en vous indiquant si une expression régulière utilisée dans un bloc location ou map correspond aux valeurs comme prévu. Il génère la configuration appropriée et affiche les valeurs des groupes de capture.
Caches partagés avec les clusters de cache NGINX Plus, partie 1
Optimisez la capacité de votre cache web en le répartissant entre plusieurs serveurs de cache web NGINX ou NGINX Plus. Découvrez comment procéder dans cet article.
Introduction aux microservices
Les microservices suscitent actuellement beaucoup d’intérêt. Cet article de blog est le premier d’une série de sept consacrée à la conception, au développement et au déploiement de microservices.