Rédaction – Cette série de sept articles est désormais terminée :
- Introduction aux microservices
- Créer des microservices : utiliser une passerelle API (cet article)
- Création de microservices : communication interprocessus dans une architecture de microservices
- Découverte de services dans une architecture de microservices
- Gestion des données pilotée par les événements pour les microservices
- Choisir une stratégie de déploiement des microservices
- Refactoriser un monolithe en microservices
Vous pouvez également télécharger l’ensemble des articles, ainsi que des informations sur la mise en œuvre de microservices avec NGINX Plus, sous forme d’ebook : « Microservices : de la conception au déploiement ». Nous vous invitons également à consulter la nouvelle page Solutions de microservices.
Le premier article de cette série en sept parties consacrée à la conception, au développement et au déploiement de microservices a présenté le modèle d’architecture de microservices. Il a abordé les avantages et les inconvénients de l’utilisation des microservices et expliqué pourquoi, malgré leur complexité, ils constituent généralement le choix idéal pour les applications complexes. Ce deuxième article de la série traite du développement de microservices à l’aide d’une passerelle API.
Lorsque vous choisissez de concevoir votre application sous la forme d’un ensemble de microservices, vous devez déterminer comment les clients de votre application interagiront avec ces microservices. Une application monolithique ne comporte qu’un seul ensemble de points de terminaison (généralement répliqués et avec équilibrage de charge). Dans une architecture de microservices, en revanche, chaque microservice expose un ensemble de points de terminaison généralement très granulaires. Dans cet article, nous examinons l’incidence de cette approche sur la communication entre les clients et l’application, et proposons une solution reposant sur une passerelle d’API.
Introduction
Imaginons que vous développiez un client mobile natif pour une application d’achat en ligne. Vous devrez probablement créer une page détaillée affichant les informations relatives à chaque produit.
Par exemple, le schéma suivant montre ce que vous verrez en faisant défiler les détails d’un produit dans l’application mobile Android d’Amazon.
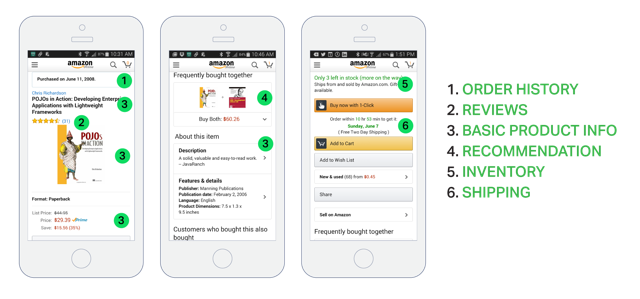
Bien qu’il s’agisse d’une application pour smartphone, la page détaillée du produit affiche de nombreuses informations. Par exemple, outre les informations de base sur le produit (telles que son nom, sa description et son prix), cette page présente également :
- Nombre d’articles dans le panier
- Historique des commandes
- Avis clients
- Alerte de stock faible
- Options de livraison
- Diverses recommandations, notamment d’autres produits fréquemment achetés avec celui-ci, d’autres produits achetés par les clients ayant acheté ce produit et d’autres produits consultés par les clients ayant acheté ce produit
- Autres options d’achat
Avec une architecture d’application monolithique, un client mobile récupérerait ces données en effectuant un seul appel REST (GET api.company.com/productdetails/productId) vers l’application. Un équilibreur de charge achemine la requête vers l’une des N instances identiques de l’application. L’application interrogerait ensuite différentes tables de base de données et renverrait la réponse au client.
En revanche, avec une architecture de microservices, les données affichées sur la page de détails du produit sont gérées par plusieurs microservices. Voici quelques-uns des microservices susceptibles de gérer les données affichées sur cet exemple de page de détails du produit :
- Service de panier – Nombre d’articles dans le panier
- Service de commande – Historique des commandes
- Service de catalogue – Informations de base sur le produit, telles que son nom, son image et son prix
- Service d’avis – Avis des clients
- Service de gestion des stocks – Alerte de stock faible
- Service d’expédition – Options, délais et coûts d’expédition récupérés séparément depuis l’API du prestataire de livraison
- Service(s) de recommandation – Articles suggérés
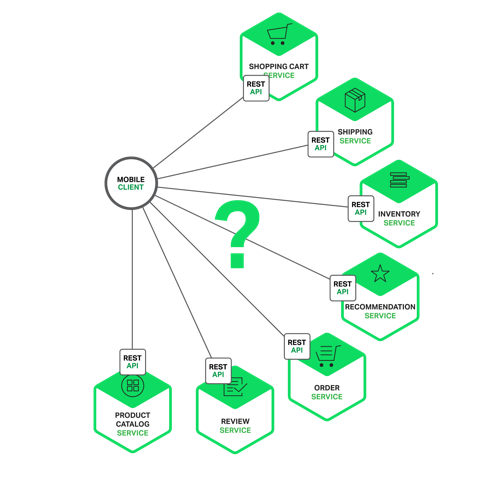
Nous devons décider de la manière dont le client mobile accède à ces services. Examinons les différentes options.
Communication directe entre le client et les microservices
En théorie, un client pourrait envoyer des requêtes directement à chacun des microservices. Chaque microservice disposerait d’un point de terminaison public (https://serviceName.api.company.name). Cette URL pointerait vers l’équilibreur de charge du microservice, qui répartirait les requêtes entre les instances disponibles. Pour récupérer les détails du produit, le client mobile enverrait des requêtes à chacun des services répertoriés ci-dessus.
Malheureusement, cette option présente des difficultés et des limites. L’un des problèmes réside dans l’inadéquation entre les besoins du client et les API très granulaires exposées par chacun des microservices. Dans cet exemple, le client doit effectuer sept requêtes distinctes. Dans des applications plus complexes, il pourrait devoir en effectuer beaucoup plus. Par exemple, Amazon explique que des centaines de services interviennent dans l’affichage de sa page produit. Si un client peut effectuer autant de requêtes sur un réseau local, cela serait probablement trop inefficace sur l’Internet public et assurément peu pratique sur un réseau mobile. Cette approche rend également le code client beaucoup plus complexe.
Un autre problème lié au fait que le client appelle directement les microservices est que certains d’entre eux peuvent utiliser des protocoles qui ne sont pas adaptés au Web. Un service peut utiliser les appels de procédure à distance binaires de Thrift, tandis qu’un autre peut utiliser le protocole de messagerie AMQP. Aucun de ces protocoles n’est particulièrement adapté aux navigateurs ou aux pare-feu, et il est préférable de les utiliser en interne. Une application doit utiliser des protocoles tels que HTTP et WebSocket à l’extérieur du pare-feu.
Un autre inconvénient de cette approche est qu’elle complique le remaniement des microservices. Au fil du temps, nous pourrions vouloir modifier la façon dont le système est réparti entre les différents services. Par exemple, nous pourrions fusionner deux services ou scinder un service en deux services ou plus. Toutefois, si les clients communiquent directement avec les services, ce type de remaniement peut s’avérer extrêmement difficile.
En raison de ce type de problèmes, il est rarement judicieux que les clients communiquent directement avec les microservices.
Utilisation d’une passerelle API
En général, une bien meilleure approche consiste à utiliser ce que l’on appelle une passerelle API. Une passerelle API est un serveur qui constitue le point d’entrée unique du système. Elle est comparable au patron de conception Façade de la programmation orientée objet. La passerelle API masque l’architecture interne du système et fournit une API adaptée à chaque client. Elle peut également assumer d’autres responsabilités, telles que l’authentification, la supervision, l’équilibrage de charge, la mise en cache, la mise en forme et la gestion des requêtes, ainsi que le traitement des réponses statiques.
Le diagramme suivant montre comment une passerelle API s’intègre généralement dans l’architecture :
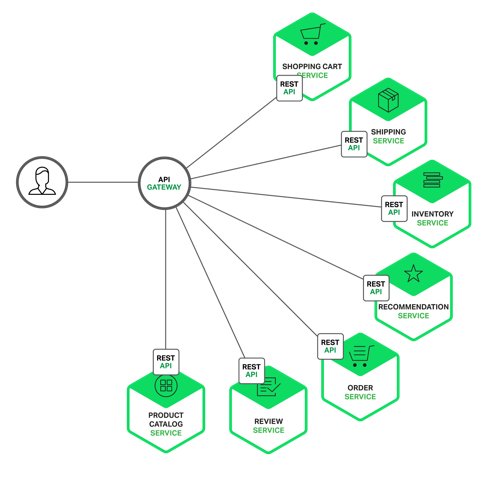
La passerelle API est chargée du routage et de la composition des requêtes, ainsi que de la traduction des protocoles. Toutes les requêtes des clients passent d’abord par la passerelle API, qui les achemine ensuite vers le microservice approprié. La passerelle API traite souvent une requête en faisant appel à plusieurs microservices et en agrégeant leurs résultats. Elle peut assurer la traduction entre des protocoles web tels que HTTP et WebSocket et des protocoles internes peu adaptés au web.
La passerelle API peut également fournir à chaque client une API personnalisée. Elle expose généralement une API à granularité grossière pour les clients mobiles. Prenons, par exemple, le scénario de consultation des détails d’un produit. La passerelle API peut fournir un point de terminaison (/productdetails?productid=xxx) qui permet à un client mobile de récupérer tous les détails du produit en une seule requête. La passerelle API traite la requête en faisant appel aux différents services – informations sur le produit, recommandations, avis, etc. – et en combinant les résultats.
La passerelle API de Netflix est un excellent exemple de passerelle API. Le service de streaming de Netflix est disponible sur des centaines de types d’appareils différents, notamment des téléviseurs, des décodeurs, des smartphones, des consoles de jeux, des tablettes, etc. Au départ, Netflix a tenté de proposer une API universelle pour son service de streaming. Cependant, l’entreprise a constaté que cette approche ne fonctionnait pas bien en raison de la grande diversité des appareils et de leurs besoins spécifiques. Aujourd’hui, elle utilise une passerelle API qui fournit une API adaptée à chaque appareil en exécutant du code d’adaptation propre à celui-ci. Pour traiter chaque requête, un adaptateur fait généralement appel à six ou sept services backend en moyenne. La passerelle API de Netflix traite des milliards de requêtes par jour.
Avantages et inconvénients d’une passerelle API
Comme vous pouvez vous y attendre, l’utilisation d’une passerelle API présente à la fois des avantages et des inconvénients. L’un de ses principaux avantages est qu’elle masque la structure interne de l’application. Au lieu d’avoir à appeler des services spécifiques, les clients communiquent simplement avec la passerelle. Celle-ci fournit une API spécifique à chaque type de client. Cela réduit le nombre d’allers-retours entre le client et l’application, tout en simplifiant le code côté client.
La passerelle API présente également quelques inconvénients. Il s’agit d’un composant supplémentaire à haute disponibilité qui doit être développé, déployé et géré. La passerelle API risque également de devenir un goulot d’étranglement pour le développement. Les développeurs doivent la mettre à jour afin d’exposer les points de terminaison de chaque microservice. Il est important que le processus de mise à jour de la passerelle API soit aussi simple que possible. Dans le cas contraire, les développeurs seront contraints d’attendre leur tour pour la mettre à jour. Malgré ces inconvénients, l’utilisation d’une passerelle API reste toutefois pertinente pour la plupart des applications réelles.
Mise en œuvre d’une passerelle API
Maintenant que nous avons examiné les motivations et les compromis liés à l’utilisation d’une passerelle API, intéressons-nous aux différents aspects de conception à prendre en compte.
Performances et évolutivité
Seules quelques entreprises opèrent à l’échelle de Netflix et doivent traiter des milliards de requêtes par jour. Toutefois, pour la plupart des applications, les performances et l’évolutivité de la passerelle API sont généralement très importantes. Il est donc judicieux de concevoir la passerelle API sur une plateforme prenant en charge les E/S asynchrones et non bloquantes. Différentes technologies permettent de mettre en œuvre une passerelle API évolutive. Sur la JVM, vous pouvez utiliser l’un des frameworks basés sur NIO, tels que Netty, Vertx, Spring Reactor ou JBoss Undertow. Parmi les solutions populaires ne reposant pas sur la JVM figure Node.js, une plateforme basée sur le moteur JavaScript de Chrome. Une autre possibilité consiste à utiliser NGINX Plus. NGINX Plus offre un serveur web et un proxy inverse éprouvés, évolutifs et hautement performants, faciles à déployer, à configurer et à programmer. NGINX Plus peut gérer l’authentification, le contrôle d’accès, l’équilibrage de charge des requêtes et la mise en cache des réponses, et fournit des contrôles d’intégrité et une supervision tenant compte des applications.
Utiliser un modèle de programmation réactive
La passerelle API traite certaines requêtes en les acheminant simplement vers le service backend approprié. Elle en traite d’autres en appelant plusieurs services backend et en agrégeant les résultats. Pour certaines requêtes, comme une demande de détails sur un produit, les requêtes adressées aux services backend sont indépendantes les unes des autres. Afin de réduire au minimum le temps de réponse, la passerelle API doit exécuter simultanément les requêtes indépendantes. Il existe toutefois parfois des dépendances entre les requêtes. La passerelle API peut d’abord devoir valider la requête en appelant un service d’authentification, avant de l’acheminer vers un service backend. De même, pour récupérer des informations sur les produits figurant dans la liste de souhaits d’un client, la passerelle API doit d’abord récupérer le profil du client contenant ces informations, puis récupérer les informations relatives à chaque produit. Un autre exemple intéressant de composition d’API est la grille vidéo de Netflix.
L’écriture de code de composition d’API selon l’approche traditionnelle fondée sur les rappels asynchrones mène rapidement à l’enfer des callbacks. Le code devient enchevêtré, difficile à comprendre et sujet aux erreurs. Une bien meilleure approche consiste à écrire le code de l’API Gateway dans un style déclaratif en adoptant une approche réactive. Parmi les abstractions réactives, on trouve Future dans Scala, CompletableFuture dans Java 8 et Promise dans JavaScript. Il existe également Reactive Extensions (aussi appelé Rx ou ReactiveX), initialement développé par Microsoft pour la plateforme .NET. Netflix a créé RxJava pour la JVM, spécifiquement afin de l’utiliser dans son API Gateway. Il existe aussi RxJS pour JavaScript, qui fonctionne aussi bien dans le navigateur que dans Node.js. Une approche réactive vous permettra d’écrire du code d’API Gateway à la fois simple et efficace.
Invocation de services
Une application basée sur des microservices est un système distribué et doit utiliser un mécanisme de communication interprocessus. Il existe deux modes de communication interprocessus. L’une des possibilités consiste à utiliser un mécanisme asynchrone reposant sur une messagerie. Certaines implémentations utilisent un courtier de messages tel que JMS ou AMQP. D’autres, comme Zeromq, n’utilisent pas de courtier et les services communiquent directement. L’autre mode de communication interprocessus repose sur un mécanisme synchrone tel que HTTP ou Thrift. En règle générale, un système utilise à la fois des modes asynchrones et synchrones. Il peut même utiliser plusieurs implémentations de chaque mode. Par conséquent, la passerelle d’API devra prendre en charge divers mécanismes de communication.
Découverte de services
La passerelle API doit connaître l’emplacement (adresse IP et port) de chaque microservice avec lequel elle communique. Dans une application traditionnelle, il serait probablement possible de coder ces emplacements en dur, mais dans une application moderne de microservices basée sur le cloud, il s’agit d’un problème complexe. Les services d’infrastructure, tels qu’un courtier de messages, ont généralement un emplacement statique, qui peut être spécifié au moyen de variables d’environnement du système d’exploitation. En revanche, déterminer l’emplacement d’un service applicatif n’est pas aussi simple. Les emplacements des services applicatifs sont attribués dynamiquement. De plus, l’ensemble des instances d’un service évolue de manière dynamique en raison de la mise à l’échelle automatique et des mises à niveau. Par conséquent, comme tout autre client de service du système, la passerelle API doit utiliser le mécanisme de découverte de services du système : soit la découverte côté serveur, soit la découverte côté client. Un article ultérieur décrira plus en détail la découverte de services. Pour l’instant, il convient de noter que si le système utilise la découverte côté client, la passerelle API doit pouvoir interroger le registre de services, qui est une base de données répertoriant toutes les instances de microservices et leurs emplacements.
Gestion des défaillances partielles
Un autre problème à prendre en compte lors de la mise en œuvre d’une passerelle API est celui des défaillances partielles. Ce problème se pose dans tous les systèmes distribués lorsqu’un service en appelle un autre qui répond lentement ou qui est indisponible. La passerelle API ne doit jamais rester bloquée indéfiniment dans l’attente d’un service en aval. Toutefois, la manière dont elle gère la défaillance dépend du scénario précis et du service défaillant. Par exemple, si le service de recommandation ne répond pas lors de la consultation des détails d’un produit, la passerelle API doit renvoyer au client le reste des informations sur le produit, car celles-ci restent utiles à l’utilisateur. Les recommandations peuvent être absentes ou remplacées, par exemple, par une liste prédéfinie des dix produits les plus populaires. En revanche, si le service d’informations sur les produits ne répond pas, la passerelle API doit renvoyer une erreur au client.
La passerelle API pourrait également renvoyer des données mises en cache si elles sont disponibles. Par exemple, comme les prix des produits changent peu fréquemment, la passerelle API pourrait renvoyer les données tarifaires mises en cache si le service de tarification est indisponible. Les données peuvent être mises en cache par la passerelle API elle-même ou stockées dans un cache externe tel que Redis ou Memcached. En renvoyant des données par défaut ou mises en cache, la passerelle API garantit que les défaillances du système n’affectent pas l’expérience utilisateur.
Netflix Hystrix est une bibliothèque extrêmement utile pour écrire du code qui appelle des services distants. Hystrix interrompt les appels qui dépassent le délai spécifié. Elle met en œuvre un modèle de disjoncteur, qui évite au client d’attendre inutilement un service qui ne répond pas. Si le taux d’erreur d’un service dépasse un seuil spécifié, Hystrix déclenche le disjoncteur et toutes les requêtes échouent immédiatement pendant une période déterminée. Hystrix vous permet de définir une action de repli en cas d’échec d’une requête, par exemple lire les données depuis un cache ou renvoyer une valeur par défaut. Si vous utilisez la JVM, vous devriez sérieusement envisager d’utiliser Hystrix. Et si vous travaillez dans un environnement non‑JVM, vous devriez utiliser une bibliothèque équivalente.
Résumé
Pour la plupart des applications basées sur des microservices, il est judicieux de mettre en œuvre une passerelle API, qui fait office de point d’entrée unique dans le système. La passerelle API est chargée du routage et de la composition des requêtes, ainsi que de la traduction des protocoles. Elle fournit une API personnalisée à chaque client de l’application. Elle peut également masquer les défaillances des services backend en renvoyant des données mises en cache ou des données par défaut. Dans le prochain article de cette série, nous aborderons la communication entre les services.
Rédaction – Cette série de sept articles est désormais terminée :
- Introduction aux microservices
- Créer des microservices : utiliser une passerelle API (cet article)
- Créer des microservices : la communication interprocessus dans une architecture de microservices
- Découverte de services dans une architecture de microservices
- Gestion des données pilotée par les événements pour les microservices
- Choisir une stratégie de déploiement des microservices
- Refactoriser un monolithe en microservices
Vous pouvez également télécharger l’ensemble des articles, ainsi que des informations sur la mise en œuvre de microservices avec NGINX Plus, sous forme d’ebook – Microservices : de la conception au déploiement.
Pour une présentation détaillée d’autres cas d’utilisation, consultez notre série de trois articles de blog, « Déploiement de NGINX Plus en tant que passerelle API » :
- La partie 1 fournit des instructions de configuration détaillées pour plusieurs cas d’utilisation.
- Partie 2 étend ces cas d’utilisation et examine différentes mesures de protection pouvant être mises en œuvre pour protéger et sécuriser les services d’API backend en production.
- Partie 3 explique comment déployer NGINX Plus en tant que passerelle API pour les services gRPC.
Le blogueur invité Chris Richardson est le fondateur du site d’origine CloudFoundry.com, l’une des premières plateformes Java en tant que service (PaaS) pour Amazon EC2. Il conseille aujourd’hui des organisations afin d’améliorer leurs méthodes de développement et de déploiement d’applications. Il publie également régulièrement des articles sur les microservices à l’adresse http://microservices.io.
À propos de l’auteur
Articles de blog associés

Tendances actuelles des technologies cloud natives, de l’ingénierie de plateforme et de l’IA
Découvrez les principaux enseignements tirés des réponses à l’enquête annuelle F5 NGINX sur les dernières tendances en matière de technologies cloud natives, de sécurité, d’ingénierie de plateforme et d’IA.

Quels contrôleurs Ingress NGINX sont affectés par les vulnérabilités CVE-2022-4886, CVE-2023-5043 et CVE-2023-5044 ?
Lorsque de nouvelles CVE sont signalées, il est facile de ne plus savoir si elles concernent un outil de contrôleur Ingress NGINX particulier, car il existe plusieurs projets. Cet article présente les CVE et explique comment distinguer les différents projets de contrôleurs Ingress afin de dissiper toute confusion.
Votre API est-elle en temps réel ? Testez sa latence avec l’outil rtapi de NGINX
Votre API répond-elle aux requêtes en moins de 30 ms ? Si ce n’est pas le cas, il ne s’agit pas d’une API en temps réel offrant la faible latence exigée par la grande majorité des organisations. Mesurez la latence de votre API avec l’outil rtapi de NGINX et découvrez comment NGINX peut l’aider à offrir une réactivité en temps réel.

Un testeur d’expressions régulières pour NGINX et NGINX Plus
Le testeur d’expressions régulières (regex) pour NGINX et NGINX Plus vous évite de tâtonner en vous indiquant si une expression régulière utilisée dans un bloc location ou map correspond aux valeurs comme prévu. Il génère la configuration appropriée et affiche les valeurs des groupes de capture.
Caches partagés avec les clusters de cache NGINX Plus, partie 1
Optimisez la capacité de votre cache web en le répartissant entre plusieurs serveurs de cache web NGINX ou NGINX Plus. Découvrez comment procéder dans cet article.
Introduction aux microservices
Les microservices suscitent actuellement beaucoup d’intérêt. Cet article de blog est le premier d’une série de sept consacrée à la conception, au développement et au déploiement de microservices.