Rédacteur – Cette série de sept articles est désormais terminée :
- Introduction aux microservices
- Créer des microservices : utiliser une passerelle API
- Créer des microservices : la communication interprocessus dans une architecture de microservices (cet article)
- Découverte de services dans une architecture de microservices
- Gestion des données pilotée par les événements pour les microservices
- Choisir une stratégie de déploiement des microservices
- Refactoriser un monolithe en microservices
Vous pouvez également télécharger l’ensemble des articles, ainsi que des informations sur la mise en œuvre de microservices avec NGINX Plus, sous forme d’ebook : « Microservices : de la conception au déploiement ». Nous vous invitons également à consulter la nouvelle page consacrée aux solutions de microservices.
Voici le troisième article de notre série consacrée à la création d’applications reposant sur une architecture de microservices. Le premier article présente le modèle d’architecture de microservices, le compare au modèle d’architecture monolithique et examine les avantages et les inconvénients de l’utilisation des microservices. Le deuxième article décrit comment les clients d’une application communiquent avec les microservices par l’intermédiaire d’un composant appelé passerelle API. Dans cet article, nous examinons comment les services d’un système communiquent entre eux. Le quatrième article aborde la question étroitement liée de la découverte de services.
Introduction
Dans une application monolithique, les composants s’appellent les uns les autres au moyen d’appels de méthodes ou de fonctions propres au langage. À l’inverse, une application basée sur des microservices est un système distribué qui s’exécute sur plusieurs machines. Chaque instance de service correspond généralement à un processus. Par conséquent, comme l’illustre le schéma suivant, les services doivent interagir à l’aide d’un mécanisme de communication interprocessus (IPC).
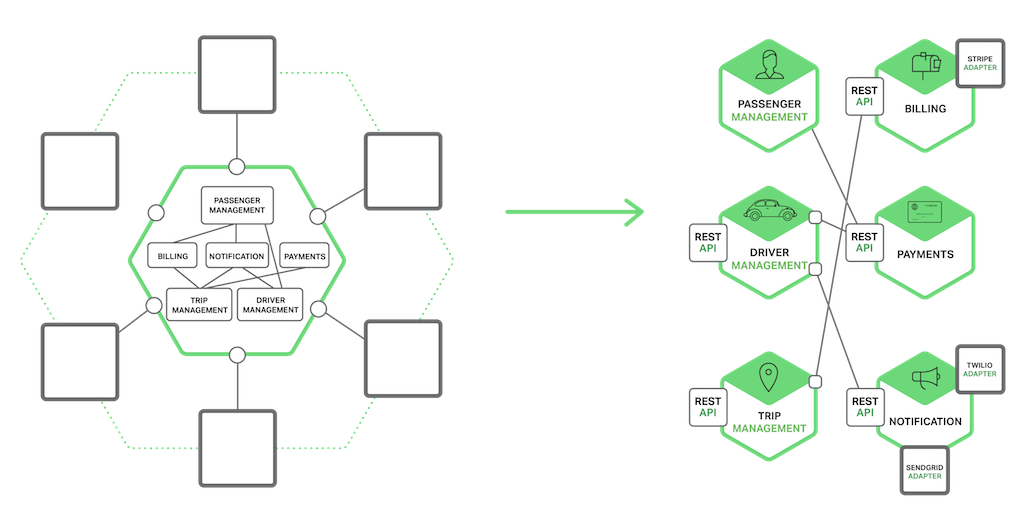
Nous examinerons plus loin des technologies IPC spécifiques, mais commençons par étudier les différentes problématiques de conception.
Styles d’interaction
Lors du choix d’un mécanisme IPC pour un service, il est utile de commencer par réfléchir à la manière dont les services interagissent. Il existe différents modes d’interaction client⇔service. Ils peuvent être classés selon deux dimensions. La première consiste à déterminer si l’interaction est de type un-à-un ou un-à-plusieurs :
- Un à un – Chaque requête client est traitée par une seule instance de service.
- Un-à-plusieurs – Chaque requête est traitée par plusieurs instances de service.
La deuxième dimension consiste à déterminer si l’interaction est synchrone ou asynchrone :
- Synchrone – Le client attend une réponse rapide du service et peut même rester bloqué pendant cette attente.
- Asynchrone – Le client ne reste pas bloqué dans l’attente d’une réponse et celle-ci, le cas échéant, n’est pas nécessairement envoyée immédiatement.
Le tableau suivant présente les différents styles d’interaction.
| Un-à-un | Un-à-plusieurs | |
|---|---|---|
| Synchrone | Requête/réponse | — |
| Asynchrone | Notification | Publication/abonnement |
| Requête/réponse asynchrone | Publication/réponses asynchrones |
Il existe les types d’interactions individuelles suivants :
- Requête/réponse – Un client envoie une requête à un service et attend une réponse. Le client s’attend à recevoir la réponse dans un délai raisonnable. Dans une application basée sur des threads, le thread qui envoie la requête peut même rester bloqué pendant l’attente.
- Notification (également appelée requête unidirectionnelle) – Un client envoie une requête à un service, mais aucune réponse n’est attendue ni envoyée.
- Requête/réponse asynchrone – Un client envoie une requête à un service, qui répond de manière asynchrone. Le client ne reste pas bloqué dans l’attente de la réponse et est conçu en partant du principe que celle-ci peut mettre un certain temps à arriver.
Il existe les types d’interactions un-à-plusieurs suivants :
- Publication/abonnement – Un client publie un message de notification, qui est consommé par zéro, un ou plusieurs services intéressés.
- Publication/réponses asynchrones – Un client publie un message de requête, puis attend pendant un certain temps les réponses des services intéressés.
Chaque service utilise généralement une combinaison de ces modes d’interaction. Pour certains services, un seul mécanisme IPC suffit. D’autres peuvent nécessiter une combinaison de mécanismes IPC. Le schéma suivant montre comment les services d’une application de réservation de taxis peuvent interagir lorsqu’un utilisateur demande une course.
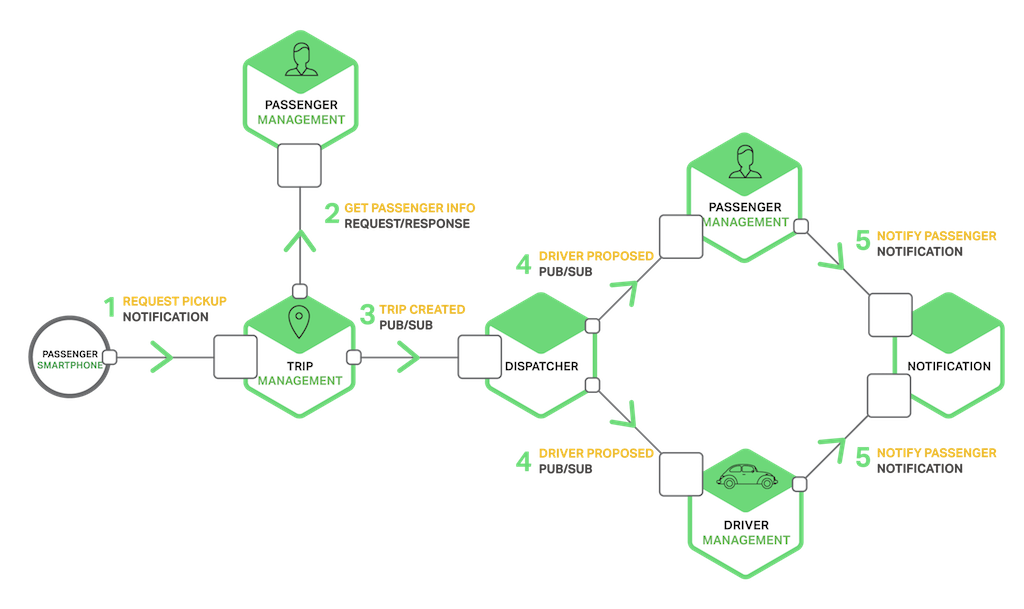
Les services utilisent une combinaison de notifications, de requêtes/réponses et de publication/abonnement. Par exemple, le smartphone du passager envoie une notification au service de gestion des trajets pour demander une prise en charge. Le service de gestion des trajets vérifie que le compte du passager est actif en utilisant le modèle requête/réponse pour appeler le service des passagers. Il crée ensuite le trajet et utilise le modèle publication/abonnement pour avertir d’autres services, notamment le répartiteur, qui recherche un chauffeur disponible.
Maintenant que nous avons examiné les styles d’interaction, voyons comment définir des API.
Définir des API
L’API d’un service constitue un contrat entre ce service et ses clients. Quel que soit le mécanisme IPC choisi, il est important de définir précisément l’API d’un service à l’aide d’un langage de définition d’interface (IDL). Il existe même de solides arguments en faveur d’une approche API-first pour définir les services. Le développement d’un service commence par la rédaction de la définition de l’interface et son examen avec les développeurs des clients. Ce n’est qu’après plusieurs itérations sur la définition de l’API que vous implémentez le service. Réaliser ce travail de conception en amont augmente vos chances de créer un service qui répond aux besoins de ses clients.
Comme vous le verrez plus loin dans cet article, la nature de la définition de l’API dépend du mécanisme IPC utilisé. Si vous utilisez une messagerie, l’API se compose des canaux de messages et des types de messages. Si vous utilisez HTTP, l’API se compose des URL ainsi que des formats de requête et de réponse. Nous décrirons plus loin certains langages de définition d’interface (IDL) de manière plus détaillée.
Évolution des API
L’API d’un service évolue inévitablement au fil du temps. Dans une application monolithique, il est généralement assez simple de modifier l’API et de mettre à jour tous les appelants. Dans une application basée sur des microservices, cela s’avère beaucoup plus difficile, même si tous les consommateurs de votre API sont d’autres services de la même application. En général, vous ne pouvez pas contraindre tous les clients à effectuer leur mise à niveau en même temps que le service. De plus, vous allez probablement déployer progressivement de nouvelles versions d’un service, de sorte que les anciennes et les nouvelles versions de ce service fonctionneront simultanément. Il est important de disposer d’une stratégie pour gérer ces problématiques.
La manière de gérer une modification d’API dépend de l’ampleur de celle-ci. Certaines modifications sont mineures et rétrocompatibles avec la version précédente. Vous pouvez, par exemple, ajouter des attributs aux requêtes ou aux réponses. Il est judicieux de concevoir les clients et les services de façon à ce qu’ils respectent le principe de robustesse. Les clients qui utilisent une ancienne API doivent continuer à fonctionner avec la nouvelle version du service. Le service fournit des valeurs par défaut pour les attributs de requête manquants, tandis que les clients ignorent les éventuels attributs de réponse supplémentaires. Il est important d’utiliser un mécanisme IPC et un format de messagerie qui vous permettent de faire évoluer facilement vos API.
Cependant, il est parfois nécessaire d’apporter des modifications majeures et incompatibles à une API. Comme vous ne pouvez pas obliger les clients à effectuer immédiatement la mise à niveau, un service doit prendre en charge les anciennes versions de l’API pendant un certain temps. Si vous utilisez un mécanisme basé sur HTTP, tel que REST, une solution consiste à intégrer le numéro de version dans l’URL. Chaque instance du service peut gérer plusieurs versions simultanément. Vous pouvez également déployer différentes instances, chacune prenant en charge une version particulière.
Gestion des défaillances partielles
Prenons, par exemple, le scénario des détails du produit présenté dans cet article. Imaginons que le service de recommandation ne réponde pas. Une implémentation naïve d’un client pourrait rester bloquée indéfiniment dans l’attente d’une réponse. Non seulement cela nuirait à l’expérience utilisateur, mais, dans de nombreuses applications, cela mobiliserait également une ressource précieuse, telle qu’un thread. L’environnement d’exécution finirait par ne plus disposer de threads et cesserait de répondre, comme l’illustre la figure suivante.
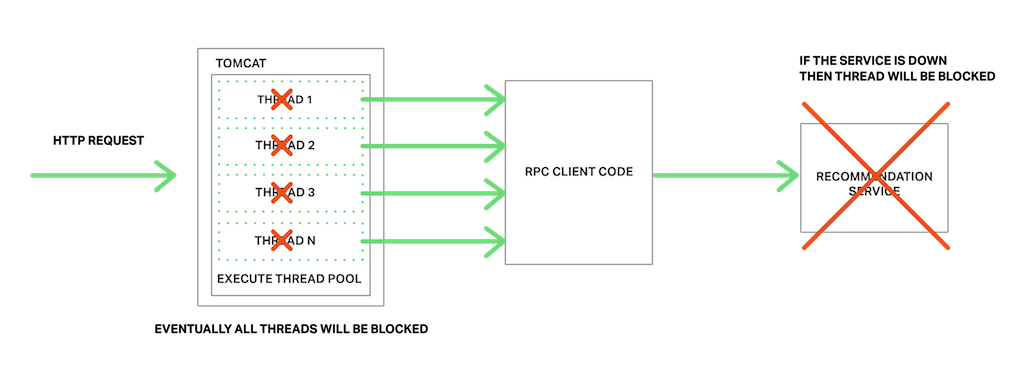
Pour éviter ce problème, il est essentiel de concevoir vos services de manière à gérer les défaillances partielles.
Une bonne approche à suivre est celle décrite par Netflix. Les stratégies permettant de gérer les défaillances partielles comprennent :
- Délais d’expiration réseau – Ne bloquez jamais indéfiniment et définissez toujours un délai d’expiration lorsque vous attendez une réponse. L’utilisation de délais d’expiration garantit que les ressources ne restent jamais mobilisées indéfiniment.
- Limitation du nombre de requêtes en attente – Fixez une limite maximale au nombre de requêtes en attente qu’un client peut avoir auprès d’un service donné. Si cette limite est atteinte, il est probablement inutile d’effectuer des requêtes supplémentaires, et ces tentatives doivent échouer immédiatement.
- Patron de disjoncteur – Comptabilisez le nombre de requêtes réussies et échouées. Si le taux d’erreur dépasse un seuil configuré, déclenchez le disjoncteur afin que les tentatives suivantes échouent immédiatement. Si un grand nombre de requêtes échouent, cela indique que le service est indisponible et qu’il est inutile d’envoyer des requêtes. Après un délai d’attente, le client doit réessayer et, en cas de réussite, réarmer le disjoncteur.
- Prévoir des solutions de repli – Exécutez une logique de repli lorsqu’une requête échoue. Par exemple, renvoyez des données mises en cache ou une valeur par défaut, telle qu’un ensemble vide de recommandations.
Netflix Hystrix est une bibliothèque open source qui met en œuvre ces modèles ainsi que d’autres. Si vous utilisez la JVM, vous devriez sérieusement envisager d’utiliser Hystrix. Et si vous travaillez dans un environnement non-JVM, vous devriez utiliser une bibliothèque équivalente.
Technologies IPC
Il existe de nombreuses technologies IPC parmi lesquelles choisir. Les services peuvent utiliser des mécanismes de communication synchrones basés sur un modèle requête/réponse, tels que REST sur HTTP ou Thrift. Ils peuvent également recourir à des mécanismes de communication asynchrones basés sur des messages, tels qu’AMQP ou STOMP. Il existe aussi différents formats de messages. Les services peuvent utiliser des formats texte lisibles par l’être humain, tels que JSON ou XML. Ils peuvent également utiliser un format binaire, plus efficace, tel qu’Avro ou Protocol Buffers. Nous examinerons plus loin les mécanismes IPC synchrones, mais commençons par aborder les mécanismes IPC asynchrones.
Communication asynchrone basée sur les messages
Lorsqu’ils utilisent une messagerie, les processus communiquent en échangeant des messages de manière asynchrone. Un client adresse une requête à un service en lui envoyant un message. Si le service est censé répondre, il le fait en envoyant un message distinct au client. La communication étant asynchrone, le client ne reste pas bloqué dans l’attente d’une réponse. Il est au contraire conçu en partant du principe que la réponse ne sera pas reçue immédiatement.
Un message se compose d’en-têtes (des métadonnées telles que l’expéditeur) et d’un corps de message. Les messages sont échangés via des canaux. Un nombre quelconque de producteurs peuvent envoyer des messages à un canal. De même, un nombre quelconque de consommateurs peuvent recevoir des messages depuis un canal. Il existe deux types de canaux : point à point et publication-abonnement. Un canal point à point transmet un message à un seul des consommateurs qui lisent le canal. Les services utilisent des canaux point à point pour les modes d’interaction un-à-un décrits précédemment. Un canal de publication-abonnement transmet chaque message à tous les consommateurs qui y sont rattachés. Les services utilisent des canaux de publication-abonnement pour les modes d’interaction un-à-plusieurs décrits ci-dessus.
Le schéma suivant montre comment l’application de réservation de taxis pourrait utiliser des canaux de publication-abonnement.
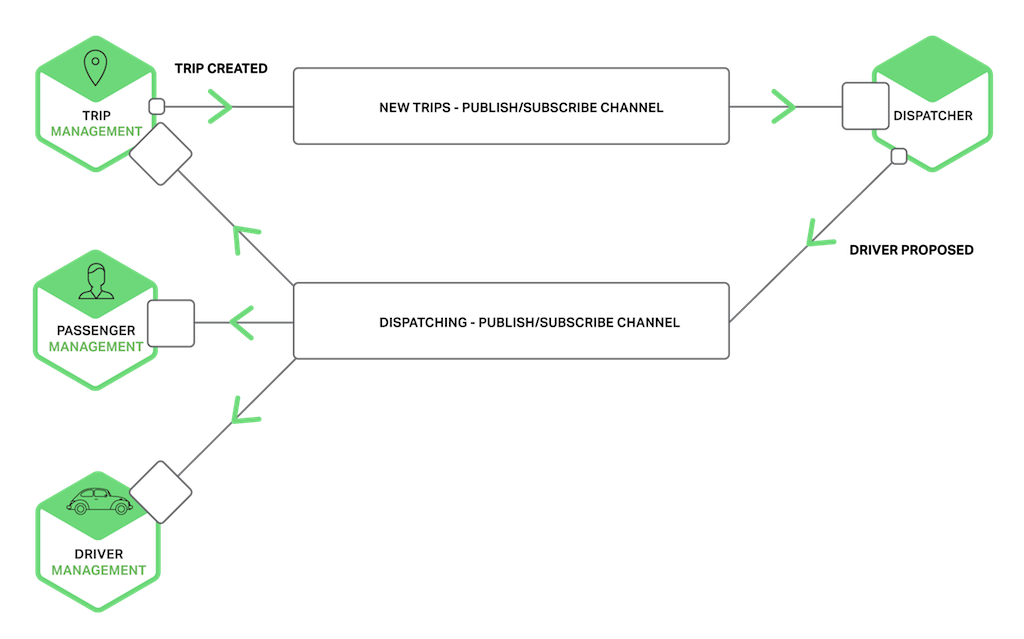
Le service de gestion des courses informe les services concernés, tels que le répartiteur, de la création d’une nouvelle course en publiant un message « Course créée » sur un canal de publication-abonnement. Le répartiteur trouve un chauffeur disponible et en informe les autres services en publiant un message « Chauffeur proposé » sur un canal de publication-abonnement.
Il existe de nombreux systèmes de messagerie. Choisissez-en un qui prend en charge plusieurs langages de programmation. Certains systèmes de messagerie prennent en charge des protocoles standard tels qu’AMQP et STOMP. D’autres utilisent des protocoles propriétaires, mais documentés. Il existe un grand nombre de systèmes de messagerie open source, notamment RabbitMQ, Apache Kafka, Apache ActiveMQ et NSQ. Globalement, ils prennent tous en charge une forme ou une autre de messages et de canaux. Ils s’efforcent tous d’être fiables, performants et évolutifs. Toutefois, les modèles de messagerie de chaque broker diffèrent considérablement dans le détail.
L’utilisation d’un système de messagerie présente de nombreux avantages :
- Découple le client du service – Un client effectue une requête simplement en envoyant un message au canal approprié. Le client n’a aucune connaissance des instances du service. Il n’a pas besoin d’utiliser un mécanisme de découverte pour déterminer l’emplacement d’une instance du service.
- Mise en mémoire tampon des messages – Avec un protocole synchrone de requête/réponse, tel que HTTP, le client et le service doivent tous deux être disponibles pendant toute la durée de l’échange. À l’inverse, un courtier de messages met en file d’attente les messages envoyés à un canal jusqu’à ce qu’ils puissent être traités par le consommateur. Cela signifie, par exemple, qu’une boutique en ligne peut accepter les commandes de ses clients même lorsque le système de traitement des commandes est lent ou indisponible. Les messages de commande sont simplement placés en file d’attente.
- Interactions flexibles entre le client et le service – La messagerie prend en charge tous les modes d’interaction décrits précédemment.
- Communication interprocessus explicite – Les mécanismes basés sur les RPC tentent de faire en sorte que l’appel d’un service distant ressemble à celui d’un service local. Cependant, en raison des lois de la physique et du risque de défaillance partielle, ces deux types d’appels sont en réalité très différents. La messagerie met clairement en évidence ces différences afin que les développeurs ne se laissent pas bercer par un faux sentiment de sécurité.
Cependant, l’utilisation de la messagerie présente certains inconvénients :
- Complexité opérationnelle supplémentaire – Le système de messagerie constitue un composant supplémentaire du système qui doit être installé, configuré et exploité. Il est essentiel que le courtier de messages soit hautement disponible, faute de quoi la fiabilité du système s’en trouve affectée.
- Complexité de la mise en œuvre d’une interaction basée sur le modèle requête/réponse – La mise en œuvre d’une interaction de type requête/réponse nécessite un certain travail. Chaque message de requête doit contenir un identifiant de canal de réponse et un identifiant de corrélation. Le service écrit dans le canal de réponse un message de réponse contenant l’identifiant de corrélation. Le client utilise cet identifiant pour associer la réponse à la requête. Il est souvent plus simple d’utiliser un mécanisme IPC prenant directement en charge le modèle requête/réponse.
Maintenant que nous avons vu comment utiliser l’IPC basé sur la messagerie, examinons l’IPC basé sur le modèle requête/réponse.
IPC synchrone de type requête/réponse
Lorsqu’un mécanisme IPC synchrone fondé sur un modèle requête/réponse est utilisé, un client envoie une requête à un service. Le service traite la requête, puis renvoie une réponse. Dans de nombreux clients, le thread à l’origine de la requête reste bloqué dans l’attente d’une réponse. D’autres clients peuvent utiliser du code client asynchrone et piloté par les événements, éventuellement encapsulé dans des Futures ou des Rx Observables. Toutefois, contrairement à ce qui se passe avec la messagerie, le client part du principe que la réponse arrivera dans un délai raisonnable. De nombreux protocoles sont disponibles. REST et Thrift sont deux protocoles couramment utilisés. Commençons par examiner REST.
REST
Aujourd’hui, il est courant de développer des API dans le style « RESTful ». REST est un mécanisme de communication interprocessus (IPC) qui utilise (presque toujours) HTTP. L’un des concepts clés de REST est la ressource, qui représente généralement un objet métier, tel qu’un client ou un produit, ou une collection d’objets métier. REST utilise les verbes HTTP pour manipuler les ressources, qui sont référencées au moyen d’une URL. Par exemple, une requête GET renvoie la représentation d’une ressource, qui peut prendre la forme d’un document XML ou d’un objet JSON. Une requête POST crée une nouvelle ressource, tandis qu’une requête PUT met à jour une ressource. Pour citer Roy Fielding, le créateur de REST :
« REST fournit un ensemble de contraintes architecturales qui, lorsqu’elles sont appliquées dans leur globalité, mettent l’accent sur l’évolutivité des interactions entre composants, la généricité des interfaces, le déploiement indépendant des composants et le recours à des composants intermédiaires afin de réduire la latence des interactions, de renforcer la sécurité et d’encapsuler les systèmes existants. »
Le schéma suivant illustre l’une des façons dont l’application de réservation de taxis pourrait utiliser REST.
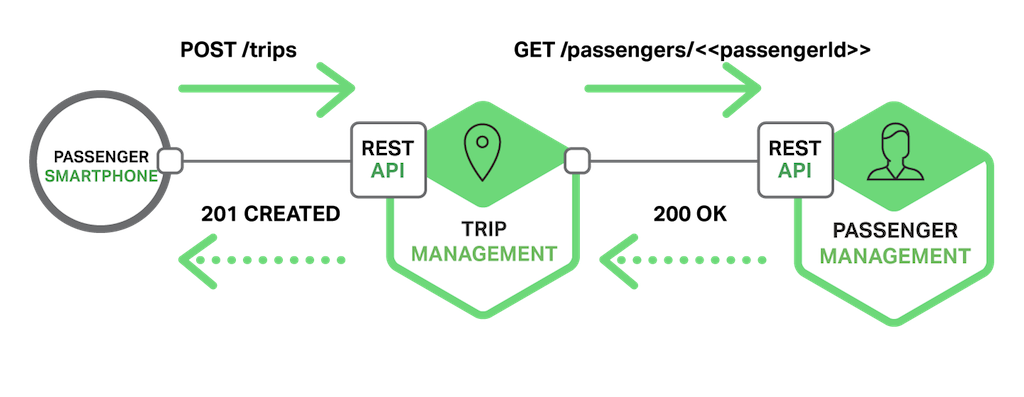
Le smartphone du passager demande une course en envoyant une requête POST à la ressource /trips du service de gestion des courses. Ce service traite la requête en envoyant une requête GET au service de gestion des passagers afin d’obtenir des informations sur le passager. Après avoir vérifié que le passager est autorisé à créer une course, le service de gestion des courses crée la course et renvoie une réponse 201 au smartphone.
De nombreux développeurs affirment que leurs API basées sur HTTP sont RESTful. Cependant, comme l’explique Fielding dans ce billet de blog, elles ne le sont pas toutes réellement. Leonard Richardson (aucun lien de parenté) définit un très utile modèle de maturité REST qui comprend les niveaux suivants.
- Niveau 0 – Les clients d’une API de niveau 0 appellent le service en envoyant des requêtes HTTP
POSTà son unique point de terminaison URL. Chaque requête précise l’action à effectuer, la cible de l’action (par exemple, l’objet métier) et les éventuels paramètres. - Niveau 1 – Une API de niveau 1 prend en charge la notion de ressources. Pour effectuer une action sur une ressource, un client envoie une requête
POSTqui précise l’action à effectuer ainsi que les éventuels paramètres. - Niveau 2 – Une API de niveau 2 utilise les verbes HTTP pour effectuer des actions :
GETpour récupérer,POSTpour créer etPUTpour mettre à jour. Les paramètres de requête et le corps de la requête, le cas échéant, précisent les paramètres de l’action. Cela permet aux services de tirer parti de l’infrastructure web, notamment de la mise en cache des requêtesGET. - Niveau 3 – La conception d’une API de niveau 3 repose sur le principe HATEOAS (Hypertext As The Engine Of Application State), dont le nom est particulièrement mal choisi. L’idée de base est que la représentation d’une ressource renvoyée par une requête
GETcontient des liens permettant d’effectuer les actions autorisées sur cette ressource. Par exemple, un client peut annuler une commande à l’aide d’un lien figurant dans la représentation de la commande renvoyée en réponse à la requêteGETenvoyée pour récupérer la commande. Parmi les avantages de HATEOAS figure le fait qu’il n’est plus nécessaire de coder les URL en dur dans le code client. Un autre avantage tient au fait que, puisque la représentation d’une ressource contient des liens vers les actions autorisées, le client n’a pas à deviner quelles actions peuvent être effectuées sur une ressource dans son état actuel.
L’utilisation d’un protocole basé sur HTTP présente de nombreux avantages :
- HTTP est simple et familier.
- Vous pouvez tester une API HTTP depuis un navigateur à l’aide d’une extension telle que Postman ou depuis la ligne de commande avec
curl(à condition d’utiliser JSON ou un autre format texte). - Il prend directement en charge la communication de type requête/réponse.
- HTTP est, bien sûr, compatible avec les pare-feu.
- Il ne nécessite pas de courtier intermédiaire, ce qui simplifie l’architecture du système.
L’utilisation de HTTP présente certains inconvénients :
- Il ne prend directement en charge que le mode d’interaction requête/réponse. Vous pouvez utiliser HTTP pour les notifications, mais le serveur doit toujours envoyer une réponse HTTP.
- Comme le client et le service communiquent directement (sans intermédiaire pour mettre les messages en mémoire tampon), ils doivent tous deux être en cours d’exécution pendant toute la durée de l’échange.
- Le client doit connaître l’emplacement (c’est-à-dire l’URL) de chaque instance de service. Comme expliqué dans l’article précédent sur la passerelle API, il s’agit d’un problème complexe dans une application moderne. Les clients doivent utiliser un mécanisme de découverte de services pour localiser les instances de service.
La communauté des développeurs a récemment redécouvert l’intérêt d’un langage de définition d’interface pour les API RESTful. Plusieurs options existent, notamment RAML et Swagger. Certains langages de définition d’interface, comme Swagger, permettent de définir le format des messages de requête et de réponse. D’autres, comme RAML, nécessitent l’utilisation d’une spécification distincte telle que JSON Schema. Outre la description des API, les langages de définition d’interface proposent généralement des outils permettant de générer des stubs clients et des squelettes de serveurs à partir d’une définition d’interface.
Thrift
Apache Thrift est une alternative intéressante à REST. Il s’agit d’un framework permettant de développer des RPC clients et serveurs dans différents langages. Thrift fournit un IDL de type C pour définir vos API. Le compilateur Thrift permet de générer des stubs côté client et des squelettes côté serveur. Il génère du code pour divers langages, notamment C++, Java, Python, PHP, Ruby, Erlang et Node.js.
Une interface Thrift se compose d’un ou de plusieurs services. La définition d’un service est analogue à une interface Java. Il s’agit d’un ensemble de méthodes fortement typées. Les méthodes Thrift peuvent soit renvoyer une valeur (éventuellement de type void), soit être définies comme unidirectionnelles. Les méthodes qui renvoient une valeur mettent en œuvre un mode d’interaction de type requête/réponse. Le client attend une réponse et peut lever une exception. Les méthodes unidirectionnelles correspondent à un mode d’interaction de type notification. Le serveur n’envoie aucune réponse.
Thrift prend en charge différents formats de message : JSON, binaire et binaire compact. Le format binaire est plus efficace que JSON, car il est plus rapide à décoder. Et, comme son nom l’indique, le format binaire compact est peu gourmand en espace. JSON est bien sûr facile à lire pour les utilisateurs et compatible avec les navigateurs. Thrift offre également un choix de protocoles de transport, notamment TCP brut et HTTP. TCP brut est probablement plus efficace que HTTP. Cependant, HTTP est compatible avec les pare-feu et les navigateurs, et facile à utiliser pour les utilisateurs.
Formats de messages
Maintenant que nous avons étudié HTTP et Thrift, penchons-nous sur la question des formats de message. Si vous utilisez un système de messagerie ou REST, vous pouvez choisir votre format de message. D’autres mécanismes de communication interprocessus (IPC), tels que Thrift, peuvent ne prendre en charge qu’un nombre limité de formats de message, voire un seul. Dans tous les cas, il est important d’utiliser un format de message compatible avec plusieurs langages. Même si vous développez aujourd’hui vos microservices dans un seul langage, il est probable que vous en utiliserez d’autres à l’avenir.
Il existe deux grandes catégories de formats de message : les formats texte et les formats binaires. JSON et XML sont des exemples de formats textuels. L’un des avantages de ces formats est qu’ils sont non seulement lisibles par l’être humain, mais aussi auto-descriptifs. En JSON, les attributs d’un objet sont représentés par un ensemble de paires nom-valeur. De même, en XML, les attributs sont représentés par des éléments nommés et des valeurs. Le destinataire d’un message peut ainsi extraire les valeurs qui l’intéressent et ignorer les autres. Par conséquent, des modifications mineures du format de message peuvent facilement rester rétrocompatibles.
La structure des documents XML est définie par un schéma XML. Au fil du temps, la communauté des développeurs a pris conscience que JSON avait également besoin d’un mécanisme similaire. Une solution consiste à utiliser JSON Schema, soit de manière autonome, soit dans le cadre d’un langage de description d’interface (IDL) tel que Swagger.
L’un des inconvénients d’un format de message textuel est que les messages ont tendance à être verbeux, en particulier en XML. Comme les messages sont auto-descriptifs, chacun d’eux contient le nom des attributs en plus de leurs valeurs. Un autre inconvénient est le coût lié à l’analyse du texte. Il peut donc être judicieux d’envisager l’utilisation d’un format binaire.
Vous avez le choix entre plusieurs formats binaires. Si vous utilisez Thrift RPC, vous pouvez opter pour le format binaire Thrift. Si vous êtes libre de choisir le format des messages, les options les plus courantes incluent Protocol Buffers et Apache Avro. Ces deux formats fournissent un IDL typé permettant de définir la structure de vos messages. Ils présentent toutefois une différence : Protocol Buffers utilise des champs balisés, tandis qu’un consommateur Avro doit connaître le schéma pour pouvoir interpréter les messages. Par conséquent, il est plus facile de faire évoluer une API avec Protocol Buffers qu’avec Avro. Cet article de blog propose une excellente comparaison de Thrift, Protocol Buffers et Avro.
Résumé
Les microservices doivent communiquer à l’aide d’un mécanisme de communication interprocessus. Lorsque vous définissez la manière dont vos services communiqueront, vous devez prendre en compte plusieurs aspects : la façon dont les services interagissent, la manière de spécifier l’API de chaque service, la façon de faire évoluer les API et la gestion des défaillances partielles. Les microservices peuvent utiliser deux types de mécanismes de communication interprocessus : la messagerie asynchrone et le modèle synchrone requête-réponse. Dans le prochain article de cette série, nous aborderons la problématique de la découverte de services dans une architecture de microservices.
Éditeur – Cette série de sept articles est désormais terminée :
- Introduction aux microservices
- Créer des microservices : utiliser une passerelle API
- Créer des microservices : communication interprocessus dans une architecture de microservices (cet article)
- Découverte de services dans une architecture de microservices
- Gestion des données pilotée par les événements pour les microservices
- Choisir une stratégie de déploiement des microservices
- Refactoriser un monolithe en microservices
Vous pouvez également télécharger l’ensemble des articles, ainsi que des informations sur la mise en œuvre de microservices avec NGINX Plus, sous forme d’ebook – « Microservices : de la conception au déploiement ».
Le blogueur invité Chris Richardson est le fondateur du site original CloudFoundry.com, l’une des premières plateformes Java en tant que service (PaaS) pour Amazon EC2. Il conseille désormais des organisations afin d’améliorer leurs méthodes de développement et de déploiement d’applications. Il publie également régulièrement des articles sur les microservices à l’adresse http://microservices.io.
À propos de l’auteur
Articles de blog associés

Tendances actuelles des technologies cloud natives, de l’ingénierie de plateforme et de l’IA
Découvrez les principaux enseignements tirés des réponses à l’enquête annuelle F5 NGINX sur les dernières tendances en matière de technologies cloud natives, de sécurité, d’ingénierie de plateforme et d’IA.

Quels contrôleurs Ingress NGINX sont affectés par les vulnérabilités CVE-2022-4886, CVE-2023-5043 et CVE-2023-5044 ?
Lorsque de nouvelles CVE sont signalées, il est facile de ne plus savoir si elles concernent un outil de contrôleur Ingress NGINX particulier, car il existe plusieurs projets. Cet article présente les CVE et explique comment distinguer les différents projets de contrôleurs Ingress afin de dissiper toute confusion.
Votre API est-elle en temps réel ? Testez sa latence avec l’outil rtapi de NGINX
Votre API répond-elle aux requêtes en moins de 30 ms ? Si ce n’est pas le cas, il ne s’agit pas d’une API en temps réel offrant la faible latence exigée par la grande majorité des organisations. Mesurez la latence de votre API avec l’outil rtapi de NGINX et découvrez comment NGINX peut l’aider à offrir une réactivité en temps réel.

Un testeur d’expressions régulières pour NGINX et NGINX Plus
Le testeur d’expressions régulières (regex) pour NGINX et NGINX Plus vous évite de tâtonner en vous indiquant si une expression régulière utilisée dans un bloc location ou map correspond aux valeurs comme prévu. Il génère la configuration appropriée et affiche les valeurs des groupes de capture.
Caches partagés avec les clusters de cache NGINX Plus, partie 1
Optimisez la capacité de votre cache web en le répartissant entre plusieurs serveurs de cache web NGINX ou NGINX Plus. Découvrez comment procéder dans cet article.
Introduction aux microservices
Les microservices suscitent actuellement beaucoup d’intérêt. Cet article de blog est le premier d’une série de sept consacrée à la conception, au développement et au déploiement de microservices.