Voici le premier article de notre série consacrée au déploiement de NGINX Open Source et de NGINX Plus en tant que passerelle API :
- Cet article fournit des instructions de configuration détaillées pour plusieurs cas d’utilisation. Publié initialement en 2018, il a été mis à jour afin de refléter les bonnes pratiques actuelles en matière de configuration des API, en utilisant des blocs
locationimbriqués pour acheminer les requêtes plutôt que des règles de réécriture. - La deuxième partie approfondit ces cas d’utilisation et examine différentes mesures de protection pouvant être mises en œuvre pour protéger et sécuriser les services d’API backend en production.
- Partie 3 explique comment déployer NGINX Open Source et NGINX Plus en tant que passerelle API pour les services gRPC.
Remarque: sauf indication contraire, toutes les informations contenues dans cet article s’appliquent à la fois à NGINX Open Source et à NGINX Plus. Pour faciliter la lecture, « NGINX » sera utilisé dans la suite de cet article.
L’API HTTP est au cœur des architectures d’applications modernes. HTTP permet de développer rapidement des applications et d’en faciliter la maintenance. L’API HTTP fournit une interface commune, quelle que soit l’échelle de l’application, du microservice à usage unique au monolithe tout-en-un. Grâce à HTTP, les avancées en matière de mise à disposition d’applications web qui prennent en charge les sites Internet à très grande échelle peuvent également être mises à profit pour assurer une mise à disposition fiable et performante des API.
Pour une excellente introduction à l’importance des passerelles API pour les applications basées sur des microservices, consultez l’article « Créer des microservices : utiliser une passerelle API » sur notre blog.
En tant que proxy inverse et équilibreur de charge léger et hautement performant de référence, NGINX dispose des fonctionnalités avancées de traitement HTTP nécessaires à la gestion du trafic des API. NGINX constitue ainsi la plateforme idéale pour créer une passerelle d’API. Dans cet article de blog, nous présentons plusieurs cas d’usage courants des passerelles d’API et expliquons comment configurer NGINX pour les prendre en charge de manière efficace, évolutive et facile à maintenir. Nous décrivons une configuration complète pouvant servir de base à un déploiement en production.
Présentation de l’API Warehouse
La fonction principale de la passerelle API est de fournir un point d’entrée unique et cohérent pour plusieurs API, quelle que soit la manière dont elles sont implémentées ou déployées côté back-end. Toutes les API ne sont pas des applications basées sur des microservices. Notre passerelle API doit prendre en charge les API existantes, les monolithes et les applications en cours de transition partielle vers des microservices.
Dans cet article de blog, nous faisons référence à une API hypothétique de gestion des stocks, l’« API Warehouse ». Nous utilisons des exemples de code de configuration pour illustrer différents cas d’utilisation. L’API Warehouse est une API RESTful qui reçoit des requêtes JSON et renvoie des réponses JSON. L’utilisation de JSON ne constitue toutefois ni une limitation ni une exigence de NGINX lorsqu’il est déployé en tant que passerelle API ; NGINX est indépendant du style architectural et des formats de données utilisés par les API elles-mêmes.
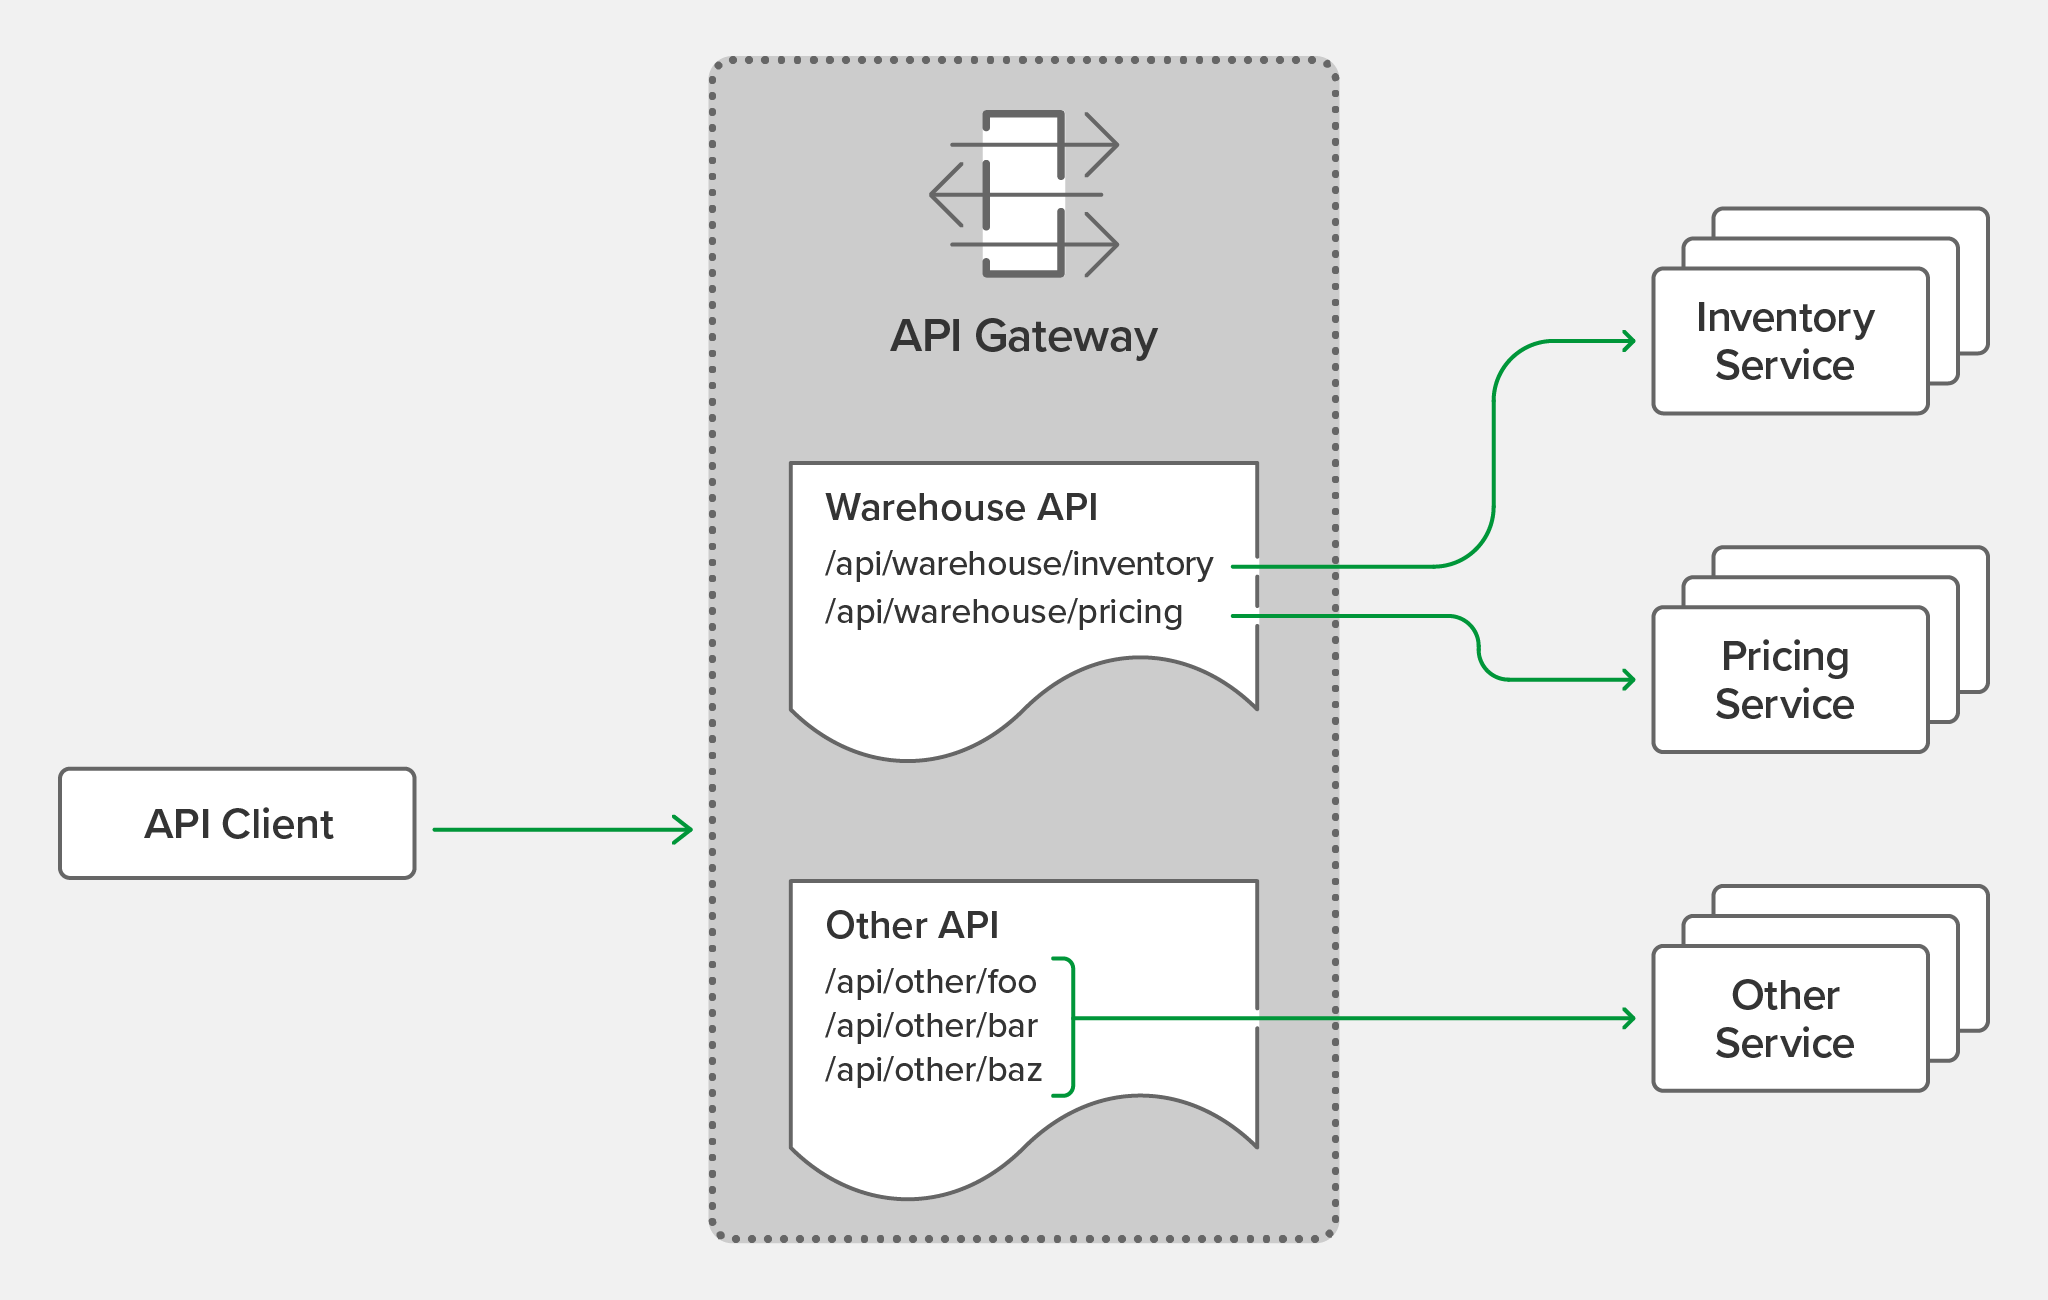
L’API Warehouse est mise en œuvre sous la forme d’un ensemble de microservices distincts et publiée en tant qu’API unique. Les ressources de gestion des stocks et de tarification sont mises en œuvre sous forme de services distincts et déployées sur différents backends. La structure des chemins de l’API est donc la suivante :
api
└── warehouse
    ├── inventory
    └── pricing
Par exemple, pour consulter l’état actuel des stocks de l’entrepôt, une application cliente envoie une requête HTTP GET à l’adresse /api/warehouse/inventory.
Organisation de la configuration NGINX
L’un des avantages de l’utilisation de NGINX comme passerelle d’API est qu’il peut remplir ce rôle tout en faisant simultanément office de proxy inverse, d’équilibreur de charge et de serveur web pour le trafic HTTP existant. Si NGINX fait déjà partie de votre infrastructure de mise à disposition des applications, il est généralement inutile de déployer une passerelle d’API distincte. Toutefois, certains comportements par défaut attendus d’une passerelle d’API diffèrent de ceux attendus pour le trafic provenant des navigateurs. C’est pourquoi nous séparons la configuration de la passerelle d’API de toute configuration existante (ou future) destinée au trafic provenant des navigateurs.
Pour assurer cette séparation, nous créons une organisation de configuration adaptée à une instance NGINX polyvalente et offrant une structure pratique pour automatiser le déploiement de la configuration au moyen de pipelines CI/CD. L’arborescence de répertoires obtenue sous « /etc/nginx » se présente comme suit.
etc/
└── nginx/
    ├── api_conf.d/ ………………………………… Subdirectory for per-API configuration
    │   └── warehouse_api.conf …… Definition and policy of the Warehouse API
    ├── api_backends.conf ………………… The backend services (upstreams)
    ├── api_gateway.conf …………………… Top-level configuration for the API gateway server
    ├── api_json_errors.conf ………… HTTP error responses in JSON format
    ├── conf.d/
    │   ├── ...
    │   └── existing_apps.conf
    └── nginx.conf
Les noms des répertoires et des fichiers de toute la configuration de la passerelle d’API sont précédés du préfixe « api_ ». Chacun de ces fichiers et répertoires active une fonctionnalité ou une capacité différente de la passerelle d’API, comme expliqué en détail ci-dessous. Le fichier warehouse_api.conf sert de substitut générique aux fichiers de configuration présentés ci-dessous, qui définissent l’API Warehouse de différentes manières.
Définition de la passerelle API de niveau supérieur
Toute configuration NGINX commence par le fichier de configuration principal, nginx.conf. Pour charger la configuration de la passerelle API, nous ajoutons une directive include dans le bloc http du fichier nginx.conf, qui fait référence au fichier contenant la configuration de la passerelle, api_gateway.conf (ligne 28 ci-dessous). Notez que le fichier nginx.conf par défaut utilise une directive include pour charger la configuration HTTP destinée aux navigateurs depuis le sous-répertoire conf.d (ligne 29). Cet article de blog fait largement appel à la directive include afin d'améliorer la lisibilité et de permettre l'automatisation de certaines parties de la configuration.
Chargement de l’exemple de code…
Le fichier « api_gateway.conf » définit le serveur virtuel qui présente NGINX aux clients en tant que passerelle d’API. Cette configuration rend toutes les API publiées par la passerelle d’API accessibles depuis un point d’entrée unique, https://api.example.com/ (ligne 9), protégé par TLS conformément à la configuration des lignes 12 à 17. Notez que cette configuration utilise exclusivement HTTPS : aucun port d’écoute HTTP en clair n’est configuré. Nous partons du principe que les clients d’API connaissent le point d’entrée approprié et établissent par défaut des connexions HTTPS.
Cette configuration est destinée à rester statique : les détails des différentes API et de leurs services backend sont spécifiés dans les fichiers référencés par la directive include à la ligne 20. Les lignes 23 à 26 concernent la gestion des erreurs et sont abordées dans la section Réponse aux erreurs ci-dessous.
Chargement de l’exemple de code…
Backends d’API à service unique ou à microservices
Certaines API peuvent être mises en œuvre sur un seul backend, même si nous nous attendons généralement à ce qu’il y en ait plusieurs, pour des raisons de résilience ou d’équilibrage de charge. Avec les API basées sur des microservices, nous définissons des backends distincts pour chaque service ; ensemble, ils constituent l’API complète. Ici, notre API Warehouse est déployée sous la forme de deux services distincts, chacun disposant de plusieurs backends.
Chargement de l’exemple de code…
Tous les services d’API backend, pour toutes les API publiées par la passerelle d’API, sont définis dans api_backends.conf. Ici, nous utilisons plusieurs paires adresse IP-port dans chaque bloc upstream pour indiquer où le code de l’API est déployé, mais il est également possible d’utiliser des noms d’hôte. Les abonnés à NGINX Plus peuvent aussi tirer parti de la répartition de charge DNS dynamique afin que les nouveaux backends soient automatiquement ajoutés à la configuration d’exécution.
Définition de l’API Warehouse
L’API Warehouse est définie par plusieurs blocs location dans une configuration imbriquée, comme l’illustre l’exemple suivant. Le bloc location externe (/api/warehouse) définit le chemin de base, sous lequel les emplacements imbriqués indiquent les URI valides qui sont acheminés vers les services d’API backend. L’utilisation d’un bloc externe permet de définir des politiques communes qui s’appliquent à l’ensemble de l’API (dans cet exemple, la configuration de la journalisation à la ligne 6).
Chargement de l’exemple de code…
NGINX dispose d’un système extrêmement efficace et flexible pour faire correspondre l’URI de la requête à une section de la configuration. L’ordre des directives location n’a pas d’importance : la correspondance la plus spécifique est retenue. Ici, les emplacements imbriqués aux lignes 10 et 14 définissent deux URI plus spécifiques que le bloc location externe ; la directive proxy_pass de chaque bloc imbriqué achemine les requêtes vers le groupe de serveurs en amont approprié. La configuration de la stratégie est héritée de l’emplacement externe, sauf s’il est nécessaire de définir une stratégie plus spécifique pour certaines URI.
Toutes les URI qui ne correspondent à aucun des blocs location imbriqués sont traitées par le bloc location externe, qui comprend une directive générique (ligne 18) renvoyant la réponse « 404 (Non trouvé) » pour toutes les URI non valides.
Choisir entre une définition large et une définition précise pour les API
Il existe deux approches pour définir une API : une définition large ou une définition précise. L’approche la plus adaptée à chaque API dépend de ses exigences de sécurité et de l’opportunité de laisser les services backend gérer les URI non valides.
Dans le fichier warehouse_api_simple.conf ci-dessus, nous adoptons l’approche générale pour l’API Warehouse, en définissant aux lignes 10 et 14 des préfixes d’URI de sorte que toute URI commençant par l’un de ces préfixes soit transmise au service backend approprié. Avec cette mise en correspondance générale des emplacements basée sur les préfixes, les requêtes d’API vers les URI suivantes sont toutes valides :
/api/warehouse/inventory
/api/warehouse/inventory/
/api/warehouse/inventory/foo
/api/warehouse/inventoryfoo
/api/warehouse/inventoryfoo/bar/
Si la seule considération est de transmettre chaque requête au service backend approprié, l’approche générale offre le traitement le plus rapide et la configuration la plus compacte. En revanche, une approche plus précise permet à la passerelle d’API de comprendre l’intégralité de l’espace URI de l’API en définissant explicitement le chemin URI de chaque ressource d’API disponible. En adoptant cette approche précise, la configuration suivante du routage des URI dans l’API Warehouse utilise une combinaison de correspondances exactes (=) et d’expressions régulières (~) pour définir chacune des URI valides.
Chargement de l’exemple de code…
Cette configuration est plus détaillée, mais décrit plus précisément les ressources mises en œuvre par les services backend. Elle présente l’avantage de protéger ces services contre les requêtes clientes mal formées, au prix d’un léger surcoût lié à la mise en correspondance des expressions régulières. Avec cette configuration, NGINX accepte certains URI et en rejette d’autres comme non valides :
URI valides URI non valides/api/warehouse/inventory /api/warehouse/inventory//api/warehouse/inventory/shelf/foo /api/warehouse/inventoryfoo/api/warehouse/inventory/shelf/foo/box/bar /api/warehouse/inventory/shelf/api/warehouse/inventory/shelf/-/box/- /api/warehouse/inventory/shelf/foo/bar/api/warehouse/pricing/baz /api/warehouse/pricing /api/warehouse/pricing/baz/pub
L’utilisation d’une définition précise de l’API permet aux formats de documentation d’API existants de piloter la configuration de la passerelle API. Il est possible d’automatiser les définitions d’API NGINX à partir de l’OpenAPI Specification (anciennement appelée Swagger). Un exemple de script prévu à cet effet est disponible parmi les Gists associés à cet article de blog.
Réécriture des requêtes clientes pour gérer les changements incompatibles
À mesure que les API évoluent, il est parfois nécessaire d’apporter des modifications qui rompent la rétrocompatibilité stricte et imposent une mise à jour des clients. C’est notamment le cas lorsqu’une ressource d’API est renommée ou déplacée. Contrairement à un navigateur web, une passerelle d’API ne peut pas envoyer à ses clients une redirection (code 301 (Déplacé définitivement)) indiquant le nouvel emplacement. Heureusement, lorsqu’il n’est pas envisageable de modifier les clients d’API, nous pouvons réécrire leurs requêtes à la volée.
Dans l’exemple suivant, nous adoptons la même approche générale que dans warehouse_api_simple.conf ci-dessus, mais ici, la configuration remplace une version antérieure de l’API Warehouse, dans laquelle le service de tarification faisait partie du service d’inventaire. La directive rewrite à la ligne 3 convertit les requêtes adressées à l’ancienne ressource de tarification en requêtes adressées au nouveau service de tarification.
Chargement de l’exemple de code…
Répondre aux erreurs
L’une des principales différences entre les API HTTP et le trafic provenant des navigateurs réside dans la manière dont les erreurs sont communiquées au client. Lorsque NGINX est déployé en tant que passerelle API, nous le configurons pour qu’il renvoie les erreurs de la manière la mieux adaptée aux clients de l’API.
La configuration de niveau supérieur de la passerelle API comprend une section qui définit la manière de gérer les réponses d’erreur.
Chargement de l’exemple de code…
La directive « error_page » à la ligne 23 indique que lorsqu’une requête ne correspond à aucune des définitions d’API, NGINX renvoie l’erreur 400 (Bad Request) au lieu de l’erreur 404 (Not Found) par défaut. Ce comportement (facultatif) impose aux clients d’API d’envoyer des requêtes uniquement aux URI valides figurant dans la documentation de l’API et empêche les clients non autorisés de découvrir la structure des URI des API publiées via la passerelle d’API.
La ligne 24 fait référence aux erreurs générées par les services backend eux-mêmes. Les exceptions non gérées peuvent contenir des traces de pile ou d’autres données sensibles que nous ne souhaitons pas transmettre au client. Cette configuration ajoute un niveau de protection supplémentaire en envoyant au client une réponse d’erreur standardisée.
La liste complète des réponses d’erreur standardisées est définie dans un fichier de configuration distinct référencé par la directive include à la ligne 25, dont les premières lignes sont présentées ci-dessous. Ce fichier peut être modifié si vous préférez un format d’erreur autre que JSON, en adaptant la valeur default_type à la ligne 26 du fichier api_gateway.conf. Vous pouvez également ajouter une directive include distincte dans la section de stratégie de chaque API afin de référencer un autre fichier de réponses d’erreur qui remplacent les réponses globales.
Chargement de l’exemple de code…
Avec cette configuration, une requête client portant sur un URI non valide reçoit la réponse suivante. [terminal]$ curl -i https://api.example.com/foo HTTP/1.1 400 Requête incorrecte Server: nginx/1.19.5 Content-Type: application/json Content-Length: 39 Connection: keep-alive {"status":400,"message":"Requête incorrecte"}[/terminal]Mise en œuvre de l’authentification
Il est rare de publier des API sans mettre en place une forme d’authentification pour les protéger. NGINX propose plusieurs approches pour protéger les API et authentifier leurs clients. Pour en savoir plus sur les approches qui s’appliquent également aux requêtes HTTP classiques, consultez la documentation relative aux listes de contrôle d’accès basées sur les adresses IP (ACL), à l’authentification par certificat numérique et à l’authentification HTTP Basic. Nous nous concentrons ici sur les méthodes d’authentification propres aux API.
Authentification par clé d’API
Les clés d’API constituent un secret partagé connu du client et de la passerelle API. Une clé d’API est essentiellement un mot de passe long et complexe fourni au client de l’API en tant qu’identifiant à long terme. La création de clés d’API est simple : il suffit d’encoder un nombre aléatoire, comme dans cet exemple.
$ openssl rand -base64 187B5zIqmRGXmrJTFmKa99vcitÀ la ligne 2 du fichier de configuration principal de la passerelle API, « api_gateway.conf », nous incluons un fichier nommé « api_keys.conf », qui contient une clé API pour chaque client API, identifié par son nom ou une autre description. Voici le contenu de ce fichier :
Chargement de l’exemple de code…
Les clés d’API sont définies dans un bloc map. La directive map accepte deux paramètres. Le premier indique où trouver la clé d’API, ici dans l’en-tête HTTP apikey de la requête du client, dont la valeur est stockée dans la variable $http_apikey. Le second paramètre crée une nouvelle variable ($api_client_name) et lui attribue la valeur du second paramètre de la ligne sur laquelle le premier paramètre correspond à la clé.
Par exemple, lorsqu’un client présente la clé d’API « 7B5zIqmRGXmrJTFmKa99vcit », la variable $api_client_name est définie sur client_one. Cette variable peut être utilisée pour vérifier que les clients sont authentifiés et être incluse dans les entrées de journal afin de permettre un audit plus détaillé. Le format du bloc map est simple et facile à intégrer aux workflows d’automatisation qui génèrent le fichier api_keys.conf à partir d’un magasin d’identifiants existant.
Ici, nous activons l’authentification par clé d’API en modifiant la configuration « broad » (warehouse_api_simple.conf) afin d’inclure une directive auth_request dans la section relative aux stratégies, qui délègue la décision d’authentification à un emplacement spécifié.
Chargement de l’exemple de code…
Avec la directive « auth_request » (ligne 7), nous pouvons, par exemple, confier l’authentification à un serveur d’authentification externe, tel qu’un service d’introspection de jetons OAuth 2.0. Dans cet exemple, nous ajoutons plutôt la logique de validation des clés d’API au fichier de configuration principal de la passerelle API, sous la forme du bloc location suivant, appelé /_validate_apikey.
Chargement de l’exemple de code…
La directive internal à la ligne 30 signifie que cet emplacement n’est pas directement accessible par les clients externes (uniquement par auth_request). Les clients doivent fournir leur clé d’API dans l’en-tête HTTP apikey. Si cet en-tête est absent ou vide (ligne 32), nous envoyons une réponse 401 (Non autorisé) pour indiquer au client qu’une authentification est requise. La ligne 35 traite le cas où la clé d’API ne correspond à aucune des clés du bloc map ; dans ce cas, le paramètre default à la ligne 2 de api_keys.conf définit $api_client_name comme une chaîne vide, et nous envoyons une réponse 403 (Interdit) pour indiquer au client que l’authentification a échoué. Si aucune de ces conditions n’est remplie, la clé d’API est valide et l’emplacement renvoie une réponse 204 (Aucun contenu).
Grâce à cette configuration, l’API Warehouse prend désormais en charge l’authentification par clé API.
$ curl https://api.example.com/api/warehouse/pricing/item001{"status":401,"message":"Unauthorized"}
$ curl -H "apikey: thisIsInvalid" https://api.example.com/api/warehouse/pricing/item001
{"status":403,"message":"Forbidden"}
$ curl -H "apikey: 7B5zIqmRGXmrJTFmKa99vcit" https://api.example.com/api/warehouse/pricing/item001
{"sku":"item001","price":179.99}
Authentification JWT
Les jetons Web JSON (JWT) sont de plus en plus utilisés pour l’authentification des API. La prise en charge native des JWT est réservée à NGINX Plus et permet de valider les JWT comme décrit dans l’article Authentification des clients d’API avec JWT et NGINX Plus de notre blog. Pour un exemple d’implémentation, consultez Contrôle de l’accès à des méthodes spécifiques dans la partie 2.
Résumé
Ce premier article d’une série présente en détail une solution complète pour déployer NGINX Open Source et NGINX Plus en tant que passerelle d’API. L’ensemble des fichiers abordés dans cet article peut être consulté et téléchargé depuis notre dépôt GitHub Gist.
Découvrez les autres articles de cette série :
- La deuxième partie explore des cas d’usage plus avancés permettant de protéger les services backend contre les clients malveillants ou au comportement inapproprié.
- Partie 3 explique comment déployer NGINX en tant que passerelle API pour les services gRPC.
Pour essayer NGINX Plus, commencez votre essai gratuit de 30 jours dès aujourd’hui ou contactez-nous pour discuter de vos cas d’utilisation.
À propos de l’auteur

Articles de blog associés

Tendances actuelles des technologies cloud natives, de l’ingénierie de plateforme et de l’IA
Découvrez les principaux enseignements tirés des réponses à l’enquête annuelle F5 NGINX sur les dernières tendances en matière de technologies cloud natives, de sécurité, d’ingénierie de plateforme et d’IA.

Quels contrôleurs Ingress NGINX sont affectés par les vulnérabilités CVE-2022-4886, CVE-2023-5043 et CVE-2023-5044 ?
Lorsque de nouvelles CVE sont signalées, il est facile de ne plus savoir si elles concernent un outil de contrôleur Ingress NGINX particulier, car il existe plusieurs projets. Cet article présente les CVE et explique comment distinguer les différents projets de contrôleurs Ingress afin de dissiper toute confusion.
Votre API est-elle en temps réel ? Testez sa latence avec l’outil rtapi de NGINX
Votre API répond-elle aux requêtes en moins de 30 ms ? Si ce n’est pas le cas, il ne s’agit pas d’une API en temps réel offrant la faible latence exigée par la grande majorité des organisations. Mesurez la latence de votre API avec l’outil rtapi de NGINX et découvrez comment NGINX peut l’aider à offrir une réactivité en temps réel.

Un testeur d’expressions régulières pour NGINX et NGINX Plus
Le testeur d’expressions régulières (regex) pour NGINX et NGINX Plus vous évite de tâtonner en vous indiquant si une expression régulière utilisée dans un bloc location ou map correspond aux valeurs comme prévu. Il génère la configuration appropriée et affiche les valeurs des groupes de capture.
Caches partagés avec les clusters de cache NGINX Plus, partie 1
Optimisez la capacité de votre cache web en le répartissant entre plusieurs serveurs de cache web NGINX ou NGINX Plus. Découvrez comment procéder dans cet article.
Introduction aux microservices
Les microservices suscitent actuellement beaucoup d’intérêt. Cet article de blog est le premier d’une série de sept consacrée à la conception, au développement et au déploiement de microservices.