Nous avons publié la version 3.0 de NGINX Ingress Controller en janvier 2023, avec de nombreuses nouvelles fonctionnalités majeures et des améliorations fonctionnelles. Parmi les nouveautés, Deep Service Insight, disponible dans l’édition NGINX Plus de NGINX Ingress Controller, devrait vous être particulièrement utile.
Deep Service Insight remédie à une limitation qui nuit au fonctionnement optimal lorsqu’un système de décision de routage, tel qu’un équilibreur de charge, est placé devant un ou plusieurs clusters Kubernetes : ce système n’a en effet pas accès aux informations sur l’état de santé des différents services exécutés dans les clusters derrière le contrôleur Ingress. Il ne peut donc pas acheminer le trafic uniquement vers les clusters dont les services sont opérationnels, ce qui risque d’exposer vos utilisateurs à des interruptions de service et à des erreurs telles que 404 et 500.
Deep Service Insight résout ce problème en exposant l’état de santé des pods des services backend (tel que collecté par NGINX Ingress Controller) sur un point de terminaison dédié, où vos systèmes peuvent y accéder et l’utiliser pour prendre de meilleures décisions de routage.
Dans cet article, nous examinons en détail le problème résolu par Deep Service Insight, expliquons son fonctionnement dans plusieurs cas d’usage courants et montrons comment le configurer.
Pourquoi Deep Service Insight ?
Les sondes Kubernetes standard de vivacité, de disponibilité et de démarrage vous fournissent certaines informations sur les services backend exécutés dans vos clusters, mais pas suffisamment pour obtenir le niveau de visibilité nécessaire afin de prendre de meilleures décisions de routage à tous les niveaux de votre pile. Le manque d’informations pertinentes devient encore plus problématique à mesure que vos déploiements Kubernetes gagnent en complexité et que vos exigences métier en matière de disponibilité continue deviennent plus pressantes.
Une approche courante pour améliorer la disponibilité à mesure que votre environnement Kubernetes évolue consiste à déployer des répartiteurs de charge, des gestionnaires DNS et d’autres systèmes de décision automatisés en amont de vos clusters. Toutefois, en raison du fonctionnement des contrôleurs Ingress, un répartiteur de charge placé devant un cluster Kubernetes n’a normalement pas accès aux informations d’état des services situés derrière le contrôleur Ingress dans le cluster : il peut uniquement vérifier que les pods du contrôleur Ingress sont eux-mêmes opérationnels et acceptent le trafic.
En revanche, NGINX Ingress Controller dispose bien d’informations sur l’état des services. Il surveille déjà l’état des pods en amont d’un cluster en effectuant régulièrement des contrôles d’intégrité passifs pour les services HTTP, TCP, UDP et gRPC, en surveillant la réactivité des requêtes et en suivant les codes de réponse indiquant une réussite ainsi que d’autres métriques. Il utilise ces informations pour déterminer comment répartir le trafic entre les pods de vos services afin d’offrir une expérience utilisateur cohérente et prévisible. En temps normal, NGINX Ingress Controller opère toute cette magie discrètement en arrière-plan, et vous ne vous demandez peut-être jamais ce qui se passe en coulisses. Deep Service Insight « fait remonter » ces précieuses informations afin que vous puissiez les exploiter plus efficacement à d’autres niveaux de votre pile.
Comment fonctionne Deep Service Insight ?
Deep Service Insight est disponible pour les services que vous déployez à l’aide des ressources personnalisées NGINX « VirtualServer » et « TransportServer » (respectivement pour HTTP et TCP/UDP). Deep Service Insight utilise l’API NGINX Plus pour partager la vue de NGINX Ingress Controller sur les pods individuels d’un service backend via un point de terminaison dédié propre à Deep Service Insight :
- Pour VirtualServer – <IP_address> :<port> /probe/<hostname>
- Pour TransportServer – <IP_address> :<port> /probe/ts/<service_name>
où
- <IP_address> appartient au contrôleur Ingress NGINX
- <port> est le numéro de port de Deep Service Insight (9114 par défaut)
- <hostname> est le nom de domaine du service tel que défini dans le champ
spec.hostde la ressource VirtualServer - <service_name> est le nom du service tel que défini dans le champ
spec.upstreams.servicede la ressource TransportServer
La sortie comprend deux types d’informations :
- Un code d’état HTTP pour le nom d’hôte ou le nom du service :
200OK– Au moins un pod est sain418Je suisunethéière– Aucun pod n’est sain404IntrouvableFound– Aucun pod ne correspond au nom d’hôte ou au nom de service spécifié
- Trois compteurs pour le nom d’hôte ou le nom de service spécifié :
Nombre totald’instances de service (pods)- Nombre de pods dans l’état «
Up» (sain) - Nombre de pods dans l’état «
Non sain»
Voici un exemple dans lequel les trois pods d’un service sont sains :
HTTP/1.1 200 OKContent-Type: application/json; charset=utf-8
Date: Day, DD Mon YYYY hh:mm:ss TZ
Content-Length: 32
{"Total":3,"Up":3,"Unhealthy":0}
Pour plus de détails, consultez la documentation de NGINX Ingress Controller.
Vous pouvez personnaliser davantage les critères utilisés par NGINX Ingress Controller pour déterminer si un pod est sain en configurant des contrôles d’intégrité actifs. Vous pouvez configurer le chemin et le port auxquels le contrôle d’intégrité est envoyé, le nombre d’échecs devant survenir au cours d’une période donnée pour qu’un pod soit considéré comme défaillant, le code d’état attendu, les délais d’expiration pour la connexion ou la réception d’une réponse, et bien plus encore. Ajoutez le champ Upstream.Healthcheck à la ressource VirtualServer ou TransportServer.
Exemples de cas d’utilisation de Deep Service Insight
Deep Service Insight s’avère particulièrement utile, par exemple, lorsqu’un équilibreur de charge achemine le trafic vers un service exécuté dans deux clusters, notamment pour assurer une haute disponibilité. Dans chaque cluster, NGINX Ingress Controller surveille l’état de santé des pods en amont comme décrit précédemment. Lorsque vous activez Deep Service Insight, les informations sur le nombre de pods en amont sains et défaillants sont également publiées sur un point de terminaison dédié. Votre système de décision de routage peut accéder à ce point de terminaison et utiliser ces informations pour détourner le trafic applicatif des pods défaillants au profit des pods sains.
Le schéma illustre le fonctionnement de Deep Service Insight dans ce scénario.
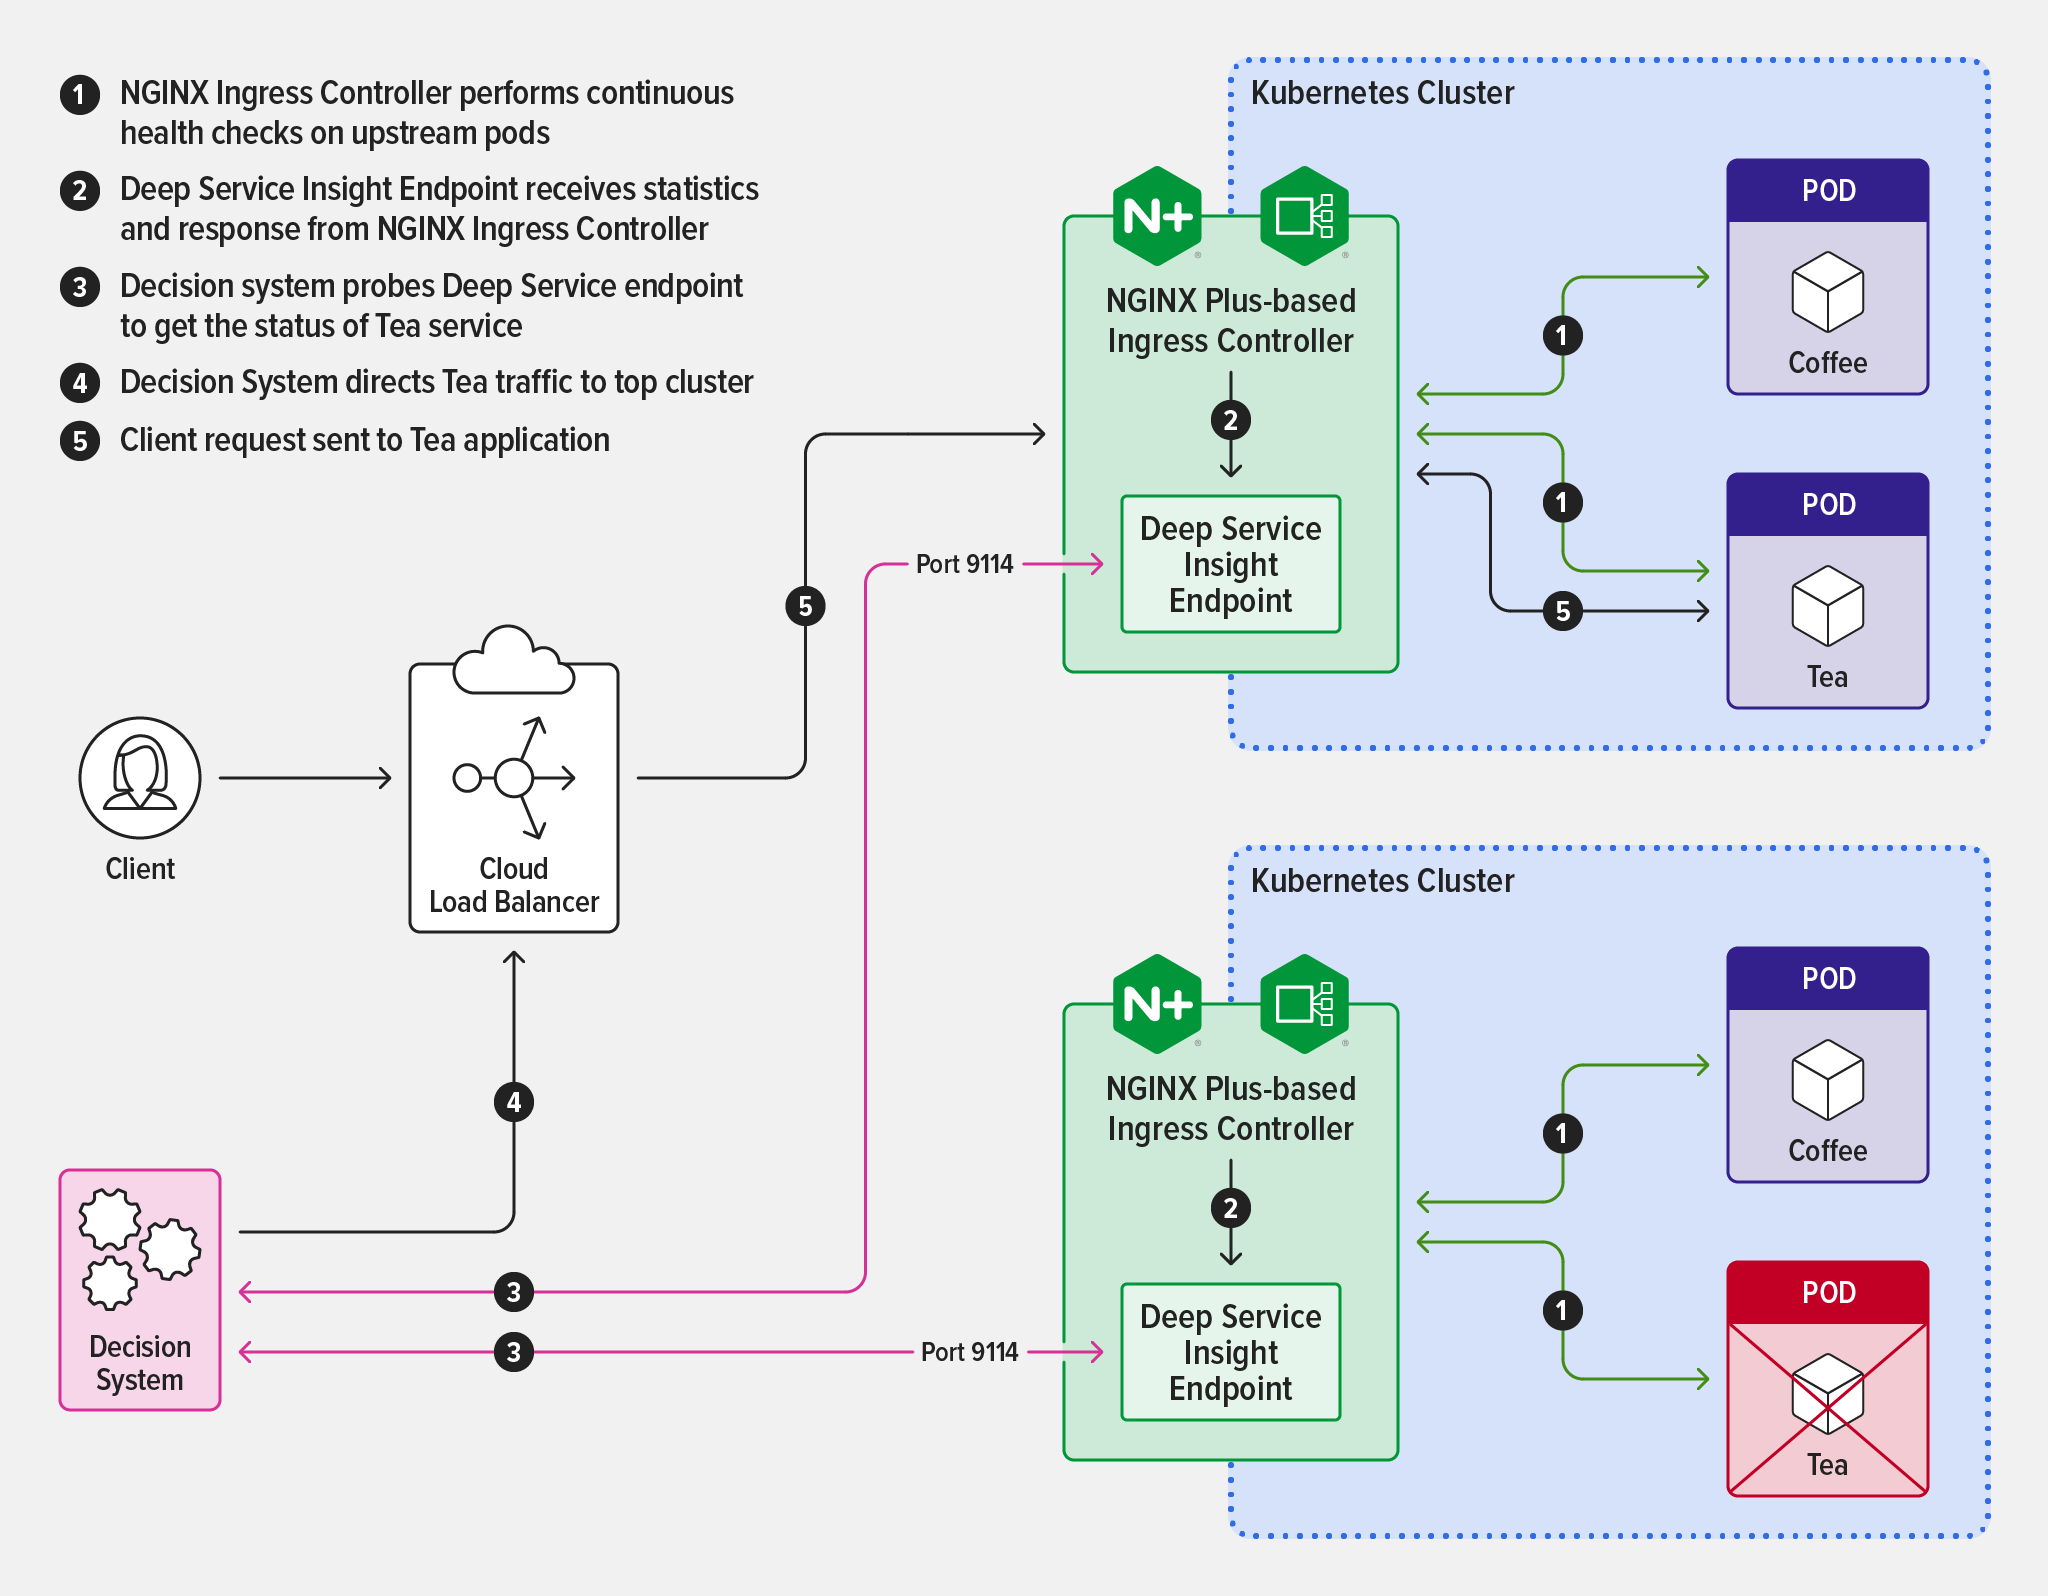
Vous pouvez également tirer parti de Deep Service Insight lors d’une opération de maintenance sur un cluster dans un environnement à haute disponibilité. Il vous suffit de réduire à zéro le nombre de pods d’un service dans le cluster sur lequel vous effectuez la maintenance. L’absence de pods sains est automatiquement signalée sur le point de terminaison Deep Service Insight, et votre système de décision de routage utilise cette information pour diriger le trafic vers les pods sains de l’autre cluster. Vous bénéficiez ainsi d’un basculement automatique sans avoir à modifier la configuration de NGINX Ingress Controller ni celle du système, et vos clients ne subissent aucune interruption de service.
Activation de Deep Service Insight
Pour activer Deep Service Insight, ajoutez l’argument de ligne de commande « -enable-service-insight » au manifeste Kubernetes, ou définissez le paramètre « serviceInsight.create » sur « true » si vous utilisez Helm.
Vous pouvez inclure deux arguments facultatifs pour adapter le point de terminaison à votre environnement :
-service-insight-listen-port<port>– Modifiez le numéro de port de Deep Service Insight, dont la valeur par défaut est 9114 (<port>est un entier compris entre 1024 et 65535). Le paramètre Helm équivalent estserviceInsight.port.-service-insight-tls-string<secret>– Un secret Kubernetes (certificat et clé TLS) pour la terminaison TLS du point de terminaison Deep Service Insight (<secret>est une chaîne de caractères au format<namespace>/<secret_name>). L’équivalent Helm est le paramètreserviceInsight.secret.
Exemple : activer Deep Service Insight pour l’application Cafe
Pour voir Deep Service Insight en action, vous pouvez l’activer pour l’application Cafe souvent utilisée comme exemple dans la documentation de NGINX Ingress Controller.
- Installez l’édition NGINX Plus de NGINX Ingress Controller avec la prise en charge des ressources personnalisées NGINX et en activant Deep Service Insight :
- Si vous utilisez Helm, définissez le paramètre
serviceInsight.createsurtrue. - Si vous utilisez un manifeste Kubernetes (Deployment ou DaemonSet), ajoutez l’argument
-enable-service-insightdans le fichier manifeste.
- Si vous utilisez Helm, définissez le paramètre
- Vérifiez que NGINX Ingress Controller est en cours d’exécution :
$ kubectl get pods -n nginx-ingressNAME                                          READY ...
ingress-plus-nginx-ingress-6db8dc5c6d-cb5hp   1/1   ...

    ...  STATUS   RESTARTS   AGE
... Running 0 9d- Déployez l’application Cafe en suivant les instructions du README.
- Vérifiez que la ressource personnalisée VirtualServer de NGINX est déployée pour l’application Cafe (l’adresse IP est omise pour plus de lisibilité) :
$ kubectl get vs NAME   STATE   HOST               IP    PORTS      AGE
cafe Valid cafe.example.com ... [80,443] 7h1m- Vérifiez que trois pods en amont sont en cours d’exécution pour le service Cafe à l’adresse « cafe.example.com » :
$ kubectl get pods NAME                     READY   STATUS    RESTARTS   AGE
coffee-87cf76b96-5b85h   1/1     Running   0          7h39m
coffee-87cf76b96-lqjrp   1/1     Running   0          7h39m
tea-55bc9d5586-9z26v 1/1 Running 0 111m- Accédez au point de terminaison Deep Service Insight :
$ curl -i <NIC_IP_address>:9114/probe/cafe.example.com- Le code de réponse
200OKindique que le service est prêt à accepter du trafic (au moins un pod est opérationnel). Dans ce cas, les trois pods sont à l’état Up.
HTTP/1.1 200 OK
Content-Type: application/json; charset=utf-8
Date: Day, DD Mon YYYY hh:mm:ss TZ
Content-Length: 32
{"Total":3,"Up":3,"Unhealthy":0}- Le code d’état
418I’mateapotindique que le service est indisponible (tous les pods sont défaillants).
HTTP/1.1 418 I'm a teapotContent-Type: application/json; charset=utf-8
Date: Day, DD Mon YYYY hh:mm:ss TZ
Content-Length: 32
{"Total":3,"Up":0,"Unhealthy":3}- Le code d’état
404NotFoundindique qu’aucun service ne s’exécute sur le nom d’hôte spécifié.
HTTP/1.1 404 Not FoundDate: Day, DD Mon YYYY hh:mm:ss TZ
Content-Length: 0
Ressources
Pour consulter la liste complète des modifications apportées à la version 3.0.0 de NGINX Ingress Controller, reportez-vous aux notes de version.
Pour essayer NGINX Ingress Controller avec NGINX Plus et NGINX App Protect, commencez votre essai gratuit de 30 jours dès aujourd’hui ou contactez-nous pour discuter de vos cas d’utilisation.
À propos de l’auteur

Articles de blog associés

Tendances actuelles des technologies cloud natives, de l’ingénierie de plateforme et de l’IA
Découvrez les principaux enseignements tirés des réponses à l’enquête annuelle F5 NGINX sur les dernières tendances en matière de technologies cloud natives, de sécurité, d’ingénierie de plateforme et d’IA.

Quels contrôleurs Ingress NGINX sont affectés par les vulnérabilités CVE-2022-4886, CVE-2023-5043 et CVE-2023-5044 ?
Lorsque de nouvelles CVE sont signalées, il est facile de ne plus savoir si elles concernent un outil de contrôleur Ingress NGINX particulier, car il existe plusieurs projets. Cet article présente les CVE et explique comment distinguer les différents projets de contrôleurs Ingress afin de dissiper toute confusion.
Votre API est-elle en temps réel ? Testez sa latence avec l’outil rtapi de NGINX
Votre API répond-elle aux requêtes en moins de 30 ms ? Si ce n’est pas le cas, il ne s’agit pas d’une API en temps réel offrant la faible latence exigée par la grande majorité des organisations. Mesurez la latence de votre API avec l’outil rtapi de NGINX et découvrez comment NGINX peut l’aider à offrir une réactivité en temps réel.

Un testeur d’expressions régulières pour NGINX et NGINX Plus
Le testeur d’expressions régulières (regex) pour NGINX et NGINX Plus vous évite de tâtonner en vous indiquant si une expression régulière utilisée dans un bloc location ou map correspond aux valeurs comme prévu. Il génère la configuration appropriée et affiche les valeurs des groupes de capture.
Caches partagés avec les clusters de cache NGINX Plus, partie 1
Optimisez la capacité de votre cache web en le répartissant entre plusieurs serveurs de cache web NGINX ou NGINX Plus. Découvrez comment procéder dans cet article.
Introduction aux microservices
Les microservices suscitent actuellement beaucoup d’intérêt. Cet article de blog est le premier d’une série de sept consacrée à la conception, au développement et au déploiement de microservices.