Les temps d’arrêt peuvent avoir de graves conséquences.
Ces mots sont plus vrais encore pour les entreprises du secteur des technologies médicales que pour celles de la plupart des autres secteurs : dans leur cas, les « conséquences graves » peuvent littéralement inclure la mort. Nous avons récemment eu l’occasion d’analyser en détail l’infrastructure technologique d’une entreprise qui cherche à faire évoluer la tenue des dossiers médicaux, en remplaçant le papier et le stylo par des données numériques sécurisées, accessibles à tout moment et partout dans le monde. Ces données vont des informations sur les patients aux directives de soins, en passant par les marqueurs biologiques, les analyses médicales, les antécédents médicaux et toutes les autres informations partagées entre les équipes soignantes.
Dès le départ, l’entreprise a cherché à répondre à une question en apparence simple : « Comment pouvons-nous aider les professionnels de santé à enregistrer facilement des données en temps réel ? » Cependant, à mesure que l’entreprise s’est développée, la nécessité de faire évoluer son infrastructure et de garantir une disponibilité permanente des données a rendu ce défi de plus en plus complexe. Nous expliquons ici comment le parcours technologique de l’entreprise l’a conduite à adopter Kubernetes et NGINX Ingress Controller.
Aperçu de la stack technologique
- Système d’exploitation – Linux
- Orchestration de conteneurs – Microsoft Azure Kubernetes Service
- Réseau – Kubernetes, contrôleur Ingress NGINX basé sur NGINX Plus
- Langage/framework de développement logiciel – .Net
- Supervision, observabilité et alertes – Prometheus
- Tableau de bord de supervision – Grafana
- Journalisation – Grafana Loki
- Base de données – Service Azure SQL
- Serveur d’applications – Azure App Service, .NET
- Messagerie et diffusion en continu – Azure Event Hubs
- Mise en cache – Redis
- Sécurité – NGINX App Protect
- Emplacement et infrastructure – Deux zones de disponibilité, 2 clusters Kubernetes, 15 à 20 nœuds, 60 à 100 pods
- DevOps – Azure DevOps Services
Voici comment NGINX s’intègre à leur architecture :
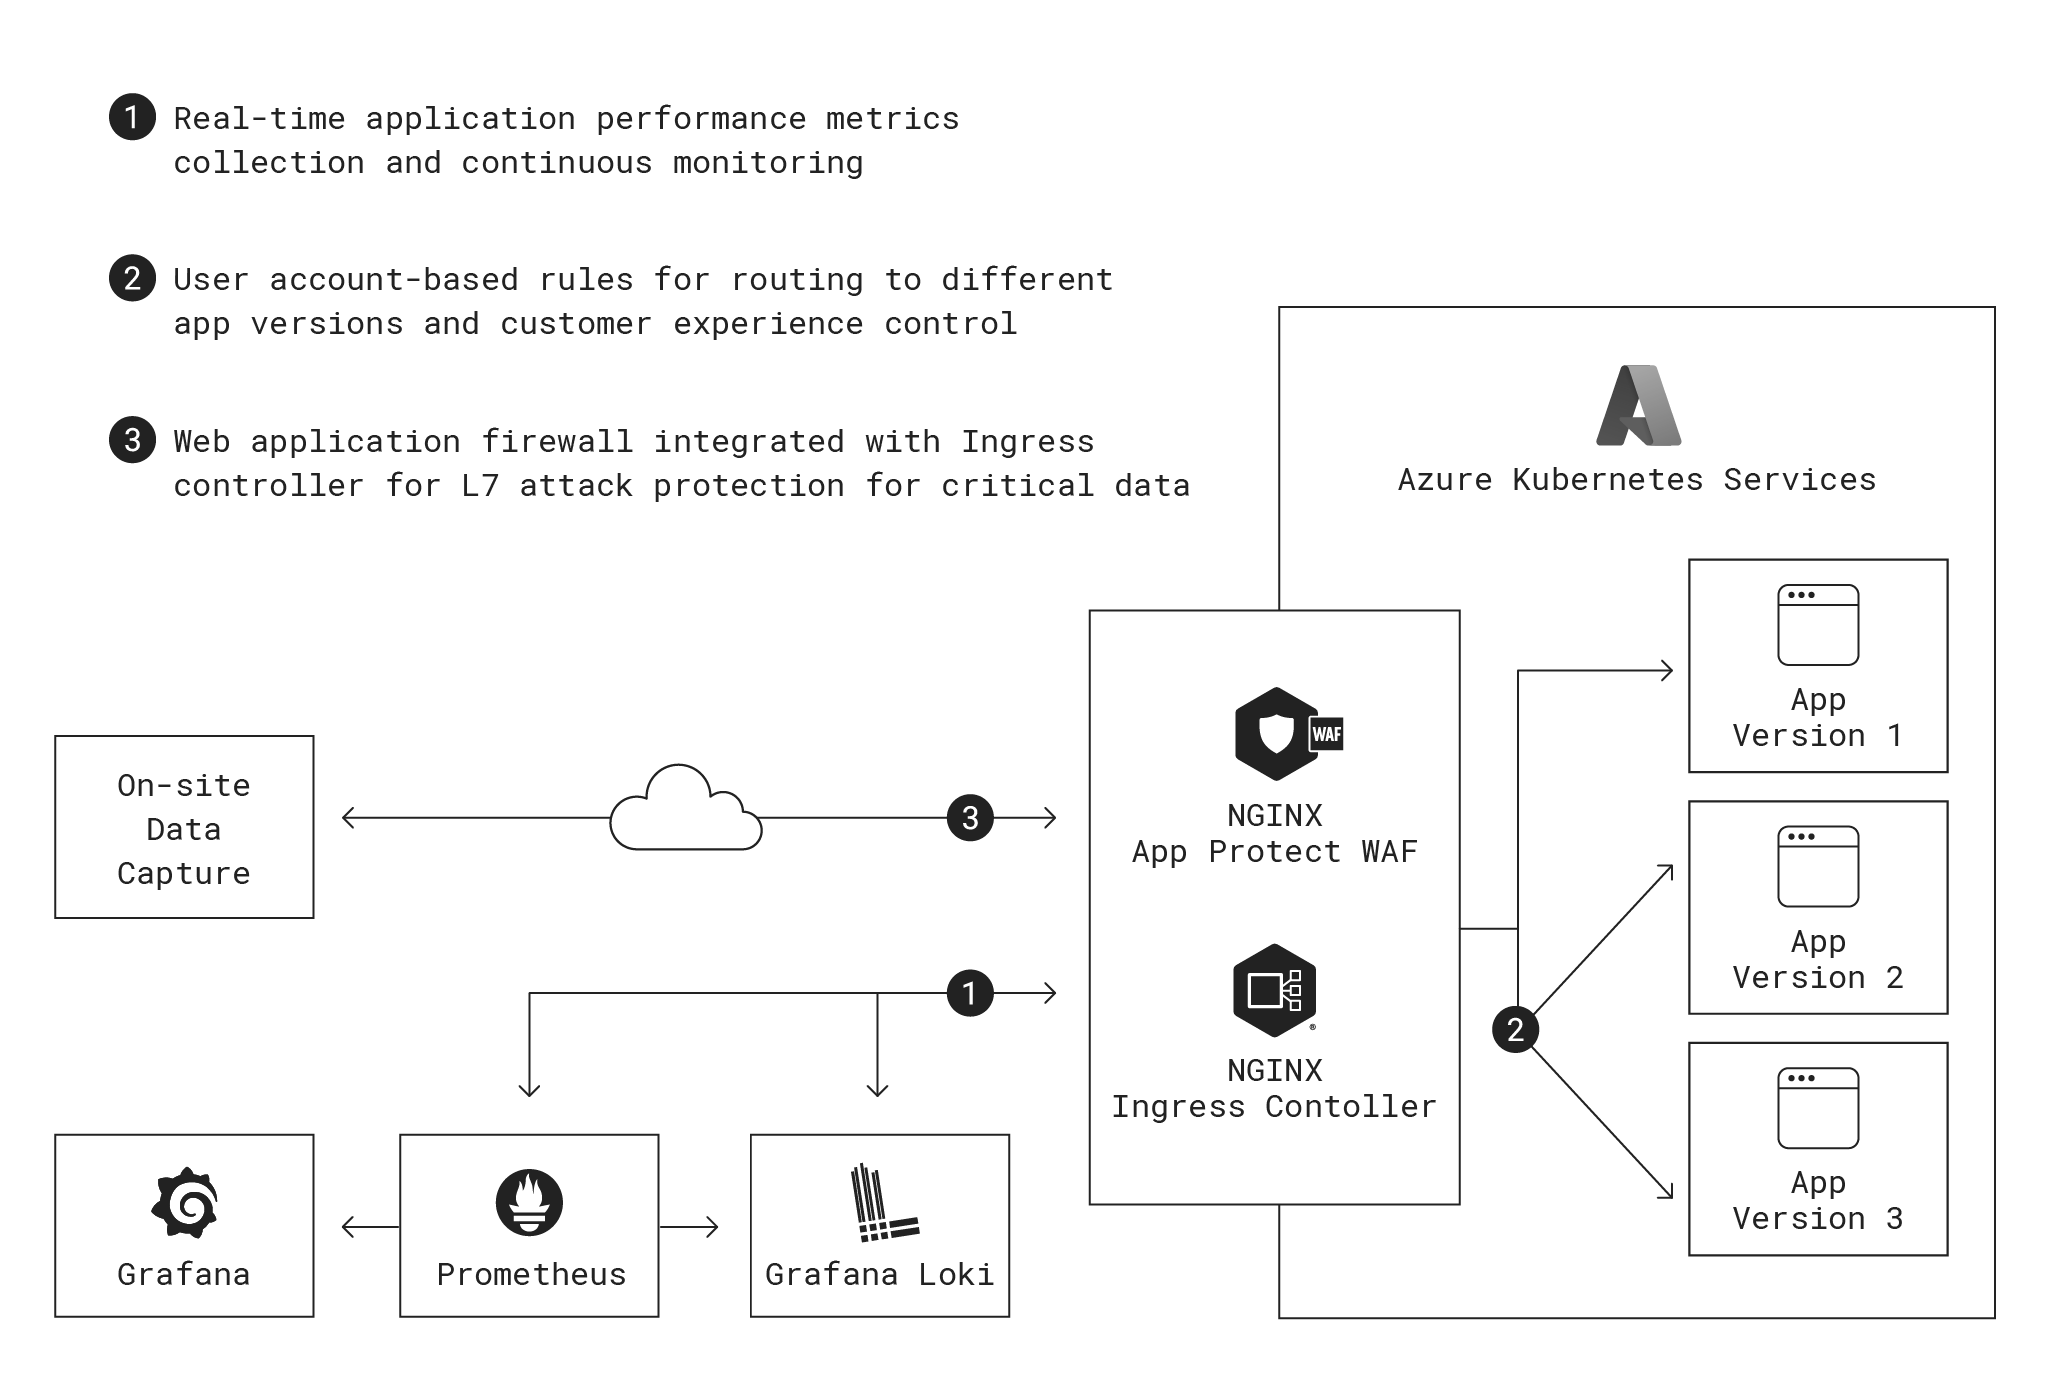
Le problème du papier
La consignation à intervalles réguliers de l’état des patients et des informations relatives aux soins constitue une mission essentielle du personnel de santé. Traditionnellement, ces informations étaient consignées sur papier ou, plus récemment, sur un ordinateur portable ou une tablette. Cette méthode présente deux inconvénients majeurs :
- Les professionnels de santé peuvent être amenés à s’occuper de dizaines de patients par jour. Il n’est donc généralement pas pratique de prendre des notes détaillées tout en prodiguant des soins. Ils finissent alors par rédiger leurs notes à la fin de leur service. À ce stade, la fatigue mentale et physique peut les inciter à ne consigner que des commentaires génériques.
- Les professionnels de santé doivent également se fier à leurs souvenirs des détails concernant le comportement des patients. Des imprécisions pourraient masquer des tendances qui, si elles étaient consignées correctement et régulièrement au fil du temps, faciliteraient le diagnostic de problèmes de santé plus importants.
- Les dossiers papier ne peuvent pas être facilement partagés entre les différents services d’un même établissement, et encore moins avec d’autres intervenants tels que les ambulanciers, le personnel des urgences et les compagnies d’assurance. La situation n’est guère meilleure avec des ordinateurs portables ou des tablettes s’ils ne sont pas connectés à un référentiel de données centralisé ou au cloud.
Pour relever ces défis, l’entreprise a créé un système simplifié de saisie des données qui permet d’accéder rapidement aux informations des patients et d’enregistrer les événements courants, comme l’administration de médicaments. Cette facilité d’accès et d’utilisation permet de consigner les interactions avec les patients en temps réel, au moment où elles ont lieu.
Toutes les données sont stockées dans des systèmes cloud gérés par l’entreprise, et l’application s’intègre à d’autres systèmes de dossiers médicaux électroniques afin de fournir une vue longitudinale complète des comportements des résidents. Cela aide les soignants à assurer une meilleure continuité des soins, permet de constituer un historique sécurisé et facilite le partage des données avec d’autres logiciels de santé.
Les médecins et autres spécialistes utilisent également la plateforme lors de l’admission des patients ou dans le cadre de leurs interactions avec eux. Un dossier répertoriant leurs préférences et leurs besoins personnels les accompagne dans chaque établissement. Ces informations peuvent être utilisées pour aider les patients à se sentir à l’aise dans un nouvel environnement, ce qui améliore notamment leur temps de rétablissement.
La législation impose des exigences strictes quant à la durée pendant laquelle les entreprises doivent conserver les données des patients. Les développeurs de l’entreprise ont conçu le logiciel de manière à garantir une disponibilité extrêmement élevée, avec des SLA de disponibilité bien supérieurs à ceux des applications cloud génériques. Il est hors de question de faire attendre une ambulance parce que le dossier d’un patient ne se charge pas.
Le voyage du garage au cloud, puis à Kubernetes
Comme de nombreuses start-up, l’entreprise a d’abord réalisé des économies en exécutant sa première application de validation de concept sur un serveur installé chez l’un de ses cofondateurs. Une fois le potentiel de l’idée confirmé, elle a transféré son infrastructure vers le cloud plutôt que de gérer du matériel dans un centre de données. Son environnement reposant sur les technologies Microsoft, elle a choisi Azure. L’architecture initiale exécutait les applications sur des machines virtuelles (VM) traditionnelles dans Azure App Service, un service managé de déploiement d’applications qui utilise le serveur web IIS de Microsoft. Pour le stockage et la récupération des données, l’entreprise a choisi d’utiliser SQL Server de Microsoft, exécuté dans une VM en tant qu’application managée.
Après plusieurs années d’exploitation dans le cloud, l’entreprise connaissait une croissance rapide et rencontrait des difficultés de mise à l’échelle. Elle devait pouvoir évoluer sans limites, horizontalement plutôt que verticalement, cette dernière approche étant lente et coûteuse avec des machines virtuelles. Cette exigence a tout naturellement conduit à envisager la conteneurisation et Kubernetes comme solution possible. La nécessité, pour les développeurs de l’entreprise, de déployer fréquemment des mises à jour de l’application et de l’infrastructure sans risquer d’interruption de service constituait un autre argument en faveur de la conteneurisation. Les dossiers des patients étant constamment enrichis dans plusieurs fuseaux horaires, il n’existe aucun temps d’arrêt naturel permettant de déployer des modifications en production sans risquer que les clients soient immédiatement affectés par d’éventuels dysfonctionnements.
Pour l’entreprise, le point de départ logique était l’offre Kubernetes managée de Microsoft, Azure Kubernetes Services (AKS). L’équipe a étudié les bonnes pratiques de Kubernetes et s’est rendu compte qu’elle avait besoin d’un contrôleur Ingress placé devant ses clusters Kubernetes afin de gérer efficacement le trafic et les applications s’exécutant dans les nœuds et les pods sur AKS.
Le routage du trafic doit être à la fois flexible et précis
L’équipe a testé le contrôleur Ingress par défaut d’AKS, mais a constaté que ses fonctionnalités de routage du trafic ne permettaient tout simplement pas de déployer les mises à jour auprès des clients de l’entreprise comme il se devait. En matière de soins aux patients, aucune ambiguïté ni information contradictoire n’est permise : il est par exemple inacceptable que, pour un même événement, un soignant voie un indicateur orange et un autre un indicateur rouge. Tous les utilisateurs d’une même organisation doivent donc utiliser la même version de l’application. Cela représente un défi majeur lors des mises à niveau. Comme il n’existe aucun moment idéal pour faire passer un client à une nouvelle version, l’entreprise avait besoin d’un moyen d’utiliser des règles au niveau des serveurs et du réseau afin d’orienter ses différents clients vers différentes versions de l’application.
Pour y parvenir, l’entreprise utilise la même plateforme backend pour tous les utilisateurs d’une organisation et ne propose pas d’architecture mutualisée avec une segmentation au niveau de l’infrastructure au sein de l’organisation. Avec Kubernetes, il est possible de répartir le trafic à l’aide de routes de réseau virtuel et de cookies dans les navigateurs, ainsi que de règles de trafic détaillées. Toutefois, l’équipe technique de l’entreprise a constaté que le contrôleur Ingress par défaut d’AKS ne permet de répartir le trafic que selon un pourcentage, et non à l’aide de règles s’appliquant au niveau de l’organisation cliente ou de l’utilisateur individuel, comme cela est nécessaire.
Dans sa configuration de base, le contrôleur Ingress NGINX basé sur NGINX Open Source présente la même limitation. L’entreprise a donc décidé d’opter pour le contrôleur Ingress NGINX plus avancé, basé sur NGINX Plus, un produit de niveau entreprise qui permet un contrôle granulaire du trafic. Les recommandations de Microsoft et de la communauté Kubernetes en faveur du contrôleur Ingress NGINX, motivées par son haut niveau de flexibilité et de contrôle, ont conforté ce choix. Cette configuration répond mieux aux besoins de l’entreprise en matière de gestion des pods (par opposition à la gestion classique du trafic), en veillant à ce que les pods s’exécutent dans les zones appropriées et que le trafic soit acheminé vers les services concernés. Le trafic est parfois acheminé en interne, mais dans la plupart des cas d’utilisation, il ressort via le contrôleur Ingress NGINX pour des raisons d’observabilité.
Attention, danger : surveillance, observabilité et performances des applications
Avec NGINX Ingress Controller, l’équipe technique maîtrise entièrement l’expérience des développeurs et des utilisateurs finaux. Dès que les utilisateurs se connectent et établissent une session, ils peuvent être immédiatement redirigés vers une nouvelle version ou revenir à une version antérieure. Les correctifs peuvent être déployés simultanément et presque instantanément auprès de tous les utilisateurs d’une organisation. Le logiciel ne dépend ni de la propagation DNS ni des mises à jour du réseau sur l’ensemble de la plateforme cloud.
NGINX Ingress Controller répond également aux exigences de l’entreprise en matière de surveillance granulaire et continue. Les performances des applications sont extrêmement importantes dans le secteur de la santé. La latence ou les interruptions de service peuvent nuire à la qualité des soins cliniques, en particulier dans les situations où le pronostic vital est engagé. Après la migration vers Kubernetes, des clients ont commencé à signaler des interruptions de service que l’entreprise n’avait pas détectées. Celle-ci a rapidement découvert l’origine du problème : Azure App Service s’appuie sur des données échantillonnées. L’échantillonnage convient pour les moyennes et les tendances générales, mais il ne permet absolument pas de détecter certains événements, tels que les requêtes rejetées et les ressources manquantes. Il ne fait pas non plus apparaître les pics d’utilisation qui surviennent généralement toutes les demi-heures, lorsque le personnel soignant se connecte et saisit les données des patients. L’entreprise ne disposait donc que d’une vision incomplète de la latence, des sources d’erreurs, des requêtes incorrectes et des indisponibilités de service.
Les problèmes ne s’arrêtaient pas là. Par défaut, Azure App Service ne conserve les données stockées que pendant un mois, bien loin des dizaines d’années imposées par la législation de nombreux pays. Étendre le stockage de données afin de les conserver plus longtemps comme requis aurait été d’un coût prohibitif. En outre, la solution Azure n’offre aucune visibilité sur le fonctionnement interne de la pile réseau Kubernetes. NGINX Ingress Controller peut surveiller à la fois les paramètres de l’infrastructure et ceux des applications lorsqu’il traite le trafic des couches 4 et 7.
Pour la surveillance des performances et l’observabilité, l’entreprise a choisi une base de données de séries temporelles Prometheus associée à un moteur de visualisation et à un tableau de bord Grafana. L’intégration avec Prometheus et Grafana est préconfigurée dans les plans de données et de contrôle de NGINX ; l’équipe technique n’a eu qu’à apporter une légère modification à la configuration pour acheminer l’ensemble du trafic via les serveurs Prometheus et Grafana. Les informations ont également été envoyées vers une base de données de journalisation Grafana Loki afin de faciliter l’analyse des journaux et de permettre à l’équipe logicielle de mieux contrôler les données au fil du temps.
Cette configuration permet également d’anticiper les incidents nécessitant un échantillonnage des données extrêmement fréquent et volumineux afin de diagnostiquer les problèmes et de corriger les bugs. La gestion de ce type d’incidents peut s’avérer coûteuse avec les systèmes de surveillance des applications proposés par la plupart des grands fournisseurs de services cloud, mais, dans ce cas d’usage, le coût et la charge opérationnelle associés à Prometheus, Grafana et Loki sont minimes. Ces trois produits open source sont stables et, après leur configuration initiale, ne nécessitent généralement guère plus que l’application de correctifs.
Maintenir le cap : priorité à la haute disponibilité et à la sécurité
L’entreprise a toujours poursuivi un double objectif : garantir la sécurité afin de protéger l’un des types de données les plus sensibles qui soient, et assurer une haute disponibilité pour que l’application soit accessible à tout moment. Lors de la migration vers Kubernetes, elle a apporté quelques changements afin de renforcer ces deux aspects.
Pour garantir une disponibilité maximale, l’équipe technique déploie une architecture d’infrastructure distribuée active-active, multizone et multirégion, assurant une redondance complète sans point de défaillance unique. L’équipe maintient une infrastructure active-active N+2 reposant sur deux clusters Kubernetes situés dans deux régions géographiques distinctes. Dans chaque région, le logiciel est réparti sur plusieurs centres de données afin de réduire le risque d’indisponibilité et d’assurer la continuité en cas de défaillance à n’importe quel niveau de l’infrastructure. Les règles d’affinité et d’anti-affinité permettent de rediriger instantanément les utilisateurs et le trafic vers des pods opérationnels afin d’éviter toute interruption de service.
Pour assurer la sécurité, l’équipe déploie un pare-feu d’applications web (WAF) afin de se protéger contre les requêtes malveillantes et les acteurs malintentionnés. La protection contre le Top 10 de l’OWASP est une fonctionnalité de base proposée par la plupart des WAF. Lors de la création de l’application, l’équipe a étudié plusieurs WAF, notamment le WAF natif d’Azure et ModSecurity. Elle a finalement choisi NGINX App Protect, avec son WAF en ligne et sa protection contre les attaques par déni de service distribué (DDoS).
L’un des grands avantages de NGINX App Protect est sa colocalisation avec NGINX Ingress Controller, qui permet à la fois d’éliminer un point de redondance et de réduire la latence. Les autres WAF doivent être placés en dehors de l’environnement Kubernetes, ce qui augmente la latence et les coûts. Même des délais infimes (par exemple, 1 milliseconde supplémentaire par requête) finissent rapidement par s’accumuler.
Quête secondaire surprise : aucune interruption pour les développeurs
Après avoir achevé la migration vers AKS de la majeure partie de son infrastructure applicative et réseau, l’entreprise a également constaté des améliorations significatives de l’expérience développeur (DevEx). Désormais, les développeurs détectent presque toujours les problèmes avant même que les clients ne les remarquent. Depuis cette migration, le volume d’appels au support concernant des erreurs a diminué d’environ 80 % !
Les équipes chargées de la sécurité et des performances applicatives de l’entreprise disposent d’un tableau de bord Grafana détaillé et d’un système d’alertes unifié. Elles n’ont ainsi plus besoin de consulter plusieurs systèmes ni de mettre en place des déclencheurs pour les messages et appels d’alerte provenant de différents processus. Les équipes de développement et DevOps peuvent désormais déployer des mises à jour du code et de l’infrastructure chaque jour, voire plusieurs fois par jour, et utiliser des stratégies de déploiement bleu-vert extrêmement granulaires. Auparavant, elles déployaient des mises à jour une à deux fois par semaine et devaient les planifier pendant les périodes de faible utilisation, ce qui était particulièrement stressant. Désormais, le code est déployé dès qu’il est prêt, et les développeurs peuvent en surveiller directement l’impact en observant le comportement de l’application.
Les résultats sont positifs à tous égards : accélération du développement logiciel, amélioration du moral des développeurs et davantage de vies sauvées.
À propos de l’auteur

Articles de blog associés

Tendances actuelles des technologies cloud natives, de l’ingénierie de plateforme et de l’IA
Découvrez les principaux enseignements tirés des réponses à l’enquête annuelle F5 NGINX sur les dernières tendances en matière de technologies cloud natives, de sécurité, d’ingénierie de plateforme et d’IA.

Quels contrôleurs Ingress NGINX sont affectés par les vulnérabilités CVE-2022-4886, CVE-2023-5043 et CVE-2023-5044 ?
Lorsque de nouvelles CVE sont signalées, il est facile de ne plus savoir si elles concernent un outil de contrôleur Ingress NGINX particulier, car il existe plusieurs projets. Cet article présente les CVE et explique comment distinguer les différents projets de contrôleurs Ingress afin de dissiper toute confusion.
Votre API est-elle en temps réel ? Testez sa latence avec l’outil rtapi de NGINX
Votre API répond-elle aux requêtes en moins de 30 ms ? Si ce n’est pas le cas, il ne s’agit pas d’une API en temps réel offrant la faible latence exigée par la grande majorité des organisations. Mesurez la latence de votre API avec l’outil rtapi de NGINX et découvrez comment NGINX peut l’aider à offrir une réactivité en temps réel.

Un testeur d’expressions régulières pour NGINX et NGINX Plus
Le testeur d’expressions régulières (regex) pour NGINX et NGINX Plus vous évite de tâtonner en vous indiquant si une expression régulière utilisée dans un bloc location ou map correspond aux valeurs comme prévu. Il génère la configuration appropriée et affiche les valeurs des groupes de capture.
Caches partagés avec les clusters de cache NGINX Plus, partie 1
Optimisez la capacité de votre cache web en le répartissant entre plusieurs serveurs de cache web NGINX ou NGINX Plus. Découvrez comment procéder dans cet article.
Introduction aux microservices
Les microservices suscitent actuellement beaucoup d’intérêt. Cet article de blog est le premier d’une série de sept consacrée à la conception, au développement et au déploiement de microservices.