L’observabilité est essentielle pour exploiter des applications cloud natives, dont les fonctionnalités résultent des interactions entre un grand nombre de microservices exécutés à différents endroits. En raison du faible couplage des applications basées sur des microservices, chaque microservice peut rendre compte de ses activités à sa manière. Sans outil permettant de compiler et de corréler ces données de télémétrie, il est extrêmement difficile, voire impossible, de suivre le traitement d’une requête de bout en bout, ce qui est indispensable pour résoudre les problèmes.
Lors de la recherche d’un outil d’observabilité multifonction, l’équipe à l’origine du projet NGINX Modern Apps Reference Architecture (MARA) a choisi OpenTelemetry. Notre équipe OSS ayant retenu ce projet émergent, nous souhaitons l’examiner plus en détail. À la GlueCon 2022, j’ai rencontré Granville Schmidt, architecte au sein du bureau du CTO de F5, afin de discuter des raisons pour lesquelles l’état actuel et les futures fonctionnalités d’OpenTelemetry nous enthousiasment. Vous pouvez regarder notre conversation ci-dessous et découvrir, dans cet article de blog, pourquoi OpenTelemetry constitue un atout majeur pour l’écosystème des applications cloud natives.
OpenTelemetry propulse l’observabilité 2.0
Annoncé pour la première fois lors de la KubeCon 2019 à Barcelone, OpenTelemetry a attiré un groupe de contributeurs enthousiastes. Il s’agit du deuxième projet le plus populaire de la Cloud Native Computing Foundation (CNCF) en nombre de contributions et, au cours des six derniers mois, le rythme des contributions a atteint un niveau sans précédent. Ce grand nombre de contributeurs montre qu’OpenTelemetry a gagné en maturité et commence à franchir le fossé entre les utilisateurs précoces (qui souhaitent garder une longueur d’avance) et les pragmatiques (qui recherchent des produits matures).
OpenTelemetry se concentre sur les données, et plus précisément sur les données et les flux de données (télémétrie) nécessaires pour mieux comprendre, dépanner et améliorer nos applications. Les données ne sont utiles que si elles peuvent être agrégées, analysées et visualisées à grande échelle. Bien qu’OpenTelemetry ne donne aucune indication sur la manière de visualiser les données, il nous permet de ne plus nous préoccuper des données que nous pouvons obtenir et de nous concentrer plutôt sur ce que nous pouvons en faire.
OpenTelemetry permet également d’établir une corrélation naturelle entre ces sources de données, plutôt que de nous laisser le soin de tenter de les corréler nous-mêmes. La capacité d’OpenTelemetry à corréler les événements entre les applications nous conduit vers l’Observabilité 2.0, une nouvelle référence pour mesurer l’activité des applications dans le cloud. Les données sont déjà corrélées pour nous, ce qui change notre façon d’appréhender notre environnement applicatif. Nous ne sommes plus limités au simple fait de savoir si l’application fonctionne ou non ; nous pouvons désormais comprendre le cheminement de chaque requête à travers nos applications.
Deux projets open source notables ont précédé OpenTelemetry : OpenTracing (OT) et OpenCensus (OC). Tous deux se sont attaqués à la standardisation du format des données de trace afin de nous permettre d’obtenir les informations nécessaires et de comprendre leur incidence sur nos applications modernes. Bien que ces deux projets présentent des similitudes, ils se disputaient les ressources et les entreprises devaient souvent n’en choisir qu’un. En mars 2019, les deux projets ont annoncé leur fusion au sein d’OpenTelemetry, dans le but d’unifier la manière dont les données de trace sont générées et mises en forme. Le projet OpenTelemetry poursuit également la définition de normes pour l’acquisition d’autres catégories de données d’observabilité (les métriques et les journaux) via les mêmes canaux de télémétrie que les traces, pour une intégration et une clarté accrues.
Examinons maintenant deux aspects fonctionnels passionnants d’OpenTelemetry : le traçage distribué et l’intelligence applicative.
Pourquoi le traçage distribué est indispensable dans les architectures d’applications modernes
Bien que le traçage distribué existe depuis des années, de nombreux changements survenus au cours de la dernière décennie l’ont rendu encore plus nécessaire. En nous appuyant sur le cadre Cynefin, nous pouvons mettre en évidence certains des changements et défis auxquels nous sommes aujourd’hui confrontés dans les applications modernes :
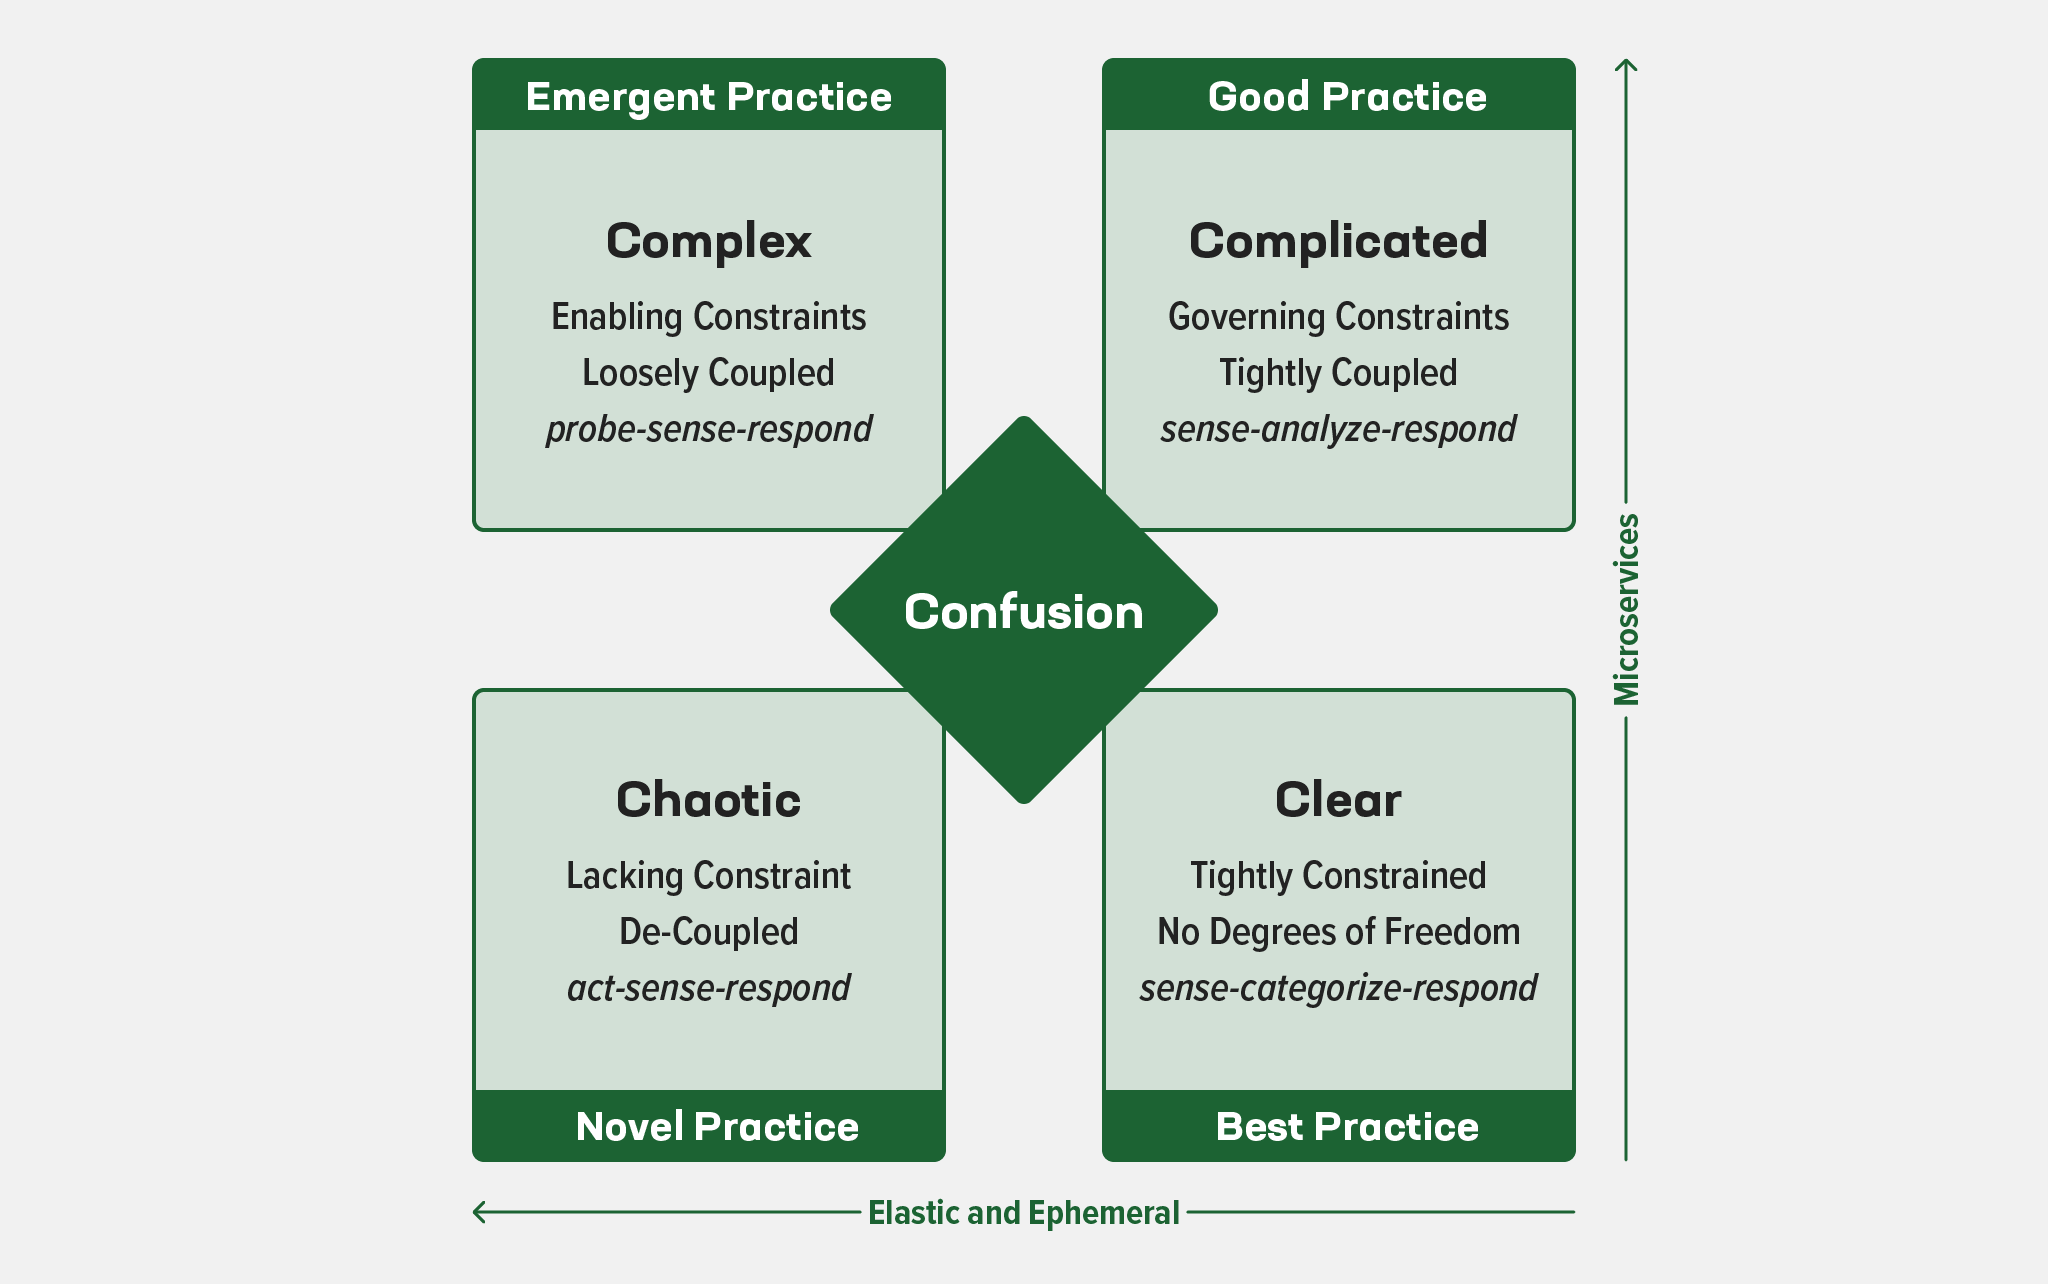
Le cadre Cynefin illustre comment nous pouvons faire évoluer nos pratiques à mesure que nous passons du simple au complexe. La difficulté tient au fait que cette évolution suit deux voies distinctes, chacune ayant ses propres caractéristiques, et que tenter de passer directement du simple au complexe en prenant un raccourci engendre souvent du désordre et une progression incomplète.
Identifions les éléments qui jalonnent notre parcours vers les applications modernes et le cloud natif. Sur le premier axe (l’axe Y du diagramme Cynefin), nous avons des applications modernes, généralement fondées sur des architectures de microservices, dans lesquelles chaque application remplit une fonction précise. Sur le second axe (l’axe X), notre environnement compliqué est éphémère : les instances de microservices sont créées et supprimées en fonction de la demande, et déplacées vers différents hôtes en cas de problèmes réseau.
Nous devons également prendre en compte l’émergence et la croissance fulgurante des environnements cloud tels qu’Amazon Web Services (AWS), Microsoft Azure et Google Cloud Platform (GCP). L’un des avantages de ces clouds est leur élasticité, qui permet d’augmenter ou de réduire les ressources en fonction du niveau de demande actuel. Si l’on ajoute à cela l’impact de l’orchestration des conteneurs (le plus souvent à l’aide de Kubernetes), on commence à observer un comportement chaotique, car le nombre et l’emplacement des ressources évoluent au fil du temps. (Même cette vision relativement limitée est chaotique, et des éléments tels que les fonctions serverless peuvent encore accentuer ce phénomène.)
Dans une architecture moderne, où de nombreux composants distincts produisent les données de télémétrie nécessaires à la surveillance et à la maintenance de nos applications, le volume de données est considérable et complexe. Les problèmes peuvent ne pas se reproduire de manière fiable ou être difficiles à provoquer, car nous ne maîtrisons pas entièrement l’infrastructure ni les voies de communication. Nous avons besoin d’une technologie qui nous permette de suivre toutes les activités et tous les éléments associés, afin de comprendre et d’analyser nos environnements en constante évolution.
C’est là qu’intervient OpenTelemetry.
L’avenir du traçage distribué avec OpenTelemetry
Le traçage distribué entraîne des changements majeurs dans le secteur, notamment dans la manière dont les requêtes permettent d’obtenir une vue interne des performances grâce aux métriques. Avec le traçage distribué, nous pouvons suivre de nombreux types de nouvelles métriques, mais les plus courantes concernent le nombre de requêtes par unité de temps, le nombre d’erreurs par unité de temps et la durée totale d’une requête agrégée sur cette même unité de temps.
Les métriques existent depuis un certain temps déjà : elles sont faciles à gérer et à stocker, s’agrègent aisément et se prêtent bien à l’analyse mathématique. Dans OpenTelemetry, toutes les applications qui génèrent des métriques peuvent les envoyer vers un point de collecte commun par l’intermédiaire d’une couche de télémétrie (transfert), ce qui permet d’harmoniser les données provenant des services faiblement couplés qui les génèrent. Cette harmonisation s’étend également à l’infrastructure sous-jacente. En bref, OpenTelemetry facilite la collecte et l’envoi des métriques.
OpenTelemetry peut également contribuer à résoudre le problème de dérive et de décalage des horodatages, qui complique la corrélation des événements. OpenTelemetry attribue à chaque requête un TraceId, mais les données peuvent malgré tout être affectées par la dérive et le décalage, qui surviennent souvent dans les architectures cloud natives. La dérive et le décalage peuvent être dus à des chemins de transmission de durées variables ou à une synchronisation insuffisante des horloges des différents hôtes. En suivant les communications entre les composants pendant le traitement du trafic, le traçage distribué permet à OpenTelemetry de mesurer les spans individuels, c’est-à-dire les unités de travail et les éléments constitutifs d’une trace, sans nécessiter d’instrumentation approfondie de l’application concernée.
La combinaison de ces trois signaux (catégories de télémétrie) nous permet de corriger les problèmes et de rétablir la qualité de production de nos applications :
- Métriques – « Y a-t-il un problème ? »
- Traces – « Où se situe le problème ? »
- Journaux – « Quel est le problème ? »
C’est là que nous revenons à l’Observabilité 2.0. La possibilité d’obtenir des traces et de voir immédiatement quelles métriques correspondent à chaque trace nous offre de nombreuses possibilités. Par exemple, lorsque les métriques signalent un problème, le traçage distribué permet de remonter jusqu’à la requête précise à l’origine du problème initial et de suivre sa progression à chaque étape de son traitement. Puisque notre trace est constituée des segments dans leur ordre d’apparition, nous pouvons suivre la requête à chaque étape de son parcours. Comprendre ce qui s’est passé et dans quel ordre – depuis l’événement initial jusqu’au résultat final, en passant par le problème signalé – nous permet de déterminer précisément « où » concentrer notre attention au sein de nos applications.
Aussi simple que cela puisse paraître, le traçage distribué d’OpenTelemetry peut nous fournir de précieuses informations sur l’expérience de nos utilisateurs, en servant d’indicateur de la réussite des requêtes et de leur temps d’exécution. En tant qu’utilisateur, c’est ma requête qui m’importe. En tant qu’ingénieur en fiabilité des sites (SRE), ce sont les requêtes agrégées qui m’importent. OpenTelemetry m’offre les deux, ainsi que la possibilité de passer d’une vue agrégée aux détails, puisqu’il est conçu pour rendre toutes les données nécessaires disponibles dans l’ensemble des applications.
Intelligence applicative avec l’IA et le machine learning
Ce nouveau flux de données provenant d’OpenTelemetry nous permet également d’adapter et d’automatiser nos processus de développement et nos interventions opérationnelles. Grâce à toutes ces données accumulées, nous pouvons rendre notre application plus intelligente. F5 s’attache actuellement à accompagner ses clients dans le développement et le déploiement de ce que nous appelons des « applications adaptatives ». Les applications adaptatives sont exactement ce que leur nom indique : des applications qui ajustent automatiquement et intelligemment leur comportement en fonction des changements qui surviennent dans leur environnement.
C’est pourquoi l’intelligence artificielle (IA) et l’apprentissage automatique (ML) sont de plus en plus présents dans diverses solutions. Mais ce n’est pas seulement parce qu’il s’agit de termes à la mode : l’IA et le ML sont utiles, car nous disposons désormais de suffisamment de données pour tirer des conclusions fiables sur les liens de causalité et concevoir des réponses appropriées.
En rendant les données de télémétrie accessibles et standardisées, OpenTelemetry facilite considérablement la transition vers des applications adaptatives. À mesure que différents types de produits commencent à produire des métriques similaires, et grâce à l’utilisation des conventions sémantiques établies au sein d’OpenTelemetry, il devient plus facile de corréler leurs actions lors du traitement des requêtes et de transmettre ces informations à des algorithmes de ML et d’IA afin de permettre aux applications et à l’infrastructure de s’adapter de manière dynamique.
Lorsque vous comprenez la science des données qui sous-tend l’ensemble et que vous veillez à ce que vos données de télémétrie soient liées à votre IA et à votre apprentissage automatique, les applications adaptatives peuvent pleinement exploiter leur nature pilotée par les données et révéler tout leur potentiel.
Résumé
La codification de la télémétrie constitue un avantage évident tant pour les utilisateurs d’OpenTelemetry que pour les applications qui l’utilisent comme canal de télémétrie. Les données peuvent être collectées à partir de plusieurs sources et transmises à n’importe quel outil compatible d’agrégation et d’analyse. En outre, l’OpenTelemetry Collector dispense les fournisseurs d’avoir à mettre en œuvre leurs propres collecteurs. Ils peuvent ainsi se concentrer sur l’amélioration de leur code afin d’effectuer des analyses pertinentes et de prendre des mesures intelligentes, tout en créant de nouveaux outils pour mieux appréhender ce nouvel univers complexe et chaotique. De fait, l’OpenTelemetry Collector, porté par l’innovation de l’open source, est extrêmement performant et peut fonctionner avec la quasi-totalité des formats existants, tout en assurant la transition de cette technologie vers l’avenir.
En se concentrant sur les principales catégories de données dont nous avons besoin pour comprendre nos applications, OpenTelemetry permet à celles-ci de fournir des informations plus approfondies sur les performances et les problèmes propres à l’univers complexe des applications modernes. En corrélant nos données et en les alignant sur des conventions sémantiques et des normes, OpenTelemetry facilite la transition vers les applications modernes. À mesure que le projet gagne en maturité et que son adoption progresse, OpenTelemetry s’impose comme la solution de référence pour approfondir notre compréhension et appliquer des techniques d’IA et de machine learning afin de rendre cette complexité intelligible.
Pour en savoir plus sur la manière dont les ingénieurs OSS de NGINX utilisent OpenTelemetry, essayez l’architecture de référence pour les applications modernes et l’application exemple (Bank of Sirius).
Articles connexes
À propos de l’auteur
Articles de blog associés

Tendances actuelles des technologies cloud natives, de l’ingénierie de plateforme et de l’IA
Découvrez les principaux enseignements tirés des réponses à l’enquête annuelle F5 NGINX sur les dernières tendances en matière de technologies cloud natives, de sécurité, d’ingénierie de plateforme et d’IA.

Quels contrôleurs Ingress NGINX sont affectés par les vulnérabilités CVE-2022-4886, CVE-2023-5043 et CVE-2023-5044 ?
Lorsque de nouvelles CVE sont signalées, il est facile de ne plus savoir si elles concernent un outil de contrôleur Ingress NGINX particulier, car il existe plusieurs projets. Cet article présente les CVE et explique comment distinguer les différents projets de contrôleurs Ingress afin de dissiper toute confusion.
Votre API est-elle en temps réel ? Testez sa latence avec l’outil rtapi de NGINX
Votre API répond-elle aux requêtes en moins de 30 ms ? Si ce n’est pas le cas, il ne s’agit pas d’une API en temps réel offrant la faible latence exigée par la grande majorité des organisations. Mesurez la latence de votre API avec l’outil rtapi de NGINX et découvrez comment NGINX peut l’aider à offrir une réactivité en temps réel.

Un testeur d’expressions régulières pour NGINX et NGINX Plus
Le testeur d’expressions régulières (regex) pour NGINX et NGINX Plus vous évite de tâtonner en vous indiquant si une expression régulière utilisée dans un bloc location ou map correspond aux valeurs comme prévu. Il génère la configuration appropriée et affiche les valeurs des groupes de capture.
Caches partagés avec les clusters de cache NGINX Plus, partie 1
Optimisez la capacité de votre cache web en le répartissant entre plusieurs serveurs de cache web NGINX ou NGINX Plus. Découvrez comment procéder dans cet article.
Introduction aux microservices
Les microservices suscitent actuellement beaucoup d’intérêt. Cet article de blog est le premier d’une série de sept consacrée à la conception, au développement et au déploiement de microservices.