En avril, j’ai expliqué pourquoi l’ancien modèle de sécurité logicielle ne fonctionne plus. Cet article portait sur le problème et les principes. Celui-ci présente le travail que nous menons chez F5 pour sécuriser notre code.
Il y a environ neuf mois, nous avons commencé à utiliser des modèles d’IA de pointe pour analyser systématiquement notre propre code source afin d’y détecter des vulnérabilités. Ce qui n’était au départ qu’une première exploration des capacités de ces modèles face à une véritable base de code à l’échelle de la production est depuis devenu l’un des investissements les plus importants de notre organisation produit. Nous avons mis en place une infrastructure dédiée, mobilisé des ressources d’ingénierie dans toute l’entreprise et fait de cette initiative une priorité absolue à tous les niveaux de l’organisation.
Plus de 80 % des entreprises du classement Fortune Global 500 font confiance à F5. Nous prenons en charge plus de la moitié des environnements de contrôleurs de mise à disposition d’applications (ADC) dans le monde. Les 15 plus grandes banques mondiales, les 30 plus grandes banques commerciales américaines, les 10 plus grandes compagnies d’assurance mondiales, les 10 plus grands opérateurs de télécommunications mondiaux et les 15 départements exécutifs américains utilisent tous F5 dans leur infrastructure.
Nous nous imposons des exigences plus élevées, car les organisations nous placent au cœur de leurs flux les plus critiques : entre leurs utilisateurs et leurs applications, ainsi qu’entre leurs agents et leurs API.
Au début, les modèles n’étaient pas très performants. Ils le sont désormais.
Lorsque nous nous sommes engagés dans cette voie à l’automne 2025, les modèles de pointe auxquels nous avions accès étaient prometteurs, mais limités. Ils pouvaient repérer des problèmes superficiels, mais leur capacité à raisonner sur des bases de code complexes, à comprendre le contexte entre différents modules et à distinguer les véritables vulnérabilités des faux positifs manquait de constance.
Le taux de faux positifs était élevé. Très élevé.
Nous avons dû apprendre beaucoup de choses en partant de zéro :
- Comment concevoir un harnais efficace
- Comment structurer des prompts qui fournissent suffisamment de contexte pour raisonner sur du code réel
- Comment concevoir des pipelines de vérification capables de distinguer le signal du bruit à grande échelle
- Comment utiliser la sortie d’un modèle comme entrée d’un autre afin de confirmer ou d’infirmer les résultats
Il n’existait pas de méthode générique que nous pouvions appliquer à F5, nous avons donc dû en élaborer une.
La vitesse à laquelle ces modèles s’améliorent est stupéfiante. Les modèles de pointe d’Anthropic et d’OpenAI, notamment Claude Mythos et GPT Cyber, sont désormais capables de découvrir de véritables vulnérabilités, de montrer comment elles peuvent être exploitées et d’aider les ingénieurs à les corriger. Dans certains cas, ces modèles sont particulièrement performants sur les fichiers binaires et le code compilé, et pas seulement sur le code source. Ce n’était pas le cas l’automne dernier.
Nous ne sommes pas les seuls à constater cette amélioration. Nous travaillons en étroite collaboration avec certaines des plus grandes organisations au monde, notamment celles qui participent au projet Glasswing. Ces institutions utilisent F5 dans leurs infrastructures les plus critiques et font face à la même évolution que nous.
Plusieurs constats se dégagent clairement :
- Les modèles en préversion et de recherche sont remarquablement performants. Les derniers modèles d’Anthropic et d’OpenAI sont capables de raisonner sur du code compilé, d’identifier des chaînes de vulnérabilités complexes et de générer des preuves de concept sophistiquées.
- Le rythme d’amélioration des modèles n’est pas linéaire. Il s’accélère. Chaque nouvelle génération de modèles marque un bond significatif en matière de capacités. Les organisations qui ne testent pas leur code à l’aide des modèles les plus récents prennent du retard.
- Les faux positifs constituaient le principal obstacle au départ, et non les modèles eux-mêmes. Au début, le rapport signal/bruit était extrêmement défavorable. Nous avons dû investir massivement dans la création de dispositifs de vérification, l’automatisation du tri et des boucles de rétroaction permettant au système d’apprendre à distinguer les véritables problèmes du bruit. Notre taux de faux positifs a ainsi diminué, et nous sommes désormais en mesure de fournir aux ingénieurs de véritables failles de sécurité et anomalies à corriger.
- La protection et la gouvernance des vulnérabilités détectées par les modèles d’IA de pointe constituent une priorité en matière de sécurité. Lorsqu’un modèle détecte une vulnérabilité critique, telle qu’une faille permettant l’exécution de code à distance, la gestion de cette information devient une opération de sécurité à part entière. Nous avons beaucoup appris sur la manière de la gérer de façon responsable.
Tout cela renforce une conviction à laquelle je reviens sans cesse : les modèles que nous utilisons pour détecter les vulnérabilités sont les mêmes que ceux que nos adversaires finiront par utiliser contre nous. La seule stratégie responsable du point de vue de la théorie des jeux consiste à utiliser en permanence des modèles d’IA de pointe pour analyser et améliorer notre code avant qu’un attaquant ne le fasse.
Créer des outils, des bancs d’essai et des processus
Nous avons développé des outils internes qui incarnent une approche radicalement différente de l’analyse des défauts et de la gestion des vulnérabilités.
Notre base de code compte plusieurs dizaines de millions de lignes en C, C++, Python, Tcl, Java, Go et en C de bas niveau destiné aux FPGA. Les problèmes que nous cherchons se trouvent dans du code utilisé en production depuis des années, au sein de modules qui interagissent de différentes manières. Concevoir un environnement de test capable d’analyser l’ensemble de ce périmètre, par-delà les langages et les couches d’abstraction, a représenté un défi technique majeur.
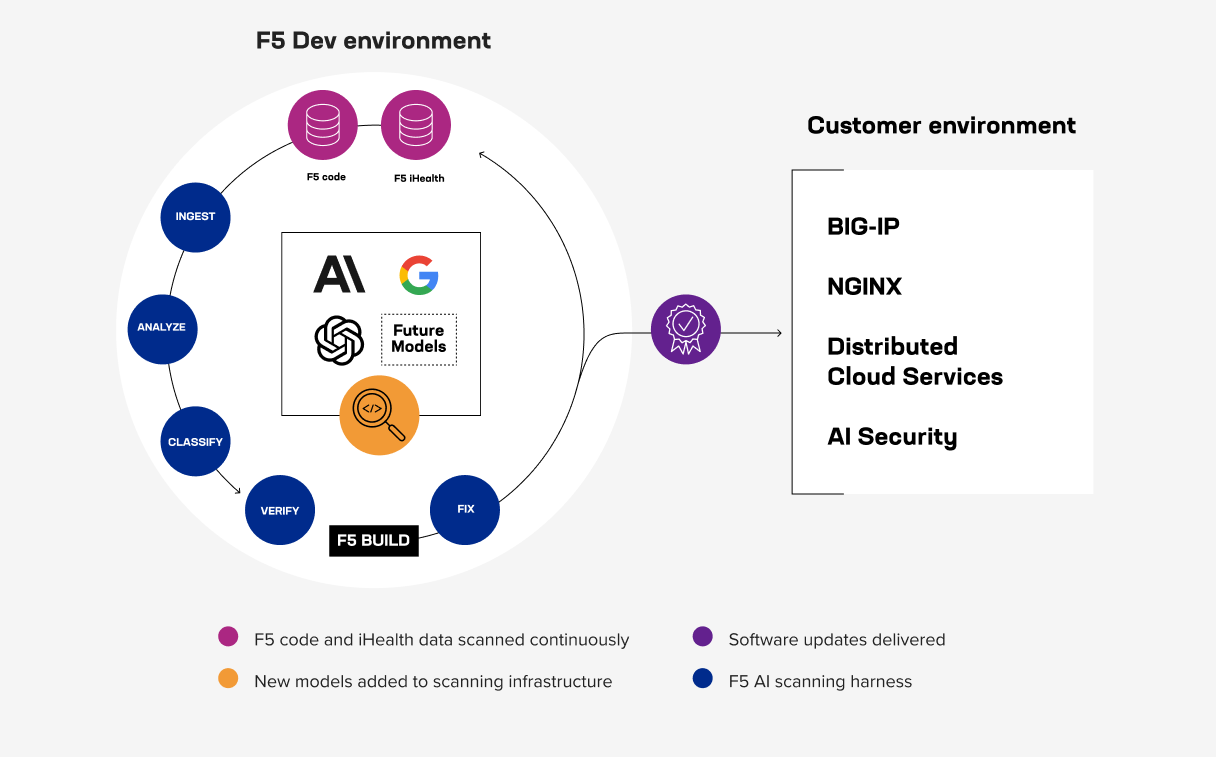
L’un des outils que nous avons développés intègre les nouveaux modèles dès qu’ils sont proposés par un fournisseur, quel qu’il soit, et les teste en continu sur notre base de code. Nous collaborons activement avec des laboratoires d’IA de pointe et avons accès à certains des modèles les plus avancés, notamment des modèles en préversion et des modèles de recherche. Cet outil exploite ces modèles ainsi que la théorie des graphes, l’analyse statique de la composition logicielle, entre autres. Nous y intégrons également des renseignements sur les menaces, notamment des jeux de données publics sur les vulnérabilités et les faiblesses.
Ce n’est pas le seul outil dont nous disposons. Nos équipes ont développé d’autres outils qui recherchent des catégories spécifiques de défauts et tirent parti des travaux d’autres organisations. En outre, de nombreux laboratoires à la pointe de l’IA disposent de bancs d’essai très performants, conçus pour exploiter au mieux les modèles sous-jacents.
Quel que soit l’outil utilisé, l’infrastructure d’analyse suit un processus rigoureux en plusieurs étapes, qui se présente comme suit :
- Ingestion. Nous transmettons aux modèles le code source des principaux modules et langages afin qu’ils puissent raisonner à partir des détails réels de l’implémentation, et non de résumés ou d’abstractions.
- Analyser. Nous effectuons une analyse statique basée sur l’IA afin de détecter les bugs, les schémas à risque et les flux suspects : logique d’authentification défaillante, chiffrement non sécurisé, problèmes de sûreté de la mémoire, et bien plus encore.
- Classifier. Nous extrayons des résultats structurés, notamment les correspondances CWE, les évaluations de gravité, les références aux fichiers et aux lignes, ainsi que le contexte d’exploitabilité.
- Vérifier. Un second modèle confirme, revoit à la baisse ou rejette les résultats avant leur intégration au processus d’ingénierie. C’est à cette étape que le problème des faux positifs est traité. Au début, cette étape n’existait pas réellement et le bruit était considérable. Aujourd’hui, elle constitue l’un des éléments les plus importants du système.
- Corriger. Les problèmes validés sont transmis à un processus de correction priorisé. Les correctifs sont développés, testés et déployés.
Chaque cycle enrichit une base de connaissances qui rend le suivant plus rapide et plus précis. Au fil du temps, la base de code elle-même devient plus robuste. Les modèles détectent moins de problèmes, car il y en a moins à détecter. C’est cet effet cumulatif dans lequel nous investissons.
Ce que nous constatons
Nous trouvons des problèmes présents dans pratiquement toutes les bases de code matures : des lacunes dans le renforcement de la configuration, des paramètres par défaut qui devraient être durcis, des problèmes de sécurité de la mémoire (dépassements de mémoire tampon, dépassements d’entiers), des situations de concurrence et des lacunes dans la validation des entrées.
Ce sont précisément les types de problèmes que nous voulons détecter et corriger. Dans un monde où les modèles d’IA sont capables de déterminer comment enchaîner plusieurs vulnérabilités, leur élimination systématique rend l’ensemble du code nettement plus résistant aux tentatives d’exploitation. Ces vulnérabilités constituent les éléments de base des chaînes d’exploitation ; les supprimer rend les logiciels plus difficiles à attaquer.
Un nouveau réflexe : analyser, trier, corriger, tester, publier, recommencer
L’un des résultats les plus importants de ce travail est la capacité opérationnelle que notre organisation d’ingénierie a développée au cours des derniers mois. L’analyse n’est qu’un élément d’une capacité de bout en bout que nous avons mise en place et qui n’existait pas auparavant.
Nous abandonnons le rythme de publication trimestriel au profit de versions renforcées plus fréquentes pour l’ensemble de nos logiciels. Il s’agit d’un changement opérationnel majeur. Prenons, par exemple, la rigueur dont fait preuve notre équipe d’ingénierie BIG-IP : elle effectue des tests sur toutes les combinaisons actives de F5OS et de TMOS utilisées par nos clients. Chaque combinaison nécessite un environnement de test dédié. Chaque version est soumise à un contrôle strict des branches, à des tests de régression et à des tests de longévité. Nous consignons les durées de mise à niveau et de redémarrage, et associons à la version chaque correctif, qu’il concerne un dépassement de mémoire tampon, le renforcement de la validation des entrées ou une CVE.
Depuis des années, nous appliquons des pratiques rigoureuses d’analyse et de test. Ce qui a changé, c’est le cycle piloté par l’IA : analyser, trier, corriger, tester, publier, puis recommencer.
La suite
Attendez-vous à davantage de versions à mesure que l’analyse assistée par l’IA mettra au jour de nouvelles vulnérabilités. C’est le signe d’une sécurité renforcée, et non de logiciels moins fiables. Nous communiquerons nos découvertes après avoir publié des versions renforcées.
À mesure que la fréquence des correctifs augmente dans l’ensemble du secteur, nos clients devront intégrer plus souvent davantage de mises à jour provenant de tous leurs fournisseurs. Nous nous engageons à leur faciliter la tâche, et non à la compliquer. Nous avons accéléré nos travaux sur la gestion des parcs, les mises à jour automatisées et la simplification des processus de mise à niveau, car ces éléments sont essentiels.
En outre, la sécurité à l’exécution doit suivre le rythme. Les capacités de détection et de réponse basées sur l’IA constitueront une ligne de défense essentielle pour identifier et neutraliser les menaces sans s’appuyer sur des signatures connues ni attendre la publication d’un correctif. Nous développons ces capacités parce que l’évolution des menaces l’exige. Nous vous en dirons très bientôt davantage à ce sujet.
Il y a neuf mois, nous avons commencé à étudier si les modèles d’IA de pointe pouvaient changer radicalement notre façon de détecter et de corriger les vulnérabilités dans notre propre code. C’est effectivement le cas. Les modèles sont plus performants que nous ne l’espérions. Nos capacités opérationnelles sont plus solides que prévu, et l’urgence n’a fait que croître.
Les organisations qui nous confient leurs infrastructures les plus critiques ne méritent rien de moins.
Pour en savoir plus, consultez mon précédent article de blog, « La fenêtre de déploiement des correctifs est terminée. Voici comment F5 se prépare à la suite ».
À propos de l’auteur

Kunal Anand dirige l’organisation produit de F5 en tant que directeur des produits. Responsable de la vision, de la stratégie et de l’exécution des produits, il veille au développement de solutions révolutionnaires qui répondent à des enjeux critiques et offrent aux clients des expériences exceptionnelles. Dans ses précédentes fonctions de directeur de la technologie et de l’IA, Kunal a défini la stratégie et la vision de l’entreprise en matière de technologie et d’intelligence artificielle. Avant de rejoindre F5, Kunal a occupé le double poste de directeur de la technologie et de directeur de la sécurité des systèmes d’information chez Imperva. Son parcours chez Imperva a débuté en 2018 avec l’acquisition de Prevoty, une start-up spécialisée dans la sécurité des applications qu’il avait cofondée en 2013. Avant de rejoindre Prevoty, il était directeur de la technologie chez BBC Worldwide. Fort d’une longue expérience en matière d’innovation et d’une solide expertise technique, Kunal a dirigé des équipes chargées de la sécurité, des données, de la technologie et de l’ingénierie chez Gravity, MySpace et au Jet Propulsion Laboratory de la NASA. Kunal possède plus de 15 ans d’expérience dans les domaines de l’IA et de l’apprentissage automatique, notamment dans l’entraînement de modèles, l’utilisation d’algorithmes fondés sur l’IA pour améliorer les produits, ainsi que la conception et la mise en œuvre d’architectures d’IA. Kunal est titulaire d’une licence en informatique du Babson College.
Autres articles de Kunal AnandArticles de blog associés

IA et cybersécurité
Découvrez comment l’IA et la cybersécurité fonctionnent de concert. Découvrez comment l’IA et le machine learning (ML) permettent à votre entreprise de rester sécurisée, efficace et prête à innover avec F5.

Suivre le rythme de l’innovation de pointe ne suffit pas à faire avancer l’entreprise : se préparer à la réglementation de l’IA
À mesure que la réglementation de l’IA évolue, réfléchissez aux mesures de protection que vous pouvez mettre en place dès maintenant.

Les contrôleurs de mise à disposition d’applications reviennent au cœur des priorités stratégiques
L’IA rebat les cartes de la livraison d’applications. Nirav Shah de F5 revient sur la nouvelle étude de Gartner® consacrée aux ADC et explique ce qu’elle implique pour les décisions des entreprises en matière d’infrastructure.

Ce que nos clients nous disent sur l’IA, le multicloud hybride et la sécurité des applications
Le nouveau vice-président senior du marketing produit de F5 explique les pressions liées à l’IA auxquelles sont confrontés les dirigeants d’entreprise et ce dont ils ont besoin pour renforcer leur organisation.

Cinq niveaux de cyberrésilience antifragile transforment les pratiques en résultats
Découvrez comment cinq niveaux de résilience antifragile transforment les perturbations en comportements adaptatifs qui limitent les défaillances et renforcent l’architecture multicloud hybride.

Optimiser les pipelines d’IA en éliminant les goulets d’étranglement dans les charges de travail modernes
À mesure que les charges de travail d’IA montent en puissance, les entreprises constatent des ralentissements provenant du pipeline de données en amont qui alimente le modèle d’IA. Voici comment F5 BIG-IP peut les aider.