Cet article de blog est le deuxième d’une série consacrée à la fourniture de données pour l’IA.
À mesure que l’utilisation de l’IA s’accélère, les pipelines de données doivent évoluer encore plus rapidement afin d’éviter les goulets d’étranglement et de maintenir les performances. De récentes études menées par des cabinets tels que McKinsey & Company montrent que la demande en capacité de centres de données adaptée à l’IA devrait augmenter d’environ 33 % par an jusqu’en 2030. Cela signifie que même les meilleures architectures de modèles manqueront de données si le pipeline de fourniture n’évolue pas en conséquence.
Mais à mesure que les charges de travail d’IA augmentent, les entreprises découvrent rapidement une réalité surprenante : les ralentissements proviennent rarement du processus d’entraînement ou d’ajustement fin du modèle lui-même ; ils sont dus au pipeline de données en amont, qui doit alimenter en continu la fabrique de modèles avec de grands volumes de données de haute qualité.
“De nouvelles innovations permettent à F5 BIG-IP de fournir les fonctionnalités intelligentes de gestion du trafic, d’optimisation du chemin des données et de contrôle de la sécurité nécessaires pour assurer le transfert des données d’IA à haut débit et en grande quantité dans les workflows d’entraînement, de génération d’embeddings et d’ajustement fin.”
Les systèmes d’IA modernes reposent sur un transfert rapide et prévisible des données entre les magasins d’objets, les couches de récupération, les pipelines de fonctionnalités et les workflows de génération d’embeddings, ainsi que vers les points de terminaison d’inférence, le cas échéant. Lorsque ce « flux » ralentit, les performances s’effondrent, les GPU restent inactifs et l’entreprise met plus de temps que prévu à commencer à en tirer profit.
Une analogie utile est celle de l’oléoduc, que nous avons évoquée dans le premier article de blog de cette série. Vous pouvez disposer de la raffinerie la plus avancée au monde, c’est-à-dire du grand modèle de langage (LLM), du moteur de recherche vectorielle ou du cluster multimodal de création de modèles utilisé pour l’entraînement, l’ajustement fin ou la production d’embeddings. Mais si les conduites qui alimentent cette raffinerie sont étroites, présentent des fuites ou sont engorgées, la production s’arrête. Le problème ne vient pas du processus de raffinage, mais du système de transport. Les pipelines d’IA actuels obéissent au même principe : le flux de données détermine les performances du système.
Là où se forment réellement les goulots d’étranglement de l’IA
Les pipelines d’IA connaissent rarement une rupture en un point unique ; ils ralentissent tout au long d’une chaîne de micro-interactions. Un même workflow peut nécessiter d’extraire des jeux de données d’entraînement, des référentiels de connaissances d’entreprise ou des plongements depuis un stockage objet, de transformer ces données en vue de leur ingestion, d’interroger une base de données vectorielle, de solliciter plusieurs microservices, puis seulement de passer aux étapes d’ajustement fin ou de création du modèle.
Chaque étape peut générer des frictions. Pris séparément, les délais semblent négligeables, mais leur cumul allonge les temps de traitement de bout en bout et prive les GPU des données dont ils ont besoin, en particulier lors des tâches d’entraînement ou d’augmentation à grande échelle.
C’est comme un oléoduc soumis à une baisse de pression, à un mauvais alignement des vannes et à des pics inattendus. Le débit devient irrégulier et les installations en aval ne bénéficient jamais d’un approvisionnement stable et prévisible. Les systèmes de fabrique de modèles d’IA connaissent le même phénomène lorsque les nœuds de stockage ralentissent, que les chemins réseau se dégradent ou que les charges de travail augmentent de manière imprévisible.
Les études disponibles sont sans équivoque : les problèmes de performances de l’IA proviennent généralement du pipeline de données, et non du modèle. Dans une étude de Fivetran, 42 % des entreprises ont indiqué que plus de la moitié de leurs projets d’IA avaient pris du retard, affiché des performances insuffisantes ou échoué parce que leurs données n’étaient pas prêtes ou accessibles à temps.
Une autre étude de Broadcom a révélé que 96 % des organisations affirment que les problèmes de performances des pipelines de données ont directement compromis leurs objectifs en matière d’IA, entraînant des retards dans les workflows d’entraînement et de préparation, une automatisation réduite et des reprises coûteuses.
Ces chiffres mettent en évidence une vérité essentielle : lorsque les données ne peuvent pas circuler rapidement ou de manière fiable dans le pipeline, même les opérations de fabrique de modèles les plus sophistiquées ne peuvent pas produire des résultats cohérents.
Comment F5 BIG-IP modernise la distribution des données d’IA
Avec la sortie de F5 BIG-IP version 21, BIG-IP a largement dépassé son rôle traditionnel de contrôleur de mise à disposition d’applications (ADC). Il s’agit désormais d’un ADC entièrement modernisé, conçu pour les pipelines de données pilotés par l’IA, en particulier ceux qui reposent sur un stockage objet compatible S3.
De nouvelles innovations permettent à F5 BIG-IP de fournir la gestion intelligente du trafic, l’optimisation des chemins de données et les contrôles de sécurité nécessaires pour assurer le transfert rapide et à grande échelle des données d’IA dans les workflows d’entraînement, de génération d’embeddings et d’affinage, et pas seulement d’inférence.
Il est conçu pour stabiliser et accélérer l’ensemble du flux. En tant que couche de mise à disposition entre le stockage objet et la pile applicative d’IA, il garantit la fluidité, la sécurité et la résilience de l’ingestion, de la récupération et du routage des données, même en cas de charge intensive.
BIG-IP surveille en permanence l’état des nœuds de stockage et redirige automatiquement le trafic pour éviter les points de terminaison lents ou défaillants. Ses optimisations propres à S3, telles que des profils TCP/TLS améliorés pour les chargements partitionnés de fichiers volumineux, contribuent à réduire la surcharge liée aux requêtes et à accélérer les lectures à grande échelle. Le trafic peut également être orienté en fonction de métadonnées, telles que la taille, le préfixe ou le compartiment de l’objet, ce qui permet aux entreprises d’accorder des priorités différentes aux jeux de données d’affinage, aux artefacts d’entraînement ou aux données d’embedding RAG selon leurs besoins opérationnels.
Piliers clés : routage géolocalisé, mise en cache et sécurité
Un autre facteur important de l’efficacité de BIG-IP réside dans sa gestion du routage tenant compte de la localisation. Lorsqu’une région de stockage subit des ralentissements ou qu’un cluster fait l’objet d’une opération de maintenance, les flux sont redirigés de manière transparente vers un site opérationnel, sans qu’il soit nécessaire de modifier les applications elles-mêmes. Le pipeline d’IA reste ainsi alimenté en données en continu, indépendamment de ce qui se passe dans la couche de stockage sous-jacente.
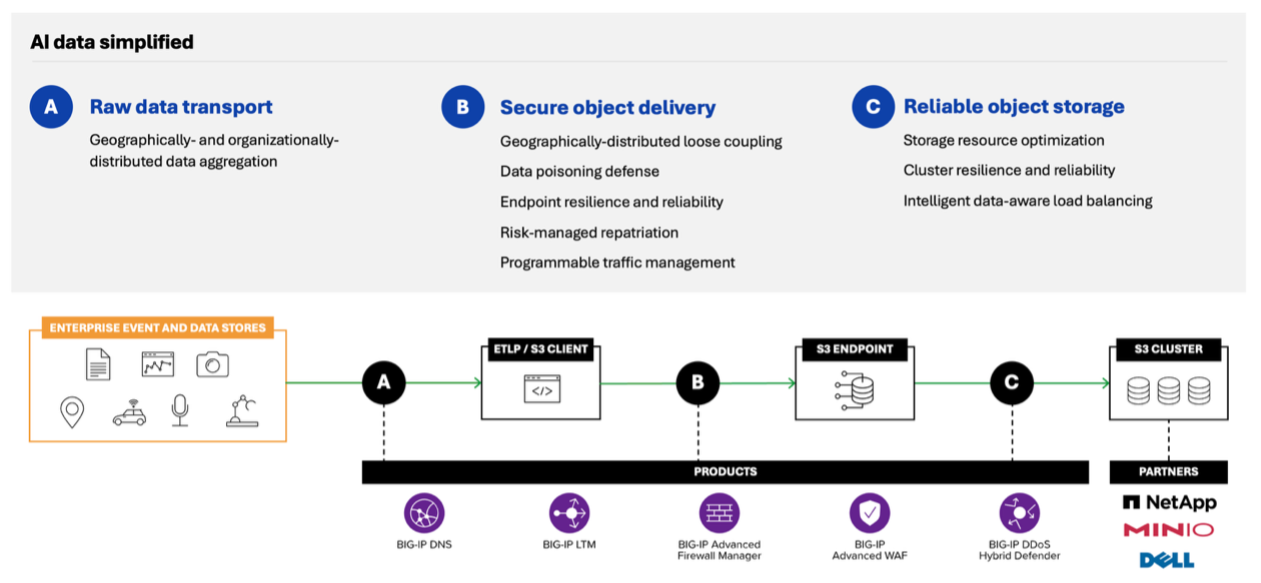
La gestion du trafic et la sécurité doivent être étroitement intégrées à l’écosystème de transport des données. Les points de terminaison des données d’IA sont coûteux à exploiter et constituent des cibles de choix pour les attaquants. Comme l’illustre le schéma ci-dessous, BIG-IP fournit aux pipelines de données d’IA des fonctionnalités essentielles de distribution et de sécurité. La protection avancée contre les attaques DDoS, les fonctionnalités WAF et la gouvernance granulaire des API font de la sécurité une composante du pipeline de données plutôt qu’un goulet d’étranglement.
L’importance de la résilience et de la fiabilité
Même les pipelines optimisés peuvent subir des perturbations. Les pics de trafic, les défaillances de nœuds, les pics de réplication et les changements apportés au réseau peuvent tous dégrader les performances de l’IA. La résilience désigne la capacité à maintenir la circulation des données malgré ces conditions. BIG-IP excelle dans ce domaine grâce au basculement actif, au drainage du trafic lors des opérations de maintenance et à des politiques de routage programmables qui assurent la stabilité du pipeline.
Concrètement, cela signifie que les magasins de données restent disponibles et accessibles. Les cycles d’entraînement se poursuivent sans perdre leur élan. Les processus de création d’embeddings pour la RAG et d’augmentation des données s’achèvent dans les délais. L’entreprise évite ainsi les défaillances en cascade qui surviennent lorsqu’une couche de la pile d’IA est surchargée ou indisponible.
BIG-IP joue le rôle de système de régulation de la pression, d’équilibrage des flux et de soupape de sécurité pour l’ensemble du pipeline de données d’IA. Il garantit que la raffinerie, autrement dit la fonderie de modèles d’IA, dispose toujours du flux constant de « pétrole » de haute qualité dont elle a besoin.
F5 fournit et sécurise les applications d’IA partout
L’optimisation des performances de l’IA ne se limite pas à l’inférence des modèles. Elle consiste également à garantir que les volumes considérables de données nécessaires aux processus d’entraînement, d’ajustement et d’intégration vectorielle soient transférés rapidement, de manière prévisible et sécurisée.
Pour en savoir plus sur nos solutions de transfert de données pour l’IA, consultez notre page consacrée aux solutions de transfert de données et d’infrastructure pour l’IA .
L’engagement de F5 en faveur de l’IA ne se limite pas à la fourniture de données. Découvrez comment F5 sécurise et fournit des applications d’IA partout dans le monde.
N’oubliez pas de consulter les autres articles de blog de notre série consacrée à la distribution des données pour l’IA :
Alimenter le pipeline de données d’IA avec F5 et un stockage compatible S3
Suivi des pipelines de données d’IA, de l’ingestion à la livraison
Pourquoi le stockage pour l’IA exige une nouvelle approche de l’équilibrage de charge
Bonnes pratiques pour optimiser l’infrastructure d’IA à grande échelle
Déployer des applications d’IA à grande échelle : le rôle des ADC
Sécurisez votre pipeline de données d’IA sans ralentir vos pipelines
À propos de l’auteur

Hunter Smit est directeur principal du marketing produit pour les solutions et la stratégie chez F5. Il dirige le marketing des solutions pour l’ensemble du portefeuille de F5, notamment dans les domaines de l’infrastructure d’IA et de la sécurité des applications, et pilote l’entrée de F5 sur le marché émergent de la fourniture de données pour l’IA. Hunter est membre du conseil consultatif de l’École de commerce de l’université Whitworth et a enseigné le marketing produit en tant que chargé de cours vacataire. Il est titulaire d’un MBA et d’un Bachelor of Business Administration en management de l’université Whitworth.
Autres articles de Hunter SmitArticles de blog associés

IA et cybersécurité
Découvrez comment l’IA et la cybersécurité fonctionnent de concert. Découvrez comment l’IA et le machine learning (ML) permettent à votre entreprise de rester sécurisée, efficace et prête à innover avec F5.

Suivre le rythme de l’innovation de pointe ne suffit pas à faire avancer l’entreprise : se préparer à la réglementation de l’IA
À mesure que la réglementation de l’IA évolue, réfléchissez aux mesures de protection que vous pouvez mettre en place dès maintenant.

Les contrôleurs de mise à disposition d’applications reviennent au cœur des priorités stratégiques
L’IA rebat les cartes de la livraison d’applications. Nirav Shah de F5 revient sur la nouvelle étude de Gartner® consacrée aux ADC et explique ce qu’elle implique pour les décisions des entreprises en matière d’infrastructure.

Ce que nos clients nous disent sur l’IA, le multicloud hybride et la sécurité des applications
Le nouveau vice-président senior du marketing produit de F5 explique les pressions liées à l’IA auxquelles sont confrontés les dirigeants d’entreprise et ce dont ils ont besoin pour renforcer leur organisation.

Cinq niveaux de cyberrésilience antifragile transforment les pratiques en résultats
Découvrez comment cinq niveaux de résilience antifragile transforment les perturbations en comportements adaptatifs qui limitent les défaillances et renforcent l’architecture multicloud hybride.

Optimiser les pipelines d’IA en éliminant les goulets d’étranglement dans les charges de travail modernes
À mesure que les charges de travail d’IA montent en puissance, les entreprises constatent des ralentissements provenant du pipeline de données en amont qui alimente le modèle d’IA. Voici comment F5 BIG-IP peut les aider.