La disponibilité est un enjeu majeur dans une économie où les applications font office de monnaie. Celles qui ne répondent pas sont aussitôt supprimées et dénigrées sur Internet, avec la rapidité et le sarcasme d’un avis négatif sur Yelp.
Depuis les débuts d’Internet, les organisations cherchent à garantir que les applications (autrefois, les sites web) soient disponibles 24 heures sur 24, 7 jours sur 7 et 365 jours par an. Car Internet ne dort jamais, ne prend jamais de vacances et ne se fait jamais porter pâle.
Pour répondre à ce besoin (à cette exigence, en réalité), l’évolutivité s’est imposée comme l’un des premiers services applicatifs permettant d’assurer la disponibilité. Le service applicatif le plus visible — et le mieux compris — répondant aux besoins de disponibilité est la répartition de charge.
Il existe toutefois de nombreuses formes d’équilibrage de charge, ainsi que différents modèles de mise à l’échelle que vous pouvez mettre en œuvre à l’aide de cette technologie fondamentale. Aujourd’hui, je vais vous présenter les cinq principaux modèles de mise à l’échelle utilisés pour maintenir les applications et Internet en ligne et disponibles 24 h/24, 7 j/7, 365 jours par an.
Répartition globale de la charge des serveurs (GSLB)
Le terme GSLB est particulièrement mal choisi. Il n’a jamais vraiment été question de répartition de charge entre les serveurs, mais plutôt de disponibilité des sites. Aujourd’hui, cette notion s’étend également à la disponibilité des applications.
Le GSLB permet de garantir que, si un centre de données (dans le cloud ou traditionnel) ne répond pas, vous pouvez en trouver un autre. Le GSLB peut être appliqué au niveau du domaine ou de l’hôte. Vous pouvez donc l’utiliser pour basculer example.com d’un emplacement à un autre, ainsi que api.example.com.
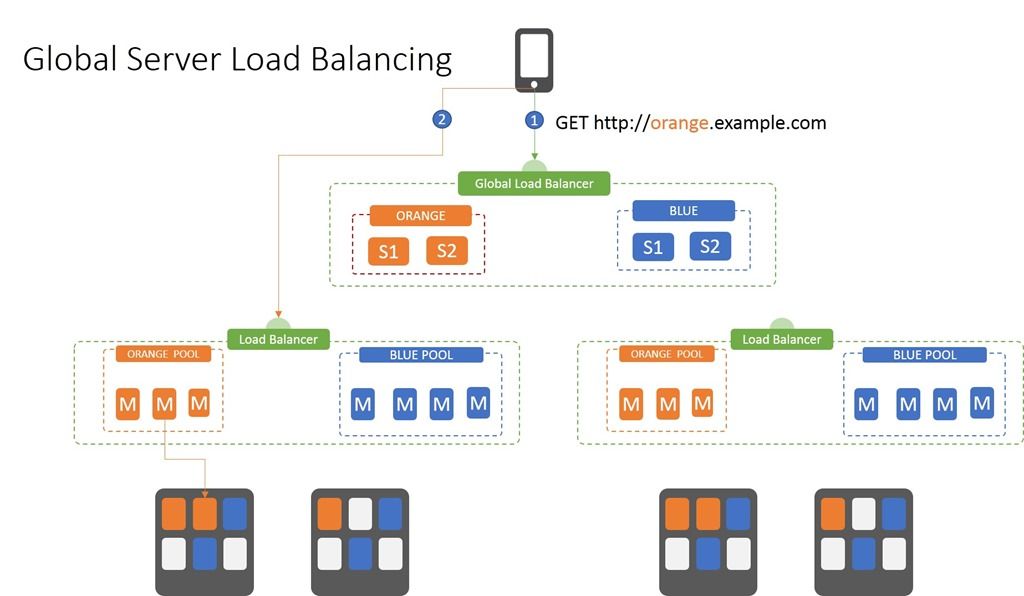
Dans sa forme la plus élémentaire, le GSLB utilise un équilibrage de charge rudimentaire basé sur le DNS. Il dispose ainsi d’une liste d’adresses IP associées à un domaine ou à un hôte et, si la première n’est pas disponible, les requêtes sont redirigées vers la deuxième de la liste, puis vers la troisième, la quatrième, et ainsi de suite.
Ce processus se déroule en deux étapes :
- Demandez au répartiteur de charge global l’adresse IP appropriée. C’est l’inconvénient systématiquement associé au GSLB : si vous avez demandé l’adresse IP de cheese.com au cours des 15 dernières minutes, ou pendant la durée du TTL actuel, vous obtenez la dernière réponse reçue. Par conséquent, si ce site est tombé en panne entre-temps, vous ne pourrez pas vous y connecter.
- Envoyez la requête à l’adresse IP du site renvoyée par la requête GSLB. Il s’agit souvent d’un équilibreur de charge local qui utilise ses propres algorithmes et son propre processus décisionnel pour acheminer la requête vers la ressource appropriée.
La décision prise à l’étape 1 ne repose généralement sur aucune analyse intelligente ; elle dépend uniquement du fait qu’un site donné réponde ou non. Cette méthode permet néanmoins d’utiliser plusieurs emplacements — cloud, hébergeur, infrastructure sur site — afin de garantir la disponibilité. En choisissant stratégiquement des emplacements dans différentes zones géographiques, vous pouvez éviter les conséquences des catastrophes naturelles ou des pannes d’Internet.
Mais cela relève davantage d’un scénario de reprise après sinistre (DR) ou de continuité d’activité (BC). D’autres scénarios tirent parti de services applicatifs GSLB plus intelligents, tels que la géolocalisation et les performances applicatives. Ainsi, si l’application du site A affiche de mauvaises performances, vous pouvez rediriger les visiteurs vers le site B jusqu’à ce que le problème soit résolu. Vous pouvez également orienter les utilisateurs vers le site géographiquement le plus proche afin d’améliorer les performances (car la vitesse de la lumière reste une contrainte et la distance influe sur les performances des applications).
Quelle que soit la manière dont la décision est prise, le principe de base reste le même : le GLSB répartit les requêtes entre plusieurs sites physiquement distincts en renvoyant l’adresse IP de l’un des sites disponibles. Qu’il s’agisse d’API ou d’applications, le GSLB constitue un mécanisme de premier niveau pour garantir la disponibilité.
Équilibrage de charge classique (POLB)
Disponibilité basée sur les connexions
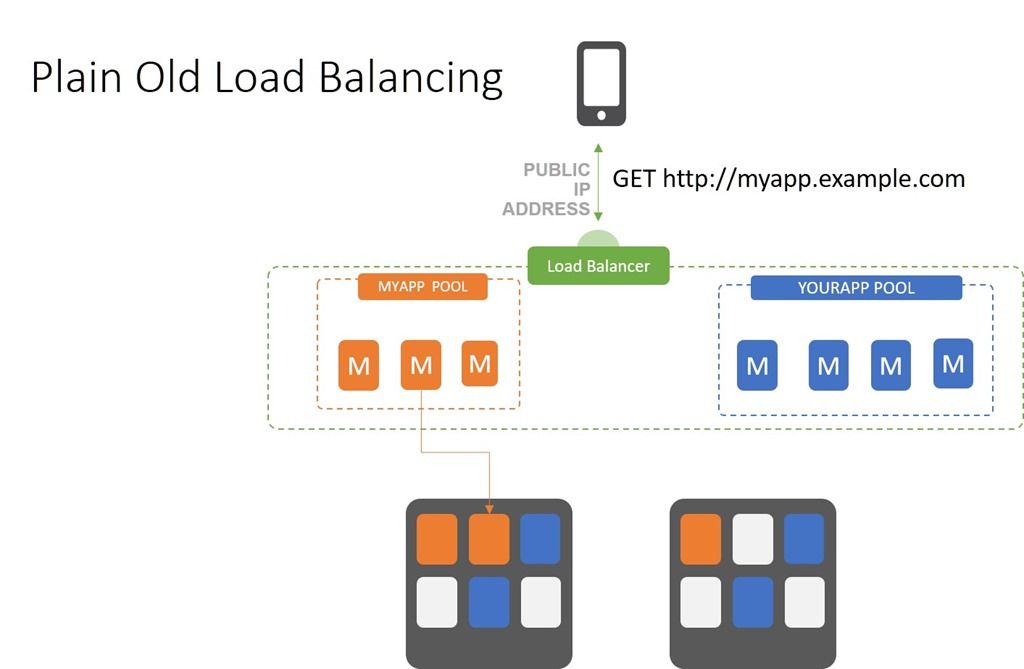
« Plain Old Load Balancing » (POLB) est le terme que j’aime employer pour désigner l’équilibrage de charge standard basé sur TCP. Avec ce modèle, la disponibilité est assurée simplement en dupliquant les applications et en veillant à ce qu’une connexion puisse être établie entre le client (utilisateur, appareil) et l’application.
Le répartiteur de charge (ou proxy, si vous préférez) reçoit une demande de connexion, sélectionne une instance disponible de l’application, puis lui transmet la connexion. C’est la dernière fois que le répartiteur de charge intervient activement. C’est un peu comme un « e-mail de mise en relation » dans lequel vous facilitez la rencontre entre deux collègues. Vous participez activement au premier échange, mais êtes ensuite placé en copie et, en général, n’intervenez plus.
J’utilise le terme POLB parce que le choix de la manière d’acheminer les requêtes repose uniquement sur des algorithmes. Malheureusement, de nombreux problèmes peuvent survenir selon l’algorithme utilisé pour répartir les requêtes. Par exemple, l’algorithme round robin ne tient compte ni de la capacité ni des performances. Il sélectionne simplement « l’application suivante », puis lui transmet la requête. Choisir l’algorithme « least connections » peut rapidement nuire aux performances en surchargeant une ressource, alors que d’autres pourraient être plus rapides. Le choix des algorithmes devient donc un élément essentiel pour garantir la disponibilité.
POLB est la méthode d’équilibrage de charge utilisée par défaut dans les environnements de conteneurs et par de nombreux services d’équilibrage de charge cloud natifs.
Persistance
Sessions persistantes et SSL
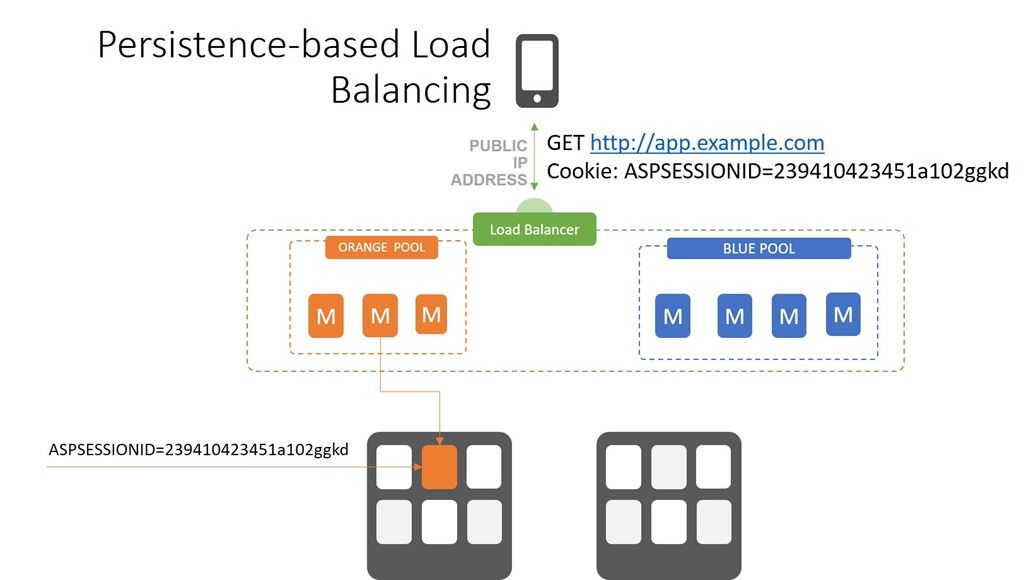
L’une des réalités des applications à trois niveaux est qu’elles conservent généralement un état. Autrement dit, elles stockent entre les requêtes et les réponses des informations essentielles à leur fonctionnement. Votre panier, vos identifiants, votre statut, la dernière page consultée et l’étape à laquelle vous vous trouvez dans un processus sont autant de données souvent enregistrées dans le cadre de la « session ». Or, de nombreuses applications développées à l’aide de frameworks à trois niveaux ont fini par stocker cette session sur le serveur d’applications ou le serveur web, plutôt que dans une base de données. Par conséquent, une fois connecté à un serveur, vous deviez continuer à vous adresser à ce même serveur pour vous assurer que toutes vos informations restaient disponibles.
Les répartiteurs de charge assuraient la persistance de différentes manières, la plus courante reposant sur les cookies. Les identifiants de session étaient stockés dans un cookie, puis utilisés par le répartiteur de charge pour s’assurer que les requêtes étaient acheminées vers le bon serveur, contournant ainsi le processus de sélection algorithmique.
Lorsque l’utilisation de SSL/TLS est devenue indispensable pour que les acheteurs se sentent en sécurité, les mêmes problèmes sont apparus. SSL/TLS établit une session sécurisée entre un client et un serveur d’applications spécifique. Pour que les deux parties puissent déchiffrer et exploiter les données échangées via cette connexion, l’équilibreur de charge devait être en mesure d’acheminer les requêtes du client vers le serveur sur lequel la session avait été initialement établie. En utilisant les mêmes techniques que celles permettant la persistance de session, les équilibreurs de charge ont pu prendre en charge la persistance basée sur SSL/TLS.
Quel que soit le type de persistance utilisé, le principe reste le même. Si un indicateur signale qu’une session a déjà été établie, l’équilibreur de charge maintient la connexion existante pendant toute la durée de la session utilisateur. Dans le cas contraire, il sélectionne une ressource en fonction de sa configuration et de ses algorithmes, puis établit la connexion.
Cela a des conséquences sur la planification de la capacité lors du choix d’un algorithme d’équilibrage de charge. L’algorithme du plus petit nombre de connexions est un bon choix dans ce scénario, car il garantit qu’aucune ressource ne sera surchargée par des sessions en cours tandis que d’autres resteront inutilisées. Avec d’autres algorithmes, une même ressource risque de devoir gérer simultanément de nombreuses sessions utilisateur, ce qui nuit aux performances de tous les utilisateurs dirigés vers ce serveur.
Équilibrage de charge basé sur l’hôte
Serveurs virtuels
L’équilibrage de charge basé sur l’hôte est l’un des modèles de mise à l’échelle les plus courants et les plus largement pris en charge. Vous pourriez penser qu’il n’est pas nécessaire d’utiliser un équilibreur de charge pour le mettre en œuvre, puisque tous les serveurs web peuvent se faire passer simultanément pour plusieurs hôtes. Pourtant, c’est bien nécessaire. Même si un serveur web/applicatif peut héberger plusieurs serveurs virtuels, il ne répartit pas nécessairement la charge entre eux. Vous avez donc toujours besoin d’un équilibreur de charge pour assurer la mise à l’échelle. Reste à savoir si l’équilibreur de charge séparera les hôtes ou si vous laisserez cette tâche au serveur web/applicatif.
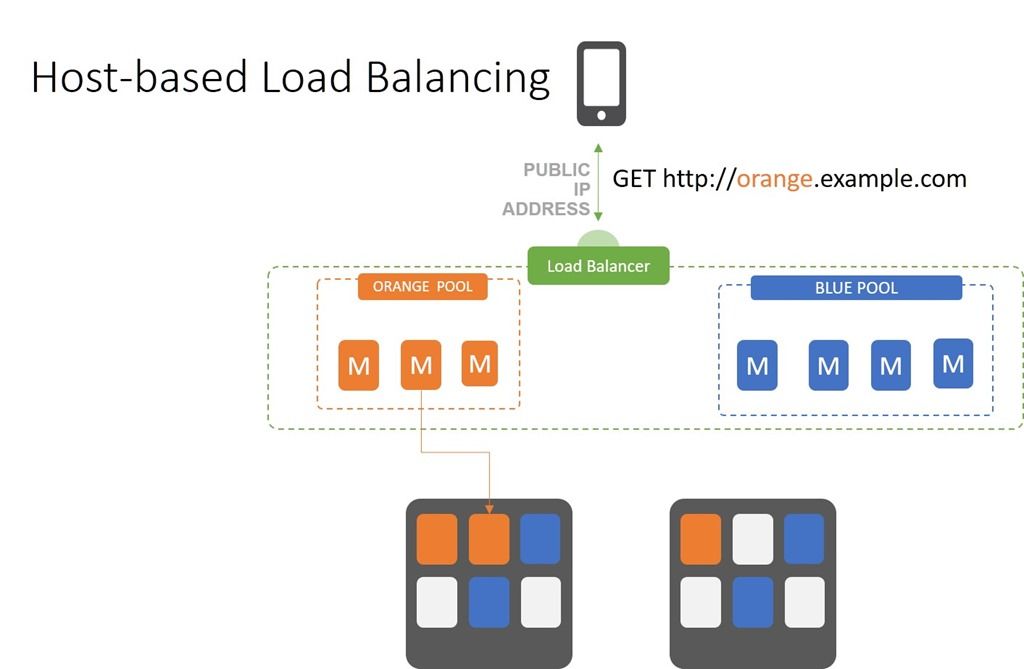
Que l’on utilise les directives du serveur web/applicatif ou un équilibreur de charge externe, le processus reste le même. Une requête est envoyée et reçue par la cible (l’équilibreur de charge ou le serveur web/applicatif). Le serveur cible examine ensuite les en-têtes HTTP et identifie la valeur de l’hôte avant de diriger la requête vers le serveur virtuel approprié.
L’intérêt d’utiliser un répartiteur de charge pour séparer les hôtes réside dans sa capacité à isoler les domaines en fonction de l’hôte et à les faire évoluer individuellement. Cette approche est plus efficace et peut réduire le nombre de serveurs (matériels et logiciels) nécessaires pour faire évoluer une application. Elle facilite également la planification des capacités, car vous pouvez mieux prévoir la charge que chaque serveur hôte peut gérer à un moment donné.
Cela s’explique par le fait que l’exécution de la logique métier ne nécessite pas les mêmes ressources de calcul que la récupération d’une image. Regrouper différents hôtes au sein d’un même domaine de mise à l’échelle entraîne une charge fluctuante et une capacité imprévisible. Si vous choisissez d’utiliser un répartiteur de charge pour effectuer une simple répartition de charge, le serveur web/applicatif doit alors séparer les hôtes et acheminer les requêtes vers le serveur virtuel approprié. Cette approche présente également les inconvénients propres à une infrastructure partagée : les conflits de versions, l’application de correctifs et les mises à jour des applications peuvent notamment créer des frictions entre les serveurs virtuels.
L’adoption croissante des conteneurs et des microservices favorise le recours à l’équilibrage de charge basé sur l’hôte sous la forme de contrôleurs d’entrée.
Acheminement et retour
Équilibrage de charge de couche 7 (HTTP)
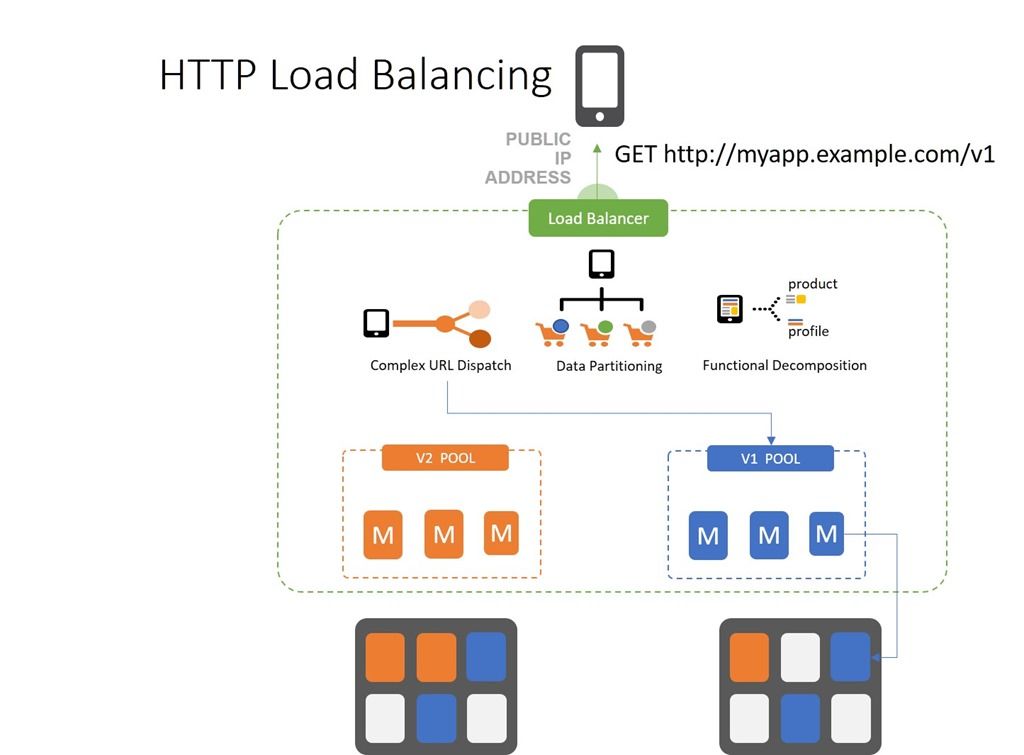
La répartition de charge de couche 7 (HTTP) est celle que je préfère en raison de la polyvalence (agilité ?) qu’elle offre. Vous pouvez répartir les requêtes en fonction de n’importe quel élément HTTP, y compris la charge utile. La plupart des gens limitent (judicieusement, à mon avis) leurs règles de répartition de charge aux informations présentes dans l’en-tête HTTP. Cela inclut notamment l’hôte, la méthode HTTP, le type de contenu, les cookies, les en-têtes personnalisés et l’agent utilisateur.
L’équilibrage de charge HTTP consiste d’abord à acheminer les requêtes, puis à répartir la charge. Un schéma classique d’équilibrage de charge HTTP se présente sous la forme acheminer –> répartir. Cela signifie que l’on détermine d’abord vers quel serveur virtuel une requête doit être dirigée, puis qu’un algorithme sélectionne une ressource dans le pool associé à ce serveur virtuel.
L’équilibrage de charge HTTP permet de mettre en œuvre des modèles tels que le versionnement des API, où la version de l’API est intégrée à l’URI (ou à un en-tête HTTP personnalisé). L’équilibreur de charge peut distinguer les différentes versions et veiller à ce que les clients soient dirigés vers le service back-end approprié pour l’exécution. Cela permet toujours une migration progressive des clients lorsqu’il est impossible d’imposer une mise à niveau.
Ce type de modèle de mise à l’échelle prend également en charge d’autres modèles, tels que la décomposition fonctionnelle et le partitionnement des données. C’est le modèle de mise à l’échelle le plus robuste et le plus agile, qui offre un vaste éventail d’options pour faire évoluer les applications et, de plus en plus, les microservices.
En résumé, il existe cinq grands modèles de mise à l’échelle, dont la plupart peuvent être combinés — et le sont souvent — afin d’optimiser l’utilisation des ressources et d’obtenir les meilleures performances possibles. Si vous n’en utilisez aucun aujourd’hui, il y a de fortes chances que vous le fassiez à l’avenir. Comprendre leur structure de base constitue donc un bon point de départ pour concevoir une architecture évolutive, quels que soient les types d’applications que vous utilisez ou les environnements dans lesquels elles sont déployées.
À vos marques, prêts, scalez !
À propos de l’auteur

Lori MacVittie est ingénieure émérite et évangéliste en chef au sein du bureau du directeur technique de F5. Elle possède une expertise approfondie dans la fourniture d’applications, les stratégies d’automatisation et les infrastructures. Elle est réputée pour sa capacité à rendre la complexité intelligible, qu’elle définisse des garde-fous pour les agents d’IA, analyse des architectures multicloud fragiles ou explore les limites des systèmes évolutifs. Elle cumule plus de trente ans d’expérience dans le secteur, couvrant le développement d’applications, l’architecture informatique ainsi que l’exploitation des réseaux et des systèmes. Avant de rejoindre F5, elle a été rédactrice spécialisée dans les technologies et a reçu plusieurs distinctions. MacVittie est titulaire d’un master en informatique et est une autrice prolifique dont les publications couvrent la sécurité, le cloud et l’architecture d’entreprise. Elle est également une passionnée de jeux de société et de jeux vidéo, et assume pleinement ses avis bien tranchés sur le fromage.
Autres articles de Lori Mac VittieArticles de blog associés

F5 NGINXaaS pour Google Cloud : des applications résilientes et évolutives
Découvrez comment NGINXaaS s’intègre à Google Cloud pour renforcer les performances et la sécurité, et préparer vos applications critiques à un avenir propulsé par l’IA.

L’intégration de F5 Web Application Firewall (WAF) à AWS est disponible dès aujourd’hui
En faisant appel à un partenaire de déploiement AWS WAF tel que F5, vous pouvez renforcer la sécurité de vos applications web grâce à des règles personnalisées qui bloquent les schémas d’attaque courants, comme les injections SQL ou les attaques par scripts intersites (XSS).
Appliquer le principe de Peter Parker à l’inspection TLS
« Un grand pouvoir implique de grandes responsabilités. » Si l’on en trouve des échos chez Voltaire et Churchill, cette citation est surtout connue grâce aux bandes dessinées Spider-Man, où elle est attribuée à l’oncle Ben. Bien entendu, si cette phrase est si répandue dans la culture populaire, c’est notamment parce qu’elle peut s’appliquer à une multitude de situations et de sujets, y compris à l’inspection TLS.
Le NetOps a besoin de défenseurs, pas d’adversaires
Il est important de reconnaître que les équipes NetOps ne sont pas toujours celles qui font obstacle au déploiement de la dernière nouveauté, application ou service. Les freins à la rapidité sont souvent dus au fait que les organisations n’adoptent pas tous les principes du DevOps lorsqu’elles cherchent à transformer leurs opérations informatiques.
Mise à jour des services applicatifs : sécurité, rapidité et visiteurs suspects
Il est de nouveau temps de nous pencher sur les services applicatifs que les entreprises utilisent réellement pour rendre leurs applications plus rapides et plus sûres. On constate notamment une hausse du recours aux services de protection contre les bots, ainsi que la progression lente mais régulière de HTTP/2. Bien qu’il ne s’agisse pas d’une application…
Les templates prennent le contrôle du cloud
Les modèles s’imposent dans le cloud. Lisez le blog de F5 pour découvrir comment l’infrastructure en tant que code et les API déclaratives automatisent la mise à disposition des applications.