Les fournisseurs de services ont toujours surveillé de près les performances des réseaux. Le débit et la latence restent importants, mais ils n’indiquent pas aux opérateurs la quantité d’infrastructure nécessaire pour atteindre ces performances.
La consommation de processeur et de mémoire influe sur les besoins en serveurs, la densité des charges de travail, l’alimentation électrique, le refroidissement et la capacité restante pour les autres services. Ces facteurs prennent une importance croissante à mesure que davantage de fonctions réseau migrent vers des environnements Kubernetes.
F5 a chargé The Tolly Group d’évaluer de manière indépendante l’efficacité de l’infrastructure et les performances de F5 BIG-IP Cloud-Native Edition par rapport à un déploiement testé de fonction réseau virtuelle, ou VNF. Les deux solutions ont été évaluées dans un environnement Red Hat OpenShift à l’aide de deux charges de travail représentatives des fournisseurs de services : le traitement des requêtes DNS et la couche 4 avec NAT de classe opérateur, ou L4+CGNAT.
Tolly a mesuré le débit et la latence, ainsi que l’utilisation du processeur et de la mémoire. L’objectif était de déterminer la charge de travail utile que chaque déploiement pouvait prendre en charge et les ressources d’infrastructure nécessaires à cette fin.
Mesurer l’infrastructure au service des performances
Les résultats des tests montrent pourquoi il est pertinent d’examiner la consommation des ressources en complément des indicateurs de performance traditionnels.
Dans un environnement Kubernetes, les ressources de processeur et de mémoire inutilisées peuvent rester à la disposition de la plateforme pour planifier d’autres charges de travail, selon les politiques de gestion des ressources du cluster. Une consommation moindre des ressources peut donc offrir aux opérateurs davantage de souplesse dans l’utilisation de l’infrastructure déjà déployée.
Les deux charges de travail Tolly ont présenté des profils de performances différents, mais toutes deux ont permis de réduire considérablement les besoins en ressources processeur de BIG-IP Cloud-Native Edition dans la configuration testée.
DNS : un débit supérieur avec moins de ressources processeur
Le DNS est un service à fort volume qui doit traiter rapidement un grand nombre de transactions relativement petites. Le test DNS de Tolly a utilisé la fonctionnalité DNS Express de BIG-IP et mesuré le débit soutenu des requêtes, l’utilisation du processeur, l’efficacité de la mémoire et la latence moyenne.
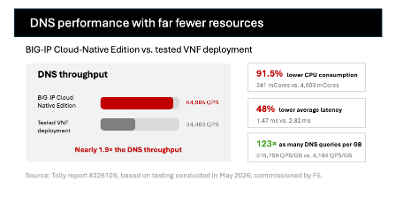
BIG-IP Cloud-Native Edition a traité de manière soutenue 64 985 requêtes DNS par seconde, contre 34 463 requêtes par seconde pour la VNF testée. Cela représente un débit de requêtes DNS près de 1,9 fois supérieur.
Les besoins en CPU étaient également très différents. BIG-IP Cloud-Native Edition a consommé 341 mCores, contre 4 003 mCores pour la VNF, soit pratiquement toutes les ressources CPU des quatre cœurs alloués au test. CNE a donc utilisé 91,5 % de CPU en moins dans la configuration testée.
La latence DNS moyenne était de 1,47 milliseconde pour CNE, contre 2,82 millisecondes pour la VNF, soit une réduction de 48 %.
Tolly a également normalisé les performances DNS par rapport à la consommation de mémoire. BIG-IP Cloud-Native Edition a traité 515 759 requêtes par seconde et par gigaoctet de mémoire, contre 4 194 pour la VNF, soit 123 fois plus de requêtes DNS par gigaoctet de mémoire lors du test.
Pour les opérateurs qui exploitent des services DNS à fort volume, la question concrète est de savoir quelle infrastructure est nécessaire pour prendre en charge une charge de travail donnée. Des besoins moindres en processeur et en mémoire permettent de libérer davantage de capacité dans l’environnement Kubernetes pour des services supplémentaires ou une croissance future.
L4+CGNAT : débit similaire, moins de ressources
Le test L4+CGNAT a donné un résultat différent.
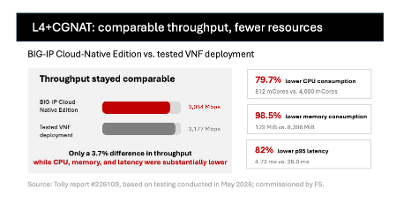
Les deux déploiements ont fourni un débit d’environ 3 Gbit/s. BIG-IP Cloud-Native Edition a maintenu un débit de 3 064 Mbit/s, tandis que la VNF testée a atteint 3 177 Mbit/s, soit un résultat supérieur d’environ 3,7 % pour la VNF.
L’écart en matière de consommation des ressources d’infrastructure était nettement plus important.
BIG-IP Cloud-Native Edition a utilisé 812 mCores, contre 4 000 mCores pour la VNF. Cela représente une consommation de CPU inférieure de 79,7 %.
La consommation de mémoire était de 129 Mio pour BIG-IP Cloud-Native Edition, contre 8 396 Mio pour la VNF, soit une réduction de 98,5 % dans la configuration testée.
Tolly a également mesuré une latence p95 de 4,73 millisecondes pour BIG-IP Cloud-Native Edition, contre 26 millisecondes pour la VNF, soit une réduction de 82 %.
Dans l’environnement testé, l’écart de débit est resté inférieur à 3,7 %, tandis que BIG-IP Cloud-Native Edition a utilisé nettement moins de ressources processeur et de mémoire, tout en offrant une latence p95 plus faible.
Pourquoi l’efficacité des ressources est importante
Les environnements des fournisseurs de services doivent souvent prendre en charge d’importants volumes de trafic sur des infrastructures dont les ressources en processeur, en mémoire, en énergie et en capacité physique sont limitées.
L’efficacité des ressources peut influer sur le nombre de charges de travail qu’un cluster peut accueillir, sur la capacité restant disponible pour de nouveaux services et sur la quantité d’infrastructure nécessaire à mesure que la demande augmente.
C’est là que les résultats de Tolly sont les plus utiles. DNS et L4+CGNAT sont deux charges de travail représentatives qui ont été sélectionnées pour faire l’objet de tests indépendants. Elles ne représentent pas toutes les fonctions disponibles dans BIG-IP Cloud-Native Edition, mais fournissent des exemples concrets de la manière dont un modèle de déploiement natif de Kubernetes peut modifier le profil d’utilisation des ressources des services réseau. Ces conclusions doivent donc être considérées comme des résultats propres aux charges de travail et aux configurations testées, et non comme des affirmations concernant les performances d’autres services BIG-IP Cloud-Native Edition.
Les résultats fournissent également aux opérateurs d’autres indicateurs à prendre en compte lors de l’évaluation de l’architecture des fonctions réseau. Le débit reste essentiel, mais l’utilisation du processeur et de la mémoire, ainsi que la latence, permettent de mesurer les ressources d’infrastructure nécessaires pour atteindre ce débit.
Pour les fournisseurs de services qui prévoient de déployer des services réseau basés sur Kubernetes, ces informations peuvent éclairer les décisions relatives à la planification des capacités, au placement des charges de travail et à l’utilisation de l’infrastructure.
Pour en savoir plus, consultez le rapport complet de Tolly Group afin de découvrir une évaluation indépendante de l’efficacité de F5 BIG-IP Cloud-Native Edition en matière d’infrastructure pour les fournisseurs de services. Consultez également notre article de blog, Modernisation cloud native à l’ère de l’IA et de la 5G/6G.
À propos de l’auteur
Articles de blog associés

F5 rejoint le projet PQC du NIST pour contribuer à l’élaboration de normes résistantes aux attaques quantiques
En rejoignant le consortium du projet « Migration to PQC » du NIST, F5 contribue à élaborer des recommandations pratiques pour un monde résistant aux menaces quantiques.

La dernière version de F5 Distributed Cloud Bot Defense offre des fonctionnalités et des améliorations de nouvelle génération
Les mises à jour de la console de F5 Distributed Cloud Bot Defense améliorent la gestion des menaces automatisées et l’intégration dans des cadres de sécurité plus larges.

La nouvelle surface de risque liée à l’IA : invisible, autonome et déjà à l’intérieur
James White, vice-président de l’ingénierie chez F5 À mi-parcours de l’année 2025, le moment est bien choisi pour dresser un état des lieux de l’adoption de l’IA en entreprise et de la sécurité de l’IA. L’utilisation de l’IA générative est désormais la norme dans les entreprises De manière générale, les entreprises possèdent au moins une compréhension élémentaire de l’IA générative. Elles savent ce qu’elle est et où elle peut […]
Évaluation des LLM : renforcer la confiance grâce à la notation de sécurité
À mesure que l’adoption de l’IA s’accélère dans les entreprises, l’évaluation des LLM ne porte plus uniquement sur leurs performances, mais aussi sur la confiance qu’ils inspirent. Les équipes de sécurité doivent évaluer non seulement les performances d’un modèle, mais aussi la sûreté de son comportement. Pourtant, la plupart des cadres d’évaluation se concentrent sur des critères de précision, laissant les facteurs de sécurité et de risque dans le flou ou sans mesure.
Évaluer le niveau de préparation de votre organisation à la sécurité de l’IA
Dans un paysage de l’intelligence artificielle (IA) en constante évolution, il est non seulement important, mais impératif de savoir si votre organisation est prête à instaurer et à soutenir une culture de la sécurité de l’IA. À mesure que les technologies d’IA progressent, elles font émerger une multitude de nouveaux défis de sécurité qui, pour être gérés efficacement, exigent une approche réfléchie, globale et proactive […]
Déployer des LLM en entreprise : via une API dans un cloud privé
Pris isolément, sans mesures de protection spécialisées ni protocoles de sécurité en place, le déploiement de modèles d’IA générative (GenAI), en particulier de grands modèles de langage (LLM), à l’échelle de l’entreprise représente pour toute organisation une opportunité à haut risque, mais potentiellement très rentable. La manière précise dont votre organisation doit franchir ce grand pas dans l’univers de la GenAI nécessite une planification mûrement réfléchie. Peut-être serait-il […]