Há anos, a segmentação de rede tem sido o elemento central que viabiliza o isolamento de ameaças, a diferenciação da qualidade de serviço, a resposta a incidentes e sua análise, as auditorias de conformidade e muitas outras funções essenciais de interoperabilidade. No entanto, ao exaltarmos os princípios de confiança zero e nos apressarmos para implantar a IA, será que negligenciamos esse elemento fundamental da infraestrutura de rede, que serve de alicerce para as operações modernas de cibersegurança e de serviços?
Anteriormente, em nossa série sobre fábricas de IA, definimos uma fábrica de IA como um investimento de grande porte em armazenamento, redes e computação para atender a requisitos de treinamento e inferência de alto volume e alto desempenho. Para obter retorno sobre esse investimento, as fábricas de IA programam dinamicamente o uso de unidades de processamento gráfico (GPUs) de alto valor e de recursos computacionais para realizar esse treinamento e essa inferência. O agendamento das GPUs exige a criação de vários “locatários” de serviços de IA por cluster de IA. Isso gera um problema que muitas equipes de operações só percebem quando já é tarde demais.
Alinhamento dos recursos de cluster da fábrica de IA com a segmentação de rede
Em um cluster de IA, podemos segmentar logicamente os recursos usando um contexto de locatário, o que permite definir cotas por locatário, limites de consumo de recursos, segurança do sistema host e controle de acesso baseado em função (RBAC) para o gerenciamento. No entanto, os contextos de locatário não são expostos pelos serviços básicos de rede que fornecem entrada e saída de tráfego entre o cluster de IA e o restante da rede da fábrica de IA. Sem esse contexto, a segmentação de rede, que é a base da segurança cibernética no data center, opera às cegas. Os métodos comuns para expor os contextos de locatário necessários reduzem significativamente a capacidade computacional de alto valor da fábrica de IA ou tornam os caminhos de rede lentos demais para atender aos limites exigidos de latência, largura de banda ou simultaneidade dos serviços. Somos forçados a escolher entre alternativas inadequadas: utilizar com eficiência os recursos de alto valor da fábrica de IA ou integrar corretamente os locatários à rede.
Nas infraestruturas de nuvem pública, as arquiteturas de rede multilocatário orquestradas são a base de todos os serviços de uma região de nuvem e são implementadas com nuvens privadas virtuais (VPCs). Essa segmentação de rede virtualizada é essencial para a segurança e a medição do uso de recursos. Os provedores de nuvem pública mantêm essa funcionalidade com equipes de desenvolvedores de software de rede e hardware de rede especializado, incluindo SmartNICs e unidades de processamento de dados (DPUs). Os clusters de fábricas de IA em nuvens públicas são projetados para aproveitar a orquestração de rede VPC da infraestrutura subjacente. O custo de manutenção das VPCs é bastante elevado, mas elas são fundamentais para o modelo de negócios da nuvem pública.
Surge então a questão: como uma organização pode maximizar seu investimento em uma fábrica de IA e alocar dinamicamente GPUs e recursos computacionais sem investir tanto quanto um provedor de nuvem pública?
A primeira etapa do setor nessa jornada foi usar a virtualização de servidores para criar máquinas virtuais (VMs). As VMs utilizam o passthrough de hardware para se conectar a redes segmentadas de data centers. Basta colocar todas as máquinas virtuais nas mesmas VLANs para continuarmos operando normalmente, caso estejamos lidando apenas com um único locatário em um único cluster de IA.
As VMs também podem lidar com a segmentação de GPUs, pois os fornecedores oferecem maneiras de subdividir os dispositivos de GPU em conjuntos de núcleos e memória e, em seguida, atribuí-los a máquinas virtuais específicas. No entanto, a segmentação de dispositivos de GPU não é dinâmica e exige a reinicialização da VM. Além disso, esse projeto limita a capacidade de criar um pool de recursos de GPU cujo uso possa ser medido entre vários locatários. Essas são desvantagens significativas dessa solução.
Alinhamento da segmentação de rede com clusters de fábricas de IA multilocatário
O que acontece com nossos clusters de fábricas de IA quando eles deixam de atender a apenas um locatário? O problema passa para o data center. Por padrão, nos clusters de fábricas de IA, todo o tráfego de rede de saída para o data center passa por uma tradução do endereço de rede de origem (SNAT) para o endereço IP do nó específico do cluster no qual está sendo executada a carga de trabalho em contêiner que faz a solicitação de rede, mascarando efetivamente a verdadeira origem. O tráfego passa então a ter como origem um segmento de rede no qual esse nó foi implantado. Em um cluster multilocatário, isso significa que perdemos o contexto do locatário e ficamos com um fluxo misto de tráfego de saída de vários locatários, impossível de separar, proteger, solucionar problemas ou auditar.
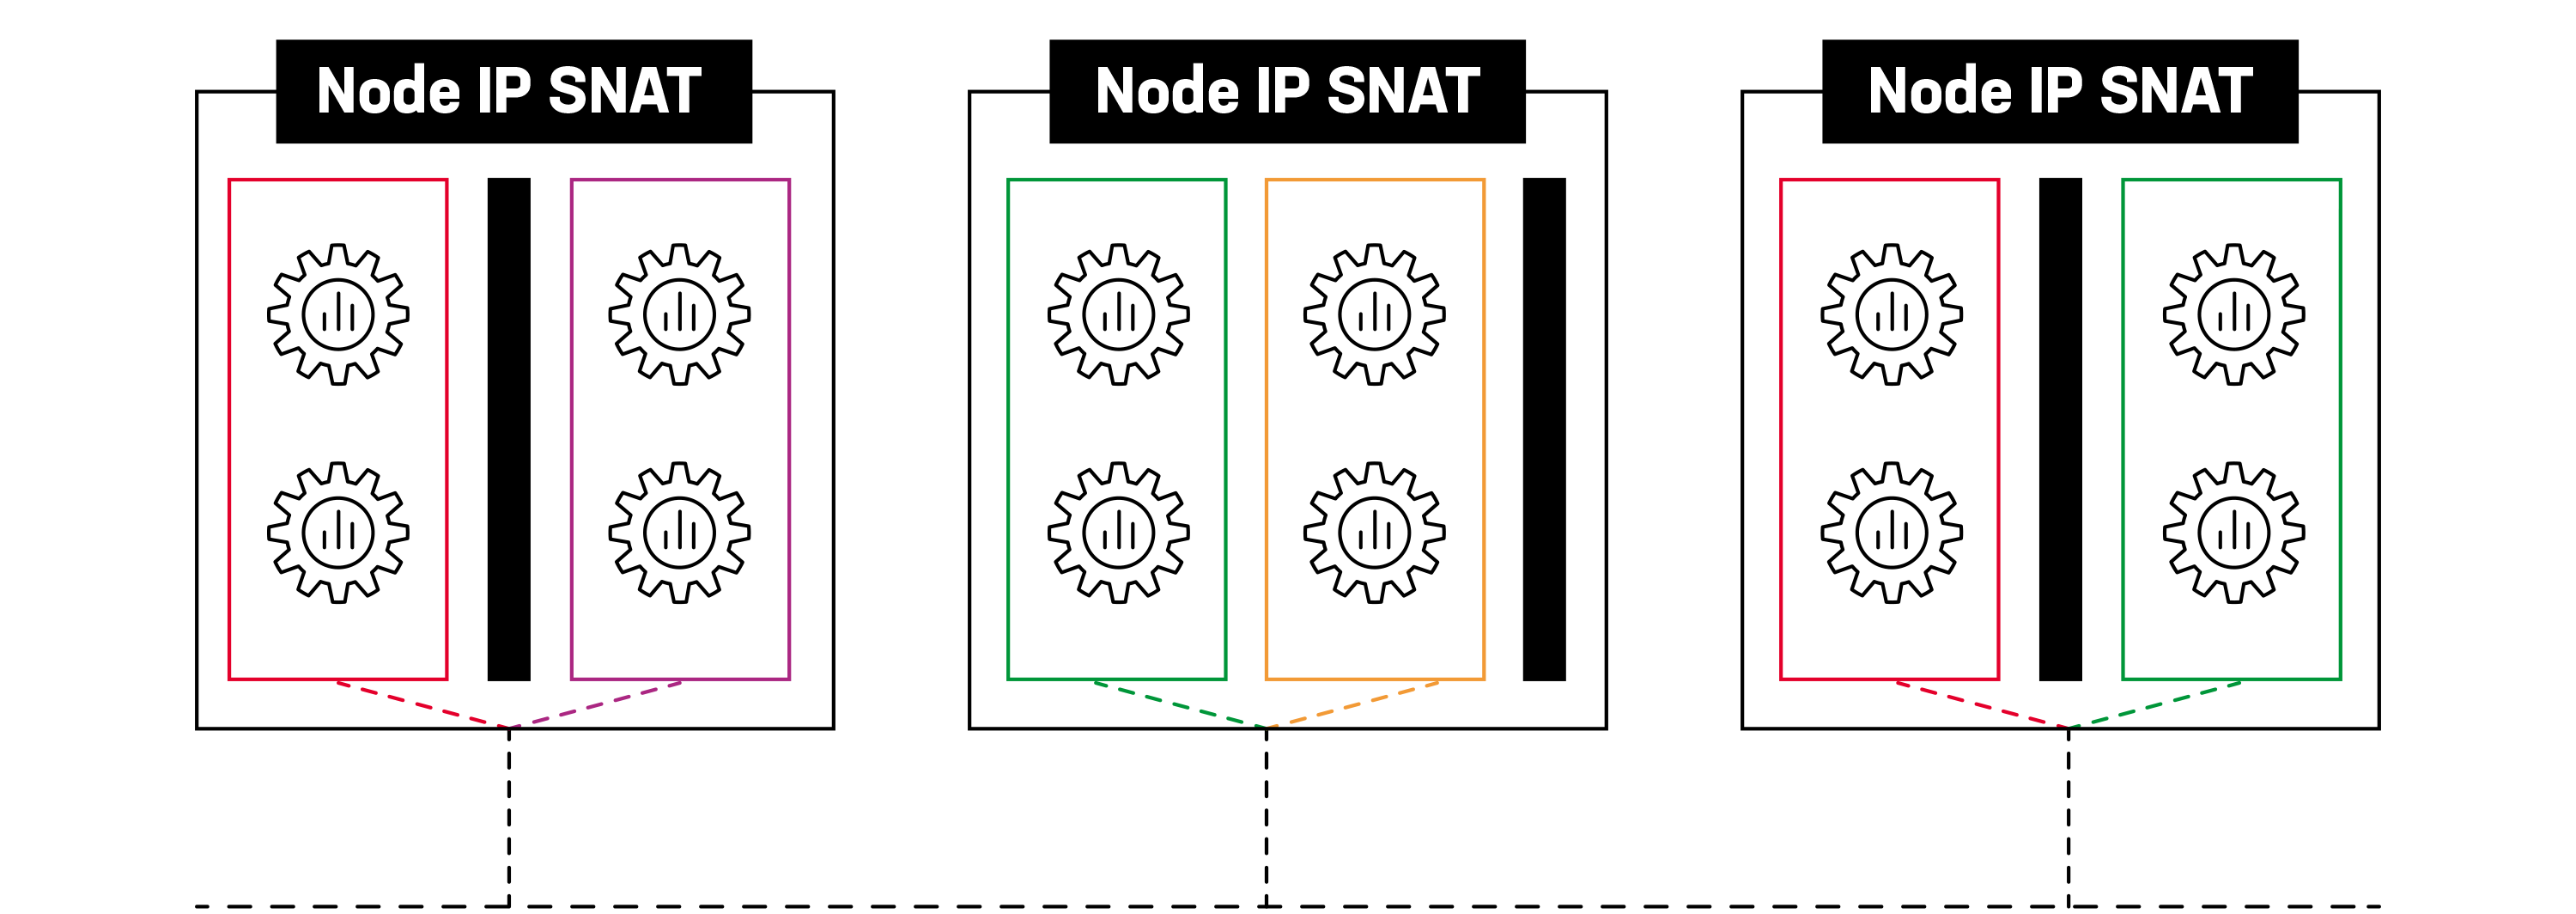
Por padrão, o contexto do tenant do cluster é perdido na saída.
Esse problema se intensifica quando o tráfego de entrada é incluído. Embora esse tráfego possa ser mais fácil de gerenciar por ser direcionado a partir de um data center já segmentado, como correlacionar o tráfego de entrada de um único tenant ao seu tráfego de saída? A resposta está na geração aumentada por recuperação (RAG) e nos serviços agênticos, que se comunicam intensamente para obter dados externos e utilizar serviços externos. Isso exige um esforço conjunto entre equipes, com engenheiros de plataforma e profissionais de NetOps identificando um problema para um cliente ou tentando obter aprovação em auditorias de segurança.
As empresas podem se perguntar: “Por que não podemos simplesmente usar uma tecnologia de sobreposição de rede definida por software (SDN) e criar redes VPC como fazem os hiperescaladores?” Isso certamente é possível, mas transfere os custos para a manutenção de redes VPC baseadas em SDN sobre a infraestrutura existente do data center. Se for desejada a segmentação de camada 2 (por exemplo, VxLAN), o problema passa a ser a orquestração de túneis com switches de topo de rack e o provisionamento desses switches de acordo com a segmentação da rede. É por isso que os hiperescaladores optaram por SmartNICs e migraram para a orquestração no nível de host a host, mantendo as redes dos data centers rápidas e sem inteligência.
A maioria das organizações não dispõe de profissionais qualificados em programação de redes nem deseja assumir uma orquestração tão complexa no nível dos hosts, ou simplesmente não pode abrir mão da visibilidade da rede de backbone necessária para garantir a qualidade do serviço. As soluções de roteamento de camada 3 (por exemplo, IP) propostas para esses problemas levaram as equipes de rede a transformar cada nó do cluster de IA em um par de roteamento dinâmico (BGP) do data center, com vários refletores de rotas tentando fornecer uma segmentação básica de sub-redes IP por locatário. Isso também expõe os operadores a problemas de roteamento e auditorias de segurança extremamente complexos e já resultou em interrupções em regiões inteiras.
Segmentação de rede orquestrada e ciente do cluster para fábricas de IA
As fábricas de IA devem planejar uma solução de rede rica em recursos, programável, segura e de baixa latência, que seja escalável tanto em largura de banda quanto em simultaneidade. Os contextos de locatários na Camada 2 (por exemplo, VLANs e VxLAN) e na Camada 3 (por exemplo, sub-redes e interfaces IPSEC) devem ser disponibilizados de dentro de um cluster para a rede da fábrica de IA. Métricas de observabilidade, logs e ferramentas de depuração devem estar disponíveis para a equipe de NetOps.
Tradicionalmente, muitas dessas soluções de multilocação e visibilidade de aplicações são fornecidas pelo F5 BIG-IP. O F5 BIG-IP Container Ingress Services (CIS) descobre dinamicamente os serviços do Kubernetes e os disponibiliza aos data centers como servidores virtuais, um objeto de configuração com o qual os administradores do BIG-IP estarão familiarizados por configurá-lo para disponibilizar servidores físicos e máquinas virtuais. Embora o BIG-IP atenda a muitos dos requisitos que buscamos em uma solução, ele não gerencia o tráfego de saída do cluster de IA para a rede da fábrica de IA, o que é necessário para manter a segmentação.
Para resolver esse problema, desenvolvemos F5 BIG-IP Next for Kubernetes, uma solução para clusters de computação multilocatários criada com base em nossa plataforma de última geração BIG-IP Next.
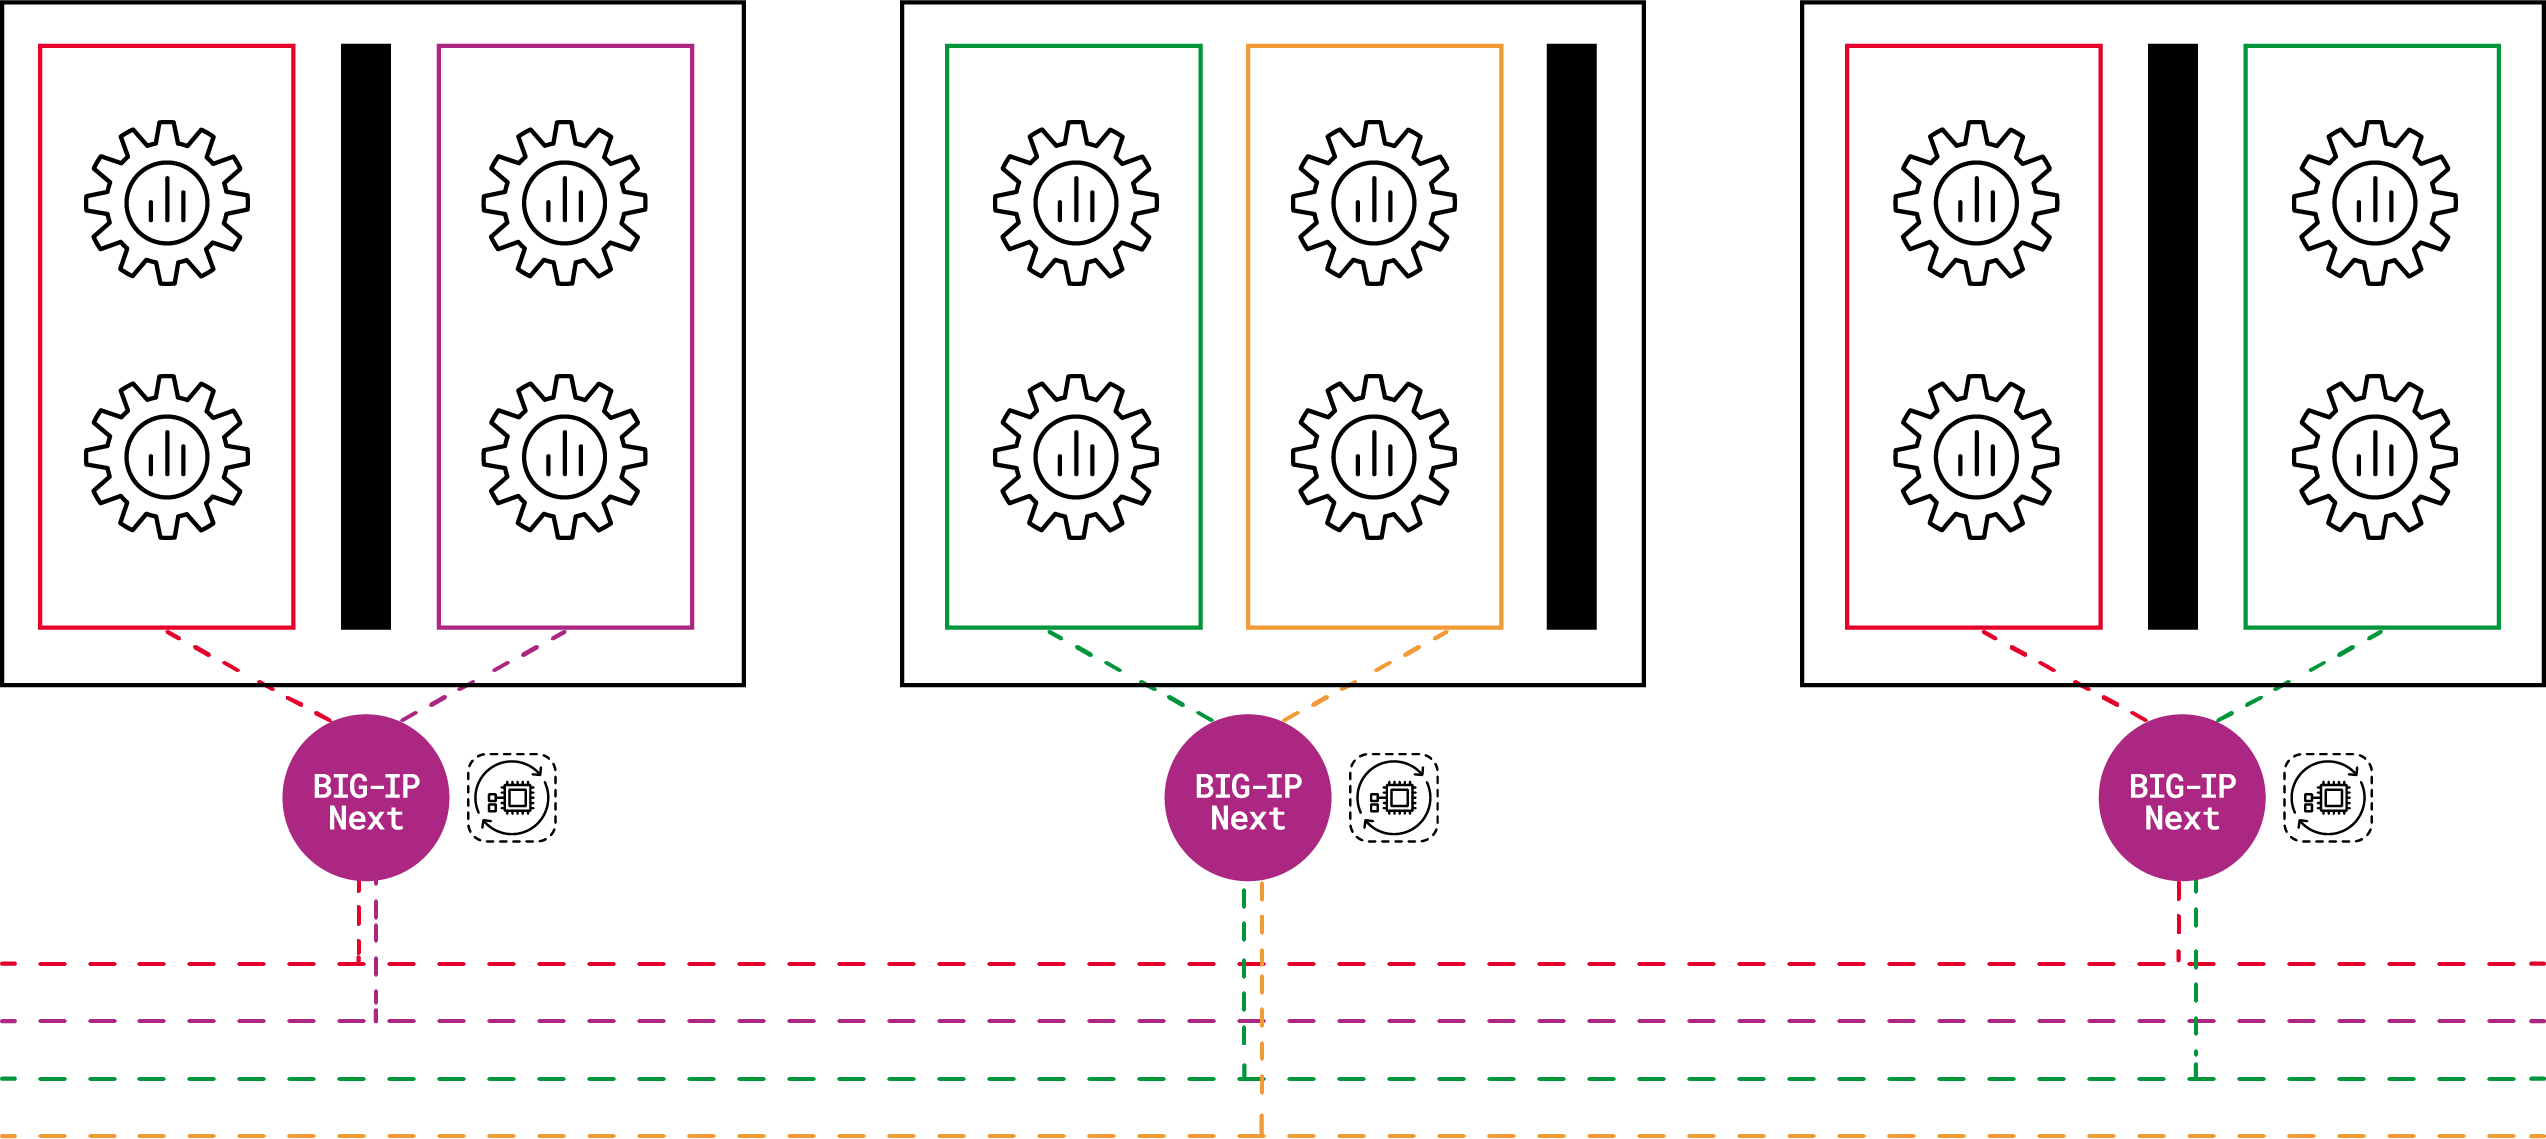
O BIG-IP Next for Kubernetes permite que as equipes de NetOps associem os tenants do cluster a segmentos de rede.
O BIG-IP Next for Kubernetes é totalmente gerenciado por meio do plano de controle do Kubernetes, oferece suporte à autenticação de gerenciamento do Kubernetes e ao RBAC para todos os recursos declarados, além de reconhecer a multilocação do Kubernetes por meio de namespaces para viabilizar a segmentação de rede necessária para o tráfego de entrada e de saída. Isso é fundamental para arquiteturas que priorizam a orquestração, como fábricas de IA.
BIG-IP Next for Kubernetes oferece uma maneira simplificada para as equipes de NetOps definirem os mapeamentos entre namespaces do Kubernetes e segmentos de rede. O emparelhamento dinâmico de rotas entre a rede da fábrica de IA e as instâncias do BIG-IP Next usa uma sintaxe conhecida de configuração de rotas. As equipes de NetOps têm a capacidade exclusiva de solucionar problemas com segurança em fluxos de rede ativos de entrada e saída do cluster. As equipes de SecOps obtêm listas de controle de acesso (ACLs) de firewall para o tráfego de entrada e saída de cada locatário do cluster, além de recursos de proteção contra negação de serviço distribuída (DDoS) e IPS.
Para as equipes de engenharia de plataforma, o BIG-IP Next for Kubernetes reduz a carga sobre os recursos computacionais ao transferir funções de rede, como o processamento do tráfego de entrada e saída de dados, bem como o NAT de origem e o firewall. Isso ajuda a reduzir os custos operacionais, mantendo os serviços disponíveis e eficientes.
BIG-IP Next for Kubernetes também oferece suporte à Kubernetes Gateway API, a primeira API de entrada da comunidade projetada para funções organizacionais específicas em NetOps, engenharia de plataforma, DevOps e MLOps. Por meio da Gateway API, BIG-IP Next for Kubernetes amplia os serviços de entrada típicos baseados em portas da Camada 4 ou em rotas HTTP(S) da Camada 7, oferecendo um conjunto de recursos para DevOps/MLOps, especificamente TCPRoute, UDPRoute, HTTPRoute, TLSRoute e GRPCRoute — todos controlados pela mesma automação de CI/CD nas principais estruturas de IA.
Do ponto de vista do gerenciamento, o BIG-IP Next for Kubernetes permite que as equipes de NetOps, SecOps, engenharia de plataforma, DevOps e MLOps trabalhem juntas de forma eficaz por meio de declarações da API do Kubernetes. Ele oferece tudo o que você espera do BIG-IP, mas sob a perspectiva do Kubernetes e com suporte à segmentação de rede.
A ascensão da DPU
As unidades de processamento de dados (DPUs) ganharam enorme relevância nas fábricas de IA. Conforme definido em uma publicação anterior da nossa série sobre fábricas de IA, uma DPU é um processador programável projetado para lidar com a movimentação e o processamento de grandes volumes de dados por meio de aceleração de hardware à velocidade de linha da rede. Por meio da inovação de produtos na F5 e da colaboração com a NVIDIA, lançamos o BIG-IP Next for Kubernetes para descarregar os fluxos de dados do tráfego de entrada e saída, oferecendo suporte à segmentação de rede e a funções de segurança por meio da implantação nas DPUs NVIDIA BlueField-3 usando as APIs DOCA da NVIDIA. Isso maximiza o investimento em uma fábrica de IA ao garantir que os clusters de IA sejam “abastecidos com dados”.
Fábricas de IA impulsionadas pela F5
Ao investir em fábricas de IA, é imprescindível garantir que a infraestrutura seja otimizada, eficiente e escalável. O F5 BIG-IP Next for Kubernetes implantado em DPUs NVIDIA BlueField-3 fornece a segmentação de rede necessária para o agendamento dinâmico de GPUs e recursos computacionais, além de oferecer escalabilidade de alto desempenho para maximizar o retorno sobre os investimentos em IA. Para saber mais, entre em contato com a F5 para falar com seu gerente de contas e engenheiro ou arquiteto de soluções da F5.
Quer saber mais sobre fábricas de IA? Confira outros artigos da nossa série de posts sobre fábricas de IA:
- O que é uma fábrica de IA? ›
- Geração Aumentada por Recuperação (RAG) para fábricas de IA ›
- Otimize o gerenciamento de tráfego para a ingestão de dados da fábrica de IA ›
- Conectando fontes de dados de edge a fábricas de IA de forma otimizada ›
- Escalabilidade e flexibilidade multicloud dão suporte às fábricas de IA ›
- O poder e a importância da DPU NVIDIA BlueField para fábricas de IA ›
- Proteção de APIs para fábricas de IA: o primeiro passo para a segurança da IA ›
- Fábricas de IA produzem os aplicativos mais modernos da atualidade: aplicativos de IA ›
Sobre o autor
Publicações relacionadas no blog

Entrega e proteção de agentes de IA em fábricas de IA: F5 para a arquitetura de referência NVIDIA OpenShell para agentes de IA seguros
As soluções da F5 ampliam a Arquitetura de Referência NVIDIA OpenShell para agentes de IA seguros.

Como medir – e minimizar – o custo total de propriedade do seu Kubernetes
O Kubernetes pode ser baixado e executado gratuitamente, mas sua manutenção está longe de não ter custos. Assim como outras grandes plataformas de código aberto que são “gratuitas” apenas em um sentido simplista, o Kubernetes quase certamente exigirá investimentos para ser implantado e operado.
As-Code: a pilha de TI contínua
Infraestrutura, configuração, pipeline, operações. De repente, tudo é “como código”. Lori MacVittie busca esclarecer a terminologia e identificar os diferentes componentes de uma stack contínua de TI.
O estado da entrega de aplicações em 2017: automação, APIs e DevOps
Explore o relatório State of Application Delivery de 2017. Leia o blog retrospectivo da F5 sobre o início da ascensão das redes declarativas e dos pipelines de DevOps.
DevOps Summit: onde a rede foi convidada para a festa
No DevOps Summit NY, falou-se muito não apenas sobre DevOps, mas também sobre contêineres, IoT e microsserviços. As sessões se concentraram não só na mudança cultural necessária para crescer em escala com uma abordagem DevOps, mas também fizeram questão de incluir...
F5 e Nutanix convergem em infraestrutura no .NEXT
Aplicações empresariais como Microsoft SharePoint e Exchange, juntamente com a VDI, continuam sendo a espinha dorsal da sua empresa. A produtividade, embora não seja tão atraente quanto o lucro, é um fator essencial para o sucesso das operações empresariais atuais. Deixar de...