Este post faz parte de uma série sobre fábricas de IA. Quando terminar de lê-lo, confira os outros posts da série.
- Geração Aumentada por Recuperação (RAG) para fábricas de IA ›
- Otimize o gerenciamento de tráfego para ingestão de dados em fábricas de IA ›
- Conectando de forma otimizada fontes de dados de edge a fábricas de IA ›
- Escalabilidade e flexibilidade multicloud dão suporte às fábricas de IA ›
- O poder e o significado da DPU NVIDIA BlueField para fábricas de IA ›
- Proteção de APIs para fábricas de IA: o primeiro passo para a segurança da IA ›
- A importância da segmentação de rede para fábricas de IA ›
- Fábricas de IA produzem os aplicativos mais modernos entre os modernos: aplicativos de IA ›
Quando o ChatGPT foi lançado, em novembro de 2022, as perguntas que fazíamos e os prompts que inseríamos eram simples: "Conte-me uma história sobre X" e "Escreva uma narrativa entre a pessoa A e a pessoa B sobre o tema Z". Por meio dessas perguntas e das interações iniciais com o GPT-3.5 na época, tentávamos entender como essa nova tecnologia em alta afetaria nosso dia a dia. Agora, no fim de 2024, a IA complementa nossas vidas: ajuda a depurar e escrever código, compilar e resumir dados e dirigir veículos autônomos, para citar apenas alguns exemplos. Esses são resultados de uma fábrica de IA moderna, e estamos apenas no começo.
Este artigo, o primeiro de uma série sobre fábricas de IA, explora os componentes de uma fábrica de IA e como os diferentes elementos trabalham em conjunto para gerar soluções baseadas em IA em larga escala.
Definição de fábricas de IA
Em meio à evolução da IA, o conceito de fábrica de IA surgiu como uma analogia para a forma como modelos e serviços de IA são criados, aprimorados e implantados. Assim como uma fábrica tradicional recebe matérias-primas e as transforma em produtos acabados, uma fábrica de IA representa um enorme investimento em armazenamento, redes e computação para atender a requisitos de treinamento e inferência de alto volume e alto desempenho.
“Uma fábrica de IA é um investimento de grande porte em armazenamento, redes e computação, destinado a atender aos requisitos de treinamento e inferência de alto volume e alto desempenho.”
Dentro dessas fábricas, redes de servidores, unidades de processamento gráfico (GPUs), unidades de processamento de dados (DPUs) e hardware especializado trabalham em conjunto para processar grandes volumes de dados, executando algoritmos complexos que treinam modelos de IA para alcançar altos níveis de precisão e eficiência. Essas infraestruturas são meticulosamente projetadas para lidar com a enorme capacidade computacional necessária para treinar modelos em larga escala e implantá-los para inferência em tempo real. Elas incorporam soluções avançadas de armazenamento para gerenciar e recuperar conjuntos de dados massivos, garantindo um fluxo contínuo de dados.
O balanceamento de carga e a otimização da rede maximizam o desempenho e a utilização de recursos, evitando gargalos e garantindo a escalabilidade. Essa orquestração de componentes de hardware e software permite que as fábricas de IA produzam modelos de IA de última geração e os aprimorem continuamente, adaptando-os a novos dados e à evolução dos requisitos. Em última análise, uma fábrica de IA representa a industrialização do desenvolvimento de IA, fornecendo a infraestrutura robusta necessária para dar suporte à próxima geração de aplicações inteligentes.
Por que as fábricas de IA são importantes?
Como disse Jensen Huang, CEO da NVIDIA, no evento Dreamforce 2024 da Salesforce: “Em nenhum outro momento da história a tecnologia da computação avançou mais rapidamente do que a Lei de Moore”. E continuou: “Estamos avançando muito mais rápido do que a Lei de Moore — pode-se dizer, sem exagero, que estamos no ritmo da Lei de Moore ao quadrado.”
A implantação de IA em escala está se tornando cada vez mais essencial, pois os investimentos em IA funcionam como importantes diferenciais de mercado e impulsionadores da eficiência operacional. Para isso, as organizações precisam desenvolver e aprimorar modelos continuamente, além de integrar repositórios de conhecimento e dados em tempo real. O conceito de fábrica de IA ressalta que a IA deve ser um investimento contínuo, e não uma iniciativa pontual. Ele oferece uma estrutura para que as organizações operacionalizem suas iniciativas de IA, tornando-as mais adaptáveis às mudanças nas demandas empresariais e de mercado.
Componentes de uma fábrica de IA
Com base em nossa experiência em ajudar clientes a implantar, em escala, conjuntos de aplicações modernas, seguras e de alto desempenho, a F5 desenvolveu um Framework de Arquitetura de Referência para IA. Considerando que as aplicações de IA são as mais modernas entre as aplicações modernas, altamente conectadas por meio de APIs e amplamente distribuídas, esse framework aborda os desafios críticos de desempenho, segurança e operação essenciais para disponibilizar aplicações de IA de última geração.
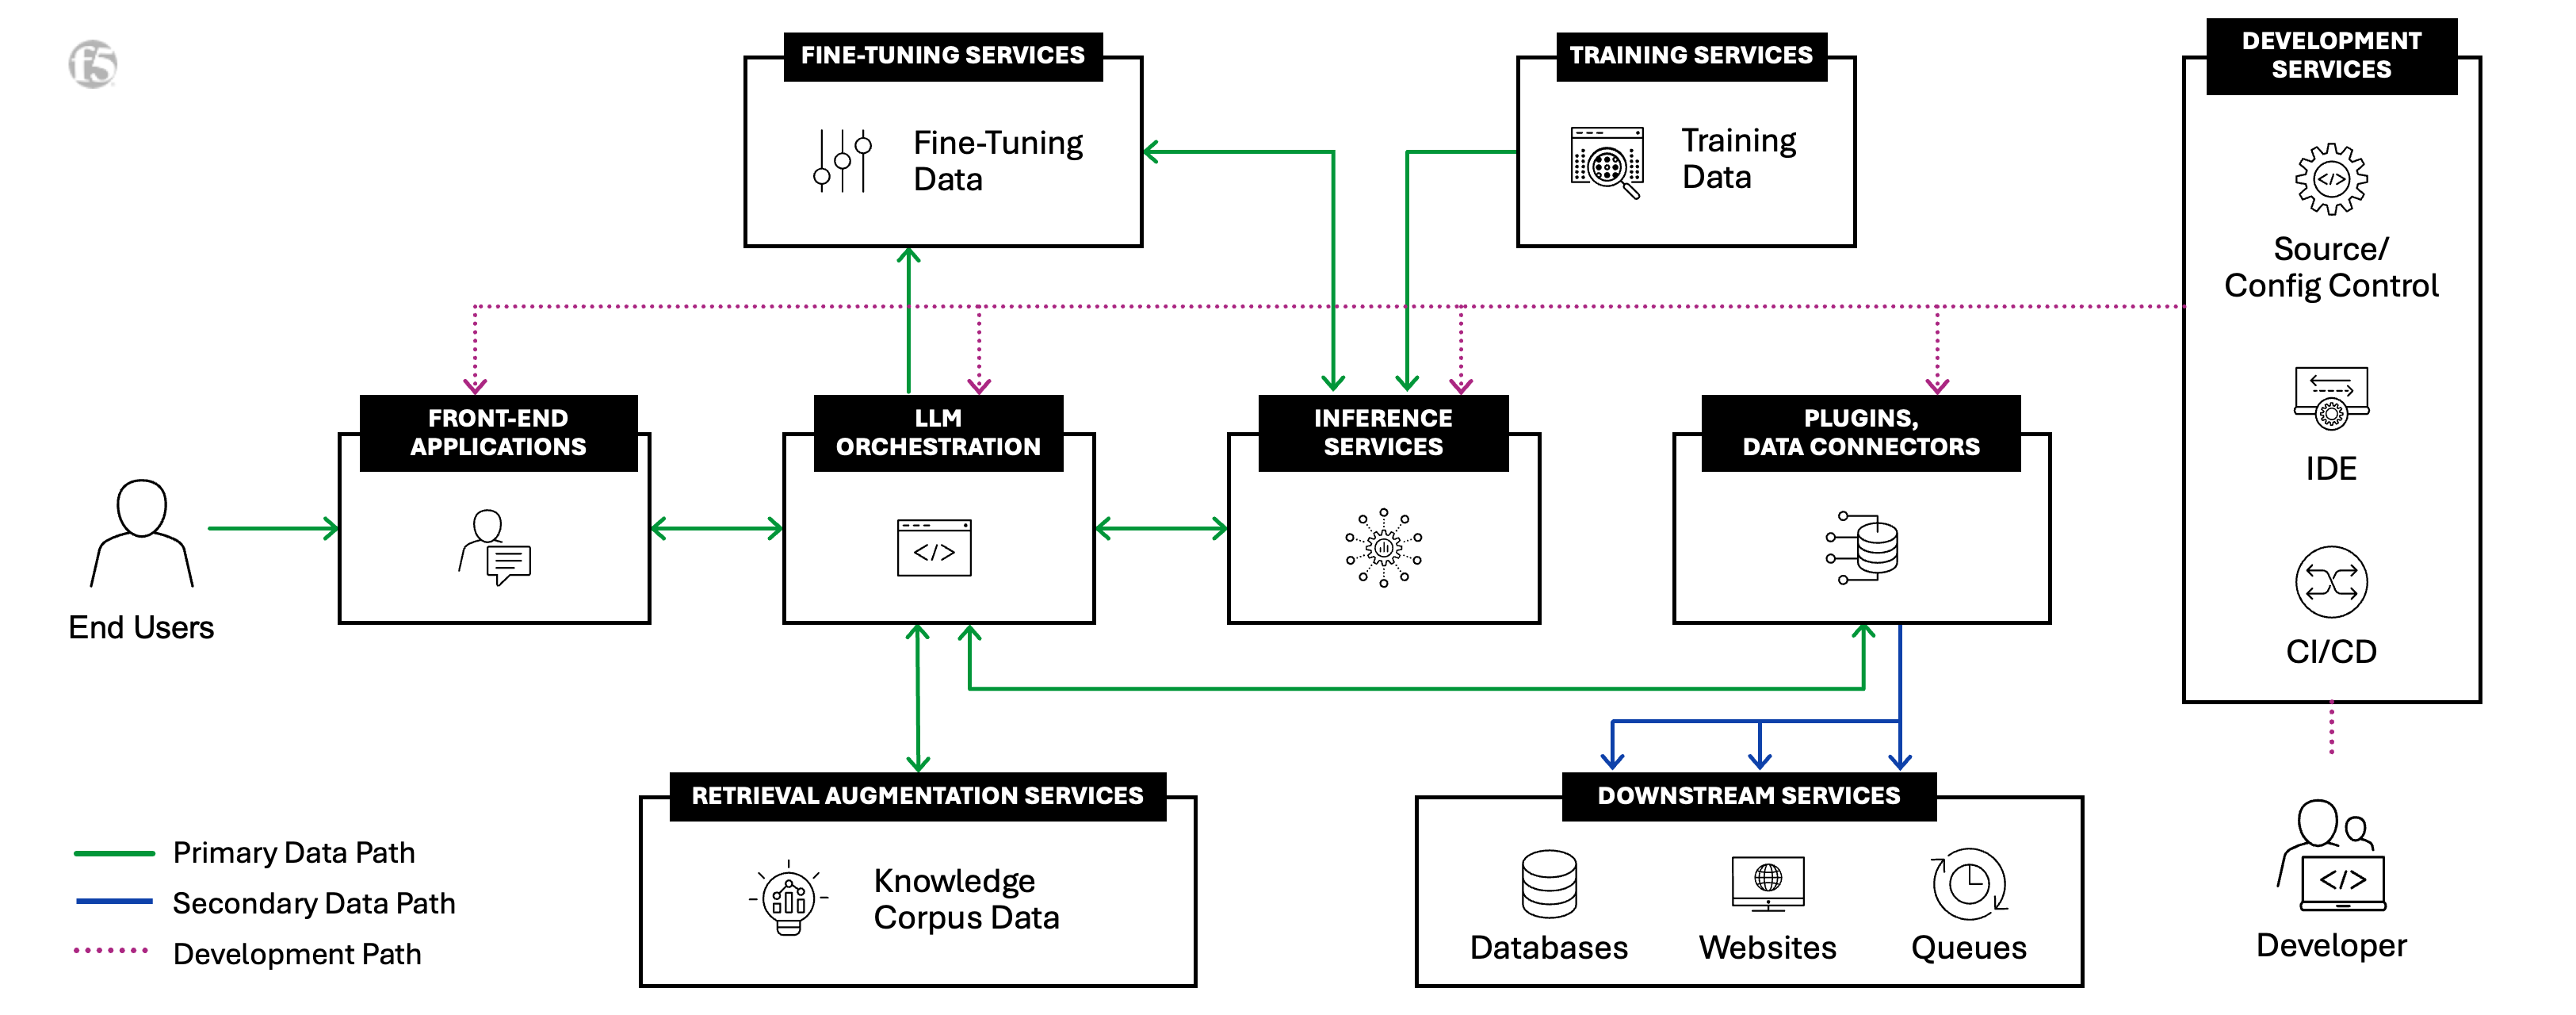
Sete componentes fundamentais da IA
Em nossa arquitetura de referência, definimos sete componentes fundamentais de IA necessários para criar uma fábrica de IA completa:
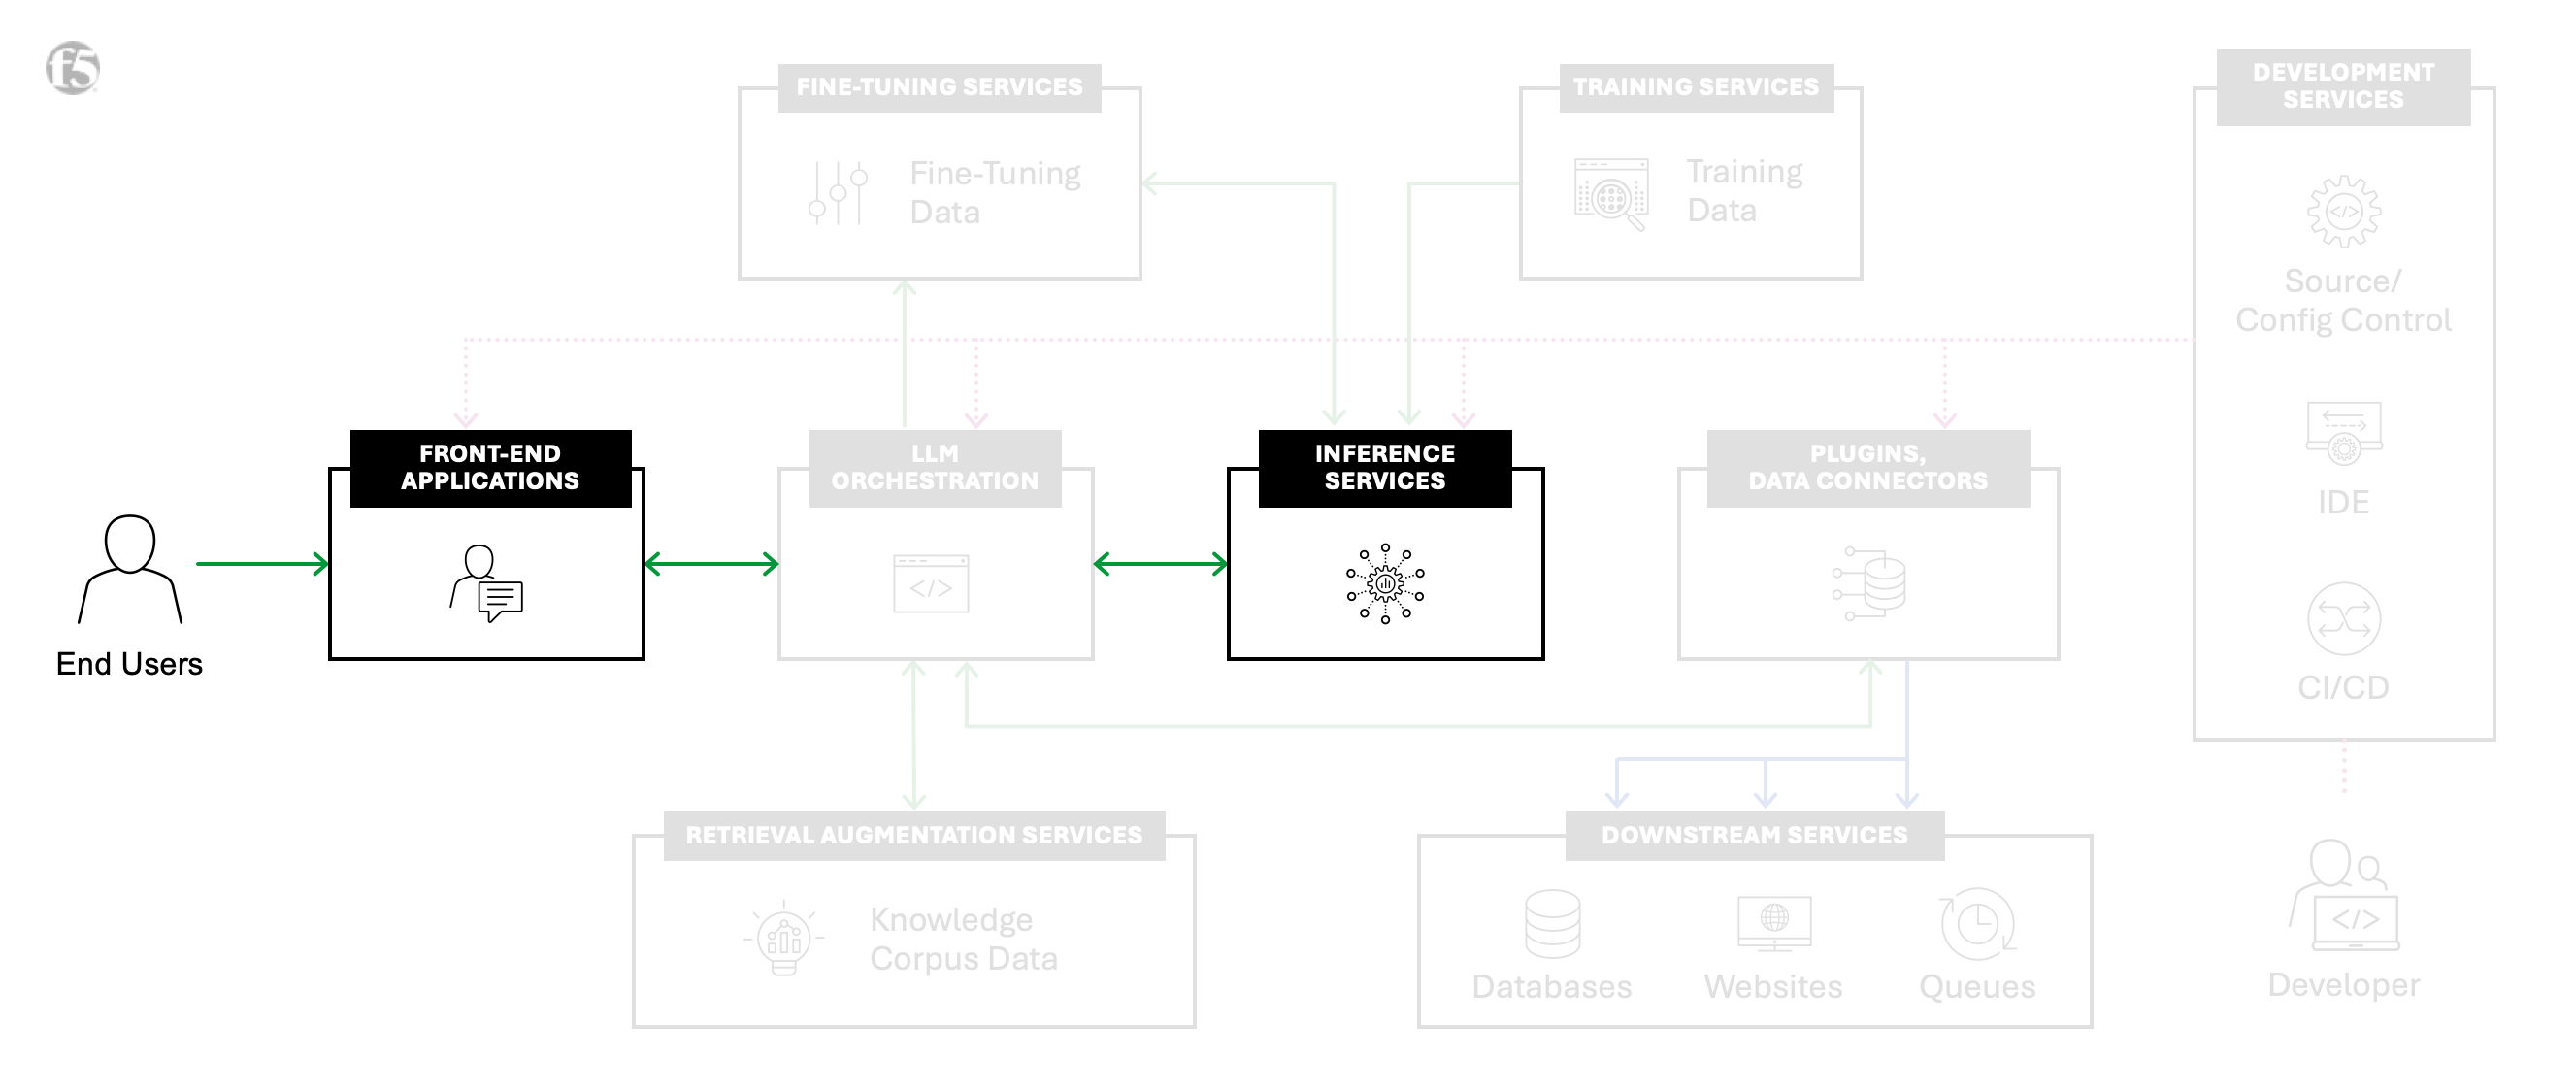
1. Inferência
Descreve a interação entre uma aplicação front-end e uma API de serviço de inferência, com foco no envio de uma solicitação a um modelo de IA e no recebimento de uma resposta. Isso estabelece a base para interações mais complexas.
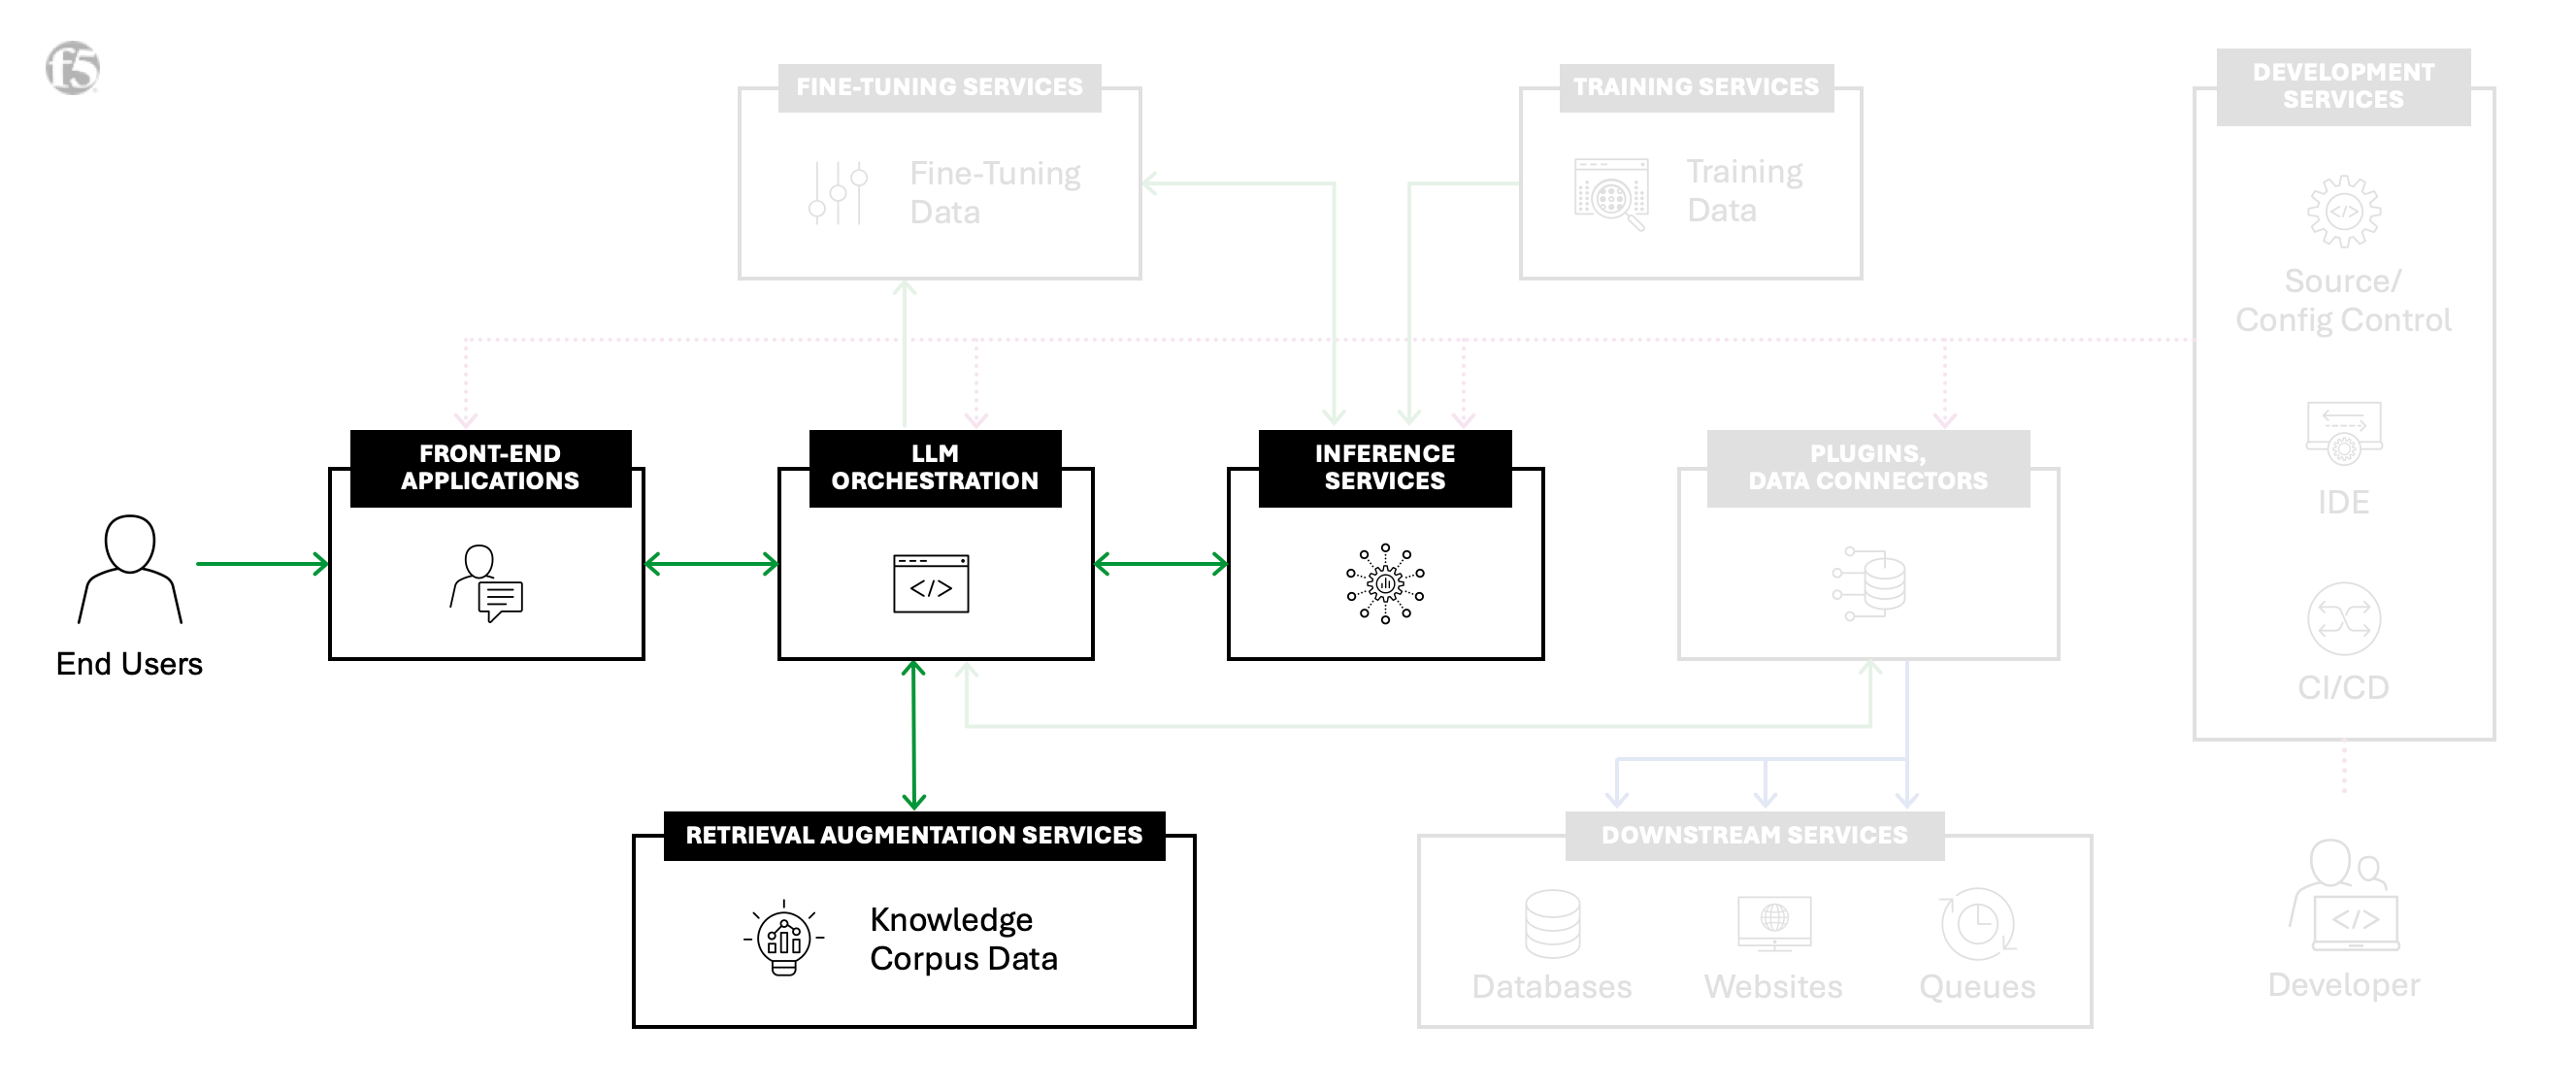
2. Geração Aumentada por Recuperação
Aprimora a inferência básica ao adicionar serviços de orquestração de modelos de linguagem de grande porte (LLMs) e de geração aumentada por recuperação. Detalha a recuperação de contexto adicional de bancos de dados vetoriais e repositórios de conteúdo, que é então usado para gerar uma resposta enriquecida com contexto.
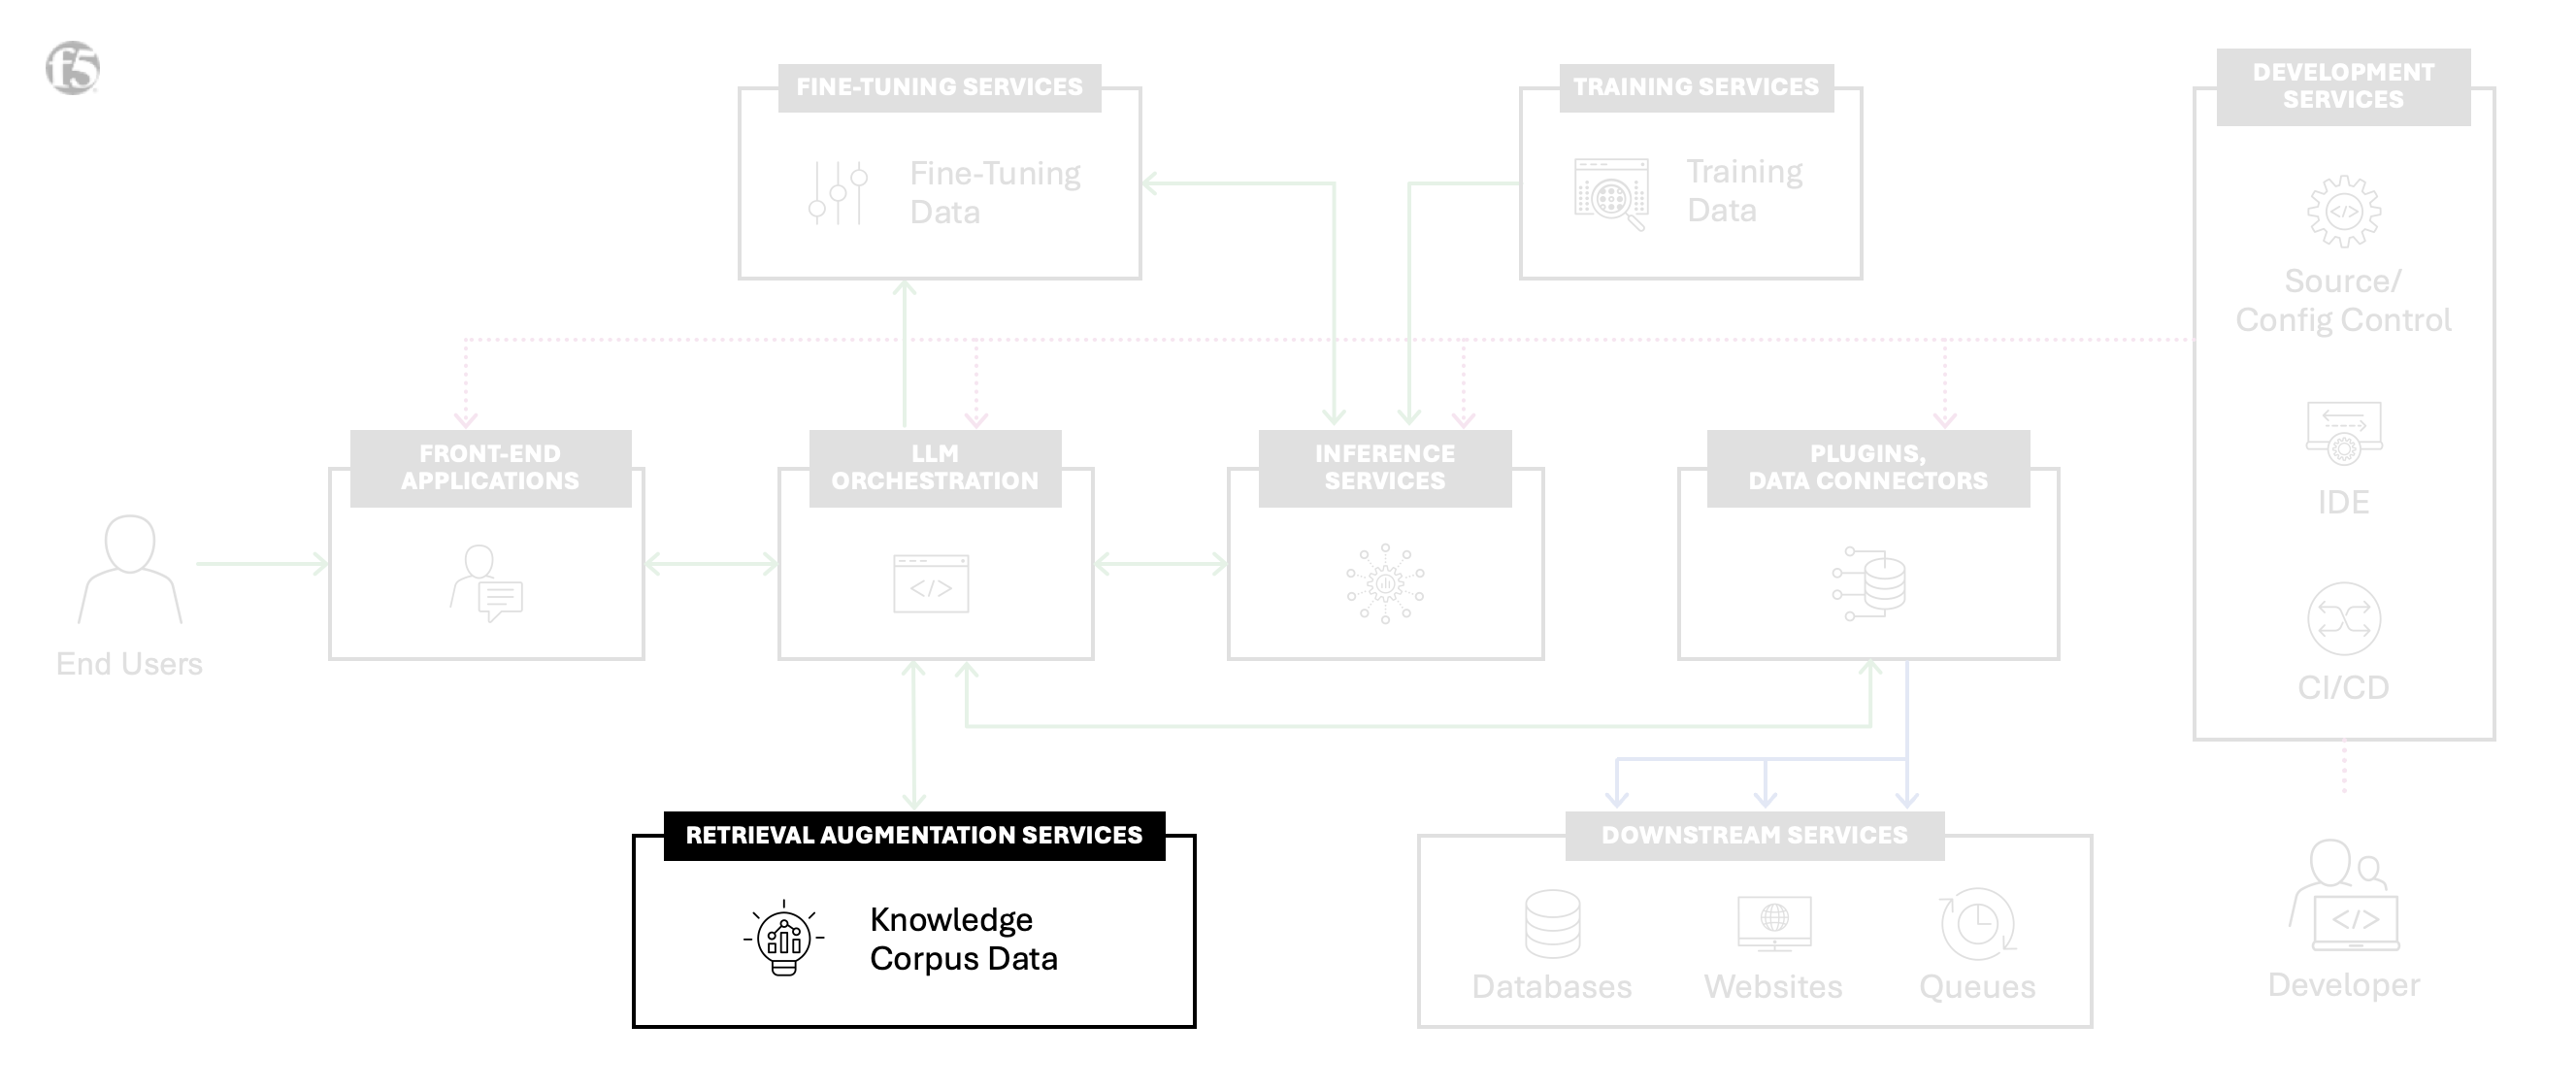
3. Gerenciamento do corpus de RAG
Concentra-se nos processos de ingestão de dados necessários para inferência com geração aumentada por recuperação (RAG). Isso inclui a normalização de dados, a geração de embeddings e o preenchimento de bancos de dados vetoriais, preparando o conteúdo para chamadas de RAG.
4. Ajuste fino
Tem como objetivo aprimorar o desempenho de um modelo existente por meio da interação com ele. O modelo é ajustado sem precisar ser reconstruído do zero, com ênfase na coleta de dados de Inferência e Inferência com RAG para fluxos de trabalho de ajuste fino.
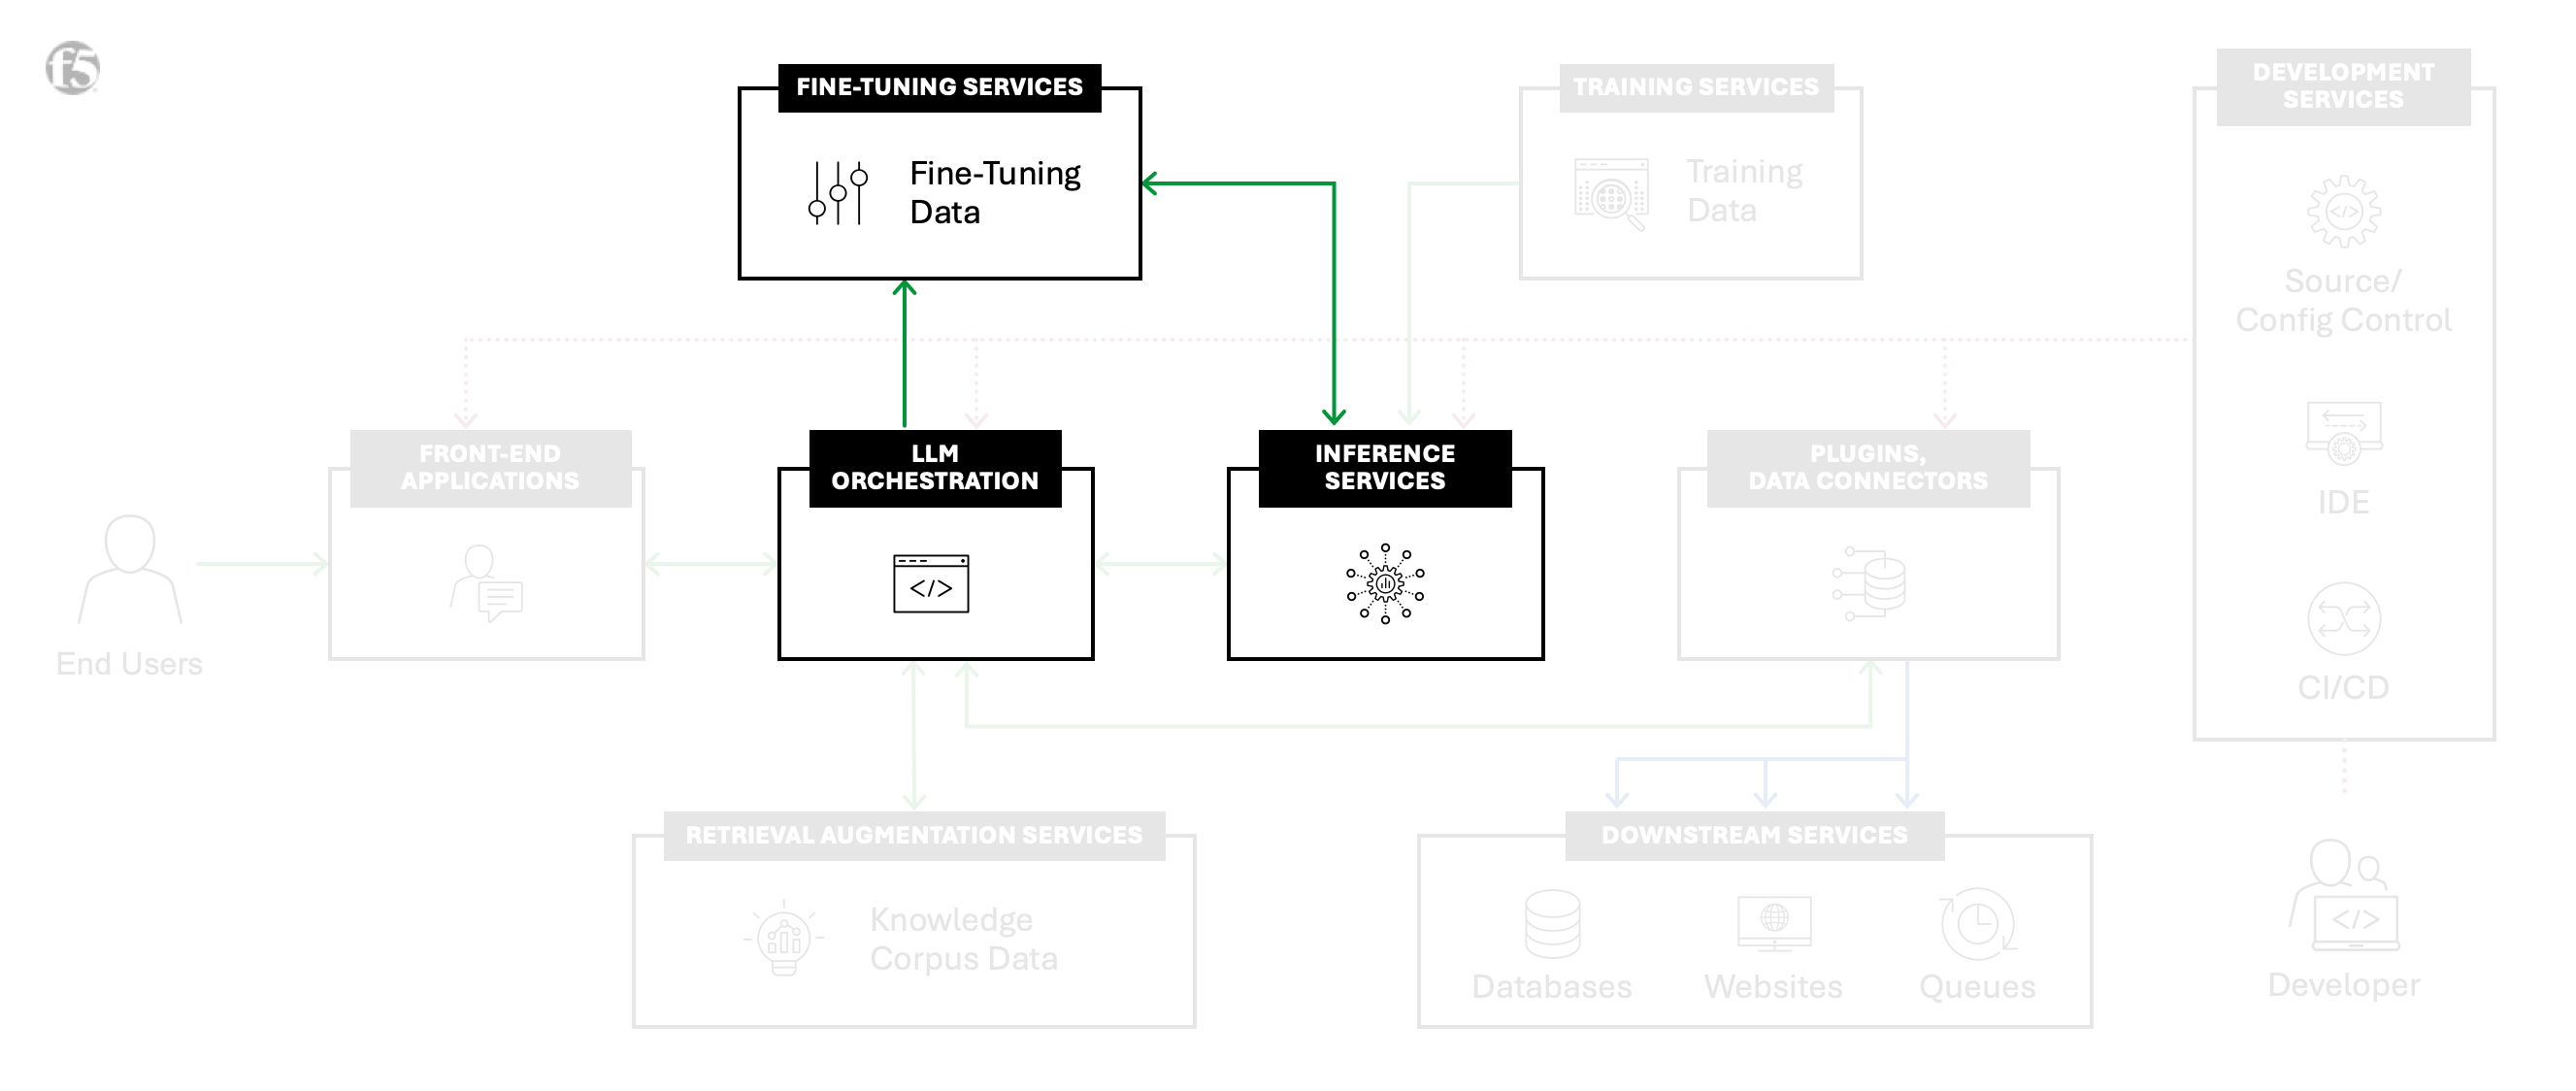
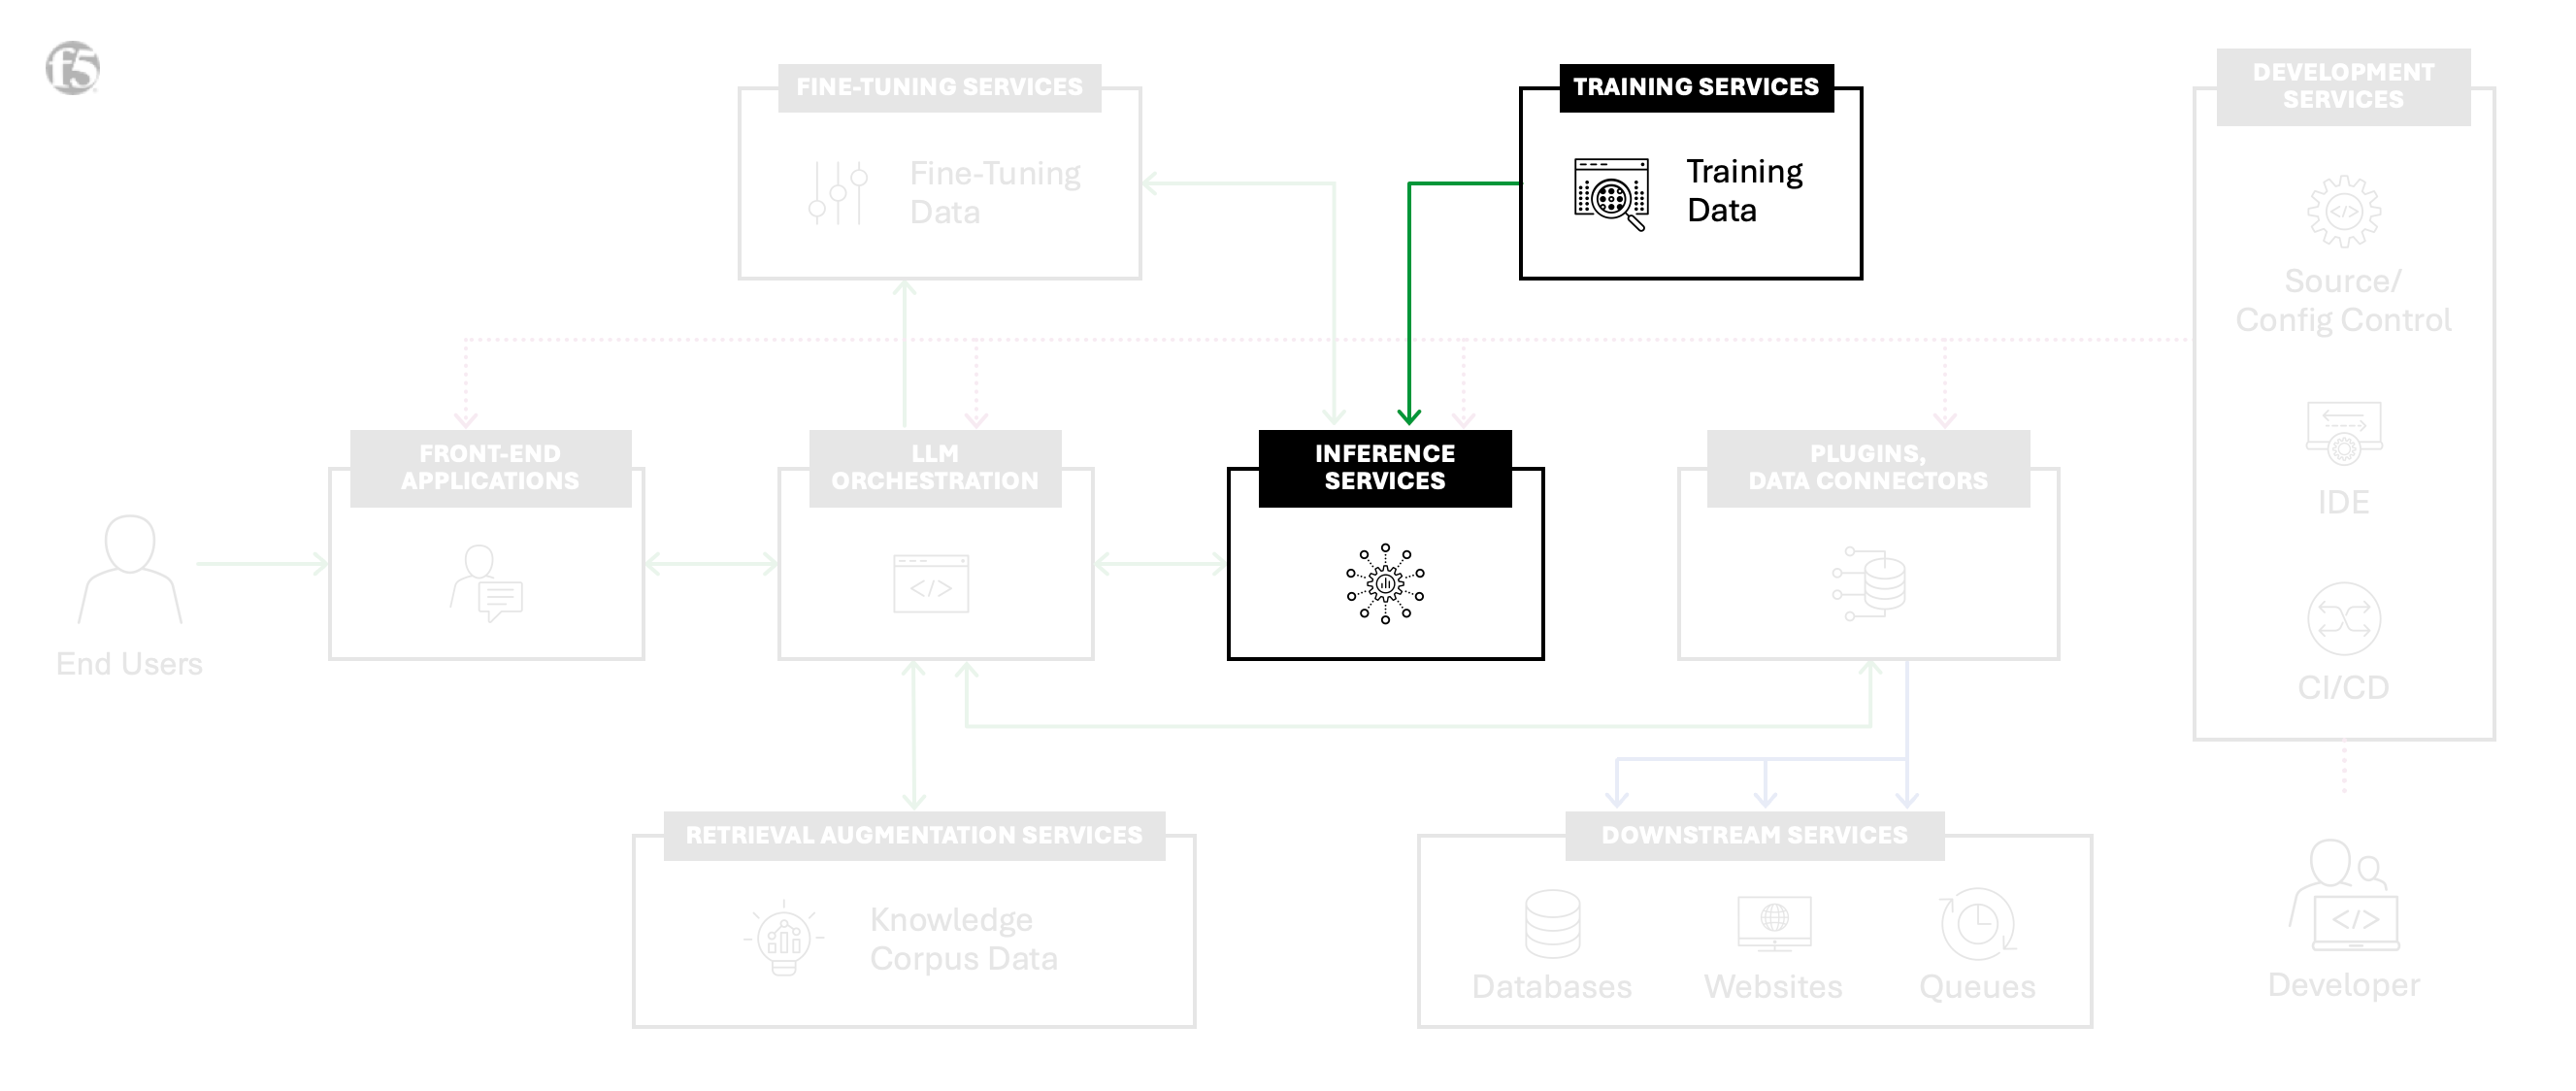
5. Treinamento
Envolve a construção de um novo modelo do zero, embora possa utilizar checkpoints anteriores (retreinamento). Abrange a coleta de dados, o pré-processamento, a seleção do modelo, a escolha do método de treinamento, o treinamento e a validação/teste. Esse processo iterativo visa criar modelos robustos e adaptados a tarefas específicas.
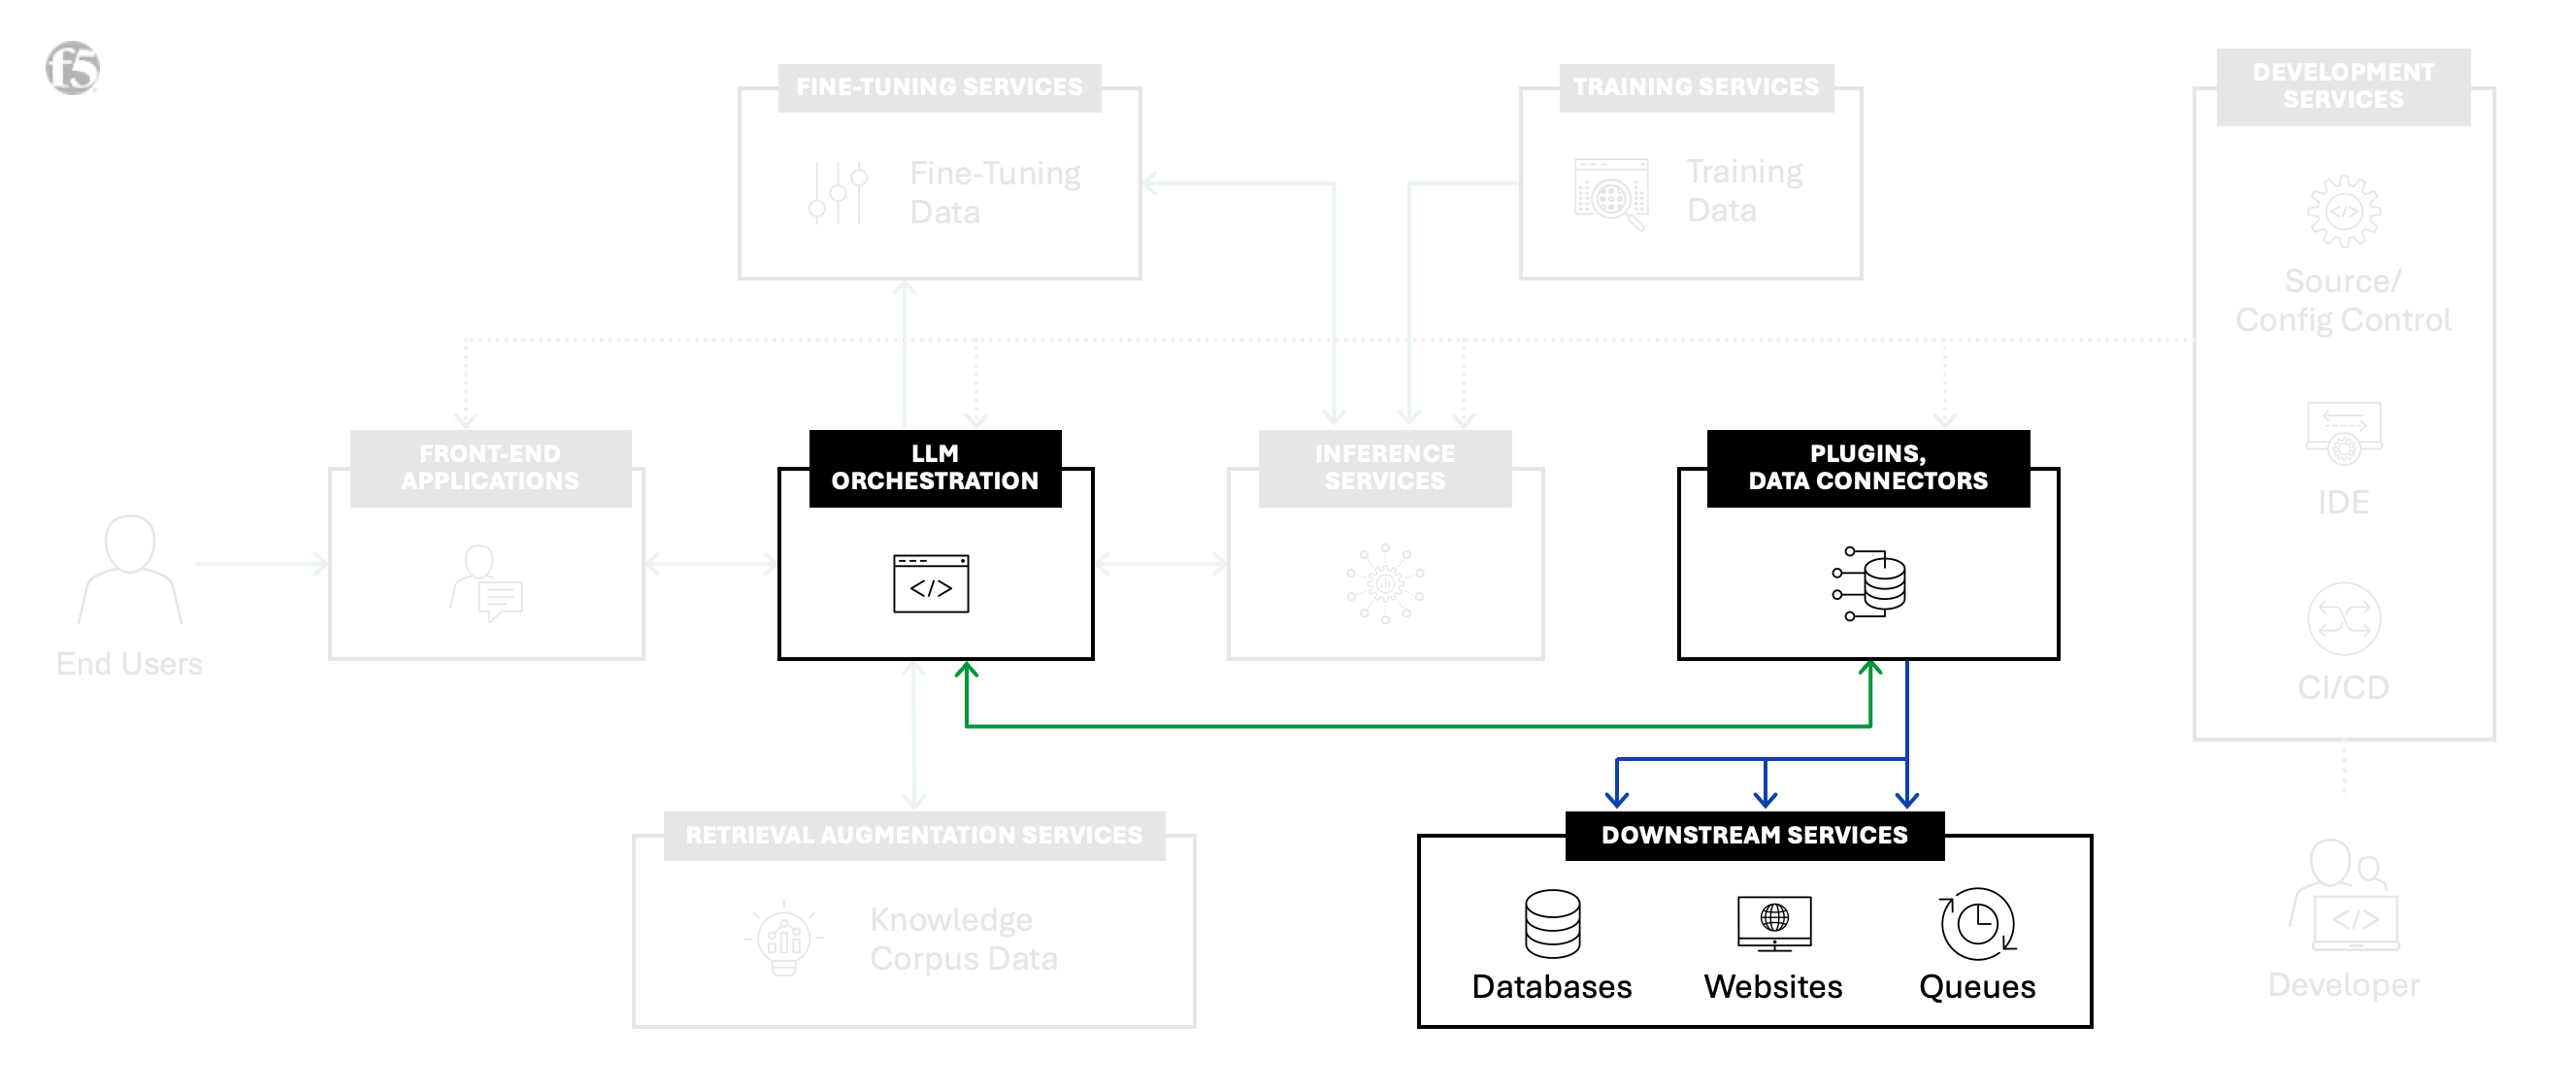
6. Integração com serviços externos
Conecta a camada de orquestração do LLM a fontes externas, como bancos de dados e sites. Integra dados externos às solicitações de inferência, mas não inclui tarefas de pré-processamento de documentos, como segmentação e geração de embeddings.
7. Desenvolvimento
Abrange fluxos de trabalho para desenvolver, manter, configurar, testar e implantar componentes de aplicações de IA. Inclui aplicações front-end, orquestração de LLMs, gerenciamento de controle de código-fonte e pipelines de CI/CD.
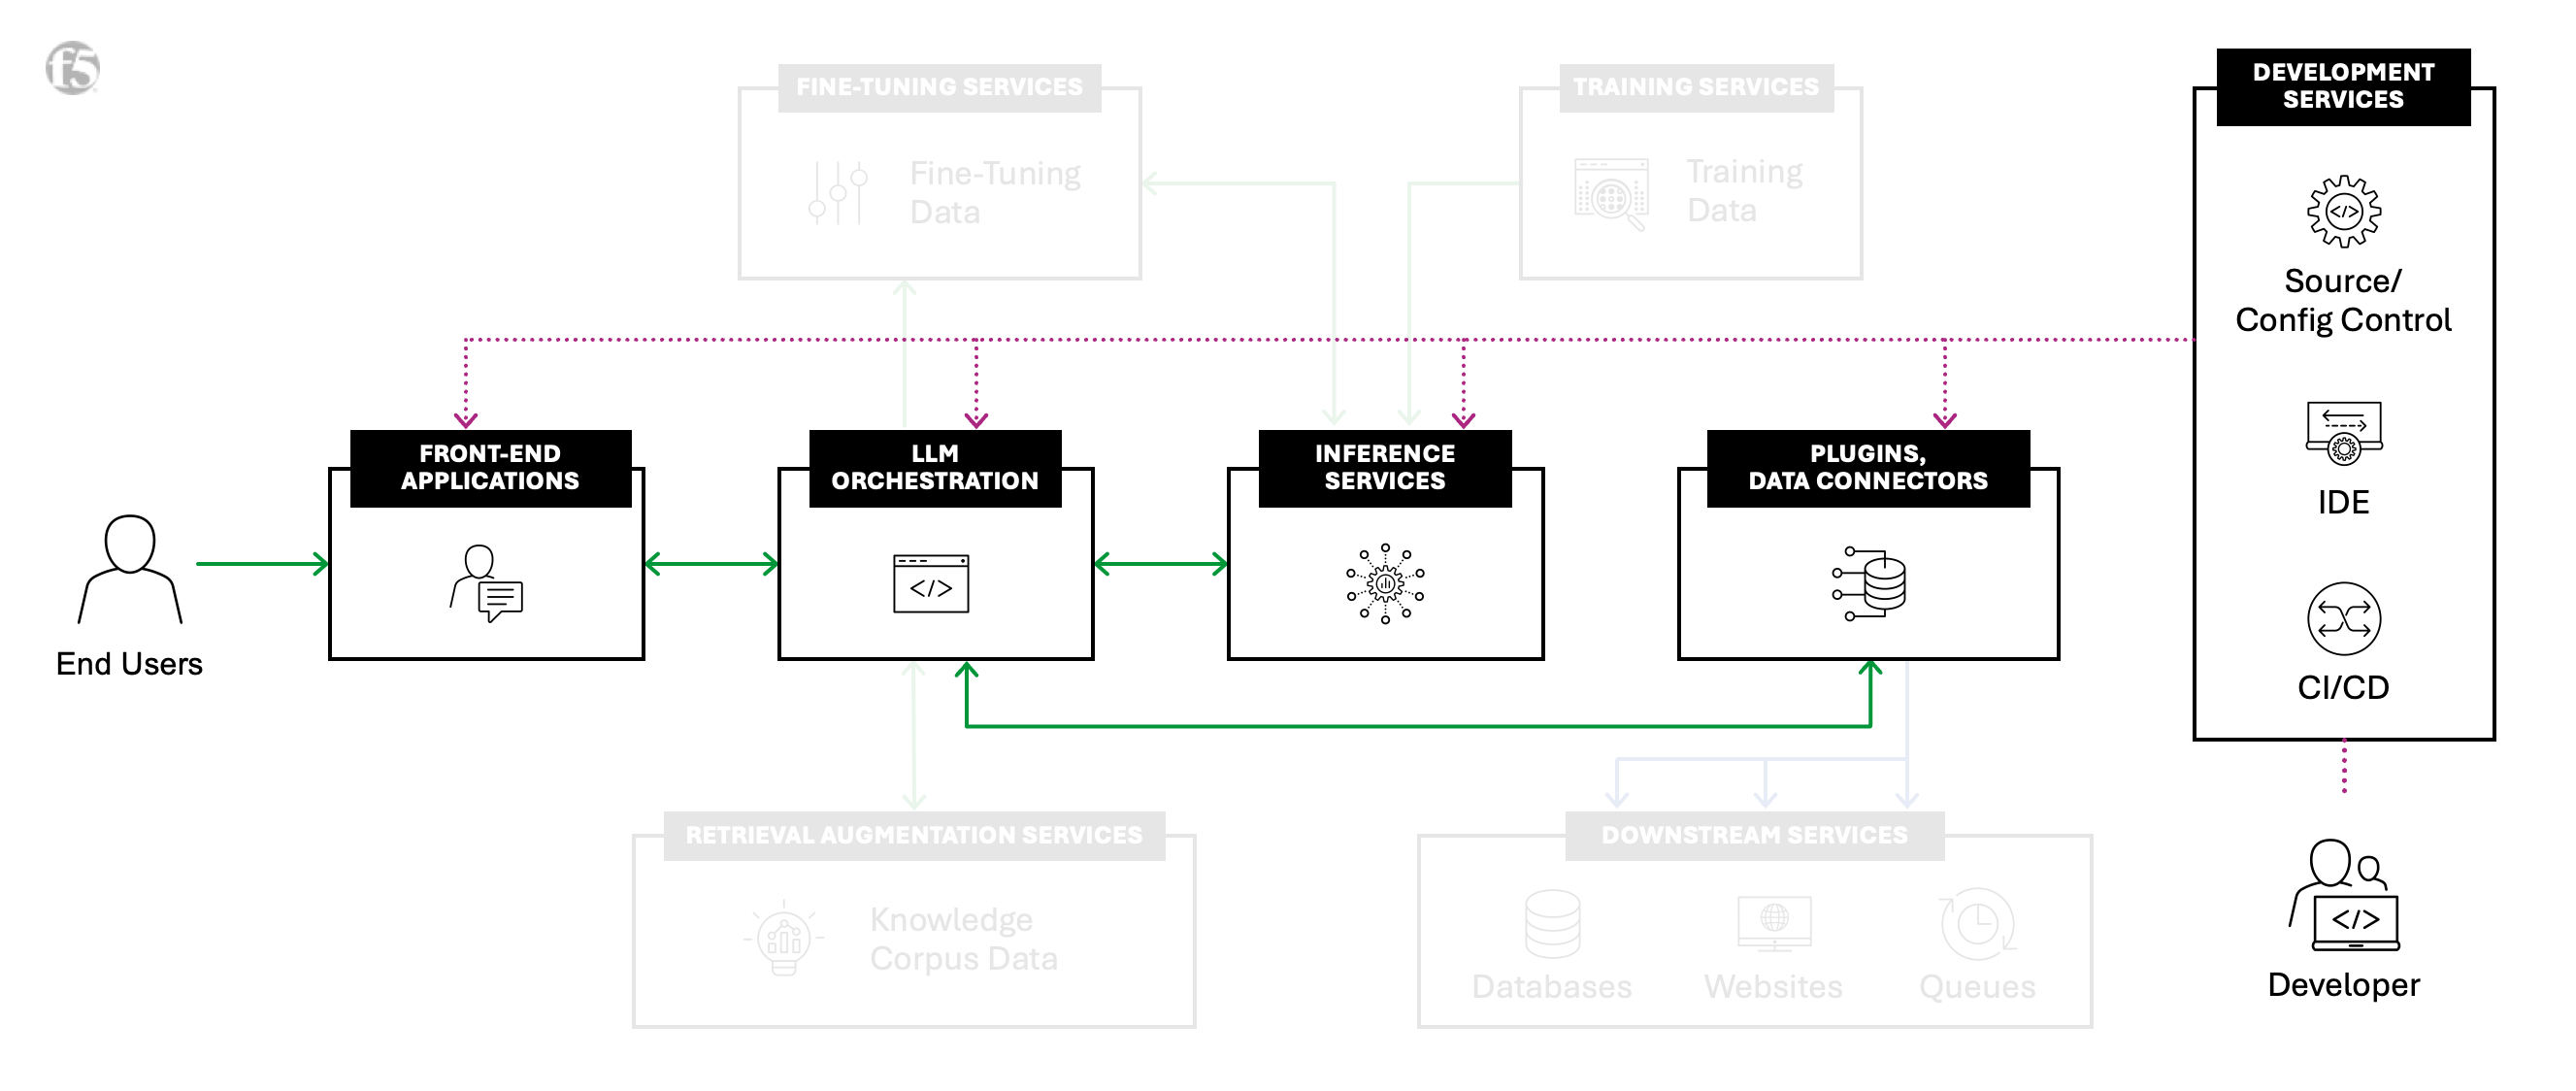
Juntos, esses componentes formam a espinha dorsal de uma fábrica de IA. Cada um desempenha um papel crucial na criação, implantação e melhoria dos resultados de IA. Além disso, as iniciativas de fábricas de IA tendem a favorecer o controle das próprias estratégias de implementação (em vez de alugá-las ou terceirizá-las) para a maioria dos componentes, o que leva à escolha da opção auto-hospedada entre os modelos de implantação listados abaixo.
Quatro modelos de implantação
Para cada um desses componentes, os clientes devem selecionar um modelo de implantação e uma estratégia de implementação adequados (adquirir, alugar ou terceirizar), definindo a arquitetura de referência ideal para alcançar os objetivos de negócios de suas iniciativas de IA. Veja os quatro principais:
- AI-SaaS envolve o uso de uma implementação de Software como Serviço (SaaS) de um serviço de inferência, na qual o provedor de serviços gerencia a infraestrutura, as atualizações do modelo e o dimensionamento. Os usuários interagem com o serviço por meio de APIs sem precisar se preocupar com a manutenção subjacente. Esse modelo de implantação é ideal para empresas que buscam facilidade de uso e integração rápida sem custos operacionais significativos. Ele também permite escalabilidade rápida e acesso aos recursos e aprimoramentos mais recentes.
- Hospedada na nuvem é uma modalidade de implantação que envolve o gerenciamento do serviço de inferência por meio de um provedor de serviços de nuvem (CSP), usando Infraestrutura como Serviço (IaaS) ou Plataforma como Serviço (PaaS). Nesse modelo, o usuário é responsável por gerenciar o serviço, incluindo configuração, escalabilidade e manutenção, mas se beneficia da infraestrutura robusta e das ferramentas do CSP. Esse modelo oferece flexibilidade e controle, sendo adequado para organizações com requisitos específicos e conhecimento técnico. Ele também permite uma integração perfeita com outros serviços e ferramentas nativos da nuvem.
- Auto-hospedada exige o gerenciamento do serviço de inferência em um data center privado autogerenciado ou em um serviço de colocation. Esse modelo oferece o mais alto nível de controle e personalização, permitindo que as organizações adaptem a infraestrutura e o serviço às suas necessidades específicas. No entanto, também exige recursos significativos para manutenção, atualizações e escalabilidade. Geralmente, é escolhido por organizações com requisitos rigorosos de segurança, conformidade ou desempenho que não podem ser atendidos por soluções baseadas em nuvem.
- Hospedada na borda é uma modalidade de implantação que envolve a execução de serviços de inteligência artificial (IA) ou aprendizado de máquina (ML) na borda, como em um quiosque de varejo, dispositivo de IoT ou outros ambientes locais. Esse modelo reduz a latência ao processar os dados perto de sua origem, sendo ideal para aplicações em tempo real e cenários em que a conectividade com a Internet é limitada ou intermitente. Ele exige um gerenciamento local robusto de hardware e software, mas oferece benefícios significativos para casos de uso que requerem tomadas de decisão imediatas e locais. A implantação hospedada na borda é particularmente valiosa em setores como varejo, manufatura e saúde.
A F5 entrega e protege aplicações de IA em qualquer lugar
Os recursos da F5 nos quais você confia diariamente para entrega e segurança de aplicações são os mesmos recursos essenciais para uma fábrica de IA bem projetada. F5 BIG-IP Local Traffic Manager, em conjunto com o hardware desenvolvido especificamente pela F5 rSeries e VELOS, permite a ingestão de dados de alto desempenho para o treinamento de IA. O F5 Distributed Cloud Network Connect para redes multinuvem seguras conecta diferentes locais de dados, criando um canal seguro entre dados proprietários e modelos de IA para RAG.
O foco da F5 em IA não para por aqui — descubra como a F5 protege e disponibiliza aplicações de IA em qualquer lugar.
Quer saber mais sobre fábricas de IA? Confira outros conteúdos da nossa série de artigos sobre fábricas de IA:
- Geração Aumentada por Recuperação (RAG) para fábricas de IA ›
- Otimize o gerenciamento de tráfego para ingestão de dados em fábricas de IA ›
- Conectando fontes de dados de borda a fábricas de IA de forma otimizada ›
- Escalabilidade e flexibilidade multicloud dão suporte às fábricas de IA ›
- O poder e a importância da DPU NVIDIA BlueField para fábricas de IA ›
- Proteção de APIs para fábricas de IA: o primeiro passo para a segurança da IA ›
- A importância da segmentação de rede para fábricas de IA ›
- Fábricas de IA produzem os mais modernos aplicativos: aplicativos de IA ›
Sobre o autor

Hunter Smit é gerente sênior de marketing de produtos para soluções e estratégia na F5. Ele lidera o marketing de soluções em todo o portfólio da F5, incluindo infraestrutura de IA e segurança de aplicações, e está conduzindo a entrada da F5 no mercado emergente de entrega de dados para IA. Hunter integra o Conselho Consultivo da Escola de Negócios da Whitworth University e atuou como professor adjunto de marketing de produtos. Ele possui MBA e bacharelado em Administração de Empresas com ênfase em gestão pela Whitworth University.
Mais publicações de Hunter SmitPublicações relacionadas no blog

Entrega e proteção de agentes de IA em fábricas de IA: F5 para a arquitetura de referência NVIDIA OpenShell para agentes de IA seguros
As soluções da F5 ampliam a Arquitetura de Referência NVIDIA OpenShell para agentes de IA seguros.

Como medir – e minimizar – o custo total de propriedade do seu Kubernetes
O Kubernetes pode ser baixado e executado gratuitamente, mas sua manutenção está longe de não ter custos. Assim como outras grandes plataformas de código aberto que são “gratuitas” apenas em um sentido simplista, o Kubernetes quase certamente exigirá investimentos para ser implantado e operado.
As-Code: a pilha de TI contínua
Infraestrutura, configuração, pipeline, operações. De repente, tudo é “como código”. Lori MacVittie busca esclarecer a terminologia e identificar os diferentes componentes de uma stack contínua de TI.
O estado da entrega de aplicações em 2017: automação, APIs e DevOps
Explore o relatório State of Application Delivery de 2017. Leia o blog retrospectivo da F5 sobre o início da ascensão das redes declarativas e dos pipelines de DevOps.
DevOps Summit: onde a rede foi convidada para a festa
No DevOps Summit NY, falou-se muito não apenas sobre DevOps, mas também sobre contêineres, IoT e microsserviços. As sessões se concentraram não só na mudança cultural necessária para crescer em escala com uma abordagem DevOps, mas também fizeram questão de incluir...
F5 e Nutanix convergem em infraestrutura no .NEXT
Aplicações empresariais como Microsoft SharePoint e Exchange, juntamente com a VDI, continuam sendo a espinha dorsal da sua empresa. A produtividade, embora não seja tão atraente quanto o lucro, é um fator essencial para o sucesso das operações empresariais atuais. Deixar de...