Você já fez um teste de desempenho de um servidor em laboratório e depois o colocou em produção para atender tráfego real, apenas para descobrir que ele não consegue chegar nem perto do desempenho obtido no teste? A utilização da CPU está baixa e há muitos recursos disponíveis, mas os clientes reclamam da lentidão nos tempos de resposta, e você não consegue descobrir como aproveitar melhor o servidor.
O que você está observando é um dos efeitos do que podemos chamar de “trabalho pesado do HTTP”. Neste post, investigamos como o HTTP funciona e como servidores HTTP comuns processam transações HTTP. Analisamos alguns dos problemas de desempenho que podem ocorrer e vemos como o modelo orientado a eventos do NGINX o torna um proxy acelerador muito eficaz para esses servidores HTTP. Com o NGINX, você pode melhorar o desempenho no mundo real para que ele volte ao nível dos seus benchmarks locais.
Para obter orientações sobre como ajustar o Linux e o NGINX para melhorar a velocidade e a escalabilidade dos seus aplicativos, consulte Ajuste do NGINX para melhorar o desempenho em nosso blog.
Uma introdução ao HTTP e às conexões keepalive
As conexões HTTP keepalive são um recurso de desempenho essencial que reduz a latência e permite que as páginas da web carreguem mais rapidamente.
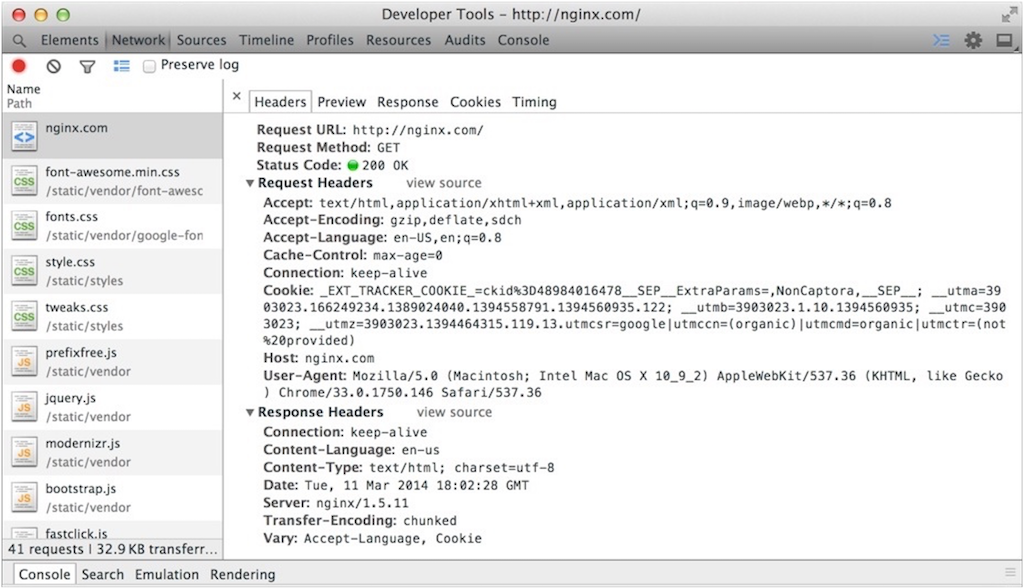
HTTP é um protocolo simples, baseado em texto. Se você ainda não fez isso, dê uma olhada na saída de uma ferramenta de depuração HTTP, como a disponível no seu navegador, e confira a estrutura padrão de requisição e resposta:
Em sua implementação mais simples, um cliente HTTP cria uma nova conexão TCP com o servidor de destino, envia a solicitação e recebe a resposta. Em seguida, o servidor encerra a conexão TCP para liberar recursos.
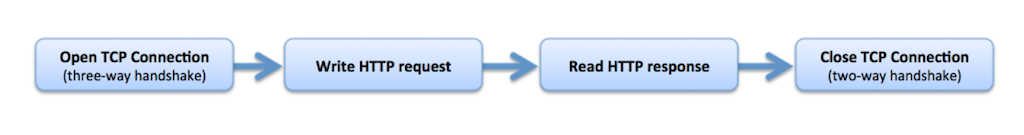
Esse modo de operação pode ser muito ineficiente, especialmente em páginas da Web complexas, com um grande número de elementos, ou quando as conexões de rede são lentas. A criação de uma nova conexão TCP exige um “handshake de três vias”, e seu encerramento também envolve um procedimento de finalização em duas vias. Criar e fechar repetidamente conexões TCP, uma para cada mensagem, é como desligar e ligar novamente após cada pessoa falar em uma conversa telefônica.
O HTTP usa um mecanismo chamado conexões persistentes para manter aberta a conexão TCP entre o cliente e o servidor após a conclusão de uma transação HTTP. Se o cliente precisar realizar outra transação HTTP, poderá usar a conexão persistente ociosa em vez de criar uma nova conexão TCP.
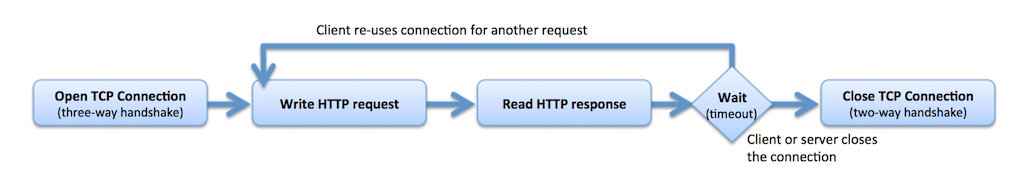
Os clientes geralmente abrem várias conexões TCP simultâneas com um servidor e realizam transações keepalive em todas elas. Essas conexões permanecem abertas até que o cliente ou o servidor decida que elas não são mais necessárias, geralmente devido a um tempo limite de inatividade.
Os navegadores modernos geralmente abrem de 6 a 8 conexões keepalive e as mantêm abertas por vários minutos antes de encerrá-las por tempo limite. Os servidores web podem ser configurados para encerrar essas conexões por tempo limite e fechá-las mais cedo.
Qual é o efeito das conexões keepalive no servidor HTTP?
Se muitos clientes usarem conexões persistentes HTTP e o servidor web tiver um limite de simultaneidade ou um problema de escalabilidade, o desempenho despencará assim que esse limite for atingido.
A abordagem acima foi projetada para oferecer o melhor desempenho possível a um cliente individual. Infelizmente, em um cenário semelhante à ‘tragédia dos comuns’, se todos os clientes agirem dessa forma, isso poderá prejudicar o desempenho de muitos servidores web e aplicações web comuns.
O motivo é que muitos servidores têm um limite fixo de simultaneidade. Por exemplo, em configurações comuns, o Apache HTTP Server só consegue processar um número limitado de conexões TCP simultâneas: 150 com o módulo de multiprocessamento (MPM) worker e 256 com o MPM prefork. Cada conexão HTTP keepalive ociosa ocupa uma dessas vagas de simultaneidade e, quando todas as vagas estão ocupadas, o servidor não consegue aceitar mais conexões HTTP.
A recomendação convencional é desativar as conexões persistentes no servidor web ou limitar sua duração a um período muito curto. Elas oferecem um vetor muito simples para os ataques de negação de serviço SlowHTTPTest e Slowloris (para uma solução rápida, consulte Proteção contra negação de serviço Keep‑Dead em serverfault.com).
Além disso, esses servidores web e de aplicativos normalmente alocam uma thread ou um processo do sistema operacional para cada conexão. Uma conexão TCP é um objeto muito leve do sistema operacional, mas uma thread ou um processo é muito pesado. Threads e processos exigem memória, precisam ser gerenciados ativamente pelo sistema operacional, e a “troca de contexto” entre threads ou processos consome recursos da CPU. Atribuir uma thread ou um processo exclusivo a cada conexão é extremamente ineficiente.
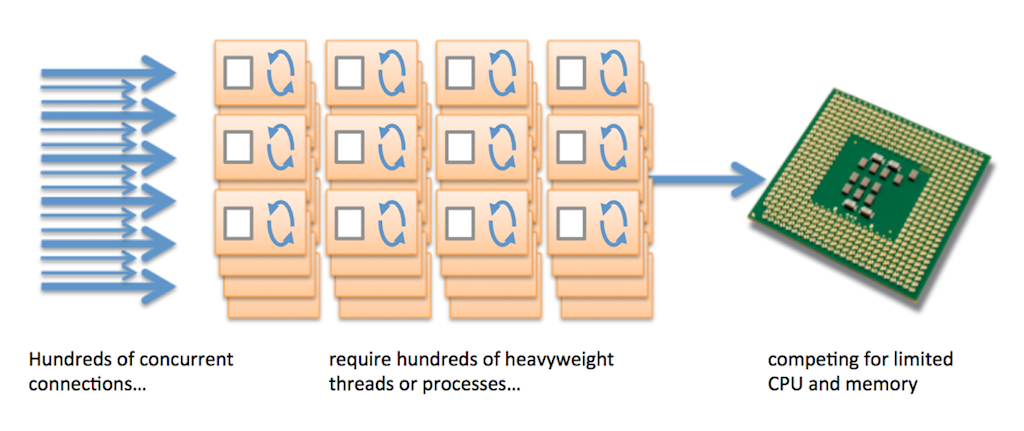
O grande número de conexões simultâneas de clientes e a atribuição de uma thread ou processo a cada conexão produzem o fenômeno conhecido como “trabalho pesado de HTTP”, no qual é necessário um esforço desproporcionalmente grande para processar uma transação HTTP simples.
O que isso significa na prática?
Não são necessários muitos clientes para esgotar o limite de simultaneidade de muitos servidores web e de aplicações modernos.
Se um cliente abrir 8 conexões TCP e mantiver cada uma ativa por 15 segundos após o último uso, ele ocupará 8 slots de simultaneidade durante 15 segundos. Se os clientes acessarem seu site à taxa de 1 por segundo, 120 slots de simultaneidade permanecerão continuamente ocupados por conexões keepalive ociosas. Se a taxa for de 2 clientes por segundo, 240 slots de simultaneidade ficarão ocupados. Quando os slots se esgotarem, novos clientes não poderão se conectar até que as conexões existentes expirem.
Isso pode resultar em níveis de serviço muito desiguais. Os clientes que conseguem estabelecer uma conexão keepalive podem navegar livremente pelo seu serviço. Já os clientes que tentam se conectar quando todos os slots de simultaneidade estão ocupados não conseguem acessar o serviço e precisam aguardar em uma fila.
Por que você não observa esses efeitos durante os testes de benchmark?
Esses problemas só se manifestam em redes lentas com muitos clientes. Eles não aparecem em testes de benchmark com um único cliente em uma rede local rápida.
Há alguns motivos pelos quais talvez você não observe esses efeitos em um benchmark.
- Se você não habilitar conexões persistentes durante o benchmark, o cliente criará uma nova conexão TCP para cada transação (e a conexão será encerrada após a conclusão da transação). Como provavelmente o benchmark está sendo executado em uma rede local rápida, ele é concluído com sucesso e você não percebe os problemas de desempenho causados pela falta de conexões persistentes.
- Se você habilitar conexões persistentes, provavelmente poderá executar menos conexões simultâneas do que o limite do servidor, e o cliente de benchmark saturará cada conexão (usando-a repetidamente), levando o servidor à sua capacidade máxima. No entanto, isso não corresponde ao perfil de conexões observado no mundo real.
Observe que a maioria das ferramentas de benchmark apresenta apenas dados sobre transações bem-sucedidas. As conexões paralisadas devido ao esgotamento de recursos podem não ser contabilizadas ou podem parecer representar apenas uma pequena fração das conexões bem-sucedidas. Isso oculta a verdadeira natureza do problema em condições de tráfego real.
Quão comum é o problema?
Qualquer servidor web ou de aplicações baseado em threads ou processos está sujeito a limitações de concorrência.
Esse problema é inerente a qualquer plataforma web ou de aplicativos que atribua uma thread ou um processo a cada conexão. Não é fácil detectá-lo em um ambiente otimizado de benchmark, mas, em um ambiente real, ele se manifesta na forma de baixo desempenho e uso excessivo da CPU.
Há várias medidas que você pode tomar para resolver esse problema:
- Aumente o número de threads ou processos – Esta é uma medida de curtíssimo prazo. Threads e processos são objetos pesados do sistema operacional e geram uma sobrecarga de gerenciamento que aumenta rapidamente à medida que mais deles são criados.
- Desative ou limite o uso de conexões persistentes HTTP – Isso adia o limite de simultaneidade, mas resulta em um desempenho muito pior para cada cliente.
- Use processamento especializado de keepalive – O Apache HTTP Server (servidor web) tem um MPM event relativamente novo que transfere as conexões entre threads de trabalho e uma thread dedicada a eventos quando elas alternam entre os estados ‘ativo’ e ‘keepalive ocioso’. Essa pode ser uma opção se os outros módulos que você usa forem compatíveis com esse MPM; observe que as conexões SSL/TLS ainda são processadas inteiramente em threads dedicadas.
- Use um modelo de processamento mais eficiente – De longe, a medida mais simples e eficaz que você pode tomar é colocar um proxy HTTP eficiente na frente dos seus servidores web ou de aplicativos. Um proxy orientado a eventos, como o NGINX, não tem as limitações de simultaneidade descritas acima. Ele lida facilmente com conexões lentas e conexões keepalive ociosas. Além disso, converte de forma eficiente conexões lentas do lado do cliente, com várias conexões keepalive ociosas, em conexões rápidas, locais e altamente eficientes, semelhantes às usadas em testes de desempenho, que extraem o melhor desempenho possível dos seus servidores web e de aplicativos.
Use o NGINX como um proxy HTTP acelerador
O NGINX usa uma arquitetura diferente, que não sofre com os problemas de simultaneidade descritos acima. Ele transforma conexões lentas de clientes em conexões otimizadas, semelhantes às usadas em testes de desempenho, para extrair o melhor desempenho dos seus servidores.
O NGINX usa um modelo orientado a eventos altamente eficiente para gerenciar conexões.
Cada processo do NGINX pode lidar com várias conexões ao mesmo tempo. Quando uma nova conexão é aceita, a sobrecarga é muito baixa (consistindo em um novo descritor de arquivo e um novo evento a ser monitorado), ao contrário do modelo por processo ou por thread descrito acima. O NGINX tem um loop de eventos muito eficiente:
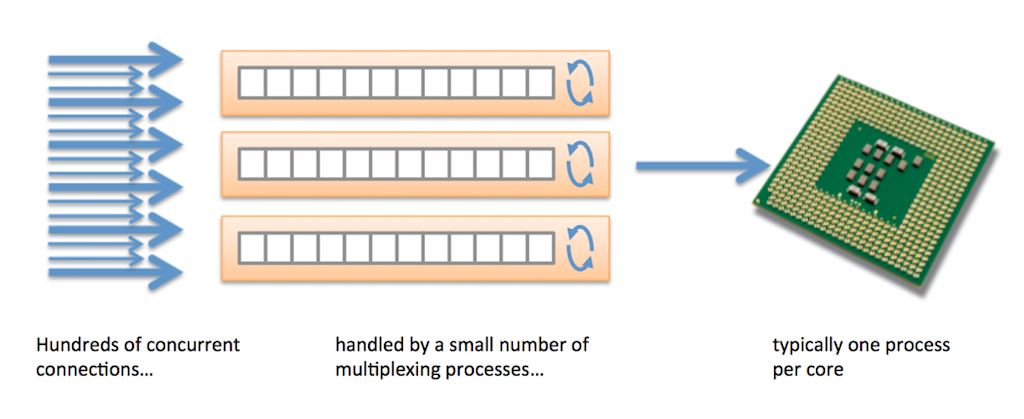
Isso permite que cada processo do NGINX seja facilmente dimensionado para lidar simultaneamente com dezenas, milhares ou centenas de milhares de conexões.
Em seguida, o NGINX encaminha as solicitações por proxy ao servidor upstream, usando um pool local de conexões keepalive. Assim, você evita a sobrecarga de abrir e fechar conexões TCP, e as pilhas TCP se adaptam rapidamente ao tamanho ideal da janela e aos parâmetros de repetição. O envio de solicitações e a leitura de respostas são muito mais rápidos pela rede local otimizada:
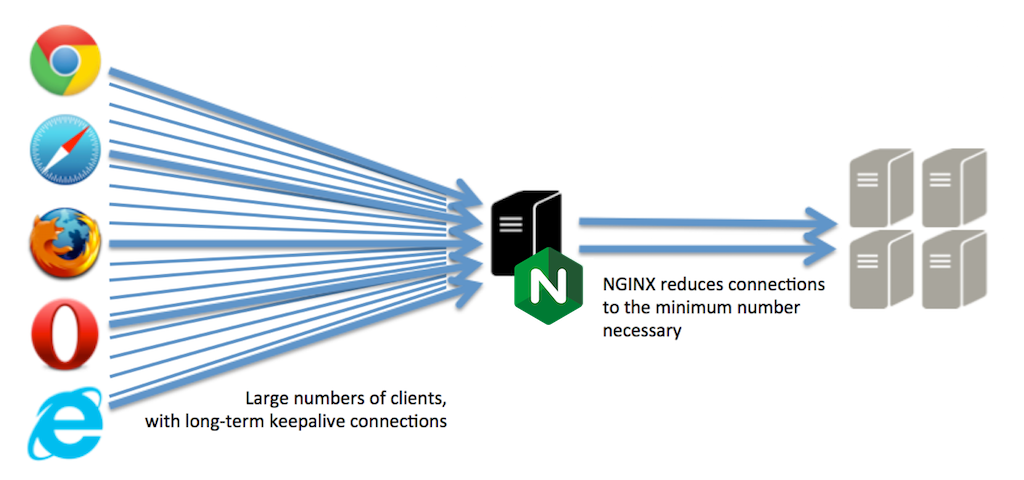
O efeito final é que o servidor upstream passa a se comunicar com um único cliente local (NGINX) por meio de uma rede rápida, e esse cliente utiliza de forma otimizada as conexões HTTP keepalive para minimizar o estabelecimento de conexões sem mantê-las abertas desnecessariamente. Isso faz com que o servidor volte a operar em um ambiente ideal, semelhante ao de um benchmark.
Com o NGINX atuando como um proxy HTTP, você observa:
- Melhor utilização dos recursos existentes. Seus servidores web e de aplicativos podem processar mais transações por segundo, pois não precisam mais lidar com o processamento pesado de HTTP.
- Redução das taxas de erro. A ocorrência de timeouts de HTTP é muito menos provável porque o NGINX atua como um agendador central para todos os clientes.
- Melhor desempenho para o usuário final. Os servidores operam com mais eficiência e atendem às conexões com mais rapidez.
Outras maneiras pelas quais o NGINX pode acelerar os serviços
Eliminar a sobrecarga do processamento pesado de HTTP é apenas uma das medidas de transformação de desempenho que o NGINX pode aplicar à sua infraestrutura de aplicações sobrecarregada.
O recurso de cache HTTP do NGINX pode armazenar em cache as respostas dos servidores upstream, seguindo a semântica padrão de cache para controlar o que é armazenado e por quanto tempo. Se vários clientes solicitarem o mesmo recurso, o NGINX poderá responder usando seu cache, sem sobrecarregar os servidores upstream com solicitações duplicadas.
O NGINX também pode transferir outras operações do servidor upstream. Você pode transferir as operações de compactação de dados para reduzir o uso de largura de banda, centralizar a criptografia e descriptografia SSL/TLS, realizar a autenticação inicial do cliente (por exemplo, com autenticação HTTP básica, subsolicitações a servidores de autenticação externos e JSON Web Tokens) e aplicar todos os tipos de regras para limitar a taxa de tráfego quando necessário.
Não é um balanceador de carga ou ADC convencional
Por fim, não se esqueça de que, ao contrário de outros proxies de aceleração, balanceadores de carga ou controladores de entrega de aplicações (ADCs), o NGINX também é um servidor web completo. Você pode usar o NGINX para fornecer conteúdo estático, encaminhar o tráfego para servidores de aplicações em Java, PHP, Python, Ruby e outras linguagens, fornecer mídia (áudio e vídeo), integrar-se a sistemas de autenticação e segurança e até mesmo responder diretamente a transações usando regras incorporadas à configuração do NGINX.
Sem limitações de desempenho integradas, o NGINX e o NGINX Plus aproveitam ao máximo o hardware no qual são implantados, agora e no futuro.
Para experimentar o NGINX Plus, inicie hoje mesmo sua avaliação gratuita de 30 dias ou entre em contato conosco para discutir seus casos de uso.
Sobre o autor

Publicações relacionadas no blog

Como o F5 NGINX One aprimora o gerenciamento e a observabilidade
Descubra como o F5 NGINX One aprimora o gerenciamento e a observabilidade de ambientes híbridos e multicloud ao oferecer um console web centralizado baseado em SaaS, com insights em tempo real, conformidade automatizada e gerenciamento simplificado de configurações.

Do OpenAPI ao NGINX como gateway de API usando uma API declarativa
Descubra como transformar uma definição de esquema OpenAPI em uma configuração NGINX totalmente funcional, operando como um API Gateway com a segurança de um Web Application Firewall e um Portal do Desenvolvedor, usando uma abordagem declarativa de API.

Como gerenciar picos repentinos de tráfego e sobrecarga do servidor
Picos de tráfego e sobrecarga de servidores são preocupações sérias para varejistas online em qualquer época, mas especialmente durante a “Cyber Season” de compras de fim de ano. Detalhamos como você pode aproveitar as soluções de entrega de aplicações de nível de produção da NGINX para se preparar para aumentos repentinos de tráfego.

Distribuição segura de chaves privadas SSL com o NGINX
Descrevemos três maneiras progressivamente mais seguras de proteger chaves privadas SSL ao configurar o NGINX para processar tráfego HTTPS: permitir acesso de leitura apenas ao usuário root, criptografar as chaves com senhas armazenadas separadamente e distribuir as senhas a partir de um repositório central.

Agrupando solicitações de API em lotes com NGINX Plus e o módulo JavaScript do NGINX
O módulo JavaScript do NGINX lançado com o NGINX Plus R15 oferece suporte a subsolicitações, possibilitando uma classe totalmente nova de casos de uso para o NGINX Plus. Este exemplo completo também usa a API do NGINX Plus e os módulos de chave-valor para converter solicitações de API dos clientes em solicitações separadas para as APIs dos microsserviços que compõem um aplicativo.
Como superar o esgotamento de portas efêmeras no NGINX e no NGINX Plus
Confira dicas para evitar o esgotamento de portas efêmeras com ajustes no kernel do Linux, conexões keepalive e conexões vinculadas dinamicamente a endereços IP locais.