Em abril, escrevi sobre por que o antigo modelo de segurança de software não funciona mais. Aquele artigo abordou o problema e os princípios. Este trata do trabalho que estamos realizando na F5 para proteger nosso código.
Há cerca de nove meses, começamos a usar modelos de IA de ponta para analisar sistematicamente nosso próprio código-fonte em busca de vulnerabilidades. O que começou como uma exploração inicial do que esses modelos poderiam fazer em uma base de código real, em escala de produção, tornou-se desde então um dos investimentos mais significativos da nossa organização de produtos. Criamos uma infraestrutura dedicada, mobilizamos recursos de engenharia de toda a empresa e fizemos disso uma prioridade máxima em todos os níveis da organização.
Mais de 80% das empresas da lista Fortune Global 500 confiam na F5. Oferecemos suporte a mais da metade dos ambientes de controladores de entrega de aplicações (ADC) do mundo. Os 15 maiores bancos globais, os 30 maiores bancos comerciais dos EUA, as 10 maiores seguradoras globais, as 10 maiores empresas globais de telecomunicações e os 15 principais departamentos executivos dos EUA utilizam a F5 em sua infraestrutura.
Nós nos pautamos por um padrão mais elevado porque as organizações nos colocam em seus fluxos mais críticos: entre seus usuários e aplicações, e entre seus agentes e APIs.
No início, os modelos não eram muito bons. Agora são.
Quando começamos a trilhar esse caminho no segundo semestre de 2025, os modelos de ponta disponíveis para nós eram promissores, mas limitados. Eles conseguiam identificar problemas superficiais, mas sua capacidade de raciocinar sobre bases de código complexas, compreender o contexto entre diferentes módulos e distinguir vulnerabilidades reais de falsos positivos era inconsistente.
A taxa de falsos positivos era alta. Muito alta.
Tivemos que aprender muitas coisas do zero:
- Como criar um harness eficaz
- Como estruturar prompts que forneçam contexto suficiente para raciocinar sobre código real
- Como criar pipelines de verificação capazes de separar o sinal do ruído em grande escala
- Como usar a saída de um modelo como entrada para outro a fim de confirmar ou rejeitar os resultados
Não havia um manual genérico que pudéssemos aplicar à F5, então tivemos que criar um.
O ritmo de evolução desses modelos tem sido impressionante. Os modelos de ponta da Anthropic e da OpenAI, incluindo Claude Mythos e GPT Cyber, agora conseguem descobrir vulnerabilidades reais, demonstrar como elas podem ser exploradas e ajudar engenheiros a corrigi-las. Em alguns casos, esses modelos funcionam excepcionalmente bem com arquivos binários e código compilado, não apenas com código-fonte. Isso não era verdade no segundo semestre do ano passado.
Não somos os únicos a observar essa evolução. Temos trabalhado em estreita colaboração com algumas das maiores organizações do mundo, incluindo as que participam do Project Glasswing. São instituições que utilizam a F5 em seus fluxos mais críticos e estão enfrentando a mesma mudança que nós.
Alguns pontos ficaram claros:
- Os modelos de prévia e pesquisa são extraordinariamente capazes. Os modelos mais recentes da Anthropic e da OpenAI conseguem analisar código compilado, identificar cadeias complexas de vulnerabilidades e gerar provas de conceito sofisticadas.
- A taxa de aprimoramento dos modelos não é linear. Ela está acelerando. Cada nova geração de modelos representa um salto significativo em termos de capacidade. As organizações que não estão testando os modelos mais recentes em seu código estão ficando para trás.
- Os falsos positivos foram o gargalo inicial, não os modelos em si. Quando começamos, a relação sinal-ruído era extremamente desfavorável. Tivemos que investir muito na criação de estruturas de verificação, na automação da triagem e em ciclos de feedback que treinam o sistema para distinguir problemas reais de ruídos. Como resultado, nossa taxa de falsos positivos caiu, e agora conseguimos fornecer aos engenheiros problemas reais de segurança e defeitos a serem corrigidos.
- Proteger e controlar as vulnerabilidades identificadas por modelos de IA de fronteira é uma prioridade de segurança. Quando um modelo encontra uma vulnerabilidade crítica, como a execução remota de código, o tratamento dessas informações torna-se, por si só, uma operação de segurança. Aprendemos muito sobre como gerenciar isso de forma responsável.
Tudo isso reforça algo a que sempre volto: os mesmos modelos que usamos para encontrar vulnerabilidades são os que os adversários acabarão usando contra nós. A única estratégia responsável, do ponto de vista da teoria dos jogos, é usar continuamente modelos de IA de fronteira para analisar e aprimorar nosso código antes que um invasor o faça.
Desenvolvendo ferramentas, estruturas de teste e processos
Desenvolvemos ferramentas internas que representam uma abordagem fundamentalmente diferente para a análise de defeitos e o gerenciamento de vulnerabilidades.
Nossa base de código abrange dezenas de milhões de linhas em C, C++, Python, Tcl, Java, Go e C de baixo nível escrito para FPGAs. Os problemas que buscamos estão em códigos que operam em produção há anos, distribuídos por módulos que interagem de diferentes maneiras. Criar uma infraestrutura capaz de analisar toda essa superfície, abrangendo diferentes linguagens e camadas de abstração, foi um desafio técnico significativo.
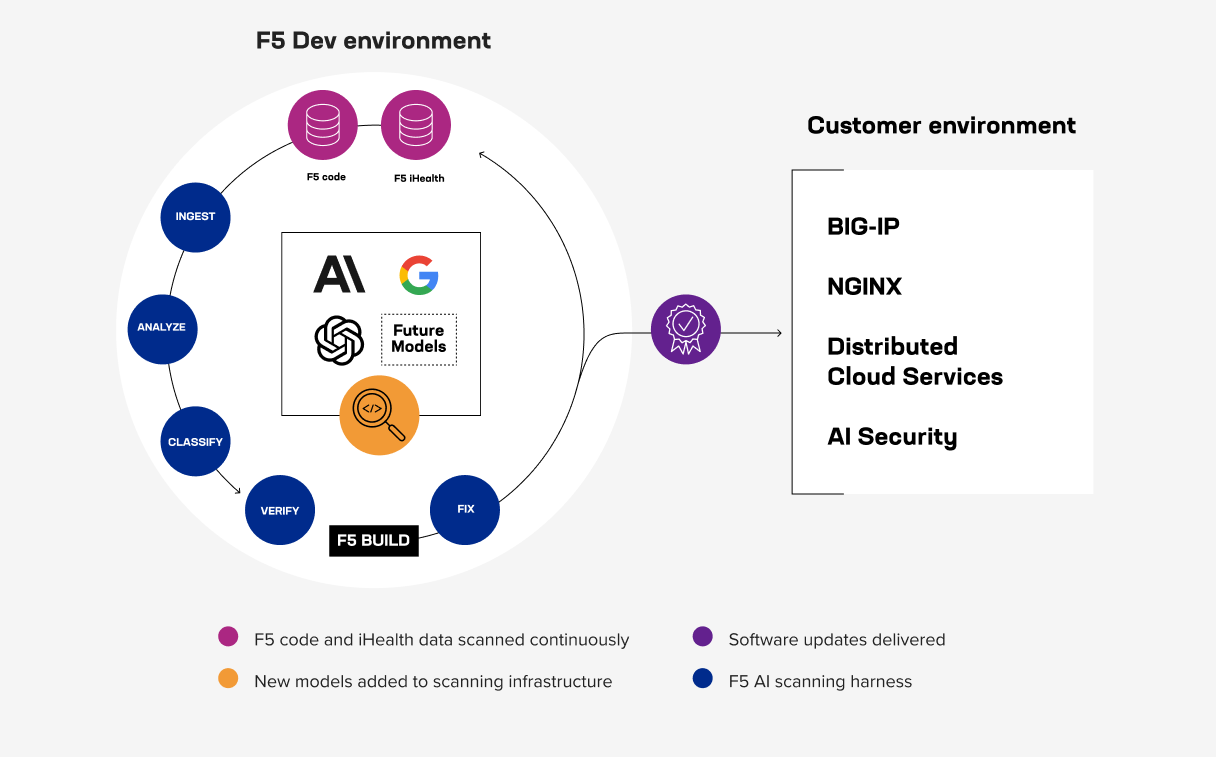
Uma das ferramentas que desenvolvemos incorpora novos modelos à medida que são disponibilizados por qualquer fornecedor e os executa continuamente em nossa base de código. Colaboramos ativamente com laboratórios de IA de ponta e temos acesso a alguns dos modelos mais avançados, incluindo modelos de prévia e de pesquisa. Essa ferramenta utiliza esses modelos em conjunto com teoria dos grafos, análise estática de composição e muito mais. Também fornecemos dados de inteligência sobre ameaças, incluindo conjuntos de dados públicos sobre vulnerabilidades e fraquezas.
Essa não é a única ferramenta do nosso arsenal. Nossas equipes desenvolveram ferramentas adicionais que buscam classes específicas de falhas e aproveitam o trabalho de outras organizações. Além disso, muitos dos laboratórios de ponta contam com estruturas altamente avançadas, projetadas para extrair o máximo dos modelos subjacentes.
Independentemente da ferramenta, a infraestrutura de varredura segue um processo rigoroso, composto por várias etapas, como descrito a seguir:
- Ingestão. Alimentamos os modelos com a base de código dos principais módulos e linguagens para que possam analisar detalhes reais da implementação, e não resumos ou abstrações.
- Análise. Executamos uma análise estática orientada por IA para detectar bugs, padrões de risco e fluxos suspeitos: falhas na lógica de autenticação, criptografia insegura, problemas de segurança de memória e muito mais.
- Classificar. Extraímos resultados estruturados, incluindo mapeamentos de CWE, avaliações de gravidade, referências a arquivos e linhas e contexto de explorabilidade.
- Verificar. Um segundo modelo confirma, rebaixa ou rejeita as constatações antes que elas entrem no fluxo de engenharia. É nessa etapa que o problema dos falsos positivos é enfrentado. No início, essa etapa praticamente não existia, e o volume de ruído era avassalador. Hoje, ela é uma das partes mais importantes do sistema.
- Corrigir. As descobertas validadas são encaminhadas para correção de acordo com a prioridade. As correções são desenvolvidas, testadas e lançadas.
Cada ciclo constrói uma base de conhecimento que torna o próximo ciclo mais rápido e preciso. Com o tempo, a própria base de código se torna mais resistente. Os modelos encontram menos porque há menos a encontrar. Esse é o efeito cumulativo no qual estamos investindo.
O que estamos descobrindo
Estamos encontrando problemas que existem em praticamente toda base de código madura: lacunas no reforço de segurança das configurações, configurações padrão que deveriam ser mais restritivas, problemas de segurança de memória (estouro de buffer, estouro de inteiros), condições de corrida e falhas na validação de entradas.
Esses são exatamente os tipos de problemas que queremos encontrar e corrigir. Em um mundo no qual os modelos de IA conseguem raciocinar sobre como encadear vulnerabilidades, eliminá-las sistematicamente torna toda a base de código significativamente mais resistente à exploração. Esses são os elementos fundamentais das cadeias de exploração, e removê-los torna o software mais difícil de atacar.
Uma nova competência: escanear, fazer a triagem, corrigir, testar, lançar e repetir
Um dos resultados mais importantes desse trabalho é a capacidade operacional que nossa organização de engenharia desenvolveu nos últimos meses. A varredura é apenas uma parte de uma capacidade de ponta a ponta que criamos e que não existia antes.
Estamos deixando de adotar um ciclo de lançamentos trimestral para disponibilizar, com mais frequência, versões reforçadas de todos os softwares. Essa é uma enorme mudança operacional. Tomemos como exemplo o rigor aplicado pela nossa equipe de engenharia do BIG-IP: ela está realizando testes em todas as combinações ativas de F5OS e TMOS presentes na nossa base de clientes. Cada combinação exige um ambiente de teste dedicado. Cada versão passa por um controle rigoroso de branches, testes de regressão e testes de longevidade. Estamos documentando os tempos de atualização e reinicialização e vinculando cada correção à respectiva versão, seja ela relacionada a um estouro de buffer, ao reforço da validação de entradas ou a uma CVE.
Há anos adotamos práticas rigorosas de varredura e testes. O que mudou foi o ciclo orientado por IA: varrer, fazer a triagem, corrigir, testar, lançar e repetir.
O que vem a seguir
Espere mais lançamentos à medida que a análise orientada por IA identificar mais vulnerabilidades. Isso é um sinal de segurança mais robusta, não de software mais fraco. Divulgaremos o que encontrarmos após publicarmos versões com segurança reforçada.
À medida que a frequência de correções aumenta em todo o setor, nossos clientes precisarão incorporar atualizações de todos os fornecedores com mais frequência. Estamos comprometidos em tornar esse processo mais fácil, não mais difícil. Aceleramos o trabalho de gerenciamento de frotas, atualizações automatizadas e simplificação dos fluxos de atualização porque esses recursos são essenciais.
Além disso, a segurança em tempo de execução precisa acompanhar esse ritmo. Os recursos de detecção e resposta baseados em IA serão uma linha de defesa essencial para identificar e neutralizar ameaças sem depender de assinaturas conhecidas nem esperar por uma correção. Estamos desenvolvendo esses recursos porque o cenário de ameaças assim exige. Em breve, compartilharemos mais novidades sobre isso.
Há nove meses, começamos a investigar se os modelos de IA de ponta poderiam mudar radicalmente a forma como encontramos e corrigimos vulnerabilidades em nosso próprio código. E podem. Os modelos são melhores do que esperávamos. Nossa capacidade operacional é mais robusta do que prevíamos, e a urgência só aumentou.
As organizações que nos confiam suas infraestruturas mais críticas não merecem nada menos do que isso.
Para saber mais, leia meu post anterior no blog, “A janela para correções se fechou. Veja como a F5 está preparada para o que vem a seguir.”
Sobre o autor

Kunal Anand lidera a organização de produtos da F5 como Chief Product Officer. Responsável pela visão, estratégia e execução de produtos, ele garante o desenvolvimento de soluções inovadoras que resolvem desafios críticos e proporcionam experiências excepcionais aos clientes. Em sua função anterior como Chief Technology and AI Officer, Kunal definiu a estratégia e a visão de tecnologia e IA da empresa. Antes da F5, Kunal exerceu simultaneamente os cargos de Chief Technology Officer e Chief Information Security Officer na Imperva. Sua trajetória na Imperva começou em 2018, com a aquisição da Prevoty, uma startup de segurança de aplicações que ele cofundou em 2013. Antes de ingressar na Prevoty, foi Diretor de Tecnologia na BBC Worldwide. Kunal tem um amplo histórico de inovação e conhecimento técnico especializado, além de ter ocupado cargos de liderança em equipes de segurança, dados, tecnologia e engenharia na Gravity, MySpace e no Laboratório de Propulsão a Jato da NASA. Kunal tem mais de 15 anos de experiência em IA e aprendizado de máquina, abrangendo treinamento de modelos, uso de algoritmos baseados em IA para aprimorar produtos e projeto e implementação de arquiteturas de IA. Kunal é bacharel em Ciência da Computação pelo Babson College.
Mais publicações de Kunal AnandPublicações relacionadas no blog

IA agêntica em cibersegurança: promessas e riscos
Saiba por que o uso de IA agêntica na cibersegurança é essencial para combater ameaças impulsionadas por IA e por que os agentes também criam novos riscos para as empresas.

Como os clientes da F5 no setor financeiro lidam com a soberania digital sem desacelerar a inovação
Como é a soberania digital na prática? Dois projetos recentes da F5 com clientes mostram como diferentes empresas estão enfrentando esses desafios.

Soberania operacional: construindo resiliência em um mundo imprevisível
Para muitas organizações, a questão já não se resume apenas a controlar os dados. Trata-se de manter a capacidade de operar, adaptar-se e se recuperar à medida que as leis e as condições evoluem.

Segurança de IA com evidências: o que levaremos ao Gartner SRM
Antes de sua sessão no Gartner SRM, o vice-presidente sênior de Marketing de Produtos da F5 explica como a F5 ajuda as organizações a proteger a IA em três etapas práticas.

Gestão de riscos de IA: como as proteções podem ajudar a mitigá-los
O risco da IA é impulsionado por comportamentos probabilísticos e pela explicabilidade limitada, não apenas por falhas de segurança. Uma gestão eficaz exige controle operacional contínuo.

Lei de IA do Colorado (SB 205): o que as empresas precisam saber antes de 2026
A SB 205 do Colorado, a lei pioneira do estado sobre inteligência artificial, foi sancionada pelo governador Jared Polis em 17 de maio de 2024. O projeto de lei estabelece requisitos para que as empresas que utilizam IA implementem controles destinados a proteger os cidadãos do Colorado.