Talvez o maior impacto nas operações causado pela migração abrupta de consumidores e funcionários para experiências digitais seja na disponibilidade. Sem dúvida, uma parcela significativa das organizações enfrentou dificuldades com o acesso remoto quando os funcionários deixaram o escritório para trabalhar em casa. No entanto, apenas alguns funcionários acabaram trabalhando de casa, enquanto populações inteiras passaram repentinamente a depender de alternativas digitais para as atividades do dia a dia.
Considere as conclusões da Nokia, que relata que o "tráfego de upload (em redes selecionadas nos EUA) no mês de março de 2020" registrou um "aumento de 30% em relação aos níveis anteriores à pandemia". Ou estes dados que mostram um aumento de 72% nas transações (e de 29% nas visualizações de páginas) na segunda semana de abril.
A demanda por experiências digitais está aumentando. E poucas coisas são mais frustrantes para um usuário do que um aplicativo ou site que não carrega. Para ser sincero, poucas coisas são mais frustrantes para um operador do que um aplicativo ou site que não carrega.
Alcançar alta disponibilidade não é apenas uma questão de inserir um balanceador de carga no caminho dos dados. Isso faz parte da equação, mas é apenas uma das etapas necessárias para garantir que um aplicativo ou site permaneça disponível.
A primeira coisa que você precisa fazer é responder a duas perguntas não tão simples:
- Como distribuir o tráfego entre os servidores para garantir alta disponibilidade?
- Qual nível de verificação de integridade é necessário para validar corretamente a disponibilidade de um servidor?
À primeira vista, essas questões parecem mais simples do que realmente são. Isso porque, para respondê-las, é preciso conhecer muito bem o aplicativo e sua infraestrutura.
Vamos começar?
Como distribuir o tráfego entre servidores para garantir alta disponibilidade?
Essa pergunta busca, na verdade, identificar o algoritmo de balanceamento de carga mais adequado, pois são os algoritmos que determinam como o tráfego (as solicitações) é distribuído entre os recursos (servidores). A resposta depende de muitos fatores, mas começa pela arquitetura do aplicativo e pelos padrões de uso.
Veja bem, se você está tentando tornar um aplicativo tradicional (monolítico, cliente-servidor, web de três camadas) altamente disponível, precisa entender os padrões de uso sob uma perspectiva totalmente diferente.
Isso acontece porque um único "servidor" de back-end é responsável por executar toda a lógica de negócios. Tentando fazer login? Comprando um produto? Navegando pelo catálogo? Tudo passa pelo mesmo "servidor". Você pode pensar que basta usar um algoritmo simples, como round-robin, para distribuir o tráfego. Au contraire, meu amigo. Cada função de negócios tem requisitos diferentes de processamento, memória, rede e dados. Isso significa que cada função de negócios impõe uma carga diferente ao "servidor". Uma única instância do "servidor" pode ficar rapidamente sobrecarregada simplesmente por receber solicitações demais que exigem muitos recursos.
A melhor maneira de otimizar a distribuição de solicitações para garantir a disponibilidade de aplicações tradicionais é usar um algoritmo baseado no menor número de conexões. Isso manterá a carga distribuída entre as instâncias dos "servidores" de acordo com o número de conexões abertas no momento. Isso funciona porque as solicitações que consomem muitos recursos levam mais tempo para serem processadas, mantendo as conexões ativas. Ao direcionar as solicitações para os "servidores" com menos conexões, é mais provável que todos eles permaneçam disponíveis.
Para aplicações modernas (baseadas em microsserviços), essa questão é mais fácil de responder. Isso ocorre porque uma aplicação moderna já é decomposta em funções de negócios que podem ser dimensionadas individualmente. Ainda é uma boa ideia usar um algoritmo baseado no menor número de conexões, pois algumas solicitações para a mesma função podem consumir mais recursos do que outras. No entanto, o tráfego é naturalmente balanceado em uma arquitetura de aplicação moderna, portanto praticamente qualquer algoritmo ajudará a manter todos os "servidores" disponíveis.
O interessante (pelo menos para mim) sobre disponibilidade é que saber como distribuir as solicitações é apenas metade da batalha. A outra metade, infelizmente, não envolve lasers vermelhos e azuis, mas depende da visibilidade do estado de integridade da aplicação.
Qual nível de verificação de integridade é necessário para validar corretamente a disponibilidade de um servidor?
É aqui que deveria entrar minha dissertação sobre observabilidade*, mas, para ser breve e preservar sua sanidade, vou apenas resumir assim:
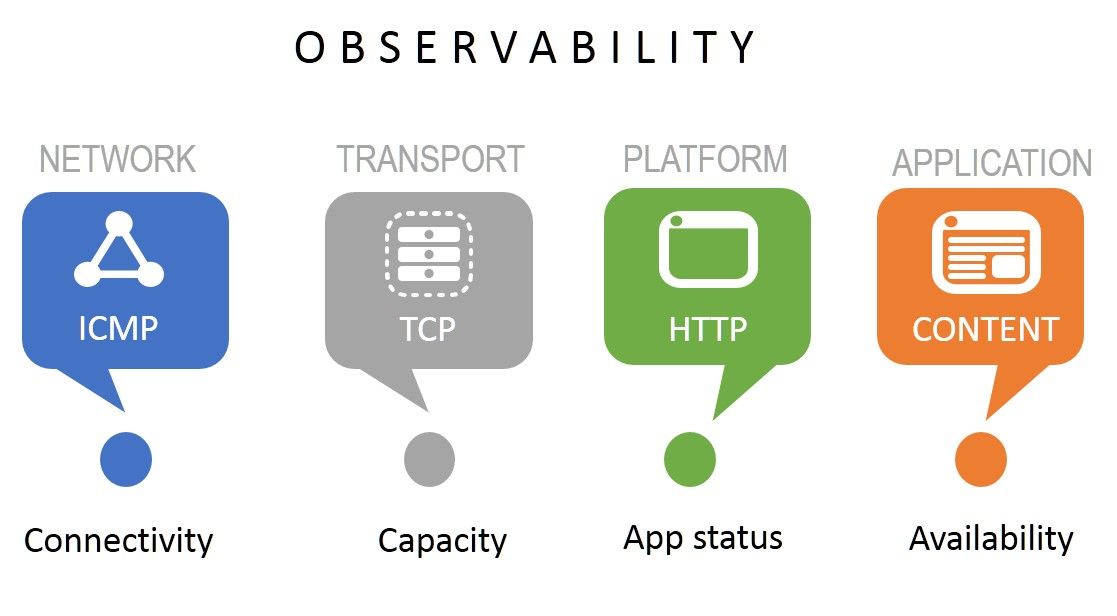
Se você estiver usando qualquer parâmetro que não seja a "disponibilidade da aplicação" para determinar o status de um aplicativo, estará colocando a alta disponibilidade em risco. Isso ocorre porque nenhuma das outras métricas observáveis fornece informações sobre o aplicativo. Embora seja necessário garantir a disponibilidade da rede, do transporte e da plataforma, enviar tráfego ao aplicativo antes de ter certeza de que ele está pronto para receber solicitações é procurar problemas.
Todos os quatro componentes da observabilidade são importantes. Afinal, se você perder a conectividade de rede, o restante realmente não importa. Portanto, é preciso monitorar as quatro métricas, o que significa verificar todas elas. Não importa qual seja a arquitetura do aplicativo. Todos os aplicativos dependem das camadas de rede, transporte e plataforma. É na camada do aplicativo que a arquitetura faz diferença, pois ela pode limitar a forma como você determina se o aplicativo está funcionando ou não.
Durante o desenvolvimento, você deve sempre solicitar uma forma de realizar uma "verificação de integridade" do aplicativo. Seja por meio de uma API ou de uma solicitação HTTP, a existência de uma "verificação de integridade" dedicada oferece aos desenvolvedores e à equipe de operações uma maneira fácil de confirmar que o aplicativo está funcionando corretamente. Isso pode incluir uma funcionalidade que verifique a conectividade com recursos externos, como fontes de dados ou APIs de parceiros. Como a falha de qualquer um desses componentes pode fazer com que o aplicativo pareça indisponível ou não responda ao usuário, é importante verificar a disponibilidade de todos os componentes necessários.
A alta disponibilidade é mais difícil do que parece
Muitas vezes, os materiais de marketing fazem parecer que a alta disponibilidade é tão simples quanto clonar um servidor e colocar um balanceador de carga na frente dele. Mas, na realidade, são necessárias análises criteriosas, medições e preparação para garantir que um aplicativo tenha alta disponibilidade. Não basta apenas assegurar que as instâncias estejam disponíveis; é preciso garantir que todos os aplicativos dos quais elas dependem também estejam disponíveis e distribuir as solicitações de modo a não sobrecarregar nenhuma instância específica.
O lado positivo de todo o trabalho extra dedicado a garantir a alta disponibilidade dos aplicativos é proporcionar uma experiência positiva aos clientes e receber menos ligações desesperadas tarde da noite por causa de aplicativos fora do ar.
* Na verdade, não tenho uma dissertação sobre observabilidade. Mas, se tivesse, ela teria sido inserida aqui.
Sobre o autor

Lori MacVittie é engenheira distinta e evangelista-chefe no Escritório do CTO da F5, com ampla experiência em entrega de aplicações, estratégia de automação e infraestrutura. Ela é conhecida por transformar complexidade em clareza, seja definindo diretrizes para agentes de IA, analisando arquiteturas multinuvem frágeis ou investigando os limites de sistemas escaláveis. Ela acumula mais de trinta anos de experiência no setor, abrangendo desenvolvimento de aplicações, arquitetura de TI e operações de redes e sistemas. Antes de ingressar na F5, atuou como editora de tecnologia e recebeu diversos prêmios. MacVittie tem mestrado em Ciência da Computação e é uma autora prolífica, com publicações que abrangem segurança, nuvem e arquitetura empresarial. Ela também é uma entusiasta de jogos de tabuleiro e videogames, além de ter opiniões assumidamente fortes sobre queijos.
Mais publicações de Lori Mac VittiePublicações relacionadas no blog

Entrega e proteção de agentes de IA em fábricas de IA: F5 para a arquitetura de referência NVIDIA OpenShell para agentes de IA seguros
As soluções da F5 ampliam a Arquitetura de Referência NVIDIA OpenShell para agentes de IA seguros.

Como medir – e minimizar – o custo total de propriedade do seu Kubernetes
O Kubernetes pode ser baixado e executado gratuitamente, mas sua manutenção está longe de não ter custos. Assim como outras grandes plataformas de código aberto que são “gratuitas” apenas em um sentido simplista, o Kubernetes quase certamente exigirá investimentos para ser implantado e operado.
As-Code: a pilha de TI contínua
Infraestrutura, configuração, pipeline, operações. De repente, tudo é “como código”. Lori MacVittie busca esclarecer a terminologia e identificar os diferentes componentes de uma stack contínua de TI.
O estado da entrega de aplicações em 2017: automação, APIs e DevOps
Explore o relatório State of Application Delivery de 2017. Leia o blog retrospectivo da F5 sobre o início da ascensão das redes declarativas e dos pipelines de DevOps.
DevOps Summit: onde a rede foi convidada para a festa
No DevOps Summit NY, falou-se muito não apenas sobre DevOps, mas também sobre contêineres, IoT e microsserviços. As sessões se concentraram não só na mudança cultural necessária para crescer em escala com uma abordagem DevOps, mas também fizeram questão de incluir...
F5 e Nutanix convergem em infraestrutura no .NEXT
Aplicações empresariais como Microsoft SharePoint e Exchange, juntamente com a VDI, continuam sendo a espinha dorsal da sua empresa. A produtividade, embora não seja tão atraente quanto o lucro, é um fator essencial para o sucesso das operações empresariais atuais. Deixar de...