
O que é alta disponibilidade?
Alta disponibilidade (HA) refere-se à capacidade de um sistema de operar continuamente — sem interrupções ou falhas —, geralmente por meio de mecanismos integrados de failover. Os sistemas de alta disponibilidade são projetados para continuar operando mesmo diante de eventos inesperados.
Por que a alta disponibilidade é importante
O principal objetivo da alta disponibilidade (HA) é evitar períodos de inatividade, ou seja, intervalos em que um sistema, serviço, aplicativo, serviço de nuvem ou recurso fica indisponível ou não funciona corretamente. Os períodos de inatividade resultam em perda de receita, redução da produtividade e danos à reputação da empresa. Por isso, a HA é importante para:
- Continuidade dos negócios – A alta disponibilidade (HA) garante que sistemas, recursos e funções essenciais estejam sempre operando conforme o esperado. Os sistemas de HA se recuperam rapidamente de falhas, permitindo que as organizações continuem atendendo aos clientes normalmente (de preferência, sem uma interrupção perceptível).
- Experiência do usuário aprimorada – Sistemas rápidos e confiáveis ajudam a manter a satisfação dos clientes e a evitar os impactos negativos da perda de receita, do comprometimento de dados e da perda de produtividade.
- Vantagem competitiva – Altos níveis de disponibilidade ajudam as organizações a se diferenciar ao oferecer serviços mais rápidos e confiáveis do que os da concorrência. Isso demonstra um compromisso com a qualidade geral e a satisfação do cliente.
Tipos de alta disponibilidade
Existem vários tipos de alta disponibilidade (HA), que podem ser classificados de acordo com o nível de redundância necessário, o tipo de tolerância a falhas exigido e o tipo de sistema que está sendo protegido. Os tipos mais comuns de HA incluem:
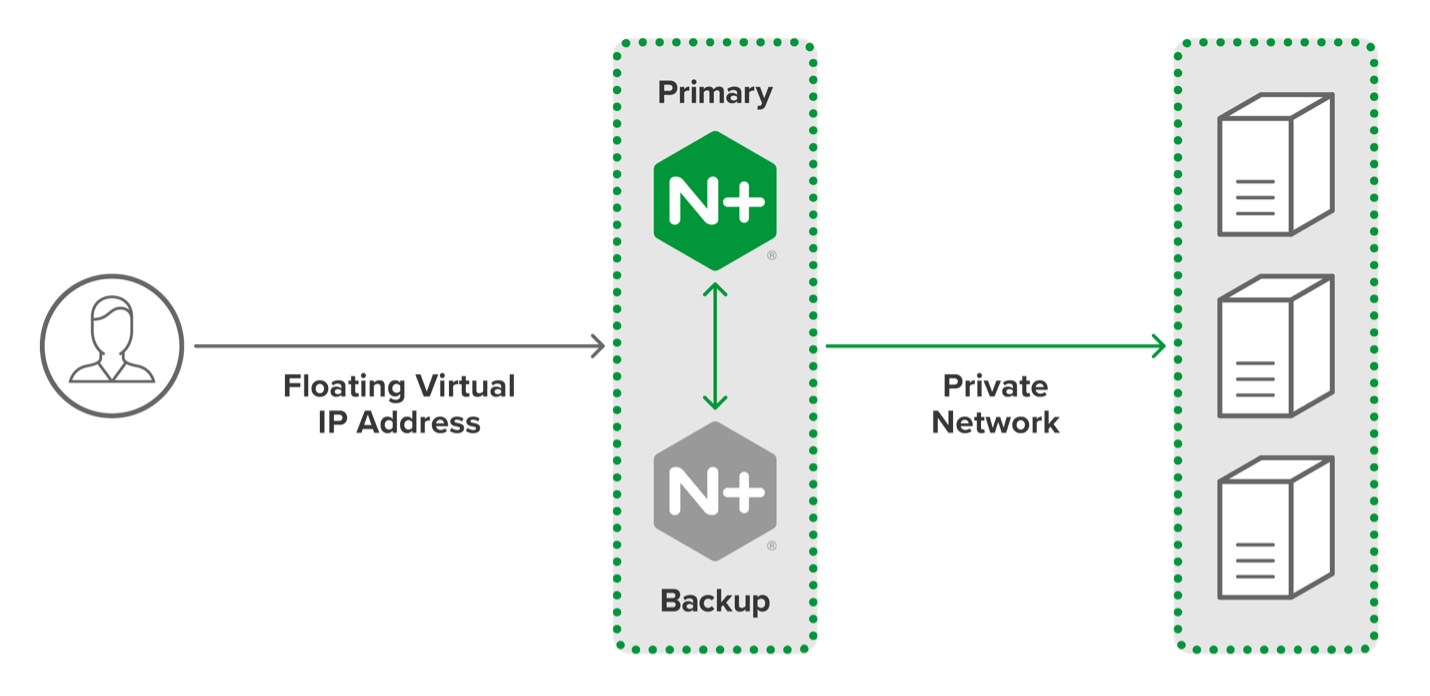
- Ativo-passivo – Um sistema de backup é mantido em modo passivo ou de espera e só é ativado se o sistema principal falhar. Esse método de proteção por failover às vezes exige intervenção manual para alternar para o sistema de backup.
- Ativo-ativo – Vários sistemas operam ativamente e compartilham a carga de trabalho. Se um sistema falhar, os demais assumirão automaticamente essa carga. Esse tipo de alta disponibilidade exige configuração e coordenação mais complexas entre os sistemas, mas oferece melhor desempenho e escalabilidade do que uma opção manual.
Este diagrama mostra um cluster de alta disponibilidade ativo-passivo com dois servidores NGINX Plus. O NGINX também oferece suporte a configurações de alta disponibilidade ativo-ativo e outras configurações de alta disponibilidade.
Como a alta disponibilidade é implementada?
Os mecanismos de redundância e failover evitam pontos únicos de falha, de modo que a falha de um componente não prejudique a operação do sistema, aplicativo ou recurso como um todo. Os mecanismos mais comuns incluem:
- Componentes redundantes – Implemente vários servidores, conexões de rede, sistemas de armazenamento e fontes de alimentação no sistema. Se um componente falhar, outro assumirá sua função sem interrupções.
- Monitoramento e alertas – Monitore constantemente o desempenho e a disponibilidade. Quando uma interrupção ou outro problema é detectado, um alerta é gerado. Os administradores do sistema podem identificar e resolver rapidamente quaisquer problemas, reduzindo o risco de indisponibilidade.
- Balanceamento de carga – Um ou mais servidores especializados interceptam as solicitações destinadas a um grupo de sistemas (de backend), distribuindo o tráfego entre eles para obter o melhor desempenho. Se um dos sistemas de backend falhar, os balanceadores de carga redirecionam automaticamente as solicitações recebidas para os outros sistemas.
- Mecanismos de failover – Implemente configurações ativo-passivo ou ativo-ativo, ou clusters de failover, para garantir que, se um sistema falhar, outro possa assumir com o mínimo de interrupção.
- Sistemas de backup e recuperação – Garanta que os dados e aplicativos possam ser restaurados rapidamente em caso de falha. Os sistemas podem ser híbridos, estar em locais diferentes, ser baseados em nuvem ou ser colocados em operação rapidamente após uma falha.
Como garantir a alta disponibilidade
Os serviços e recursos que você precisa implantar para fornecer alta disponibilidade dependem do tipo de sistema, do tipo de alta disponibilidade e dos requisitos específicos da sua organização. Os elementos de suporte incluem:
- Suporte técnico – A primeira linha de defesa para organizações que precisam de ajuda com seus sistemas de alta disponibilidade (HA). A equipe de suporte dedicada pode auxiliar na identificação, no diagnóstico e na resolução de problemas. Ela também pode fornecer orientações sobre as práticas recomendadas para manter altos níveis de disponibilidade.
- Manutenção e atualizações – Para permanecerem operacionais e seguros, os sistemas de alta disponibilidade devem passar por manutenção regular e executar as versões mais recentes dos softwares disponíveis.
- Planejamento de recuperação de desastres – Essencial para organizações que precisam restaurar sistemas rapidamente. Procedimentos predefinidos e documentados evitam que os administradores de sistemas tenham que se lembrar de soluções ou elaborá-las durante emergências.
- Documentação e treinamento – Ajudam os administradores de sistemas a entender como gerenciar seus sistemas de alta disponibilidade (HA). A documentação pode incluir práticas recomendadas, tutoriais e sessões de treinamento.
Práticas recomendadas: alta disponibilidade
Seguir as melhores práticas melhora o desempenho operacional e minimiza períodos de inatividade dispendiosos. Essas práticas recomendadas comuns podem ser adaptadas aos sistemas, locais e resultados desejados de uma organização.
- Incorpore redundância – Todos os níveis do sistema, desde os componentes de hardware até as conexões de rede, são reforçados para que, se um componente falhar, o sistema continue operando conforme o esperado.
- Balanceie a carga do tráfego – Ao distribuir as solicitações recebidas entre vários sistemas, você permite que os sistemas ainda operacionais assumam o processamento quando um deles falhar.
- Monitore o desempenho e a disponibilidade – O monitoramento contínuo e os alertas reduzem o tempo necessário para identificar e resolver problemas.
- Teste e valide frequentemente os mecanismos de failover – Realize testes periódicos para determinar se os mecanismos de failover ainda são capazes de assumir uma função de forma confiável em caso de interrupção.
- Procedimentos de backup e recuperação – Garanta que os dados e aplicativos possam ser restaurados rapidamente em caso de falha.
- Atualize e faça a manutenção dos sistemas regularmente – Isso mantém os aplicativos e sistemas operacionais e seguros.
- Treine a equipe – Testes regulares e o reforço dos procedimentos devem fazer parte do procedimento operacional padrão, especialmente para os indivíduos e as equipes responsáveis pela alta disponibilidade (HA).
- Considere soluções em nuvem – O armazenamento em nuvem e a recuperação de desastres permitem que os sistemas continuem operando independentemente do local da falha.
- Monitore a segurança – Implemente medidas que evitem violações de dados ou o acesso aos sistemas por agentes mal-intencionados ou usuários não autorizados.