
El equipo de soluciones de Volterra diseña y mantiene numerosos casos de uso potenciales de la plataforma Volterra para demostrar el valor que puede aportar. Estos casos de uso suelen convertirse en guías prácticas que los clientes utilizan para adquirir su primera experiencia directa con Volterra.
El equipo de soluciones quería disponer de un método automatizado y más rápido para desplegar internamente nuestros casos de uso bajo demanda, con la mínima intervención humana posible. Nuestros despliegues abarcaban un entorno híbrido multicloud que utilizaba tanto plataformas IaaS (AWS, Azure y GCP) como entornos de centros de datos privados (VMware vSphere y Vagrant KVM). Queríamos simplificar la gestión de estos entornos mediante una única herramienta capaz de crear despliegues en cualquier entorno, sin que cada usuario tuviera que crear cuentas de acceso adicionales ni gestionar credenciales de usuario adicionales para cada plataforma de virtualización o proveedor de IaaS. Esta herramienta también debía ser escalable para admitir varios usuarios y despliegues simultáneos.
En resumen, el principal problema que queríamos resolver era crear una herramienta automatizada para desplegar casos de uso de soluciones, capaz de escalar y gestionar despliegues simultáneos en entornos híbridos multinube con la mínima intervención posible por parte del usuario.
El proyecto Altered-Carbon (AC)
Para ello, creamos un proyecto llamado Altered-Carbon, a menudo abreviado como AC. El proyecto AC es una canalización dinámica de GitLab capaz de crear más de 20 casos de uso diferentes de soluciones de Volterra. Mediante la automatización de la canalización, creamos «despliegues con solo pulsar un botón» que se ejecutan con un único comando y permiten a los usuarios desplegar fácilmente varios clústeres de casos de uso bajo demanda o mediante tareas cron diarias programadas.
Como referencia, en AC denominamos a cada despliegue STACK y a cada caso de uso único SLEEVE.
Desarrollo de proyectos
Comenzamos el desarrollo del proyecto AC automatizando el caso de uso hello-cloud en el primer SLEEVE. El caso de uso hello-cloud crea un sitio de Volterra en AWS y otro en Azure; a continuación, combina ambos sitios en un clúster VK8s (Kubernetes virtual) de Volterra y despliega una aplicación de 10 pods en los dos sitios mediante VK8s. Iniciamos el proceso creando plantillas adicionales de Terraform y scripts de shell que utilizaban la API de Volterra para crear un flujo de trabajo de GitLab totalmente automatizado y gestionable mediante canalizaciones de CI/CD. Después, nos pusimos manos a la obra para que esta metodología de despliegue fuera reutilizable y escalable.
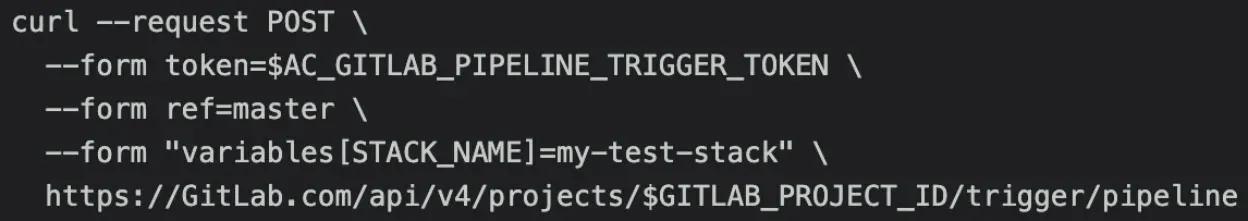
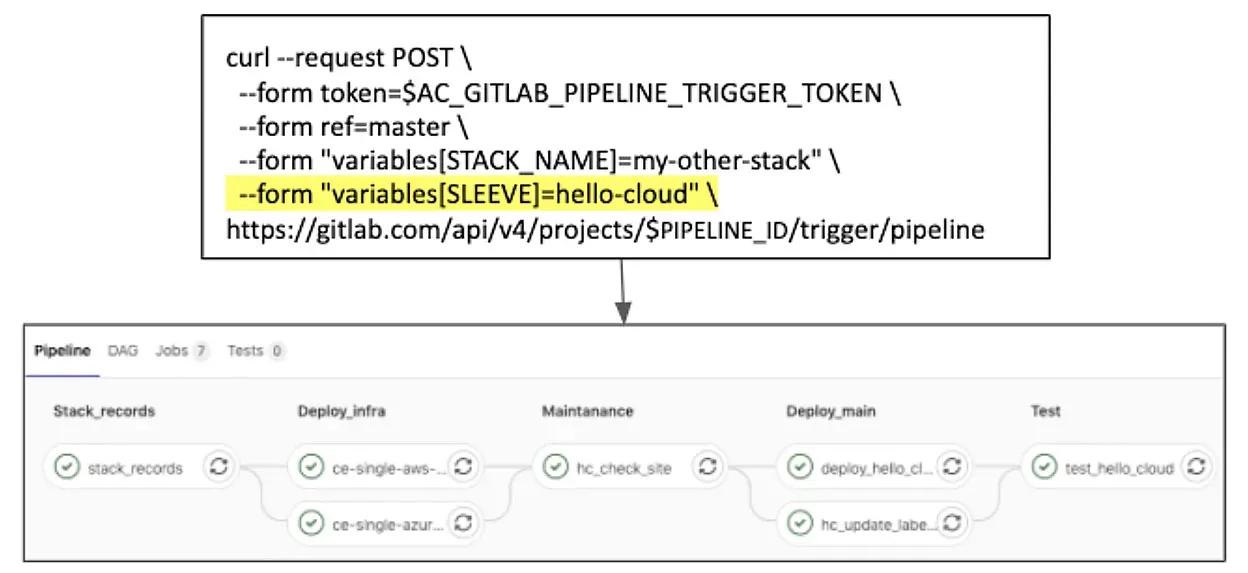
El siguiente problema que abordamos en nuestro diseño fue la incorporación de convenciones de nomenclatura únicas. Para permitir varios despliegues del caso de uso en un único entorno de tenant de Volterra, debíamos asegurarnos de que los recursos creados en cada STACK tuvieran nombres únicos y no intentaran crear recursos con nombres ya utilizados por otros STACKs del mismo entorno de tenant de Volterra. Para resolver posibles conflictos con las convenciones de nomenclatura, comenzamos a incorporar en los activadores de las canalizaciones el concepto de variables de entorno únicas proporcionadas por el usuario, que acabarían siendo fundamentales para el proyecto. Se introdujo la variable de entorno STACK_NAME y terraform la utilizó para incluir una cadena definida por el usuario en los nombres de todos los recursos asociados a un STACK específico. En lugar de activarse con cada commit, las condiciones de activación de los trabajos de las canalizaciones de AC se configuraron para que solo se ejecutaran cuando un usuario de GitLab las activara mediante una llamada a la API con un token de activación de CI de un proyecto de GitLab, lo que permitía controlar la canalización mediante la intervención humana o llamadas externas a la API. Mediante llamadas a la API similares a la del siguiente ejemplo, los usuarios podían alcanzar nuestro objetivo de crear varios despliegues sin conflictos entre recursos con un solo comando.
A continuación, nos propusimos crear opciones de despliegue adicionales a partir de este modelo. Los despliegues del sitio de hello-cloud en AWS y Azure también eran casos de uso independientes que queríamos desplegar por separado con AC. Esto nos llevó a encontrarnos con nuestro primer problema importante con GitLab. En las canalizaciones de CI/CD de GitLab, todas las tareas de la canalización de un proyecto están conectadas. Esto resultaba poco intuitivo, ya que muchas de las tareas necesarias para nuestro despliegue de hello-cloud no serían necesarias en los despliegues del sitio en AWS o Azure. En esencia, queríamos que una única canalización de CI de un proyecto de GitLab contuviera varias canalizaciones independientes que pudieran activarse bajo demanda con conjuntos distintos de tareas de CI cuando fueran necesarias.
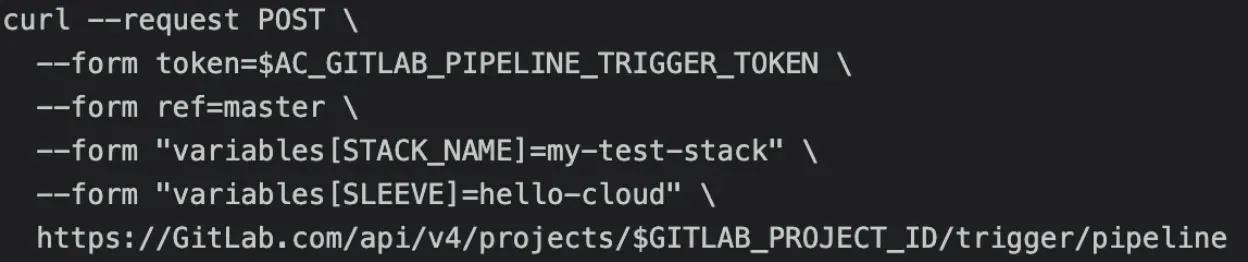
Para resolver este problema, introdujimos la variable de entorno SLEEVE en la estructura del pipeline, que incorporaba las opciones only/except de GitLab CI/CD. Esto permitió limitar los trabajos de CI activados en cualquier pipeline en función del valor de SLEEVE proporcionado al activar el pipeline. Finalmente, establecimos nuestras tres opciones iniciales de SLEEVE: simple-aws, simple-azure y hello-cloud. Cada SLEEVE definiría el caso de uso que un usuario deseaba desplegar (controlando así los trabajos de CI del pipeline activado) y un STACK_NAME para asignar un nombre a los recursos creados por cualquier pipeline activado. La siguiente estructura de comandos, que incorporaba ambas variables de entorno, sirvió como el comando de AC más básico y sigue utilizándose hoy en día:
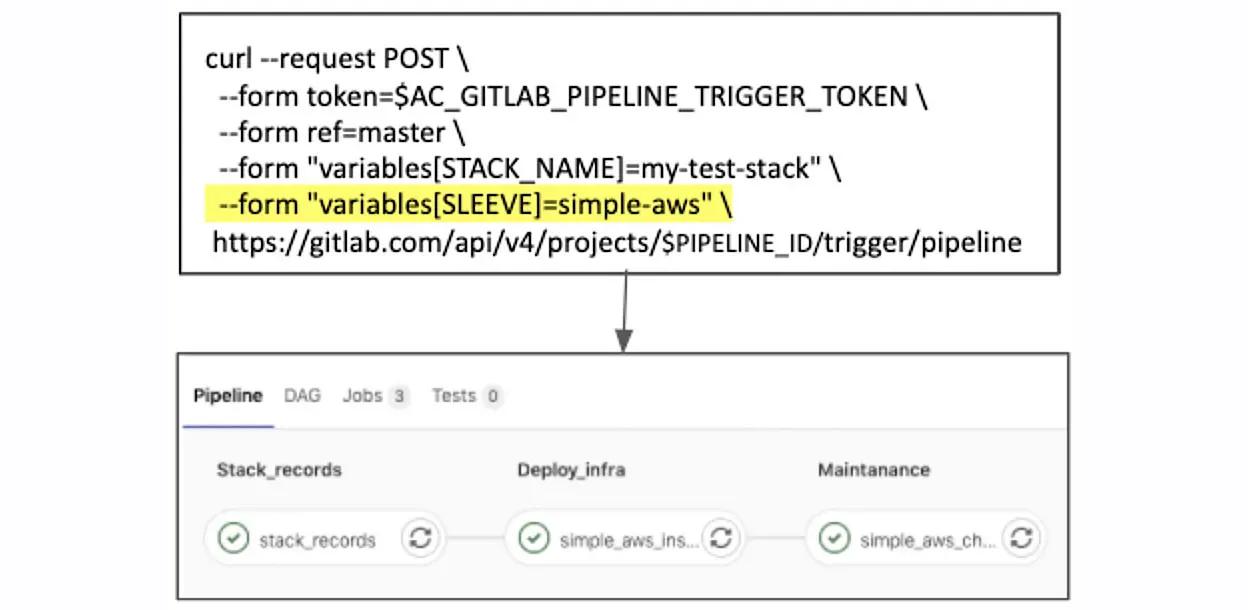
La siguiente imagen muestra de forma visual cómo el cambio de la variable de entorno SLEEVE modifica los trabajos que se activan en cada ejecución del pipeline de AC.
Pipeline SLEEVE «simple-aws»:
Pipeline «hello-cloud» de SLEEVE:
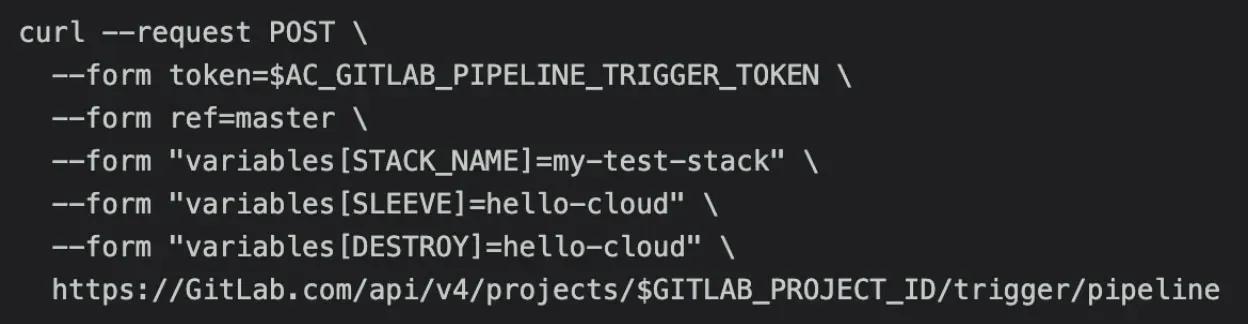
También introdujimos tareas adicionales que se activarían si se proporcionara la variable de entorno DESTROY en cualquier activador de la canalización. Esto ofrecería una opción inversa para eliminar los recursos creados por AC. El siguiente ejemplo muestra cómo eliminar los recursos de una STACK existente:
Otras variables de entorno se almacenaban en GitLab con valores predeterminados que podían sobrescribirse añadiendo valores al comando de activación. Por ejemplo, la URL de la API de nuestros entornos de tenant de Volterra se almacenaba en la variable de entorno VOLTERRATENANT. Si un usuario añadía la variable de entorno VOLTERRATENANT a su comando de API, se sobrescribía el valor predeterminado y se redirigía el despliegue a la ubicación deseada. Esto resultó ser muy importante para nuestra capacidad de realizar pruebas internas, ya que el equipo de soluciones gestiona decenas de entornos de tenant de Volterra y necesita poder alternar entre ellos en función de la tarea en cuestión:
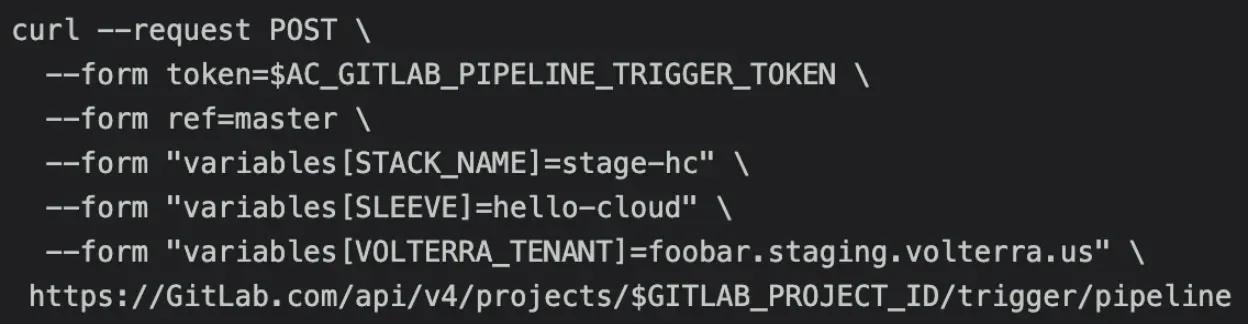
Estas variables de entorno opcionales podían utilizarse para ejercer un mayor control sobre los despliegues cuando fuera necesario, al tiempo que ofrecían una opción de despliegue predeterminada más sencilla para los usuarios que no querían asumir esta carga adicional de gestión. También nos permitían alternar fácilmente entre los despliegues en los entornos de preproducción y producción, algo que resultaría esencial para nuestro mayor consumidor de AC.
Caso de uso de Solutions: pruebas de regresión nocturnas
Como se ha mencionado anteriormente, cada SLEEVE de AC representaba un caso de uso de Volterra que, a menudo, constituía el primer contacto de los clientes con el producto. Garantizar que estos casos de uso funcionaran correctamente y no tuvieran errores era fundamental para causar una buena primera impresión del producto. Antes de la creación de AC, probar los casos de uso para confirmar que funcionaban y estaban actualizados con las últimas versiones del software y la API de Volterra era una tarea que requería mucho tiempo. Las partes manuales necesarias para cada caso de uso limitaban las pruebas de regresión, que no se realizaban con la frecuencia suficiente y eran propensas a errores humanos.
Sin embargo, gracias a la automatización de AC, se podían utilizar tareas programadas diariamente para iniciar el despliegue de cualquier caso de uso específico mediante un SLEEVE y, a continuación, eliminar los recursos creados una vez que el despliegue hubiera finalizado correctamente o hubiera fallado. Esto se utilizaba tanto en entornos de preproducción como de producción para comprobar si los cambios recientes en cualquiera de ellos habían afectado al despliegue del caso de uso o habían provocado errores en el software de Volterra. De este modo, podíamos actualizar nuestras guías de casos de uso para reflejar los errores detectados o identificar rápidamente errores en el software de Volterra y enviar solicitudes para su resolución.
Creamos un repositorio y un pipeline independientes con trabajos programados que utilizaban los comandos de activación de la API de GitLab para generar simultáneamente varias pilas mediante distintos SLEEVE. Cada trabajo de prueba de humo comenzaba activando la creación de una pila con un pipeline de AC independiente. A continuación, el trabajo de prueba de humo obtenía el ID del pipeline de la salida estándar de la llamada de activación del pipeline y utilizaba la API de GitLab para supervisar el estado del pipeline que había activado. Cuando el pipeline finalizaba (correctamente o con errores), ejecutaba el pipeline de destrucción en la misma STACK que había creado para eliminar los recursos después de la prueba.
La siguiente imagen detalla este proceso y muestra los trabajos que activa en AC para sus comandos de creación y destrucción:
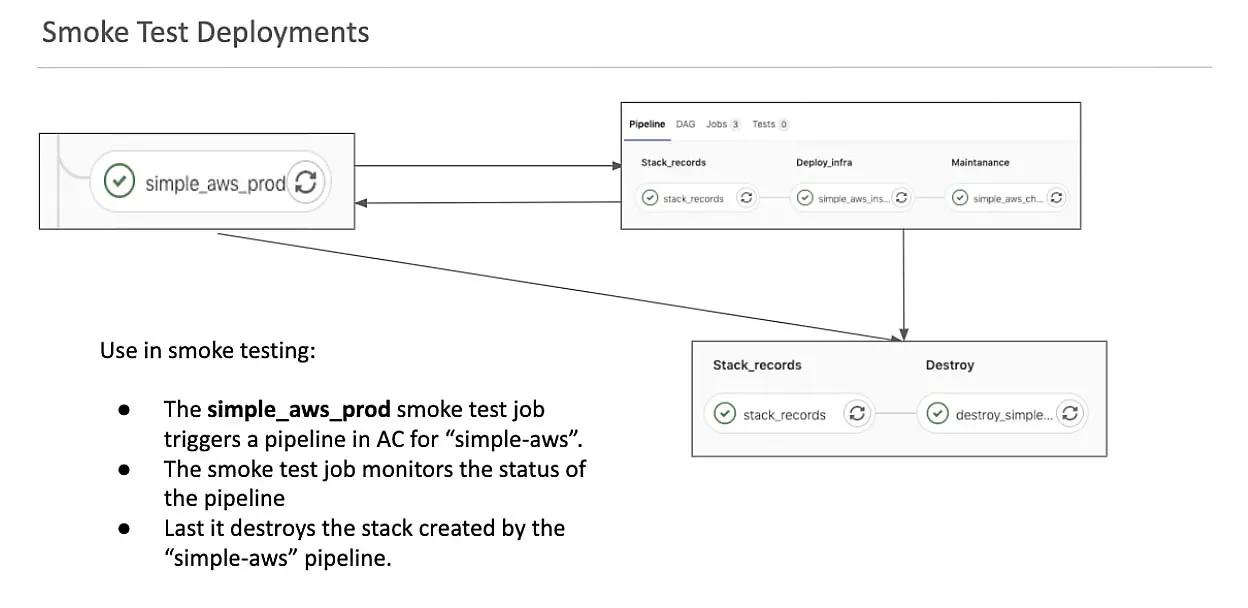
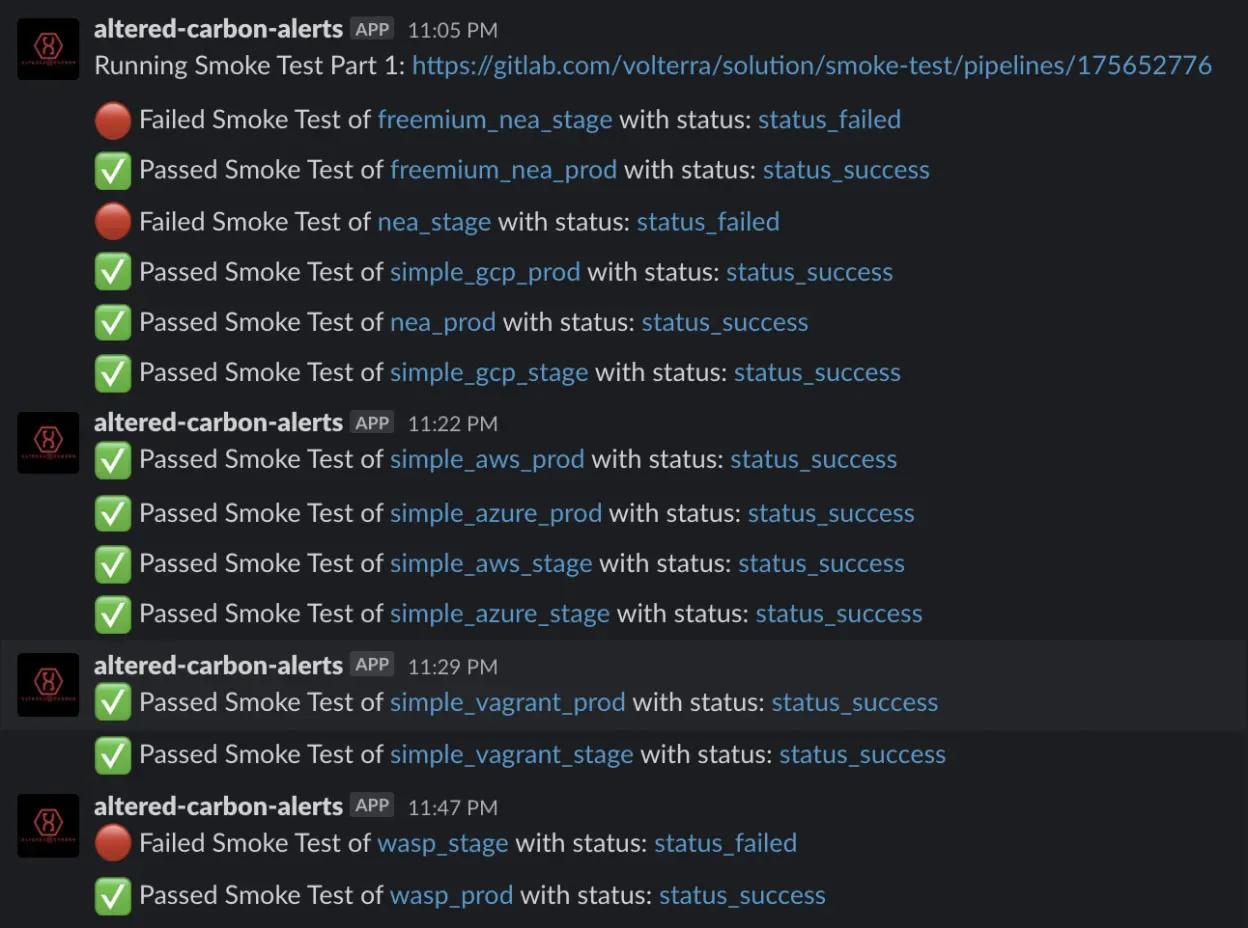
Cuando fallaba una canalización de pruebas de humo, podíamos proporcionar las variables de entorno que se podían utilizar en un activador de AC para reproducir el problema. Esta información podía incluirse en nuestros tickets de incidencias técnicas, lo que permitía a nuestros desarrolladores recrear fácilmente los despliegues fallidos. Después, a medida que se completaban más SLEEVES, añadíamos cada vez más tareas a las canalizaciones de CI, lo que permitía ampliar la cobertura de las pruebas. Para mejorar aún más la visibilidad de estas pruebas, añadimos una integración con Slack e hicimos que las tareas de pruebas de humo enviaran un mensaje indicando el éxito o el fracaso de cada ejecución de la canalización, con enlaces e información detallada de las páginas web de CI correspondientes tanto en el proyecto Altered-Carbon como en Smoke-Test.
Registro de pilas y navegación por la URL web de la canalización
La complejidad del proyecto aumentó a medida que AC evolucionaba, incorporaba nuevos usuarios del equipo de soluciones y creaba cada vez más stacks. Esto empezó a generar problemas importantes al navegar por la interfaz web de GitLab Pipeline. Utilizábamos los pipelines de GitLab de una forma muy poco convencional, lo que dificultaba el uso de su interfaz web para rastrear las ejecuciones individuales de los pipelines relacionadas con los STACKs que estábamos creando.
Las canalizaciones de GitLab que gestionan despliegues mediante flujos de trabajo de GitOps parecen funcionar mejor cuando se utilizan con un conjunto estático y definido de clústeres. En este caso, cada ejecución de una canalización de GitLab afectaría siempre a los mismos clústeres y recursos. Así, el historial de despliegues de estos clústeres sería el historial de canalizaciones que se muestra en la interfaz web de GitLab. Sin embargo, AC es dinámico y gestiona un conjunto de recursos en constante cambio, por lo que cada ejecución de una canalización puede utilizar un conjunto de tareas completamente distinto y gestionar diferentes STACK de recursos en distintos proveedores de virtualización. Esta diferenciación, derivada de las convenciones SLEEVE y STACK, hacía muy difícil determinar qué canalización correspondía a cada STACK. Por ejemplo, podemos consultar la interfaz web de canalizaciones de CI/CD de GitLab para AC:
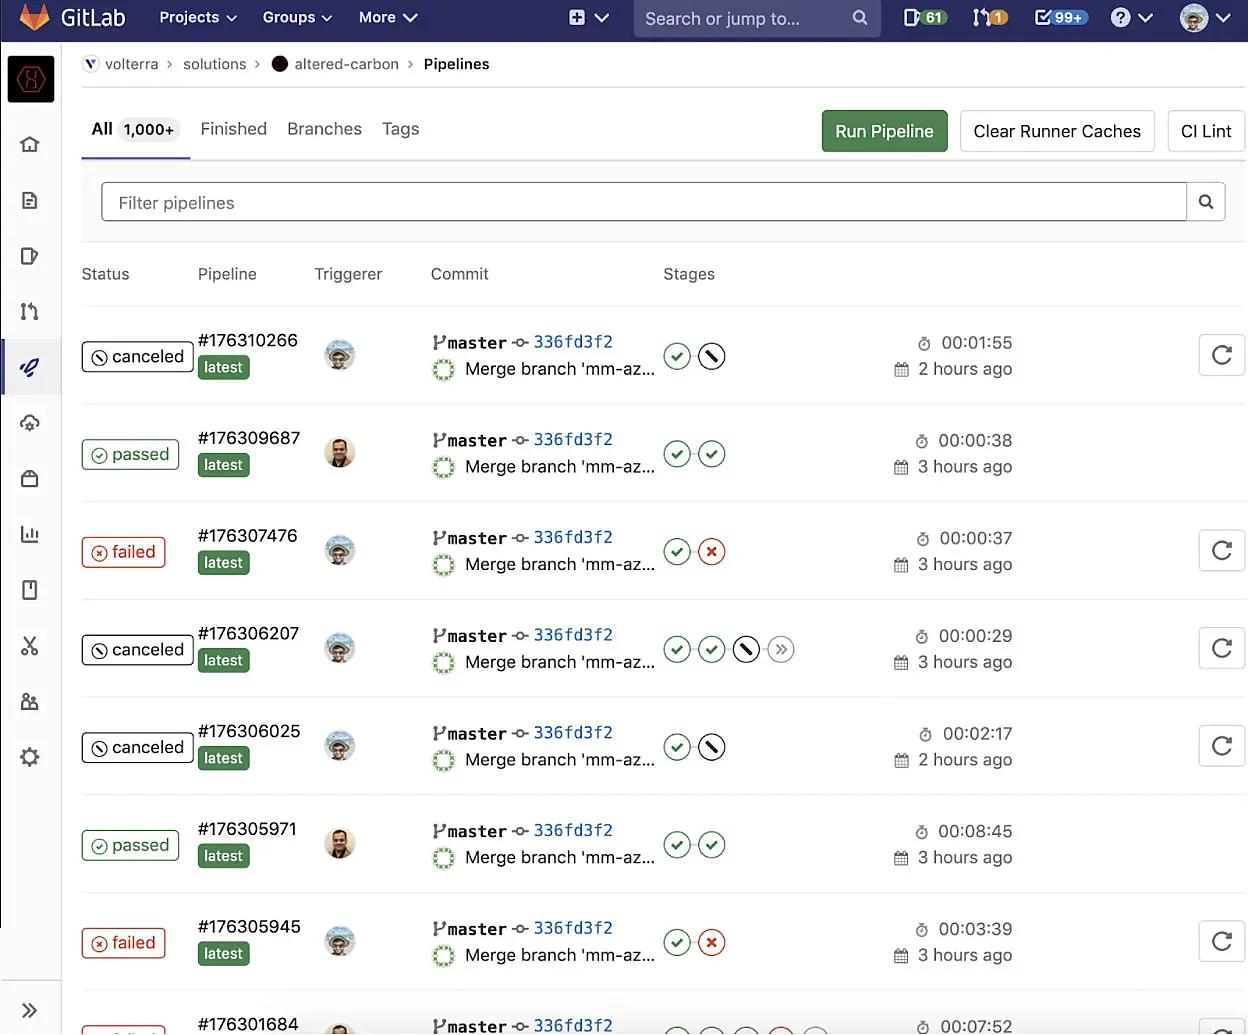
Desde esta vista, no podemos determinar qué STACK o SLEEVE está modificando una canalización concreta sin revisar cada canalización por separado. Cuando se ejecutan cientos de canalizaciones al día, puede resultar tedioso encontrar la ejecución específica que creó o destruyó una STACK concreta, o localizar información específica sobre dicha STACK. Para resolver este problema en las primeras fases del desarrollo de AC, añadimos un sencillo sistema de registro. Antes de cualquier canalización se ejecutaba un trabajo denominado stack-records. Este trabajo recopilaba información sobre la stack en el momento de su creación y generaba un archivo JSON que se cargaba en nuestro bucket de almacenamiento S3, utilizado para guardar las copias de seguridad de tfstate. A continuación, vemos un ejemplo de un registro de stack:
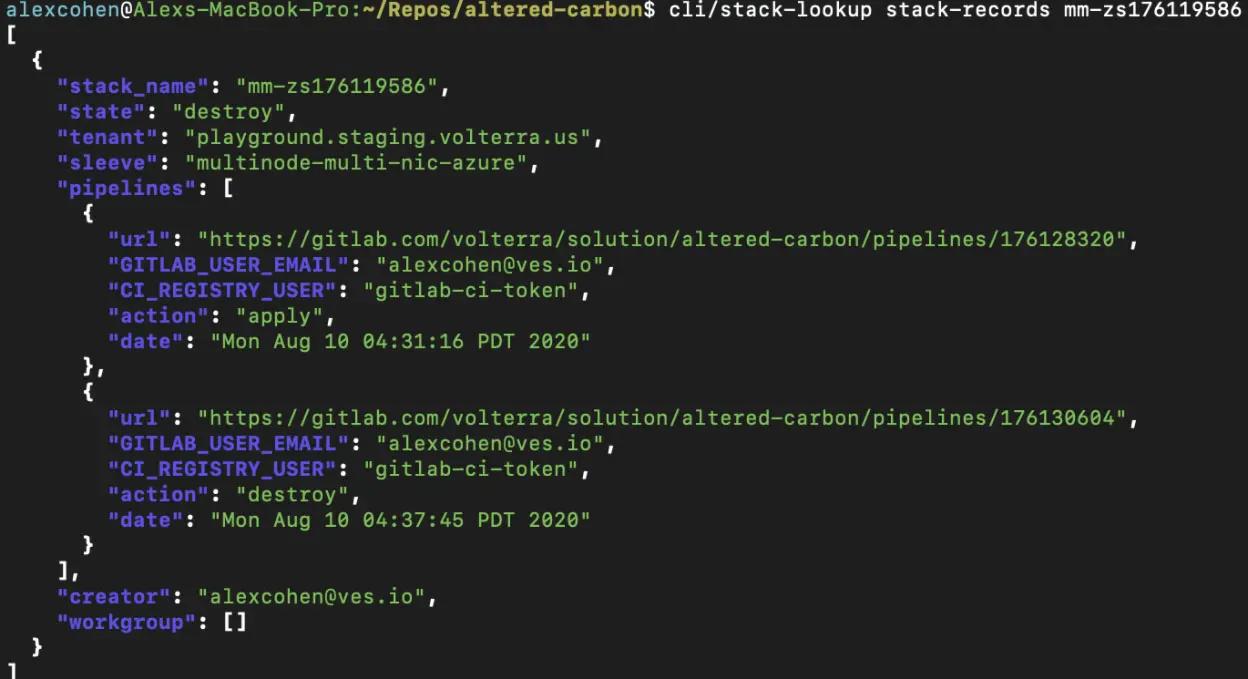
Los archivos stack-record.json incluyen información detallada de cada pila, como:
- Qué entorno de inquilino de Volterra se utilizó.
- Qué SLEEVE se utilizó.
- Si el STACK se estaba ejecutando en ese momento en el estado «apply» o si sus recursos se eliminaron con el estado «destroy».
- Qué usuario de GitLab creó la pila.
- Un grupo de trabajo que enumera a otros usuarios con acceso para modificar una PILA.
- Y, lo que es más importante, una matriz de pipelines que incluiría la URL web de cada ejecución de pipeline realizada en la pila, quién activó el pipeline, si este aplicó o destruyó una pila y cuándo se activó.
Esto proporcionaba un historial registrado de todas las URL de las canalizaciones asociadas a cada pila. Además, para simplificar aún más el proceso, se creó un sencillo script de CLI capaz de acceder a estos archivos mediante llamadas a la API de S3. Los usuarios de AC podían utilizar estos documentos para consultar el historial de las pilas y saber cuándo se habían modificado revisando sus registros.
Los registros de las pilas también nos permitieron implementar ciertos niveles de control de usuarios y detección de errores en las canalizaciones que desplegamos. Por ejemplo, un cambio realizado en el software de Volterra tras la creación de AC nos obligó a empezar a limitar a 17 caracteres los nombres de los clústeres de sitios (un valor derivado de STACKNAME) utilizados al crear sitios en Volterra. Por ello, añadimos una comprobación a la tarea de registros de las pilas para que las canalizaciones fallaran antes de ejecutar cualquier paso de despliegue si STACKNAME superaba el límite de caracteres. También se añadieron otros controles personalizados, como niveles de permisos de usuario en AC que restringen qué usuarios pueden modificar determinadas pilas gestionadas por AC.
- Permisos de nivel de administrador, con los que los dos desarrolladores principales de AC pueden crear o destruir cualquier stack con fines de depuración. -El nivel de propietario o creador corresponde al usuario de GitLab que crea inicialmente un STACK. Su dirección de correo electrónico de GitLab se registra en los registros del stack como creador, y dicho usuario puede crear o destruir un stack.
- A continuación, tenemos los permisos de nivel de grupo de trabajo. El correo electrónico del usuario de GitLab se puede añadir al array del grupo de trabajo del registro de la pila, lo que permite a usuarios distintos del creador aplicar o destruir una PILA.
- Un usuario que no disponga de ninguno de estos niveles de permisos no podrá modificar una pila. Si dicho usuario intenta modificar una pila para la que no tiene permisos, el trabajo stack-records fallará antes de que se despliegue ningún recurso.
Uso interno y cobertura actual de las pruebas
Hoy en día, AC se ha convertido en una herramienta fundamental para el equipo de soluciones, ya que permite realizar la mayor parte de nuestras pruebas de regresión y tareas de automatización. Sus principales usos son las pruebas de humo de regresión, las pruebas de escalabilidad, las pruebas de facturación de productos y las implementaciones simplificadas utilizadas en demostraciones de productos.
Los principales usuarios de los despliegues automatizados son nuestras pruebas de regresión nocturnas. Cada noche probamos cada uno de nuestros SLEEVES en un entorno de producción y otro de preproducción, iniciando un despliegue y eliminando después los recursos creados. Cuando se producen cambios, podemos detectarlos rápidamente y enviar informes de errores para actualizar nuestras guías. Nuestra cobertura de pruebas actual incluye:
- Puerta de enlace segura de Kubernetes.
- Seguridad de aplicaciones web.
- Aplicaciones en el perímetro de la red que implementan nuestra aplicación estándar «hipster-co» de 10 pods y una aplicación más ligera de un solo pod.
- Hola-Cloud.
- Sitios Volterra CE de un solo nodo y una única interfaz de red en AWS, GCP, Azure, VSphere y KVM/Vagrant.
- Sitios Volterra CE de un solo nodo con doble interfaz de red en AWS, GCP, Azure, VSphere y KVM/Vagrant.
- Despliegues a escala de sitios Volterra CE de un solo nodo y una única interfaz de red (mediante GCP, VSphere y KVM), creando varios sitios CE de un solo nodo y una única NIC para probar la capacidad de escalado de Volterra.
- Sitios Volterra CE de un solo nodo con varias interfaces de red en AWS, GCP, Azure, VSphere y KVM/Vagrant.
- Sitios Volterra CE multinodo con una única interfaz de red en AWS, GCP, Azure, VSphere y KVM/Vagrant.
- Sitios Volterra CE multinodo con múltiples interfaces de red en AWS, GCP, Azure, VSphere y KVM/Vagrant.
También disponemos de conjuntos especializados de pruebas de escalabilidad que automatizan el proceso de despliegue de hasta 400 sitios simultáneamente para comprobar la capacidad de escalado del software de Volterra, y que se han probado con GCP, vSphere y KVM.
El despliegue rápido y automatizado de casos de uso permite a los miembros del equipo de soluciones centrarse en otras tareas, lo que mejora la eficiencia interna. El equipo de soluciones suele utilizar AC para desplegar decenas de sitios de KVM, GCP y vSphere destinados a la grabación de demostraciones en vídeo, lo que nos ahorra tiempo al crear sitios de Volterra que se emplean para desarrollar infraestructuras más complejas a partir de la automatización existente. También se utiliza en tareas cron diarias que prueban las funciones de facturación de la plataforma Volterra mediante la automatización del despliegue de casos de uso de AWS, seguridad de aplicaciones web, puerta de enlace segura de Kubernetes y aplicaciones en el extremo de la red en un tenant especializado de Volterra que registra la información de facturación.
Planes futuros y hoja de ruta
Nuestro uso de AC ya está dando muy buenos resultados y todavía quedan muchas más funciones y mejoras por incorporar al proyecto en un futuro próximo.
La principal novedad del proyecto es la incorporación constante de nuevas opciones de SLEEVE para abarcar la implementación de casos de uso adicionales. Por cada nuevo SLEEVE que se añade, incorporamos una nueva tarea a nuestras pruebas de humo de regresión nocturnas, lo que amplía la cobertura de los proyectos de implementación de soluciones. La mayoría de los SLEEVE anteriores se centraban en casos de uso de un solo nodo y una única interfaz de red, pero recientemente hemos ampliado la cobertura de SLEEVE a clústeres de sitios Volterra de varios nodos y a casos de uso con múltiples interfaces de red en las plataformas AWS, Azure, GCP, VMWare y KVM/Vagrant.
También queremos mejorar nuestro sistema de registros de stacks. Aumentaremos el nivel de detalle de nuestros registros de AC y añadiremos funciones de búsqueda mejoradas mediante la incorporación de bases de datos RDS para almacenarlos. El objetivo es poder realizar búsquedas más rápidas en nuestro entorno de AC y ofrecer funciones de búsqueda más selectivas, como la consulta de stacks en función de su estado, sus creadores, etc. También figura en nuestra hoja de ruta utilizar estos registros para crear una interfaz de usuario personalizada que permita visualizar de forma más eficiente los despliegues creados con AC.
Sobre el autor
Artículos relacionados del blog

Cree servicios públicos seguros, resilientes y preparados para la IA con F5 y AWS
Descubre cómo las organizaciones del sector público pueden modernizar de forma segura sus aplicaciones y soluciones de IA, al tiempo que gestionan los sistemas heredados, el cumplimiento normativo y el riesgo operativo.

Protección de los sistemas de IA: por qué la seguridad debe avanzar al ritmo de la innovación
Desde acelerar avances revolucionarios en medicina y educación hasta transformar la vida cotidiana, la IA está cambiando nuestra forma de vivir y trabajar. Pero también ofrece grandes oportunidades a los ciberdelincuentes.
Avanzar hacia la optimización digital tras la transformación
Descubre estrategias de optimización digital para garantizar políticas de seguridad coherentes, impulsar la madurez de la transformación digital y superar los retos de la transformación.
Proyecto de código abierto destacado: mayor observabilidad con F5 Cloud Logger iApp
En el punto de mira del código abierto: cómo aumentar la observabilidad. Lee el blog de F5 para descubrir cómo exportar fácilmente la telemetría de BIG-IP a plataformas modernas de análisis en la nube.
El estado de la entrega de aplicaciones en 2018: la transformación digital impulsa la automatización y la multinube pese a las preocupaciones de seguridad
Descubre las principales conclusiones del cuarto informe anual de F5 sobre el estado de la entrega de aplicaciones.
Estado de la entrega de aplicaciones en 2017: automatización, API y DevOps
Descubre el informe sobre el estado de la entrega de aplicaciones de 2017. Lee el blog retrospectivo de F5 sobre los inicios del auge de las redes declarativas y los flujos de DevOps.