Cada gran cambio en la arquitectura de las aplicaciones obliga a la red a adaptarse. No es una idea nueva, ni siquiera revolucionaria. Ya lo hemos visto antes, una y otra vez. Y en cada ocasión se repitió el mismo patrón. Surgió un nuevo tipo de aplicación dominante y «la red» se adaptó para darle soporte, porque esas aplicaciones exigían capacidades que la infraestructura existente no podía ofrecer. Esa presión es exactamente la que estamos viendo ahora con la inferencia de IA.
La inferencia no es entrenamiento. No es experimentación. No es un ejercicio de ciencia de datos. La inferencia es un comportamiento en tiempo de ejecución en producción y funciona como una capa de aplicación. Tiene usuarios, patrones de tráfico, sensibilidad a la latencia, modos de fallo, restricciones de costes y riesgos de seguridad. Tratarla como un servicio de backend o una carga de trabajo especializada supone no entender lo que está ocurriendo realmente.
La inferencia es un nuevo tipo de aplicación.
Nuestro estudio anual pone de manifiesto esta realidad. Casi el 80 % de las organizaciones gestionan la inferencia por sí mismas. Solo una pequeña minoría depende exclusivamente de servicios públicos de IA. La mayoría de las organizaciones ejecutan la inferencia en sus propios entornos, en varias nubes y junto con aplicaciones y API tradicionales. Ya se enfrentan a problemas de enrutamiento, disponibilidad, rendimiento y seguridad durante la inferencia.
Ese es el punto clave. Los problemas surgen durante la inferencia; no antes ni después y, desde luego, tampoco durante el entrenamiento.
Las técnicas tradicionales de entrega no son suficientes en este caso. El balanceo de carga presupone que los backends son intercambiables. Las comprobaciones de estado presuponen una disponibilidad binaria. El enrutamiento estático del tráfico presupone un comportamiento predecible. Ninguno de estos supuestos se cumple cuando el coste, la calidad, la latencia y el riesgo de las solicitudes varían en función de los prompts, los tokens y el comportamiento del modelo.
Por lo tanto, ergo y, en consecuencia, «la red» debe cambiar de nuevo.
La nueva pila de red
Durante décadas, la pila de red se ha descrito en términos de paquetes y protocolos. Las capas 2 y 3 gestionaban los paquetes. Las capas de la 4 a la 7 gestionaban las sesiones, los protocolos y las aplicaciones. Este enfoque funcionaba porque las aplicaciones expresaban su intención y finalidad mediante protocolos. La inferencia no.
La inferencia expresa la intención y el propósito mediante prompts.
Por eso estamos asistiendo ahora a la aparición de una nueva capa dominante. La capa 8. La capa de los prompts.
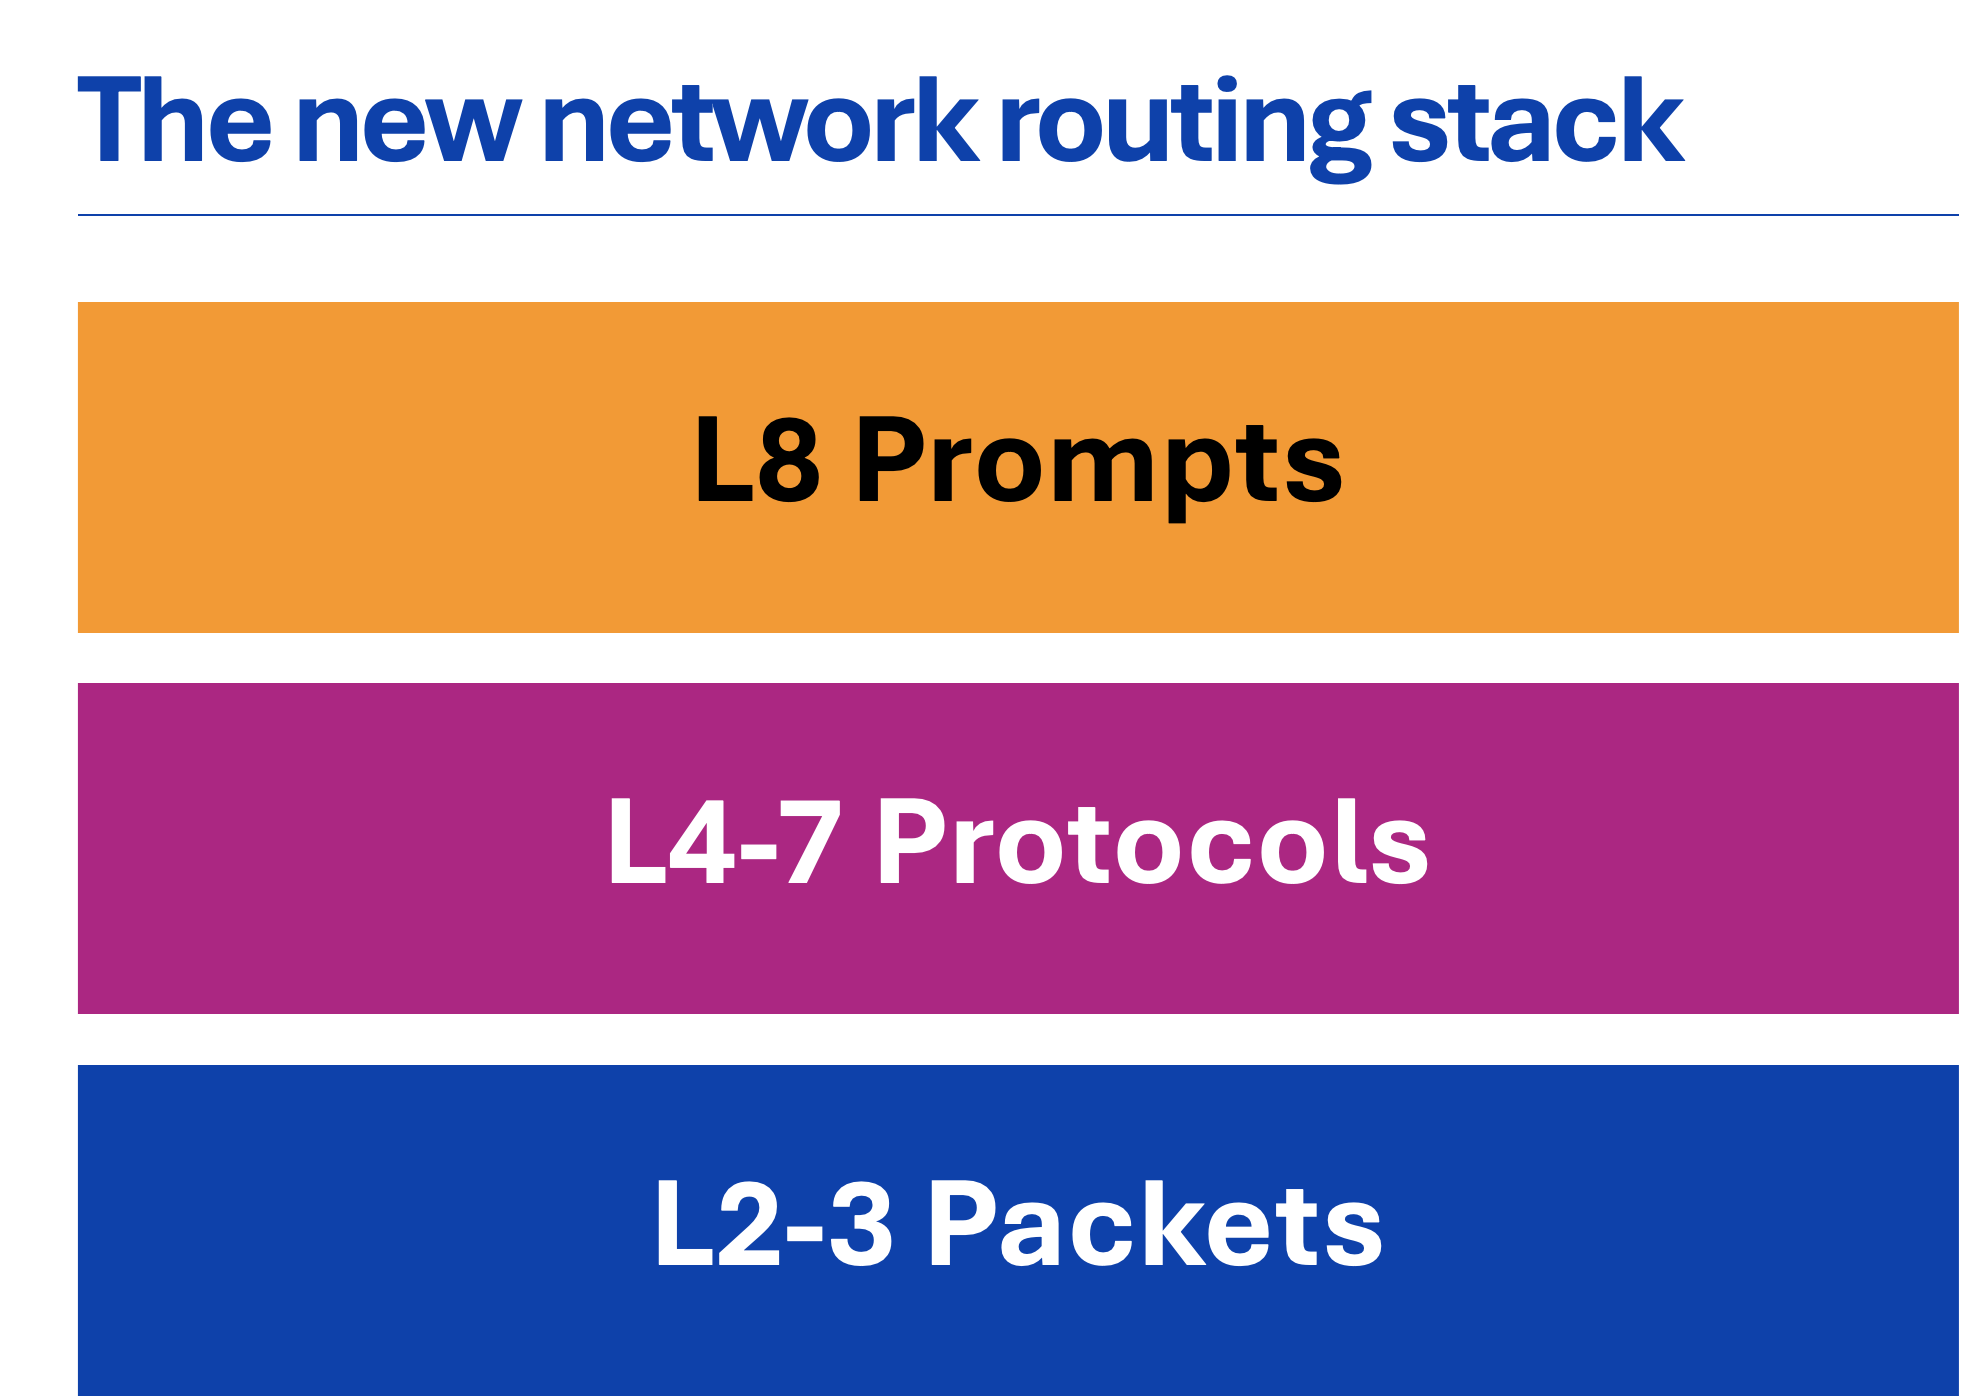
Un momento, Lori, puede que estés pensando. Llevamos mucho tiempo enrutando en función de partes de la carga útil, así que ¿qué hace que esto sea tan diferente?
¡Gracias por preguntar!
La diferencia es, en realidad, bastante profunda, sobre todo teniendo en cuenta que los URI no se corresponden con «funciones» en la inferencia y que lo que se invoca exige extraer la intención de… la instrucción. Esta es la razón fundamental por la que el direccionamiento del tráfico basado en la carga útil no llegó a constituir una nueva capa. No cambió radicalmente las reglas del juego. ¿La inferencia? La inferencia no solo cambia las reglas del juego, sino que las reescribe con frecuencia.
Ahora bien, lo importante es que, en «la capa del prompt», las decisiones de enrutamiento ya no se basan únicamente en direcciones IP, puertos, URI ni siquiera en partes de la carga útil. Se basan en quién realiza la petición, qué solicita, cuánto cuesta, qué riesgo entraña y qué calidad del resultado se requiere. Junto con la moderación de las respuestas y el control de tokens, nuestra investigación más reciente identificó esta capa de la pila como aquella en la que la entrega y la seguridad de las aplicaciones tienen un mayor impacto. Si añadimos el enrutamiento de modelos (también en la capa 8), vemos que la mayoría de las organizaciones ya reconoce su importancia para proteger y escalar la inferencia de IA.
La inspección de prompts, el control de tokens, la moderación de resultados y el enrutamiento de modelos no son funciones opcionales. Son requisitos básicos para ejecutar la inferencia en producción.
No hay de qué preocuparse: las capas inferiores no desaparecen, del mismo modo que las capas L2-3 no desaparecieron cuando las capas L4-7 pasaron a ocupar la parte superior de la pila. Simplemente se convierten en la base. El enrutamiento de paquetes sigue siendo importante. La gestión de protocolos también.
Pero que no quepa duda: el valor está ahora en la capa 8.
La respuesta a la inferencia confirma el cambio
Los controladores de entrega de aplicaciones surgieron porque las redes diseñadas para paquetes no podían admitir aplicaciones. Las puertas de enlace de API surgieron porque las redes diseñadas para aplicaciones web no podían admitir API. Ahora está surgiendo la compatibilidad con la inferencia porque las redes diseñadas para API no pueden admitir aplicaciones autónomas, probabilísticas y con costes variables.
La respuesta del mercado confirma este cambio. Están surgiendo startups centradas en el enrutamiento de modelos, las pasarelas de inferencia, la gobernanza de tokens y el control de prompts. Los hiperescaladores están desarrollando discretamente estas mismas capacidades a nivel interno.
La respuesta de las empresas confirma este cambio. El 90 % de las organizaciones utiliza servicios de inferencia, y el 70 % de ellas emplea dos o más servicios de inferencia distintos, incluidos servicios propios. Están implementando estrategias multimodelo, experimentando con IA agéntica y adoptando la automatización basada en IA en sus operaciones.
Esto no es una moda pasajera. Es un cambio estructural.
La inferencia no es simplemente otra carga de trabajo. Las arquitecturas que sigan ancladas en paquetes y protocolos continuarán funcionando, pero no podrán escalar de forma eficiente. Las pilas de red que se limiten a las API tendrán dificultades para controlar sistemas autónomos.
La inferencia ha desplazado el punto de control hacia las capas superiores de la pila. El resto es inevitable.
Sobre el autor

Lori MacVittie es ingeniera distinguida y evangelista jefe en la Oficina del CTO de F5, y cuenta con una amplia experiencia en entrega de aplicaciones, estrategia de automatización e infraestructura. Es conocida por convertir la complejidad en claridad, ya sea definiendo mecanismos de protección para agentes de IA, analizando arquitecturas multinube frágiles o explorando los límites de los sistemas escalables. Aporta más de treinta años de experiencia en el sector en desarrollo de aplicaciones, arquitectura de TI y operaciones de redes y sistemas. Antes de incorporarse a F5, fue una galardonada editora de tecnología. MacVittie posee un máster en Informática y es una autora prolífica cuyas publicaciones abarcan la seguridad, la nube y la arquitectura empresarial. También es una apasionada de los juegos de mesa y los videojuegos, y expresa sin complejos sus firmes opiniones sobre el queso.
Más artículos de Lori Mac VittieArtículos relacionados del blog
Las 10 claves para la entrega de aplicaciones de IA: requisitos de las aplicaciones a medida
La IA convierte lo «personalizado» de caso excepcional en opción predeterminada: las solicitudes pasan a ser cadenas componibles (selección de modelos, recuperación, políticas y herramientas), por lo que la entrega debe adaptarse a cada solicitud, no a cada aplicación.
Las 10 principales amenazas para la entrega de aplicaciones de IA: observabilidad incompleta
La IA no escalará por sí sola. Sin un plano de control unificado que elimine las barreras entre herramientas y responsabilidades, la inferencia se convierte en la capa más frágil y que más coordinación requiere.
Las 10 principales amenazas en la entrega de aplicaciones de IA: prácticas de DNS deficientes
Para los sistemas de inferencia y los sistemas agénticos, la resiliencia del DNS es fundamental para la disponibilidad y el rendimiento: una resolución deficiente provoca errores de enrutamiento, picos de latencia e interrupciones del servicio en distintas regiones.
Comportamiento y límites: el cambio hacia la seguridad agéntica
Los agentes generan secuencias emergentes y sin límites en las que el riesgo se acumula con el tiempo. La seguridad debe pasar de validar solicitudes individuales a supervisar continuamente el comportamiento en flujos de varios pasos que evolucionan con el tiempo.
La IA está impulsando la aparición de nuevos tipos de tráfico
La adopción de la IA está dando lugar a nuevos tipos de tráfico de primer nivel: solicitudes de inferencia, tráfico de automatización generado por máquinas y tráfico de telemetría de gran volumen que alimenta los bucles de control.
La compresión ya no es una cuestión de velocidad, sino del coste de pensar
En la era de la IA, la compresión reduce el coste de pensar, no solo el ancho de banda. Descubre cómo la compresión de prompts, resultados y modelos permite controlar los gastos de inferencia de la IA.