Editor – Esta publicación forma parte de una serie de 10 entregas:
- Reduzca la complejidad con Kubernetes preparado para producción
- Cómo mejorar la resiliencia en Kubernetes con una gestión avanzada del tráfico (este artículo)
- Cómo mejorar la visibilidad en Kubernetes
- Seis formas de proteger Kubernetes mediante herramientas de gestión del tráfico
- Guía para elegir un controlador de Ingress, parte 1: Identifique sus requisitos
- Guía para elegir un controlador de Ingress, parte 2: riesgos y preparación para el futuro
- Guía para elegir un controlador de Ingress, parte 3: código abierto frente a opción predeterminada frente a solución comercial
- Guía para elegir un controlador de Ingress, parte 4: opciones de controladores de Ingress de NGINX
- Cómo elegir una malla de servicios
- Pruebas de rendimiento de los controladores Ingress de NGINX en un entorno dinámico de Kubernetes en la nube
También puedes descargar la colección completa de artículos del blog como libro electrónico gratuito : «Cómo llevar Kubernetes de las pruebas a producción».
Hay una forma muy sencilla de saber que una empresa no está utilizando correctamente las tecnologías modernas de desarrollo de aplicaciones: sus clientes no tardan en quejarse en las redes sociales. Se quejan cuando no pueden ver en streaming el último estreno que engancha. O acceder a la banca online. O realizar una compra porque el carrito agota el tiempo de espera.
Aunque los clientes no se quejen públicamente, eso no significa que su mala experiencia no tenga consecuencias. Uno de nuestros clientes, una gran compañía de seguros, nos contó que pierde clientes cuando su página de inicio no se carga en menos de 3 segundos.
Todas esas quejas de los usuarios sobre el bajo rendimiento o las interrupciones apuntan a un culpable común: la resiliencia… o la falta de ella. La gran ventaja de las tecnologías de microservicios —incluidos los contenedores y Kubernetes— es que pueden mejorar significativamente la experiencia del cliente al aumentar la resiliencia de sus aplicaciones. ¿Cómo? Todo depende de la arquitectura.
Me gusta explicar la diferencia fundamental entre las arquitecturas monolíticas y las de microservicios mediante la analogía de una guirnalda de luces navideñas. Cuando se funde una bombilla en una guirnalda antigua, toda la guirnalda se apaga. Si no puedes sustituir la bombilla, lo único que merece la pena decorar con esa guirnalda es el interior del cubo de la basura. Este tipo antiguo de luces es como una aplicación monolítica, que también tiene componentes estrechamente acoplados y deja de funcionar si falla uno de ellos.
Pero el sector de la iluminación, al igual que el del software, detectó este problema. Cuando se funde una bombilla en una guirnalda de luces moderna, las demás siguen brillando, del mismo modo que una aplicación de microservicios bien diseñada continúa funcionando aunque falle una instancia de servicio.
Gestión del tráfico en Kubernetes
Los contenedores son una opción muy popular en las arquitecturas de microservicios porque resultan idóneos para crear aplicaciones mediante componentes más pequeños e independientes: son ligeros, portátiles y fáciles de escalar. Kubernetes es el estándar de facto para la orquestación de contenedores, pero existen numerosos desafíos para preparar Kubernetes para entornos de producción. Una estrategia madura de gestión del tráfico mejora tanto el control sobre las aplicaciones de Kubernetes como su resiliencia, ya que permite controlar servicios en lugar de paquetes y adaptar las reglas de gestión del tráfico de forma dinámica o mediante la API de Kubernetes. Aunque la gestión del tráfico es importante en cualquier arquitectura, hay dos herramientas esenciales para las aplicaciones de alto rendimiento: el control del tráfico y la división del tráfico.
Control del tráfico
El control del tráfico (a veces denominado «enrutamiento del tráfico» o «modelado del tráfico») consiste en controlar adónde se dirige el tráfico y cómo llega hasta allí. Es imprescindible cuando se ejecuta Kubernetes en producción, ya que permite proteger la infraestructura y las aplicaciones frente a ataques y picos de tráfico. Dos técnicas que conviene incorporar al ciclo de desarrollo de las aplicaciones son la limitación de la tasa y el corte de circuitos.
- Caso de uso: Quiero proteger los servicios para que no reciban demasiadas solicitudes
Solución: Limitación de solicitudesYa sea por motivos maliciosos (por ejemplo, intentos de adivinar contraseñas por fuerza bruta y ataques DDoS) o legítimos (como una afluencia masiva de clientes durante una oferta), un gran volumen de solicitudes HTTP puede saturar los servicios y provocar que las aplicaciones dejen de funcionar. La limitación de solicitudes restringe el número de solicitudes que un usuario puede realizar en un periodo determinado. Estas pueden ser desde una simple solicitudGETde la página de inicio de un sitio web hasta una solicitudPOSTen un formulario de inicio de sesión. Por ejemplo, durante un ataque DDoS, puedes usar la limitación de solicitudes para limitar la tasa de solicitudes entrantes a un valor habitual para usuarios reales. - Caso de uso: Quiero evitar fallos en cascada
Solución: DisyuntorCuando un servicio no está disponible o presenta una latencia elevada, las solicitudes entrantes pueden tardar mucho en agotar el tiempo de espera y los clientes en recibir una respuesta de error. Estos tiempos de espera prolongados pueden provocar un fallo en cascada, en el que la interrupción de un servicio causa tiempos de espera agotados en otros servicios y, en última instancia, el fallo de toda la aplicación. Los disyuntores evitan los fallos en cascada supervisando los fallos de los servicios. Cuando el número de solicitudes fallidas a un servicio supera un umbral preestablecido, el disyuntor se activa y comienza a devolver una respuesta de error a los clientes en cuanto llegan las solicitudes, desviando así el tráfico del servicio. El disyuntor continúa interceptando y rechazando solicitudes durante un periodo definido antes de permitir que pase un número limitado de solicitudes a modo de prueba. Si esas solicitudes se procesan correctamente, el disyuntor deja de limitar el tráfico. De lo contrario, el temporizador se reinicia y el disyuntor vuelve a rechazar solicitudes durante el periodo definido.
División del tráfico
La división del tráfico (a veces denominada «pruebas de tráfico») es una subcategoría del control del tráfico y consiste en controlar la proporción del tráfico entrante que se dirige a distintas versiones de una aplicación de backend que se ejecutan simultáneamente en un entorno (normalmente, la versión actual en producción y una versión actualizada). Es una parte esencial del ciclo de desarrollo de aplicaciones, ya que permite a los equipos probar la funcionalidad y la estabilidad de nuevas características y versiones sin afectar negativamente a los clientes. Entre los escenarios de despliegue útiles se incluyen el enrutamiento de depuración, los despliegues canary, las pruebas A/B, y los despliegues azul-verde. (Existe bastante disparidad en el uso de estos cuatro términos en el sector. Aquí los utilizamos según nuestra interpretación de sus definiciones).
- Caso de uso: Estoy listo para probar una nueva versión en producción
Solución: Enrutamiento de depuraciónSupongamos que tiene una aplicación bancaria y va a añadir una función de puntuación crediticia. Antes de probarla con los clientes, probablemente quiera comprobar cómo funciona en producción. El enrutamiento de depuración le permite desplegarla públicamente y, al mismo tiempo, «ocultarla» a los usuarios reales, ya que solo permite acceder a ella a determinados usuarios en función de atributos de la capa 7, como una cookie de sesión, un ID de sesión o un ID de grupo. Por ejemplo, puede permitir el acceso únicamente a los usuarios que tengan una cookie de sesión de administrador: sus solicitudes se enrutan a la nueva versión con la función de puntuación crediticia, mientras que el resto de los usuarios continúa utilizando la versión estable.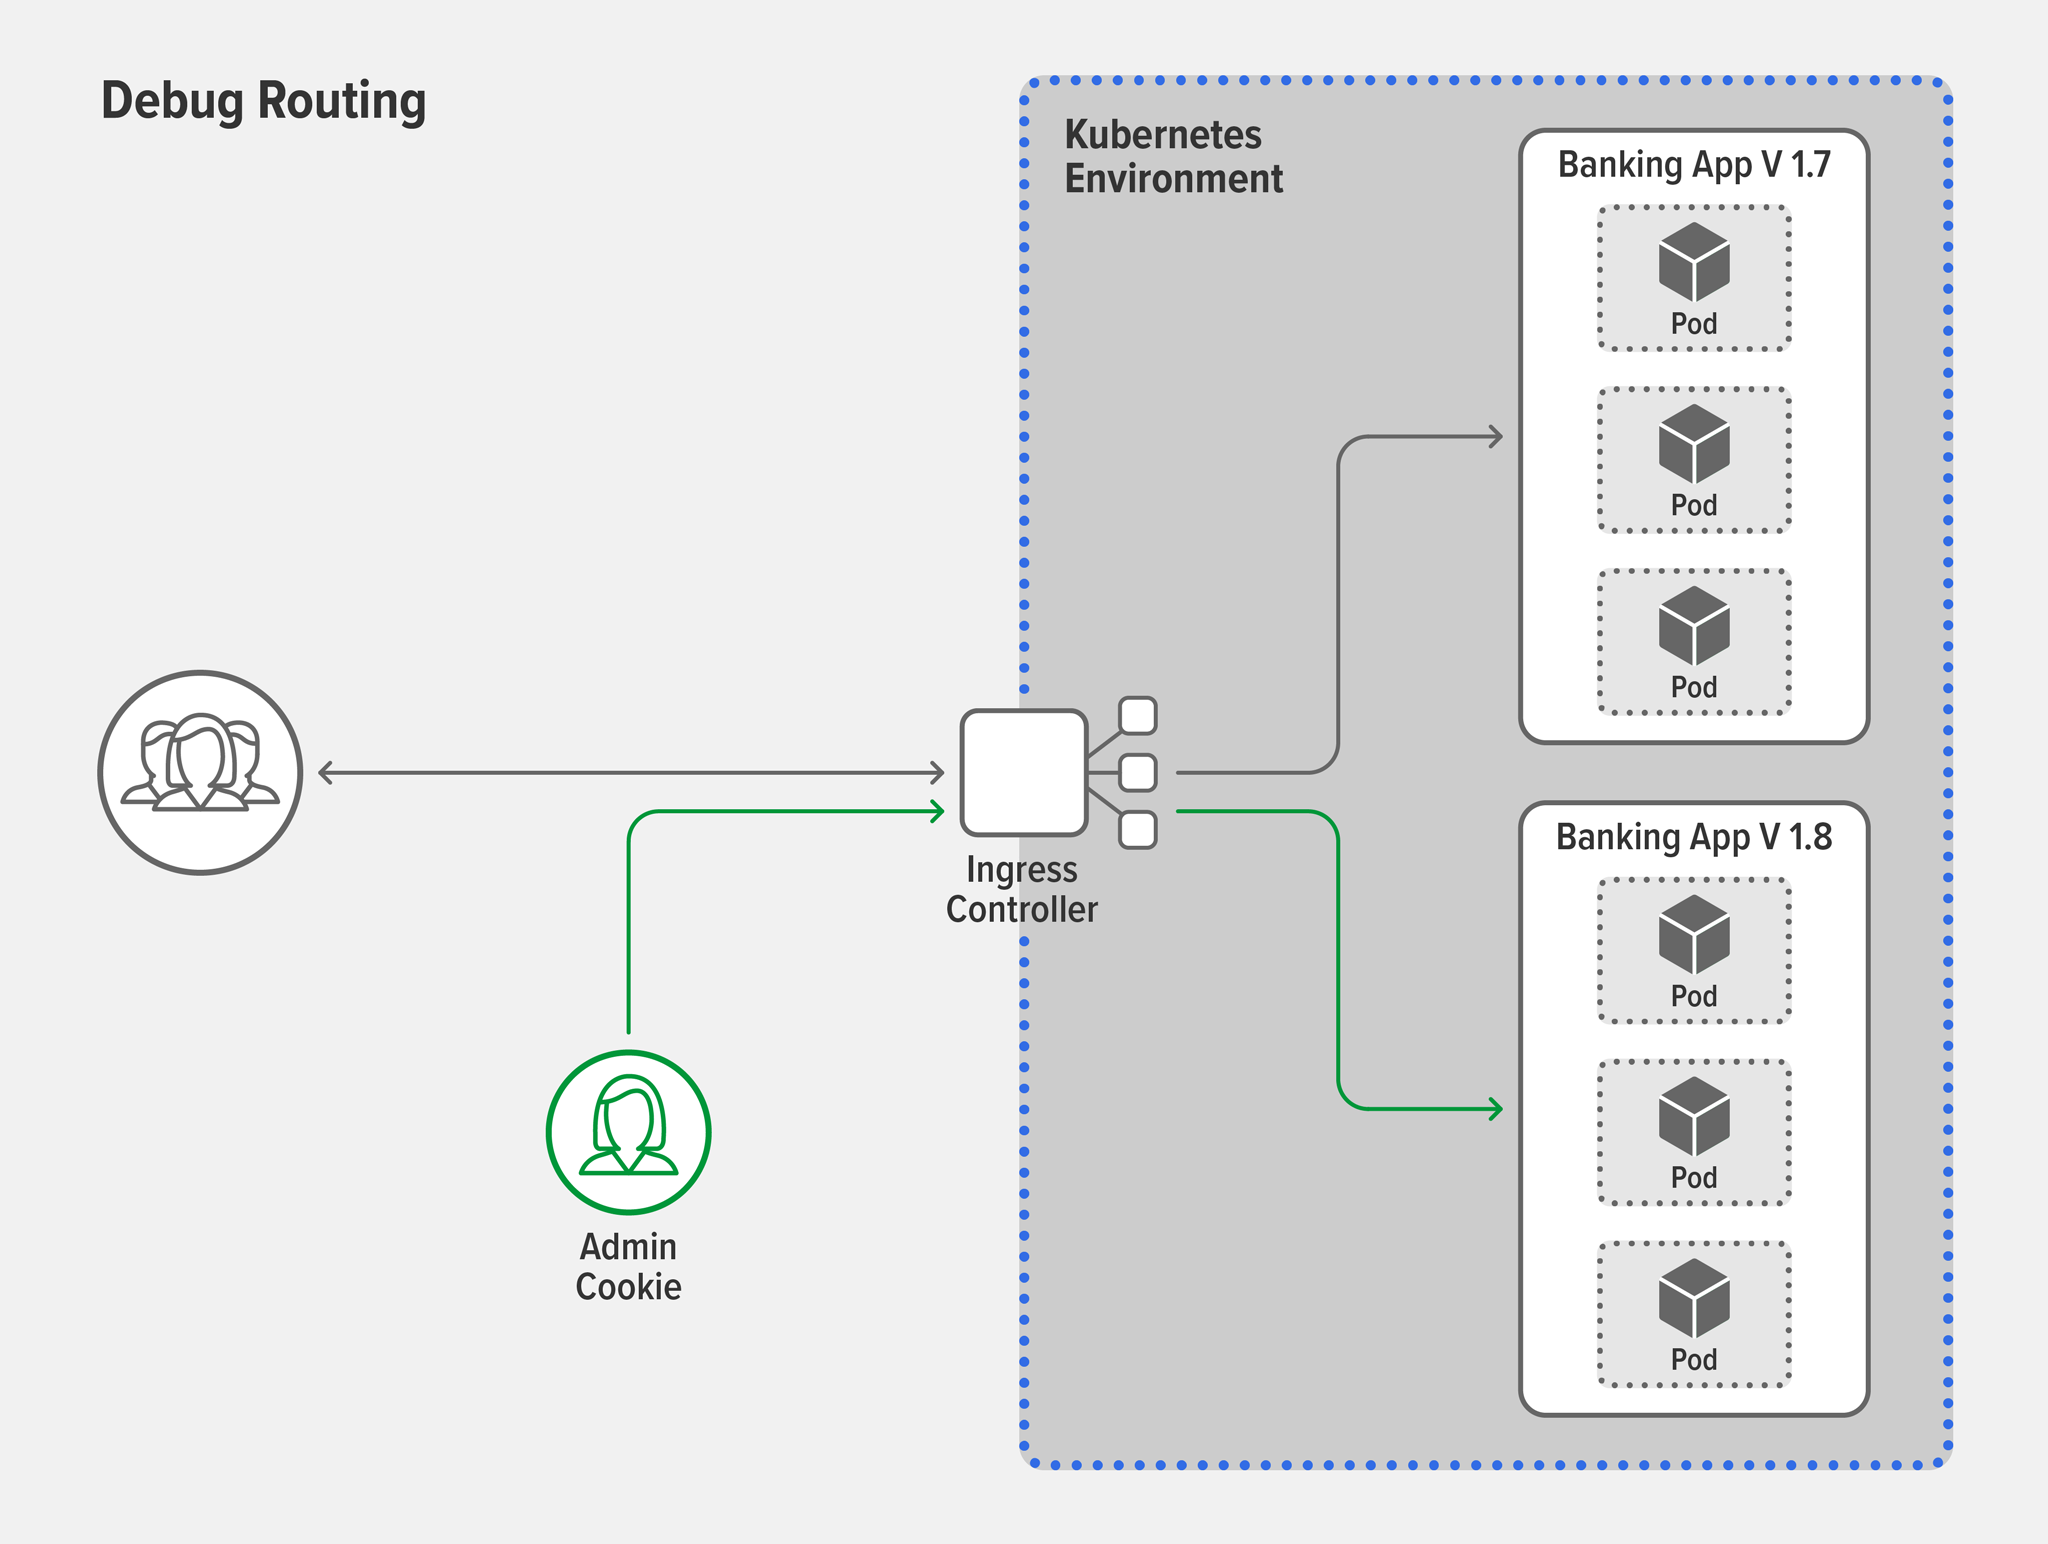
- Caso de uso: Necesito asegurarme de que mi nueva versión sea estable
Solución: Despliegue canaryEl concepto de despliegue canary procede de una antigua práctica minera, en la que los mineros llevaban un canario enjaulado a las minas de carbón para que sirviera como alerta temprana ante la presencia de gases tóxicos. El gas mataba al canario antes que a los mineros, lo que les permitía escapar rápidamente del peligro. En el mundo de las aplicaciones, ¡ningún pájaro sufre daño alguno! Los despliegues canary ofrecen una forma segura y ágil de probar la estabilidad de una nueva funcionalidad o versión. Un despliegue canary típico comienza manteniendo a una gran proporción de los usuarios (por ejemplo, el 99 %) en la versión estable y trasladando a un pequeño grupo (el 1 % restante) a la nueva versión. Si la nueva versión falla, por ejemplo, porque se bloquea o devuelve errores a los clientes, puedes devolver inmediatamente el grupo de prueba a la versión estable. Si funciona correctamente, puedes trasladar a los usuarios de la versión estable a la nueva, ya sea a todos a la vez o, como suele ser más habitual, mediante una migración gradual y controlada.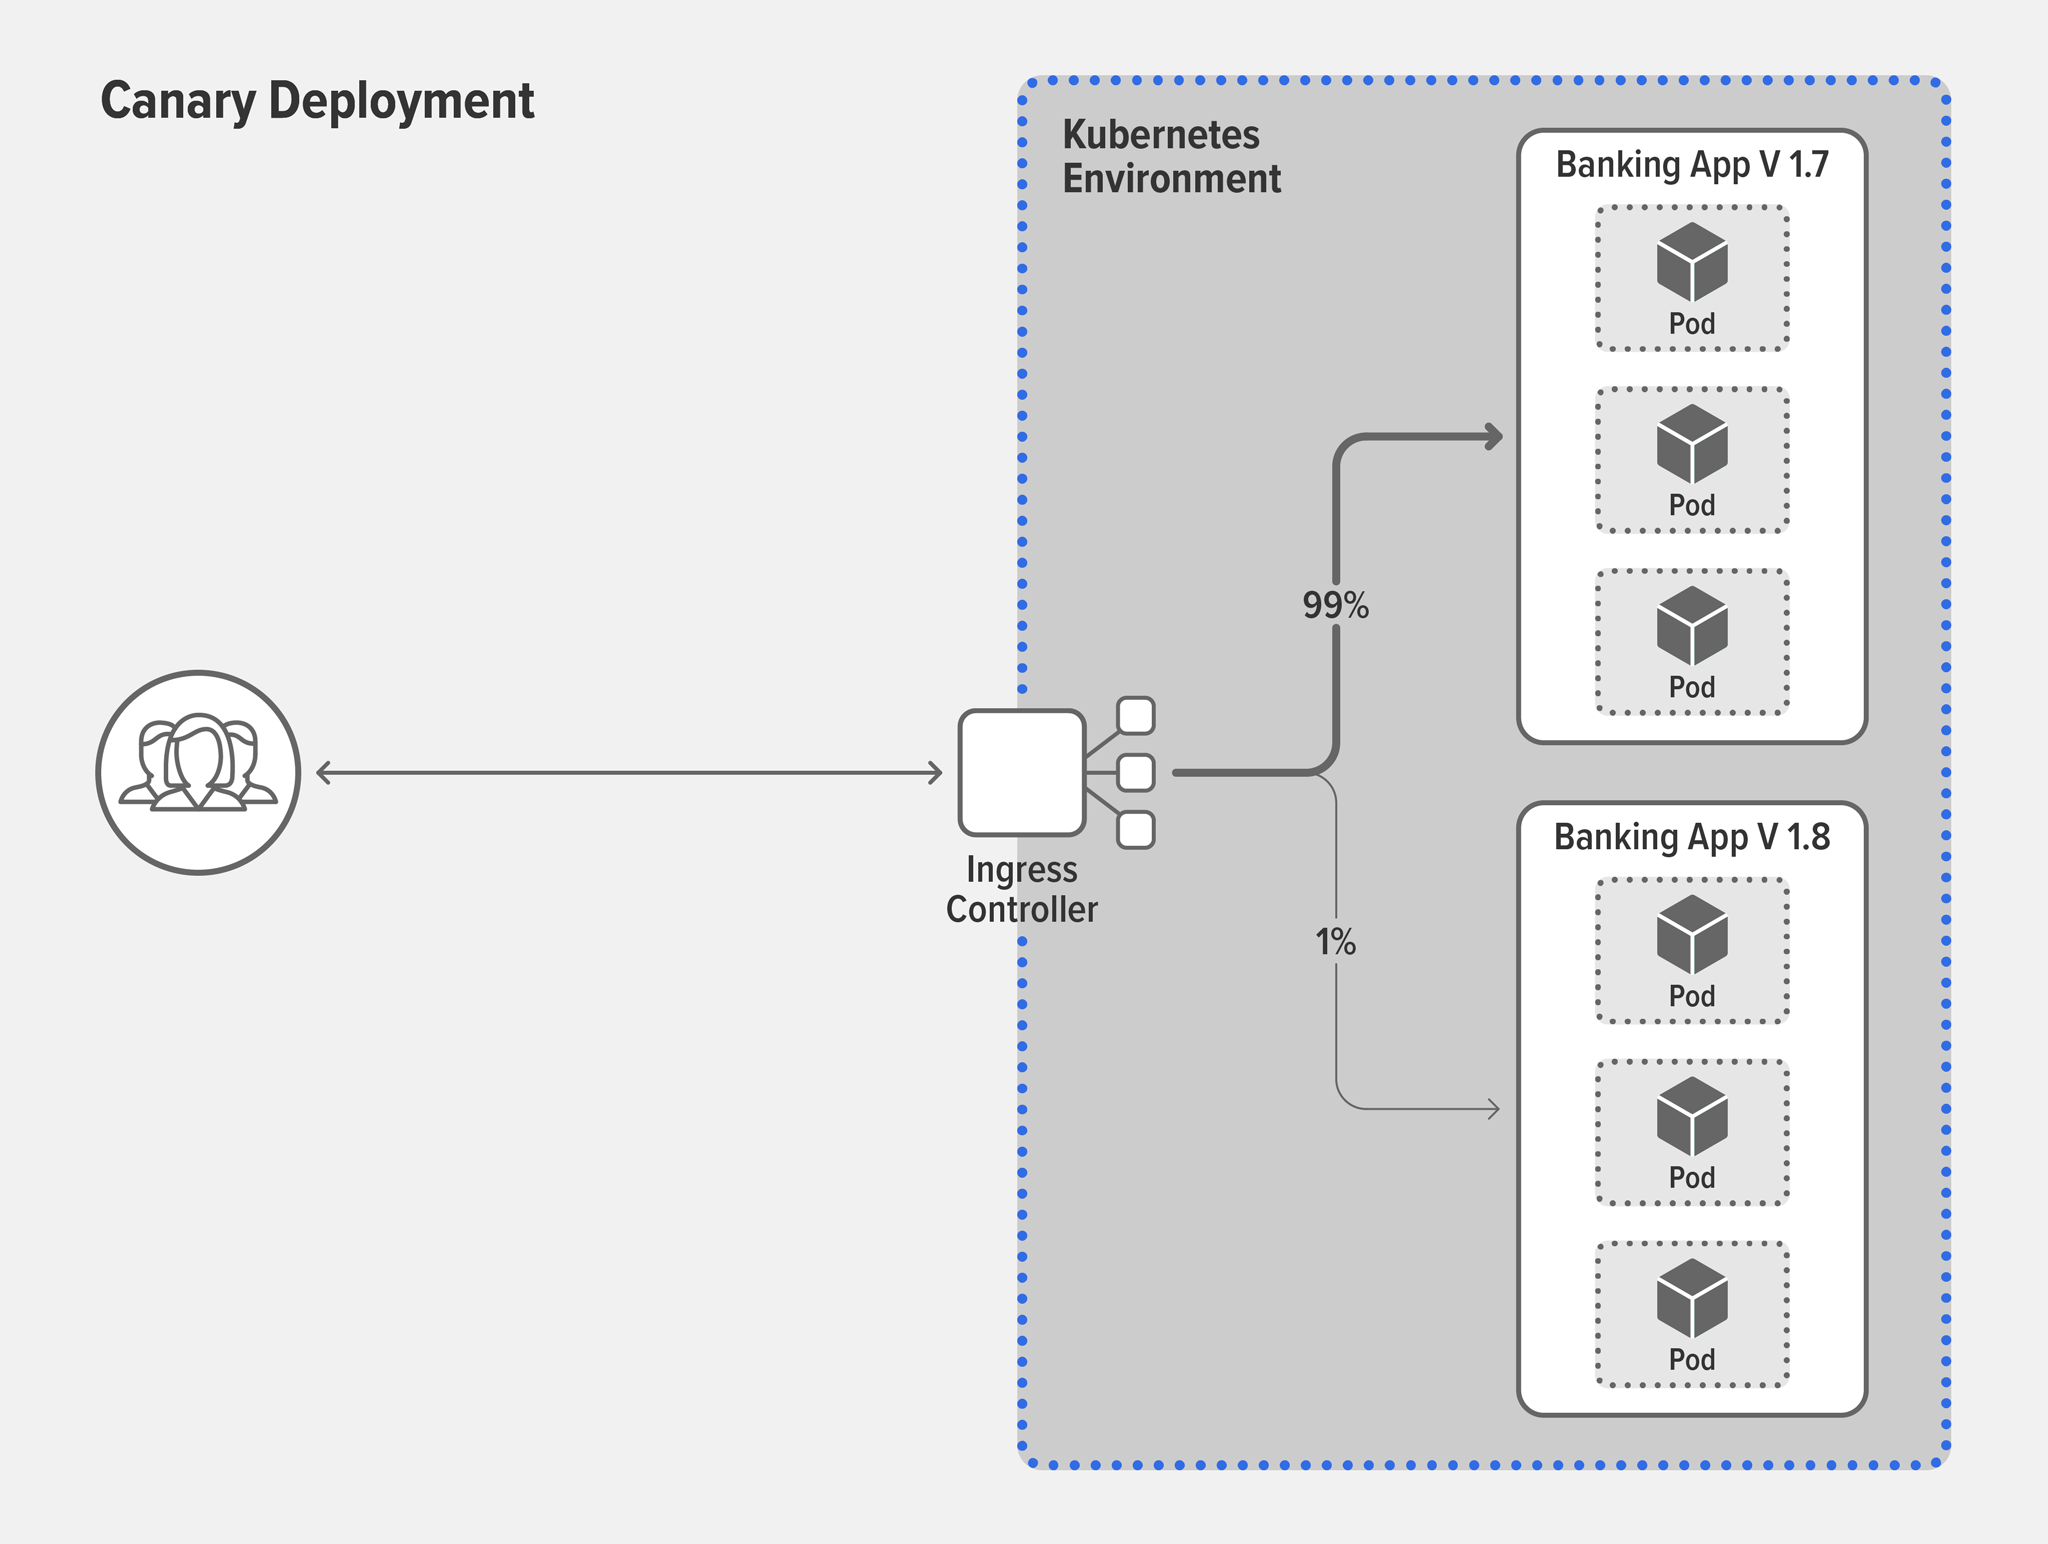
- Caso de uso: Necesito averiguar si los clientes prefieren una versión nueva a la versión actual
Solución: Pruebas A/BAhora que ha confirmado que la nueva funcionalidad funciona en producción, quizá quiera conocer la opinión de los clientes sobre su éxito basándose en indicadores clave de rendimiento (KPI), como el número de clics, los usuarios recurrentes o las valoraciones explícitas. Las pruebas A/B son un proceso utilizado en muchos sectores para medir y comparar el comportamiento de los usuarios con el fin de determinar el éxito relativo de distintas versiones de un producto o una aplicación entre la base de clientes. En una prueba A/B típica, el 50 % de los usuarios recibe la versión A (la versión actual de la aplicación), mientras que el 50 % restante recibe la versión B (la versión que incluye la funcionalidad nueva, pero estable). La ganadora es la que obtiene el mejor conjunto global de KPI.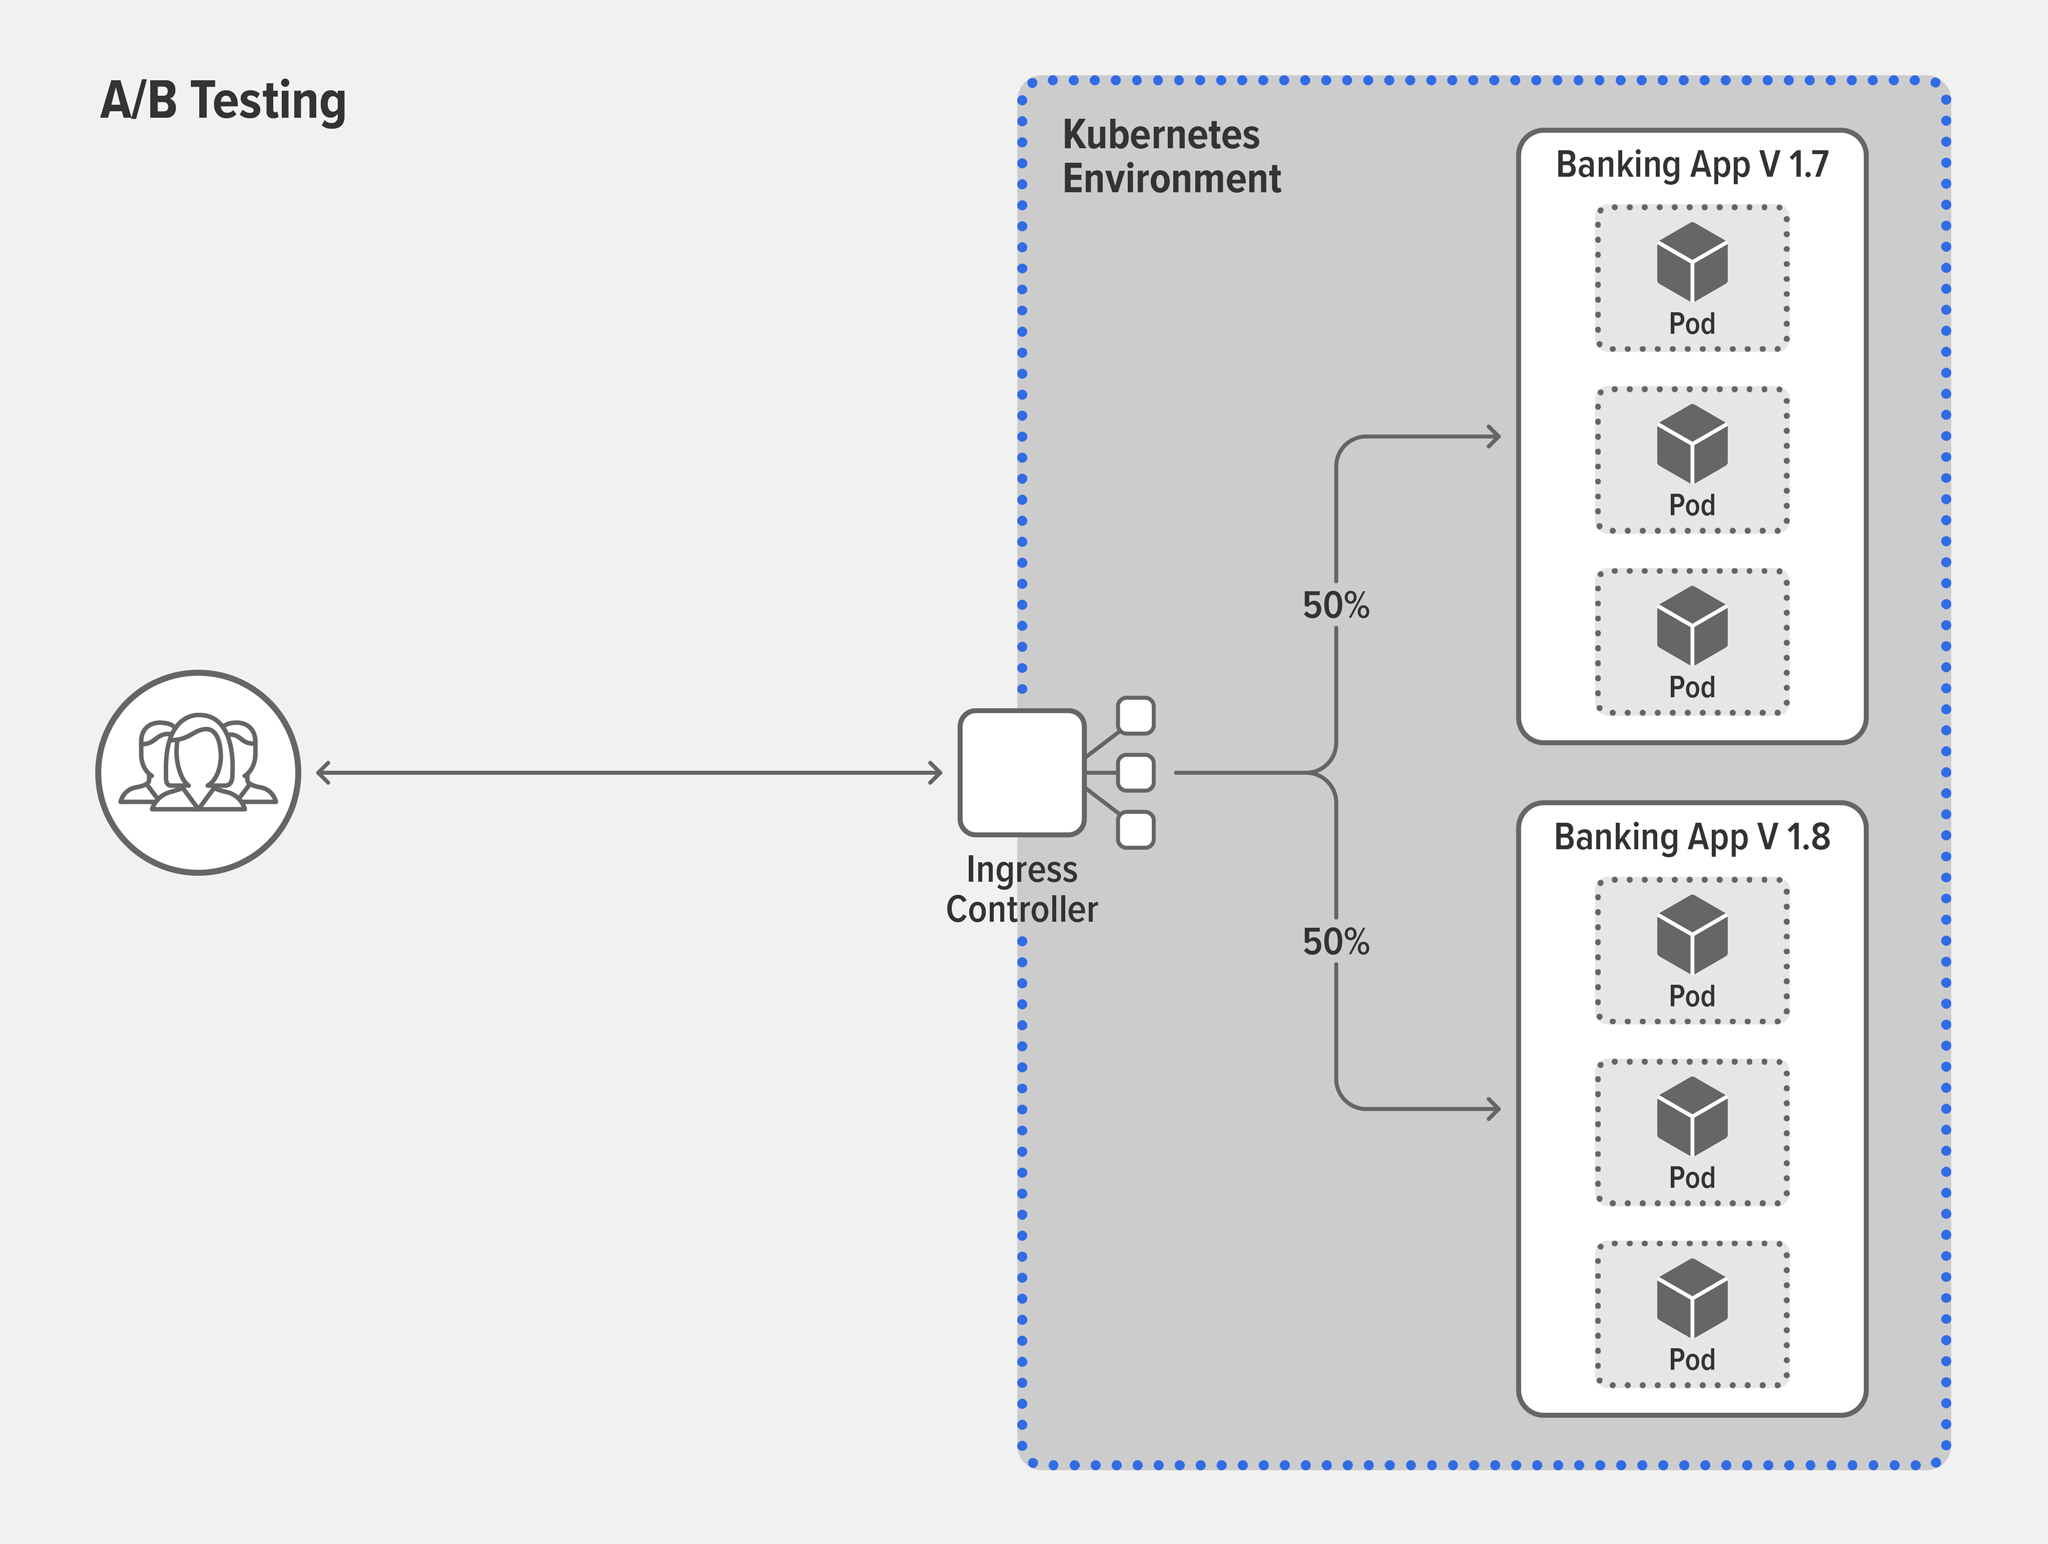
- Caso de uso: Quiero migrar a mis usuarios a una nueva versión sin tiempo de inactividad
Solución: Despliegue azul-verdeSupongamos ahora que ha llegado el momento de realizar un cambio de versión importante en su aplicación bancaria… ¡Enhorabuena! Antes, actualizar una versión solía implicar tiempo de inactividad para los usuarios, ya que había que retirar la versión anterior antes de poner la nueva en producción. Sin embargo, en el competitivo entorno actual, la mayoría de los usuarios considera inaceptable que una actualización provoque tiempo de inactividad. Los despliegues azul-verde reducen considerablemente, o incluso eliminan, el tiempo de inactividad durante las actualizaciones. Basta con mantener la versión anterior (azul) en producción mientras se despliega simultáneamente la nueva versión (verde) en paralelo dentro del mismo entorno de producción. La mayoría de las organizaciones no quieren migrar al 100 % de los usuarios de la versión azul a la verde de una sola vez; al fin y al cabo, ¿qué ocurriría si la versión verde fallara? La solución consiste en utilizar un despliegue canario para migrar a los usuarios en los incrementos que mejor se adapten a su estrategia de mitigación de riesgos. Si la nueva versión resulta ser un desastre, puede devolver fácilmente a todos los usuarios a la versión estable con apenas un par de pulsaciones de teclas.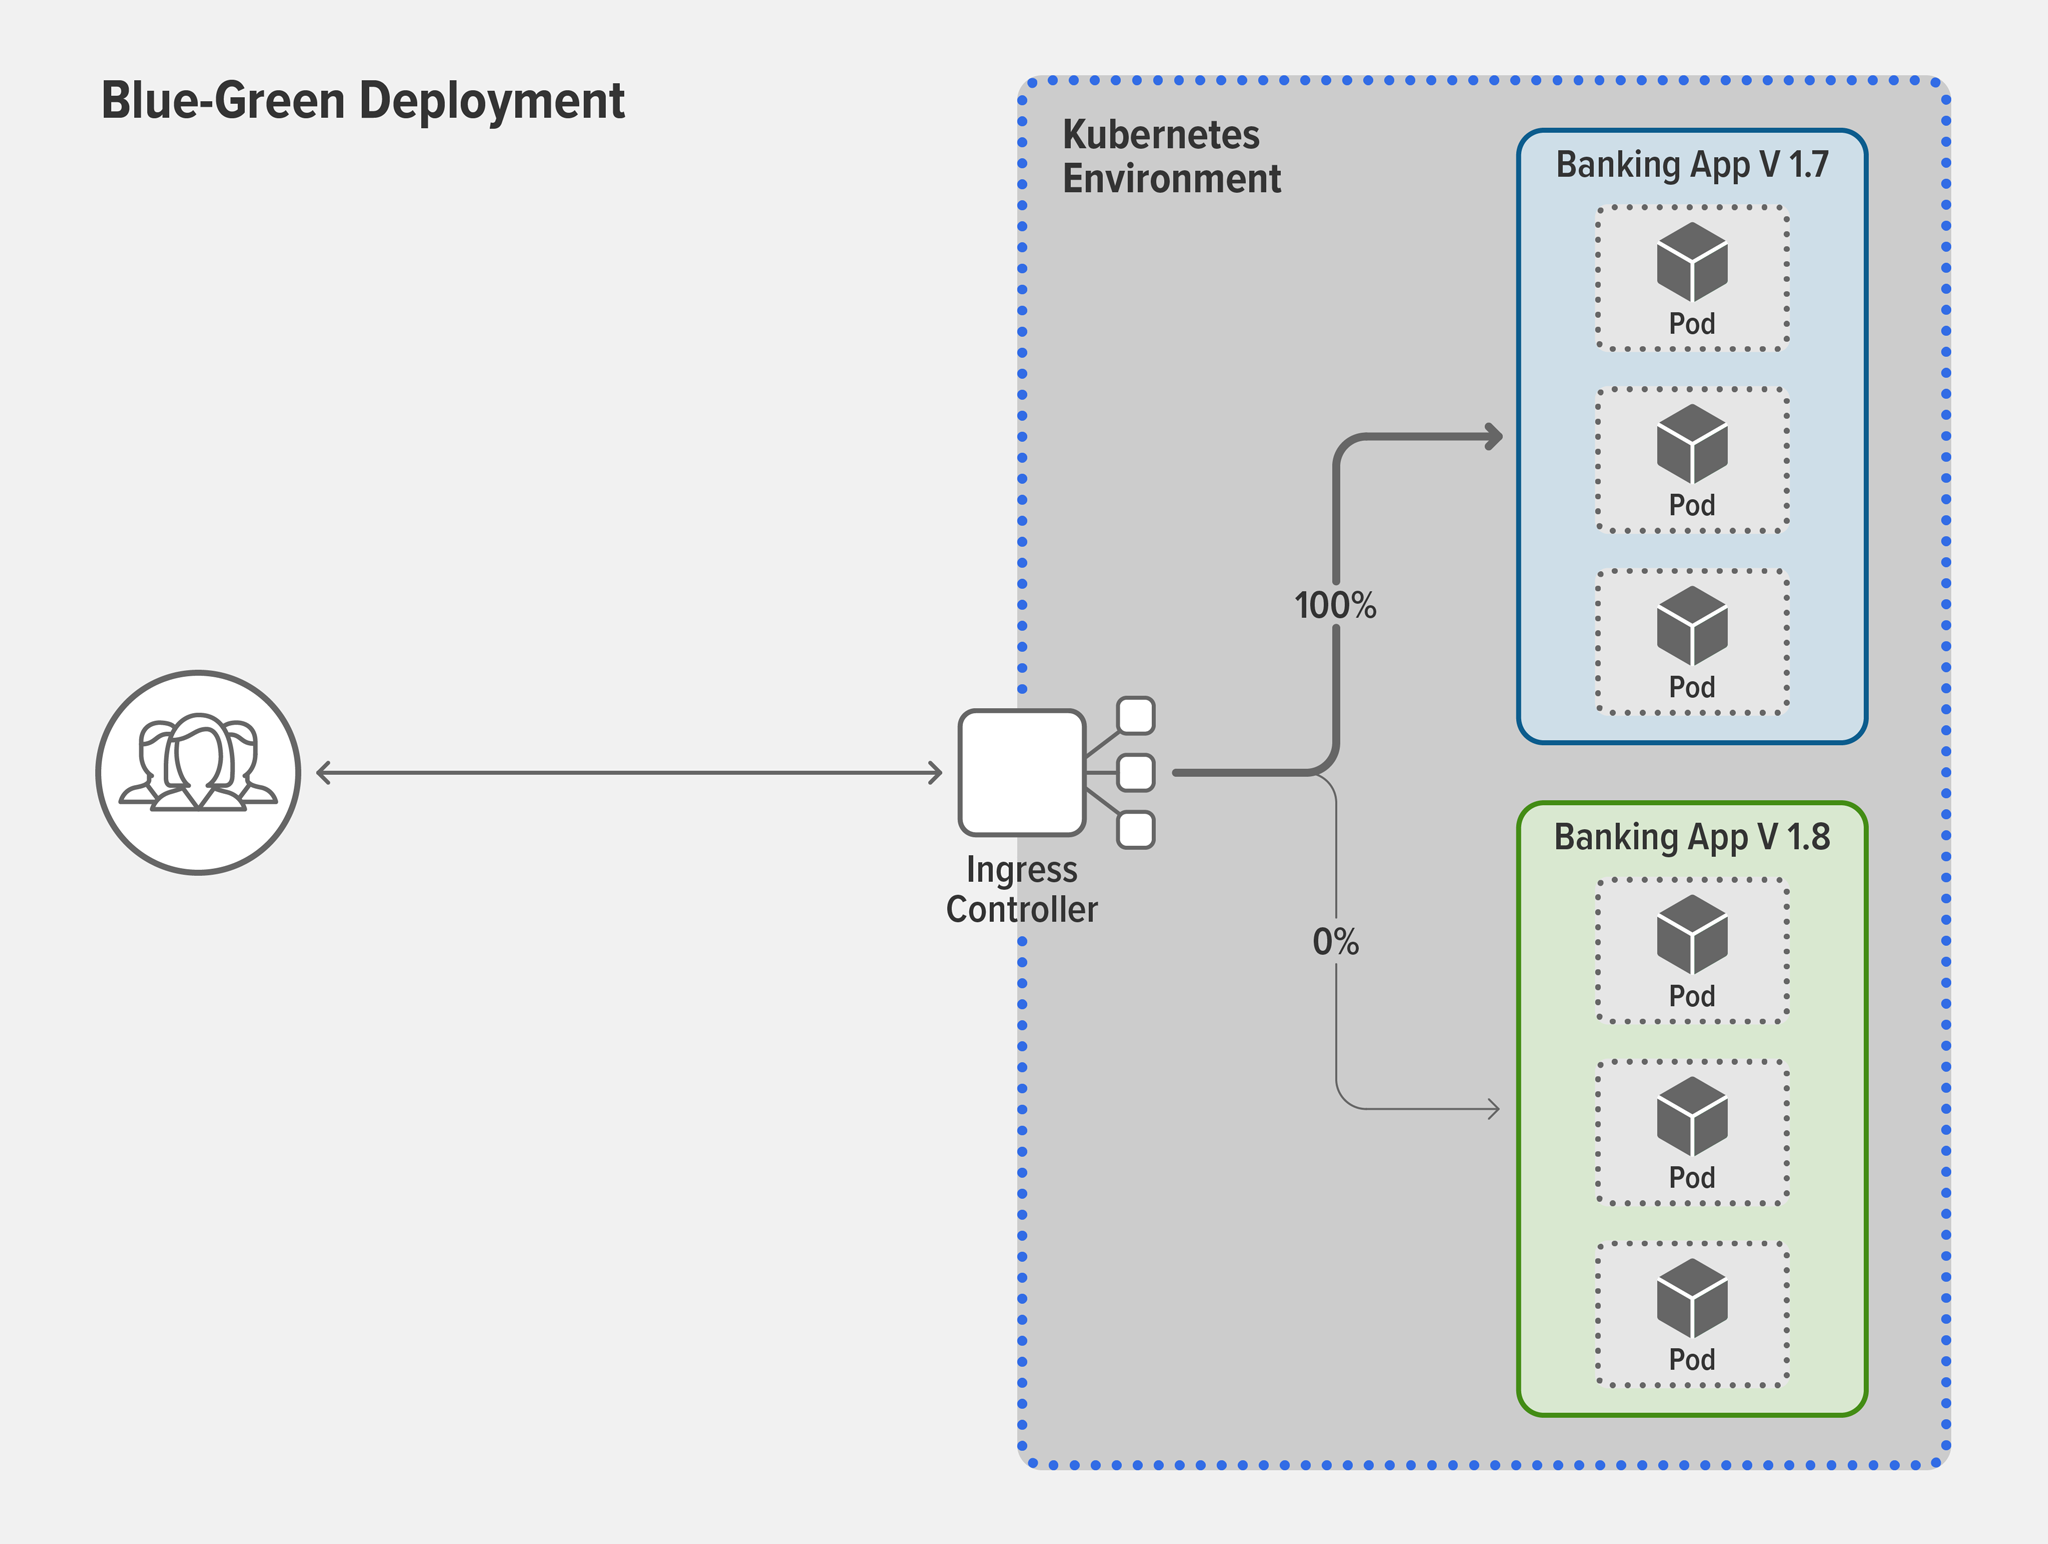
Cómo puede ayudar NGINX
Puede implementar funciones avanzadas de control y distribución del tráfico con la mayoría de los controladores de Ingress y las mallas de servicios. La tecnología que debe utilizar depende de la arquitectura y los casos de uso de su aplicación. Por ejemplo, utilizar un controlador de Ingress resulta adecuado en estos tres casos:
- Tus aplicaciones tienen un único punto de conexión, como ocurre con las aplicaciones sencillas o monolíticas que has migrado a Kubernetes mediante «lift and shift».
- No hay comunicación entre servicios en tu clúster.
- Hay comunicación entre servicios, pero todavía no utilizas una malla de servicios.
Si el despliegue es lo suficientemente complejo como para necesitar una malla de servicios, un caso de uso habitual consiste en dividir el tráfico entre servicios para probar o actualizar microservicios concretos. Por ejemplo, puede que quieras realizar un despliegue canario detrás del front-end móvil, entre dos versiones diferentes de la API del microservicio de geolocalización.
Sin embargo, configurar la división del tráfico con algunos controladores de Ingress y mallas de servicios puede llevar mucho tiempo y ser propenso a errores por diversos motivos:
- Los controladores de Ingress y las mallas de servicios de distintos proveedores implementan las funcionalidades de Kubernetes de formas diferentes.
- Kubernetes no está realmente diseñado para gestionar y comprender el tráfico de capa 7.
- Algunos controladores de Ingress y mallas de servicios no admiten una gestión avanzada del tráfico.
Con NGINX Ingress Controller y NGINX Service Mesh, puede configurar fácilmente y en cuestión de segundos sólidas políticas de enrutamiento y distribución del tráfico. Vea esta demostración en directo con nuestros expertos y siga leyendo para descubrir cómo le ayudamos a ahorrar tiempo gracias a configuraciones más sencillas, personalizaciones avanzadas y una mayor visibilidad.
Configuración más sencilla con los recursos de Ingress de NGINX y la especificación SMI
Estas funciones de NGINX facilitan la configuración:
- Recursos Ingress de NGINX para NGINX Ingress Controller – Aunque el recurso Ingress estándar de Kubernetes facilita la configuración de la terminación SSL/TLS, el balanceo de carga HTTP y el enrutamiento de capa 7, no incluye las funciones de personalización necesarias para la interrupción de circuitos, las pruebas A/B y los despliegues blue-green. En su lugar, quienes no utilizan NGINX tienen que recurrir a anotaciones, ConfigMaps y plantillas personalizadas, que carecen de un control detallado, no son seguras, son propensas a errores y resultan difíciles de usar. NGINX Ingress Controller incluye recursos Ingress de NGINX como alternativa al recurso Ingress estándar (que también admite). Estos ofrecen un estilo de configuración nativo, con seguridad de tipos y basado en sangrías, que simplifica la implementación del balanceo de carga de Ingress. Los recursos Ingress de NGINX aportan una ventaja adicional a quienes ya utilizan NGINX: facilitan la reutilización de configuraciones de balanceo de carga procedentes de entornos ajenos a Kubernetes, de modo que todos sus balanceadores de carga NGINX puedan utilizar las mismas configuraciones.
- NGINX Service Mesh con SMI – NGINX Service Mesh implementa Service Mesh Interface (SMI), una especificación que define una interfaz estándar para las mallas de servicios en Kubernetes, con recursos tipados como
TrafficSplit,TrafficTargetyHTTPRouteGroup. Mediante los métodos de configuración estándar de Kubernetes, NGINX Service Mesh y las extensiones SMI de NGINX facilitan la implementación de políticas de división del tráfico, como los despliegues canary, con una interrupción mínima del tráfico de producción. Por ejemplo, así se define un despliegue canary con NGINX Service Mesh:
apiVersion: split.smi-spec.io/v1alpha2kind: TrafficSplit
metadata:
name: target-ts
spec:
service: target-svc
backends:
- service: target-v1-0
    weight: 90
- service: target-v2-0
weight: 10- Nuestro tutorial, «Implementaciones mediante la división del tráfico», explica paso a paso patrones de implementación de ejemplo que aprovechan la división del tráfico, incluidas las implementaciones canary y blue-green.
Control y división del tráfico más sofisticados mediante personalizaciones avanzadas
Estas funcionalidades de NGINX permiten controlar y dividir el tráfico fácilmente de formas avanzadas:
- El almacén de clave-valor para despliegues canary – Al realizar pruebas A/B o despliegues blue-green, puede que quieras dirigir el tráfico a la nueva versión en incrementos específicos, por ejemplo, 0 %, 5 %, 10 %, 25 %, 50 % y 100 %. Con la mayoría de las herramientas, este es un proceso muy manual, ya que hay que modificar el porcentaje y volver a cargar el archivo de configuración en cada incremento. Debido a toda esta carga de trabajo, podrías decidir asumir el riesgo de pasar directamente del 5 % al 100 %. Sin embargo, con la versión de NGINX Ingress Controller basada en NGINX Plus, puedes aprovechar el almacén de clave-valor para cambiar los porcentajes sin necesidad de volver a cargar la configuración.
- Disyuntores con NGINX Ingress Controller – Los disyuntores avanzados ahorran tiempo y mejoran la resiliencia al detectar los fallos y realizar la conmutación por error con mayor rapidez, e incluso al activar páginas de error personalizadas y con el formato adecuado para los servidores ascendentes que no funcionan correctamente. Por ejemplo, un disyuntor para un servicio de búsqueda podría configurarse para devolver un conjunto de resultados de búsqueda vacío, pero con el formato correcto. Para alcanzar este nivel de sofisticación, la versión de NGINX Ingress Controller basada en NGINX Plus utiliza comprobaciones de estado activas que supervisan de forma proactiva el estado de los servidores ascendentes TCP y UDP. Gracias a esta supervisión en tiempo real, es menos probable que los clientes se encuentren con aplicaciones que devuelvan errores.
- Disyunción de circuitos con NGINX Service Mesh – La especificación del disyuntor de NGINX Service Mesh tiene tres campos personalizados: Aunque
errorsytimeoutSecondsson funciones estándar de los disyuntores,fallbackmejora aún más la resiliencia al permitir definir un servidor de respaldo. Si las respuestas de este servidor son únicas, pueden servir como indicador temprano de problemas en el clúster, lo que permite empezar a diagnosticarlos de inmediato.errors– Número de errores antes de que se abra el circuitotimeoutSeconds– El intervalo de tiempo en el que deben producirse los errores antes de que se abra el circuito, así como el tiempo que se debe esperar antes de cerrarlofallback– El nombre y el puerto del servicio de Kubernetes al que se redirige el tráfico después de que se haya activado el circuito
Interpretar los resultados de la división del tráfico mediante paneles
Ya ha implementado la división del tráfico… ¿y ahora qué? Es hora de analizar el resultado. Esta puede ser la parte más difícil, ya que muchas organizaciones carecen de información clave sobre el rendimiento del tráfico y las aplicaciones de Kubernetes. NGINX facilita la obtención de información mediante el panel de NGINX Plus y los paneles prediseñados de Grafana, que muestran las métricas proporcionadas por Prometheus Exporter. Para obtener más información sobre cómo mejorar la visibilidad, lea Cómo mejorar la visibilidad en Kubernetes en nuestro blog.
Domina los microservicios con NGINX
El controlador de entrada NGINX basado en NGINX Plus está disponible con una prueba gratuita de 30 días que incluye NGINX App Protect para proteger sus aplicaciones en contenedores.
Para probar NGINX Ingress Controller con NGINX Open Source, puede obtener el código fuente de la versión, o descargar un contenedor precompilado de DockerHub.
NGINX Service Mesh, que es gratuito para siempre, está disponible para descargar en f5.com.
Sobre el autor

Artículos relacionados del blog

Únete a F5 NGINX en AppWorld 2024
Descubre las numerosas razones para asistir al evento insignia de F5, que incluirá un emocionante anuncio sobre la cartera de productos NGINX.
Rotación de certificados SSL/TLS sin reinicios en NGINX Open Source
La función de diccionario compartido permite configurar NGINX sin necesidad de reiniciarlo al renovar los certificados SSL/TLS.
Exposición de APIs en Kubernetes
La unidad 2 de Microservices March 2022 se centra en cómo exponer tus API en Kubernetes. Aquí tienes enlaces a los recursos que necesitas: la retransmisión en directo del 14 de marzo, artículos de blog y otros recursos de preparación, y el laboratorio práctico «Protege las API de Kubernetes mediante la limitación de solicitudes».
NGINX Sprint 2.0: visión clara, código renovado y nuevos compromisos con el código abierto
Hoy, en NGINX Sprint 2.0, anunciamos cómo respaldaremos nuestra visión del futuro de las aplicaciones modernas con una mayor presencia en la comunidad de código abierto, incluida la participación en el proyecto comunitario Kubernetes, nuevos proyectos de software de código abierto y la arquitectura de referencia para aplicaciones modernas.
Presentamos NGINX Plus R22
NGINX Plus R22 incorpora nuevas funcionalidades, como la compatibilidad con OCSP para verificar la revocación de certificados en TLS mutuo, el uso de varios proveedores de identidad OIDC en una configuración, el seguimiento en tiempo real de la limitación de solicitudes y conexiones en el panel de NGINX Plus y mejoras en NGINX JavaScript.
Presentamos NGINX Plus R17
NGINX Plus R17 incorpora compatibilidad con la limitación de velocidad en dos fases y con TLS 1.3, la versión más reciente del protocolo Transport Layer Security. La configuración de OpenID Connect es más sencilla y NGINX ModSecurity WAF es el doble de rápido que antes. También se ha actualizado el módulo JavaScript de NGINX.