
Esta es la tercera entrada de una serie de artículos en los que abordamos diversos aspectos de lo que supuso crear y gestionar nuestro servicio SaaS:
- Plano de control para una PaaS de Kubernetes distribuida
- Malla de servicios global para aplicaciones distribuidas
- Seguridad de la plataforma para infraestructuras, aplicaciones y datos distribuidos
- Seguridad de las aplicaciones y de la red de los clústeres distribuidos
- Observabilidad en una plataforma distribuida globalmente
- Operaciones y SRE de una plataforma distribuida globalmente
- Framework de servicios en Golang para microservicios distribuidos
Mi primera entrada del blog explicaba el contexto y las necesidades que nos llevaron a crear una nueva plataforma para nubes distribuidas. Con esta plataforma, nuestros clientes desarrollan un conjunto complejo y diverso de aplicaciones, como fabricación inteligente, análisis forense de vídeo para la seguridad pública, negociación algorítmica y redes 5G de telecomunicaciones.
Dado que muchas de estas aplicaciones son críticas, nuestros clientes esperan que no solo proporcionemos seguridad multicapa, sino que también podamos realizar mejoras continuas para mantener protegidos sus clústeres distribuidos. Este artículo aborda los retos que plantea proteger la infraestructura, las aplicaciones y los datos en varios clústeres.
TL;DR (Resumen)
- Aunque se sabe relativamente bien cómo proporcionar a usuarios y empleados un acceso seguro a las aplicaciones (lo hacemos a diario cuando accedemos a nuestras cuentas bancarias o a nuestro correo electrónico corporativo), no resulta tan sencillo hacer lo mismo con el acceso entre aplicaciones o de aplicaciones a datos, ya que no interviene ninguna persona en el proceso de verificación.
- Proteger las aplicaciones y los datos en un entorno heterogéneo (periferia, múltiples nubes y puntos de presencia de red) nos obligó a resolver un problema con múltiples capas: identidad, autenticación y autorización, secretos y gestión de claves
- Aunque existen muchas soluciones específicas para estos cuatro problemas (por ejemplo, diversos servicios de proveedores de nube individuales, Hashicorp Vault, SPIFFE/Spire, etc.), no hay ninguna solución integrada que funcione con distintos proveedores de nube ni que combine a la perfección cada uno de estos servicios para facilitar su uso.
- Dada la falta de experiencia de nuestros equipos de desarrollo y DevOps a la hora de integrar todos estos componentes, resultó esencial que nuestro equipo de plataforma ofreciera estas capacidades como una solución integrada y fácil de usar. La evolución del panorama de la seguridad y la aparición de nuevas tecnologías dificultan aún más la labor de estos equipos, ya que no cuentan con los conocimientos necesarios ni con la capacidad para mantenerse al día de todos los cambios.
- Como parte de la implementación de una seguridad de plataforma multicapa, desarrollamos nuevos componentes de software que resolvían tres problemas críticos de una forma totalmente novedosa: el arranque seguro de una identidad universal que no adolece del problema de la «regresión infinita»; secretos que pueden almacenarse y distribuirse sin tener que preocuparse en ningún momento por que un almacén central se vea comprometido (problema de la mina de oro); y la gestión distribuida de claves para facilitar la protección de los datos en reposo.
Contexto del problema de seguridad
Como se ha indicado anteriormente, el problema de proteger el acceso de los usuarios a las aplicaciones (por ejemplo, el acceso a nuestras cuentas bancarias o a nuestros correos electrónicos) se conoce bien. Sin embargo, no resulta tan sencillo hacer lo mismo con el acceso entre aplicaciones o de aplicaciones a datos, ya que no interviene ninguna persona en el proceso de verificación.
Para que una aplicación pueda acceder de forma segura a otro recurso —por ejemplo, a datos almacenados en un almacén de objetos o realizar una llamada a la API de otra aplicación—, debe ocurrir lo siguiente:
- Identidad — el solicitante debe obtener de forma segura una identidad verificable que pueda utilizarse con fines de autenticación y autorización al acceder a los recursos necesarios. Asimismo, se le deben proporcionar de forma segura los anclajes de confianza necesarios para verificar las identidades de las otras partes.
- Autenticación — Durante el proceso de acceso a un recurso determinado, el solicitante y el propietario del recurso deben verificar de forma segura la identidad del otro. El proceso de verificar la identidad declarada por la otra parte contrastándola con la identidad presentada se denomina autenticación.
- Autorización — una vez autenticado el solicitante, el proceso de comprobar si tiene permiso para acceder al recurso se denomina autorización.
Como parte del proceso de autenticación, la aplicación solicitante puede acreditar su identidad mediante un certificado PKI, un secreto (por ejemplo, una contraseña) o una clave. Al utilizar secretos o una clave como medio de identificación, deben abordarse dos cuestiones:
- Los secretos y las claves no deben almacenarse directamente en el código, ya que esto constituye un vector de ataque fácil de explotar y la filtración de claves puede suponer un grave problema.
- Si los secretos se almacenan en una bóveda externa, ¿qué identidad (normalmente, otro secreto) debe utilizarse para obtener el secreto y cómo protegemos dicha identidad?
Realizar estas operaciones de seguridad (para la interacción entre aplicaciones) de forma fiable y reproducible es un problema complejo. Hay muchas razones que explican esta complejidad:
- Las aplicaciones se pueden clonar y replicar fácilmente (por ejemplo, los microservicios). ¿Cómo se puede asignar una identidad única a cada réplica que pueda ser necesaria con fines de análisis forense, auditoría u observabilidad?
- La identidad de la aplicación variará en función del entorno en el que se ejecute. Por ejemplo, la aplicación es la misma en los entornos de desarrollo y producción, pero necesita una identidad diferente en cada uno de ellos.
- ¿Cómo generar confianza en que la infraestructura en la que se está desplegando la aplicación no robará la identidad, los secretos ni las claves sin que nadie se dé cuenta?
- ¿Cómo proteger el almacén central frente a ataques y garantizar la seguridad de todos los secretos y claves que contiene?
Como resultado, proteger la infraestructura, las aplicaciones y los datos en un entorno dinámico supone un reto considerable. Aunque los proveedores de servicios en la nube han respondido a este desafío y ofrecen numerosas herramientas para abordar estos problemas, integrarlas y mantenerlas no resulta sencillo por los siguientes motivos:
- Complejidad — Cada proveedor de servicios en la nube exige que el cliente configure y gestione varios servicios. Por ejemplo, en AWS: el servicio de metadatos, los roles de IAM, la cuenta de servicio, RBAC, KMS y el gestor de secretos. Cada uno de estos servicios varía considerablemente de un proveedor de servicios en la nube a otro, tanto en su semántica como en sus API y su supervisión.
- Interoperabilidad — Incluso cuando los servicios del proveedor de nube están configurados y operativos, ninguno de ellos permite la interoperabilidad. Por ejemplo, una máquina virtual que se ejecuta en GCP no puede acceder a un recurso de AWS porque este no reconoce la identidad asignada mediante la cuenta de servicio de GCP.
- Entornos heterogéneos — Si el entorno está distribuido entre nubes públicas y privadas, entre varias nubes públicas o, peor aún, en el extremo de la red, el reto será decidir cómo y dónde almacenar secretos como contraseñas, claves, etc.: de forma centralizada o distribuida.
- Específico de cada entorno — La solución para la rotación o revocación de credenciales es muy diferente en cada proveedor de servicios en la nube, mientras que no existe ninguna solución de este tipo para los clústeres en el extremo.
Aunque muchas empresas trabajan con un único proveedor de servicios en la nube y puede que les baste con invertir recursos en gestionar y mejorar los mecanismos de seguridad de dicho proveedor, nosotros operamos en un entorno heterogéneo (nube híbrida y edge) y tuvimos que desarrollar una nueva solución para resolver estos problemas.
Solución para proteger una plataforma distribuida
Nuestro equipo recibió el encargo de garantizar la seguridad de las aplicaciones, la infraestructura y los datos que pudieran estar alojados en una infraestructura distribuida, tal como se muestra en la Figura 1.
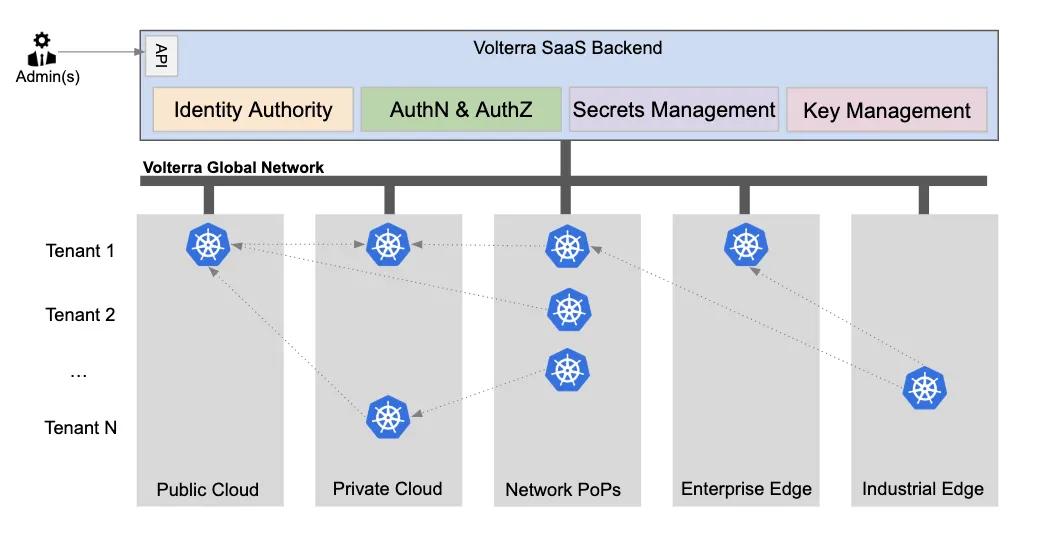
Como resultado, nuestro equipo de plataforma decidió desarrollar nuevos servicios de software que integrasen los cuatro aspectos siguientes para garantizar la seguridad de la plataforma en el edge, en cualquier nube y en nuestros PoP de red:
- Gestión de identidades — describiremos cómo proporcionamos una identidad basada en PKI, criptográficamente segura e imposible de falsificar, no solo a las aplicaciones, sino también a la infraestructura distribuida en un entorno heterogéneo (varias nubes, nuestros PoP globales y ubicaciones perimetrales geográficamente dispersas) y que funciona en distintos entornos (p. ej., equipo de desarrollo, pruebas unitarias, producción, etc.)
- Autenticación y autorización — nuestra infraestructura se basa en microservicios que utilizan una identidad basada en PKI y autentican mutuamente todas las comunicaciones, independientemente del protocolo de comunicación utilizado. También hemos desacoplado la autorización de la autenticación para poder utilizar un motor de autorización común en distintos tipos de decisiones de autorización y unificar la estructura de las políticas.
- Sistema de gestión de secretos — existen muchos tipos de secretos (como certificados TLS, contraseñas, tokens, etc.) que necesitan tanto nuestro software como las cargas de trabajo de los clientes. El método más sencillo habría sido adoptar un almacén centralizado en el que se guardaran todos los secretos, pero este enfoque tenía el inconveniente de que cualquier vulneración dejaría al descubierto todos los secretos. Describiremos un enfoque diferente que implementamos para lograr un mayor nivel de seguridad a costa de cierta simplicidad.
- Sistema de gestión de claves (KMS) — la seguridad de los datos es fundamental para nuestro sistema distribuido, y el equipo tuvo que desarrollar un KMS que funcionara de forma fluida con distintos proveedores de servicios en la nube. El KMS debe gestionar, versionar y rotar las claves utilizadas para el cifrado y descifrado simétricos de los datos en reposo, el HMAC de los tokens CSRF y la firma digital de archivos binarios. Explicaremos cómo ofrecemos funcionalidades tanto para operaciones sensibles desde el punto de vista de la seguridad mediante este KMS como para operaciones sensibles a la latencia mediante el sistema de gestión de secretos.
Identidad infalsificable para la infraestructura y las aplicaciones
La identidad es una cuestión fundamental, ya que muchos retos de seguridad pueden abordarse más fácilmente una vez resuelto el problema de la identidad. Sin embargo, para resolverlo, debemos definir qué entendemos por identidad y cómo otorgarla de forma fiable. A los entusiastas de la criptografía les gusta dar su propio enfoque a todo, y la definición de identidad no es una excepción:
El conjunto único y completo de características infalsificables y verificables criptográficamente que han sido certificadas criptográficamente por una autoridad de confianza mediante un protocolo seguro y sin delegación, y que conforman aquello por lo que se conoce o considera a una persona o cosa.
En esencia, lo que se necesita es una identidad infalsificable y verificable criptográficamente que se proporcione de forma segura. Emitir una identidad de este tipo resulta complicado por dos motivos: 1) establecimiento inicial de la identidad y 2) raíz de confianza
Hay varios enfoques que suelen mencionarse al hablar de identidad, como SPIFFE y Hashicorp Vault. Cabe aclarar que SPIFFE es un esquema de nomenclatura que podría utilizarse en nuestro sistema como documento de identidad (certificado X.509); sin embargo, el formato no es adecuado para algunos atributos de identidad que contienen datos binarios. Aunque Vault puede utilizarse para emitir un documento de identidad, no resuelve los retos del establecimiento inicial de la identidad ni el problema de la raíz de confianza:
- Inicialización de la identidad — en la vida real, cuando nace una persona, su identidad queda establecida mediante el certificado de nacimiento. De este modo, se inicializa la identidad de la persona y, a partir de este certificado, puede obtener o solicitar otros documentos de identidad, como el pasaporte, el permiso de conducir, etc. Del mismo modo, en el mundo de la informática, cada vez que se inicia una aplicación (o un microservicio), es necesario inicializar una identidad. Establecer la identidad es uno de los primeros pasos que debe realizar cualquier código en ejecución para poder interactuar con otros servicios. Además, dado que el mismo código de una aplicación puede iniciarse varias veces y en distintos entornos `(portátil del desarrollador, pruebas unitarias o producción), también es necesario que cada una de estas instancias establezca una identidad de inicialización independiente.
- Raíz de confianza — aunque emitir una identidad inicial puede parecer un proceso sencillo, el problema radica en quién se encarga de proporcionarla. Por ejemplo, en el mundo real, la provisión de una identidad comienza cuando el hospital certifica que un niño nació en una fecha y hora determinadas de una persona concreta, y se presupone que el hospital expide el registro de nacimiento tras realizar las comprobaciones pertinentes y que este no puede falsificarse. Por tanto, el documento del registro de nacimiento puede utilizarse como fuente de verdad (o raíz de confianza). Del mismo modo, cuando una aplicación es iniciada por una persona o mediante código automatizado, debe existir una raíz de confianza que pueda acreditar de forma verificable la identidad de la aplicación iniciada. Esta acreditación puede utilizarse posteriormente para generar un documento de identidad para la aplicación.
Por ejemplo, cuando se inicia una máquina virtual en AWS, se le proporciona una identidad de arranque y el servicio de metadatos de AWS actúa como raíz de confianza. El documento de identidad (firmado por AWS con su propia clave criptográfica) tiene un aspecto similar a este:
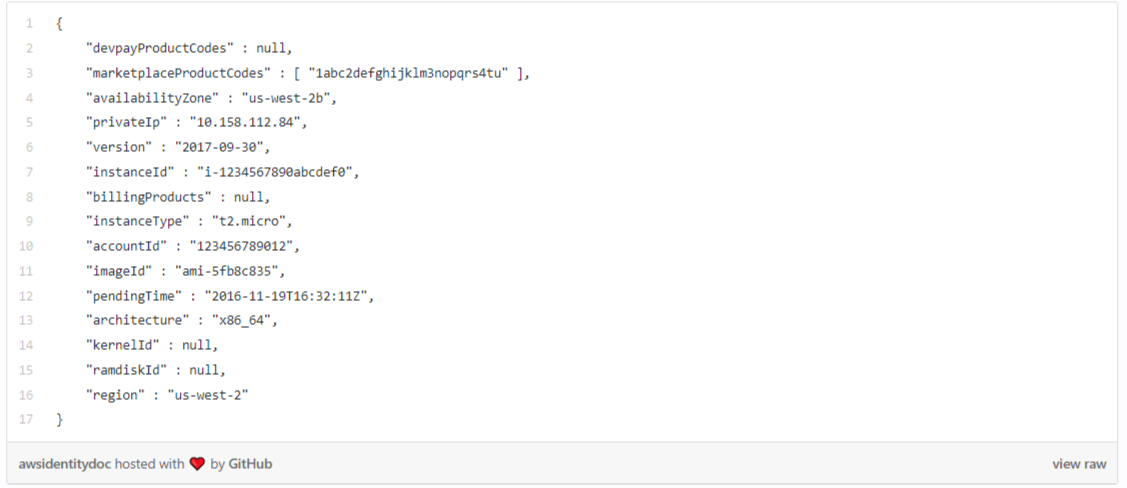
Aunque instanceId puede indicar la identidad única de la instancia de la aplicación que se ha iniciado, debe vincularse a algún nombre conocido (myserver.acmecorp.com) que otras aplicaciones utilizarán para comunicarse con esta instancia concreta. Por tanto, ni siquiera este documento de identidad de arranque de AWS es suficiente, aunque puede utilizarse para emitir otra identidad que las aplicaciones puedan usar para comunicarse con otra aplicación.
Como se ha indicado anteriormente, para nosotros era fundamental proporcionar una identidad que permitiera a las aplicaciones comunicarse y compartir información entre distintos proveedores de servicios en la nube y/o ubicaciones en el extremo de la red (Figura 2). Esto implicaba crear un sistema tanto para el arranque de identidades como para la raíz de confianza que funcionara en todos estos entornos.
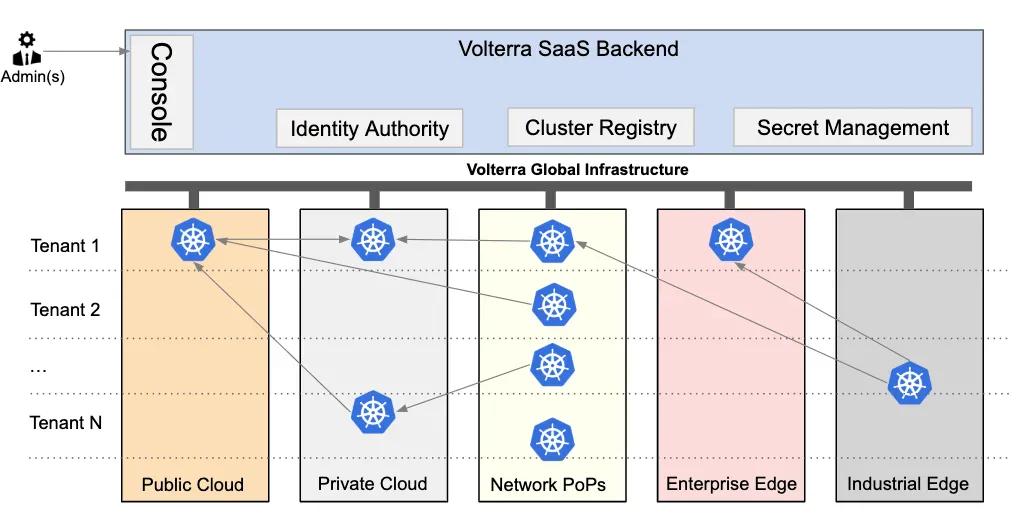
Dado que utilizamos Kubernetes para gestionar y orquestar aplicaciones (tanto microservicios como máquinas virtuales), tuvimos que integrar la inicialización de una identidad única para cada pod que se inicia en el proceso de creación de pods de Kubernetes. La figura 3 muestra cómo nos integramos en el proceso de creación de pods mediante el mecanismo de webhooks de K8s. Este webhook, denominado Voucher, inyecta un sidecar de seguridad llamado Wingman en todos los pods creados en el clúster y también proporciona la información necesaria, firmada criptográficamente, que puede utilizarse como raíz de confianza. Este webhook proporciona un token firmado de corta duración que Wingman utiliza para solicitar un certificado X.509 a Identity Authority en el backend SaaS de Volterra.
La Autoridad de Identidad aplica las reglas de creación de identidades de forma que se minimice el «radio de impacto» en caso de que uno de los clústeres de K8s se vea comprometido. Muchas otras soluciones que dependen de una CA raíz común o de la federación de clústeres de K8s no pueden limitar el radio de impacto, lo que influyó de manera decisiva en nuestra decisión de diseño.
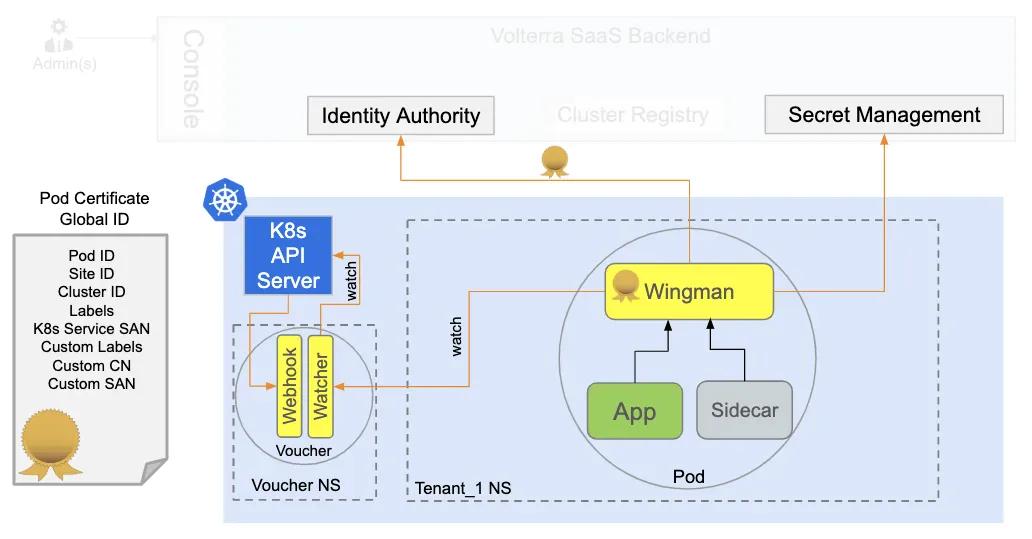
Para un Pod determinado en K8s, los atributos pueden cambiar después de crear el Pod. Por ejemplo, un Pod puede asociarse a un nuevo servicio después de su creación. Esto implicaba que los certificados de identidad debían actualizarse con el nuevo servicio. Wingman supervisa continuamente el Voucher que realiza el seguimiento del servidor de la API de K8s para detectar cualquier actualización de este tipo.
Este mecanismo proporciona una identidad global única y universal a cada instancia de aplicación que se ejecuta en nuestra plataforma, independientemente de si se trata de una carga de trabajo propia o de un cliente. Esta identidad única y el contenedor auxiliar (Wingman) se utilizan para proteger todas las comunicaciones, los accesos y las claves y secretos en todo el sistema distribuido.
Autenticación y autorización
Contar con una identidad única para cada Pod es un excelente punto de partida, ya que facilita la implementación de la autenticación mutua entre los servicios que se comunican. Nuestra infraestructura subyacente está formada por numerosos servicios diferentes que utilizan distintos protocolos, como gRPC, REST, IPSec, BGP, etc. Desde el principio, el equipo se propuso lograr la autenticación mutua y la seguridad de las comunicaciones (canal cifrado) para todas las partes implicadas, independientemente del protocolo. Esto también implicaba que no podíamos vincular nuestra identidad a una solución (por ejemplo, Istio) limitada a un conjunto concreto de protocolos (por ejemplo, HTTP/TCP frente a protocolos basados en IP).
Dado que nuestra plataforma también permite a los clientes ejecutar las cargas de trabajo que elijan, prevemos que estas puedan utilizar diversos protocolos, por lo que la plataforma no debería limitar sus posibilidades proporcionando una identidad restringida a un conjunto concreto de protocolos. En su lugar, la autenticación se desacopla de la identidad (mediante Wingman), lo que permite la integración con distintas tecnologías de malla de servicios. El sidecar/plano de datos de nuestra malla de servicios (descrito en una entrada anterior del blog) utiliza esta identidad para proporcionar mTLS a las cargas de trabajo de los clientes.
Dado que muchos de nuestros propios servicios de infraestructura se desarrollaron utilizando Volterra Golang Service Framework (del que hablaremos en una futura entrada del blog), decidimos integrar directamente en el framework la lógica para consumir la identidad (procedente de Wingman). Esto ha permitido a nuestros desarrolladores proteger de forma nativa las comunicaciones entre servicios sin depender de un sidecar de malla de servicios para mTLS.
El siguiente paso lógico tras establecer un canal seguro con autenticación mutua es la autorización: un proceso mediante el cual el receptor de la solicitud (servidor) determina si debe permitir o no la solicitud procedente del emisor identificado (cliente). Puede haber muchos motivos para denegarla, como limitaciones de cuota, permisos, etc. Dado que estos motivos y sus umbrales cambian dinámicamente, un conjunto de reglas (política) de autorización codificadas de forma rígida no era una opción viable para nuestra plataforma.
Decidimos utilizar el motor de Open Policy Agent como punto de partida y creamos una capa de abstracción para la autorización dentro del sidecar Wingman. El código de esta capa obtiene dinámicamente las políticas pertinentes y las mantiene listas para evaluarlas con rapidez. Al igual que con la autenticación, desacoplar el motor de autorización de la identidad (y de la autenticación) nos ha permitido aplicar políticas de autorización en varias etapas del procesamiento de las solicitudes, incluso en niveles profundos de la lógica de negocio, y no solo inmediatamente después de la autenticación.
Dado que Wingman está integrado en todas las cargas de trabajo, incluidas las de los clientes, nuestra plataforma ofrece un motor de autorización como funcionalidad integrada. Aunque Open Policy Agent (OPA) se basa en un potente lenguaje llamado Rego, queríamos ocultar su complejidad a nuestros desarrolladores y clientes. Todas las políticas de nuestra plataforma también pueden definirse mediante una estructura de políticas mucho más intuitiva y fácil de entender, que no exige que los usuarios (DevOps) aprendan Rego y, por tanto, ayuda a evitar errores. Al igual que con la configuración de la autenticación, nuestro framework de servicios de Golang se integró con el motor de autorización de Wingman, llamando automáticamente a Wingman para gestionar la autorización y ocultando así su complejidad a los desarrolladores.
Mediante el uso de una identidad única (emitida por Wingman) para la autenticación y un motor de políticas programable (integrado en Wingman) para la autorización, podemos proteger las comunicaciones mediante mTLS y controlar cada acceso con una política sólida y programable.
Gestión de secretos sin una bóveda centralizada
A diario, los ingenieros cometen errores involuntarios al almacenar claves y contraseñas en su código, que de algún modo terminan en repositorios públicos de código o artefactos. Gestionar secretos es difícil y, sin un conjunto de herramientas fácil de usar y un proceso bien definido, es de esperar que los desarrolladores opten por el camino más corto. Por ello, desde los inicios de la empresa, la misión de nuestro equipo de seguridad de la plataforma (distinta de la seguridad de redes y aplicaciones) ha sido garantizar que los desarrolladores no tengan que plantearse preguntas como: «¿Dónde almaceno los secretos: en el código fuente, en los artefactos o…?»
Cuando empezamos a desarrollar nuestra plataforma, evaluamos dos enfoques habituales que teníamos a nuestra disposición para gestionar secretos, y ambos presentaban ciertas carencias:
- Secretos de Kubernetes — Aunque utilizamos Kubernetes y este incluye su propia solución para gestionar secretos, no resulta especialmente útil por varios motivos: los secretos no se cifran cuando están almacenados, las estructuras de políticas no son exhaustivas y no resuelve los escenarios con varios clústeres.
- Almacén centralizado (p. ej., Hashicorp Vault o Cyberark Vault) — Otro enfoque podría haber sido utilizar un almacén en el que los secretos se guardaran de forma centralizada y se proporcionaran a los solicitantes autorizados. Los secretos están protegidos por una única clave de cifrado que se utiliza para el almacenamiento cifrado del almacén. Sin embargo, el problema de este enfoque es que el sistema de gestión de secretos tiene acceso a los secretos en texto claro (aunque se almacenen cifrados) y cualquier vulneración del sistema podría revelar todos los secretos.
En nuestro caso, al tratarse de un servicio SaaS, tuvimos que idear un método más sólido para proteger los secretos de nuestros clientes, ya que ninguna vulneración debería revelarlos.
Como resultado, decidimos implementar una nueva técnica que denominamos Volterra Blindfold (marca registrada), que funciona conjuntamente con nuestro sidecar de seguridad, Wingman, como se muestra en la Figura 4. Este enfoque permite al propietario del secreto bloquearlo (cifrarlo) de tal forma que nunca se revele en texto claro a ninguna parte no deseada (incluido el servidor de descifrado). El secreto ni siquiera se almacena en un servidor central de descifrado y este diseño, en ciertos aspectos, simplifica drásticamente el diseño del servidor.
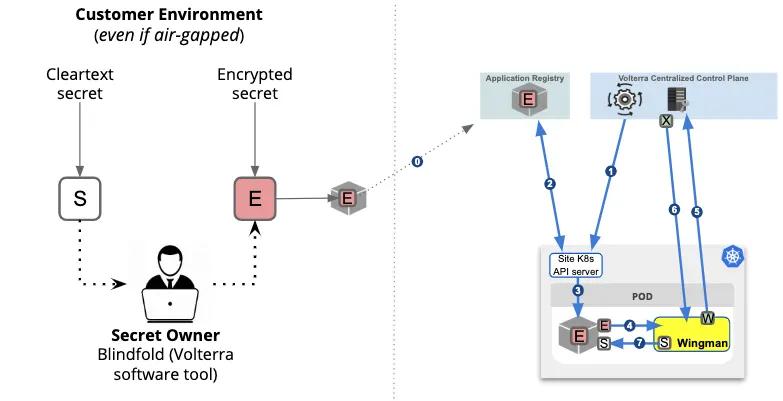
Proporcionamos a los usuarios una herramienta de blindfold que puede utilizarse en un entorno completamente sin conexión para cifrar el secreto (S), que después puede distribuirse. Por ejemplo, el propio secreto puede almacenarse junto con la carga de trabajo y subirse al registro. Una vez hecho esto, deben llevarse a cabo los siguientes pasos:
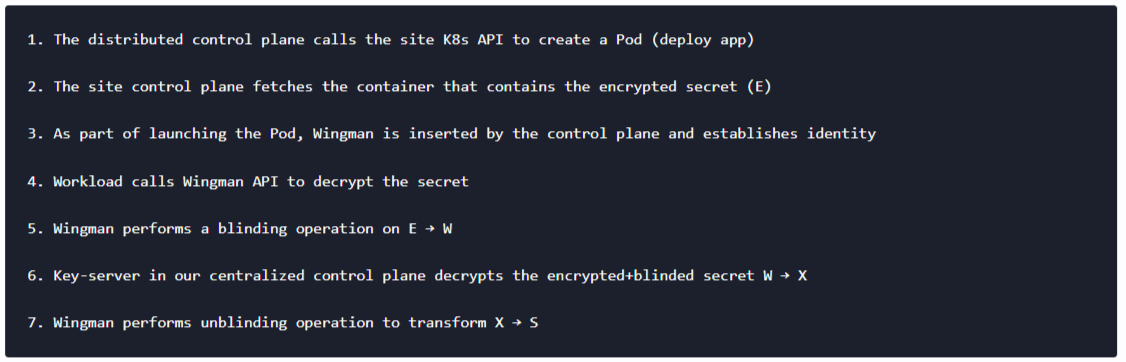
Esto garantiza que el plano de control centralizado nunca tenga acceso al secreto en texto claro (S) y que este solo esté disponible en la memoria de ejecución del Pod mientras dure el acceso. Además, se puede aplicar una política de acceso para definir quién puede acceder a un secreto. La política puede definirse en función de atributos de identidad, como el nombre de la aplicación, la ubicación, el nivel de cumplimiento, etc. De este modo, se puede delimitar cualquier subconjunto complejo de cargas de trabajo y lograr un control de acceso preciso. La política se integra criptográficamente en el proceso de cifrado, cegado, descifrado y eliminación del cegado, por lo que resulta computacionalmente inviable eludir su propósito.
Gracias a nuestra exclusiva técnica Blindfold, que bloquea cada secreto, y a Wingman, que lo desbloquea en función de las políticas y de una identidad infalsificable, podemos superar los problemas de las soluciones existentes y gestionar secretos en un entorno distribuido sin tener que preocuparnos en ningún momento de que el repositorio central se vea comprometido.
Gestión de claves para sistemas distribuidos
Aunque la gestión de secretos y la gestión de claves puedan parecer dos formas distintas de referirse al mismo problema, existen diferencias sutiles —pero importantes en la práctica— entre ambas, según a quién se pregunte y cómo se quieran implementar las soluciones.
Un secreto es cualquier información que deba mantenerse confidencial y no estar disponible para personas no autorizadas. En cierto modo, las claves criptográficas son un tipo específico de secreto. La gestión de claves, por su parte, suele referirse a un sistema que almacena de forma segura material criptográfico confidencial y controla su uso. En algunos casos, el sistema de gestión de claves puede proporcionar los bytes sin procesar de la clave a las partes autorizadas, por lo que puede confundirse con un sistema de gestión de secretos. Sin embargo, en la mayoría de los casos, el sistema de gestión de claves no proporciona los bytes sin procesar del material criptográfico, sino que realiza operaciones para los solicitantes autorizados y envía únicamente el resultado de la operación. Además, muchos sistemas de gestión de claves utilizan almacenamiento basado en hardware (p. ej., un HSM) para el material criptográfico, de modo que la clave nunca queda expuesta en texto claro al software.
En entornos distribuidos, incluso cuando se utiliza un único proveedor de servicios en la nube, gestionar, sincronizar y rotar las claves criptográficas resulta muy complicado, y las soluciones actuales son propensas a errores, ineficientes e incluso inseguras. Por ejemplo, si actualmente se utilizan tres regiones de AWS y se quiere usar la misma clave criptográfica en las tres, será necesario sincronizar y rotar las claves manualmente. El problema se agrava aún más cuando el entorno abarca varios proveedores de servicios en la nube (públicos o privados). Incluso después de resolver todo esto, los responsables de las aplicaciones siguen teniendo que escribir código complejo para aprovechar estas funciones de KMS.
Nuestra plataforma oculta a la aplicación toda la complejidad de la gestión de claves, haciendo que el sidecar Wingman se encargue de todo el trabajo pesado y proporcione a la aplicación interfaces sencillas para realizar solicitudes de gestión de claves, como cifrado, descifrado, HMAC, verificación de HMAC, firma digital, verificación de firmas, obtención de claves (cuando esté permitido), etc. De este modo, la gestión de claves deja de ser una tarea abrumadora tanto para nuestros propios servicios de infraestructura como para las cargas de trabajo de los clientes.
El siguiente diagrama (Figura 5) muestra cómo funciona el KMS de Volterra en distintos entornos y cómo ayuda a las cargas de trabajo a delegar sus operaciones de gestión de claves y criptografía en el sidecar Wingman. Según la configuración, Wingman puede almacenar claves en caché y actualizar dicha caché sin que la aplicación llegue siquiera a saberlo. El factor que lo hace posible es la identidad universal e infalsificable que presentamos anteriormente. Dado que cada Pod, independientemente de su ubicación, obtiene una identidad única a nivel global, el sistema KMS de Volterra puede aplicar con gran precisión políticas de acceso a las claves criptográficas y a operaciones específicas como el cifrado, el descifrado, HMAC, la verificación de HMAC, la firma digital y la verificación de firmas.
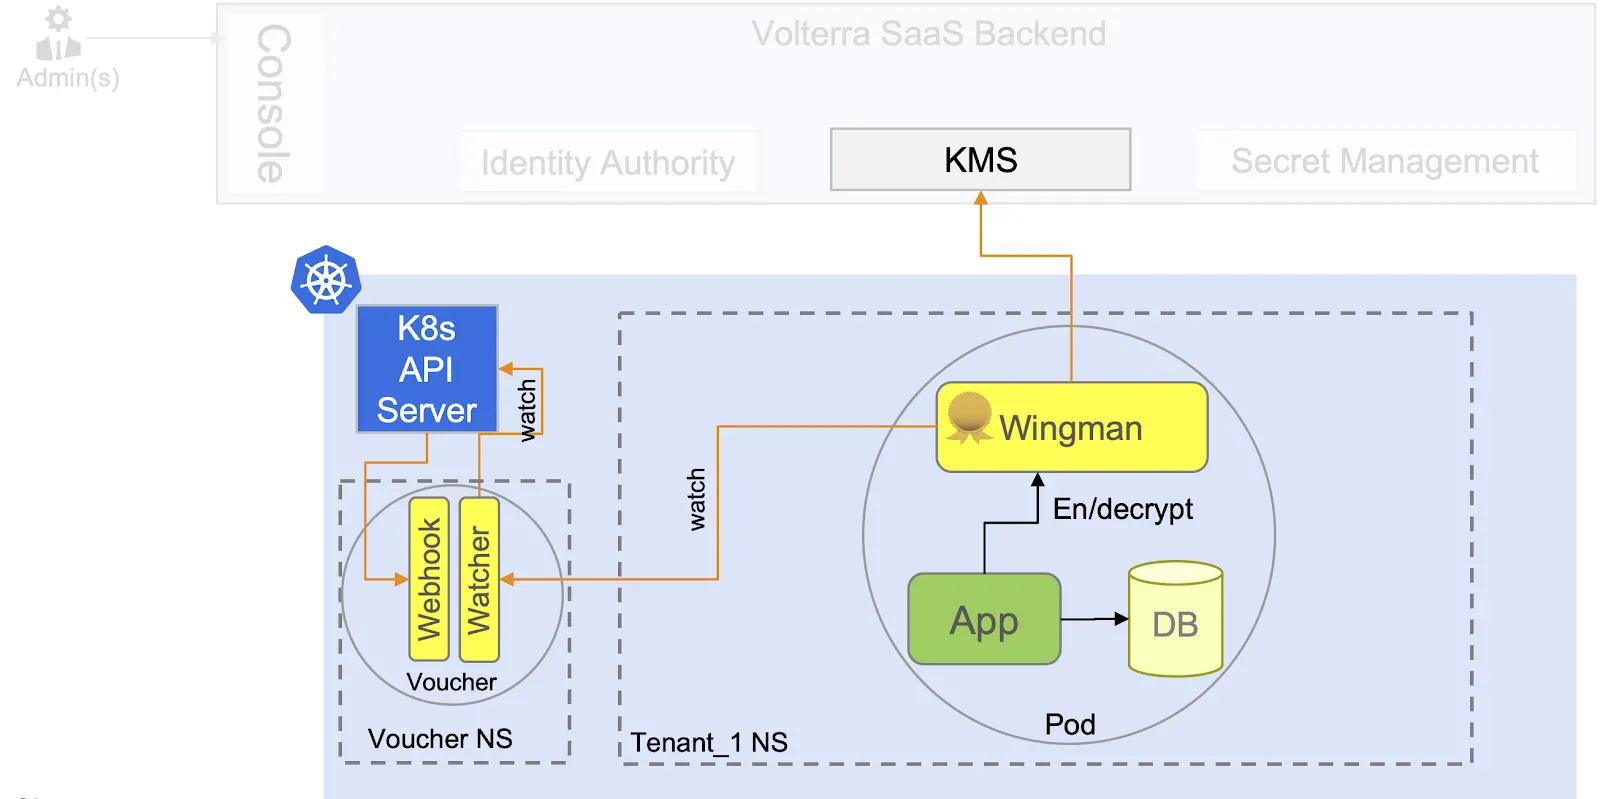
Dado que todas las claves se gestionan a través del backend SaaS de Volterra, las cargas de trabajo que se ejecutan en entornos heterogéneos no tienen que ocuparse de la sincronización, la rotación o la revocación de claves, entre otras tareas; solo necesitan conocer las sencillas API de Wingman para cubrir todas sus necesidades de seguridad de los datos en reposo.
Beneficios que ofrece nuestra solución de seguridad de plataformas
Gracias a la seguridad multicapa de la plataforma, hemos podido ofrecer una solución integral para tres problemas críticos de una forma totalmente novedosa. Nuestro sistema puede inicializar de forma segura una identidad universal que no se ve afectada por el problema de «tortugas hasta el infinito», gestionar secretos que pueden almacenarse y distribuirse sin tener que preocuparse en ningún momento por el problema de la mina de oro, y proporcionar una gestión de claves que facilite la protección de los datos en reposo en un entorno distribuido. Esto ha aportado las siguientes ventajas tanto a nuestros equipos internos como a nuestros clientes:
- Seguridad y cumplimiento normativo — identidad universal e infalsificable, Blindfold y un sidecar de seguridad (Wingman) totalmente integrado y gestionado automáticamente por la plataforma para proteger todas las comunicaciones, autorizar cada acceso y gestionar claves y secretos en un sistema distribuido. Gracias a estos avances, podemos ofrecer una solución de seguridad más sólida que nos facilita, tanto a nosotros como a nuestros clientes, el cumplimiento de la normativa.
- Mejoras de la productividad — al utilizar una solución de seguridad integrada en nuestro proceso de DevOps y marco de servicios, los desarrolladores y los equipos de DevOps pueden centrarse fácilmente en sus entregables sin preocuparse por aspectos clave de la seguridad de las aplicaciones y los datos.
- Evolución continua — la evolución del panorama de la seguridad y las nuevas tecnologías impulsan la evolución continua de Blindfold, Wingman y nuestro framework de servicios de Golang. Como resultado, la plataforma implementa automáticamente nuevas funcionalidades sin necesidad de modificar la lógica de las aplicaciones.
Continuará…
Esta serie de artículos abordará diversos aspectos de lo que supuso crear y operar nuestro servicio SaaS distribuido globalmente, con numerosos clústeres de aplicaciones en la nube pública, nuestros PoP de red privada y sitios perimetrales. El próximo tema será Seguridad de aplicaciones y redes…
Buscamos algunos desarrolladores y arquitectos de soluciones voluntarios que nos ayuden a poner esta funcionalidad a disposición de una comunidad más amplia como proyecto de código abierto. Si te interesa formar parte de algo divertido, ponte en contacto directamente con asingla@volterra.io.
Sobre el autor
Artículos relacionados del blog

Cree servicios públicos seguros, resilientes y preparados para la IA con F5 y AWS
Descubre cómo las organizaciones del sector público pueden modernizar de forma segura sus aplicaciones y soluciones de IA, al tiempo que gestionan los sistemas heredados, el cumplimiento normativo y el riesgo operativo.

Protección de los sistemas de IA: por qué la seguridad debe avanzar al ritmo de la innovación
Desde acelerar avances revolucionarios en medicina y educación hasta transformar la vida cotidiana, la IA está cambiando nuestra forma de vivir y trabajar. Pero también ofrece grandes oportunidades a los ciberdelincuentes.
Avanzar hacia la optimización digital tras la transformación
Descubre estrategias de optimización digital para garantizar políticas de seguridad coherentes, impulsar la madurez de la transformación digital y superar los retos de la transformación.
Proyecto de código abierto destacado: mayor observabilidad con F5 Cloud Logger iApp
En el punto de mira del código abierto: cómo aumentar la observabilidad. Lee el blog de F5 para descubrir cómo exportar fácilmente la telemetría de BIG-IP a plataformas modernas de análisis en la nube.
El estado de la entrega de aplicaciones en 2018: la transformación digital impulsa la automatización y la multinube pese a las preocupaciones de seguridad
Descubre las principales conclusiones del cuarto informe anual de F5 sobre el estado de la entrega de aplicaciones.
Estado de la entrega de aplicaciones en 2017: automatización, API y DevOps
Descubre el informe sobre el estado de la entrega de aplicaciones de 2017. Lee el blog retrospectivo de F5 sobre los inicios del auge de las redes declarativas y los flujos de DevOps.