
La confianza cero es un tema popular en los círculos de la ciberseguridad hoy en día, pero todavía me miran con extrañeza cada vez que planteo el concepto de presuponer una brecha como una parte fundamental de la mentalidad de confianza cero. Supongo que esta reacción se debe a una de dos posibles inquietudes. En primer lugar, algunos profesionales de la seguridad pueden interpretarlo como una visión terriblemente pesimista del mundo; para ellos, «presuponer una brecha» viene a significar algo así como: «Entonces, lo que dices es que estamos todos condenados. Pues bien, rindámonos y dejemos siquiera de intentarlo.» Otros, quizá los más orgullosos, pueden adoptar una actitud del tipo: «Bueno, puede que tus sistemas sufran una brecha, pero mi seguridad es inexpugnable y no hay forma de que los malos logren atravesar mis defensas».
Mi intención no es defender ninguno de estos extremos, sino hacer hincapié en que debemos interiorizar la realidad de operar en un mundo digital: las brechas de seguridad se producirán y, por tanto, pueden y deben tenerse en cuenta al diseñar cualquier sistema de seguridad. No se trata de un concepto novedoso, y deberíamos inspirarnos en la sabiduría adquirida por generaciones de artesanos y profesionales de distintos oficios que lo han adoptado.
Los fontaneros, electricistas y otros profesionales que trabajan en el mundo físico llevan mucho tiempo teniendo interiorizada la verdadera esencia del principio «dar por sentada una brecha de seguridad». Dado que su labor consiste en crear soluciones que deben ser resistentes en entornos tangibles, aceptan e incorporan implícitamente el simple hecho de que se producen fallos en el ámbito de su trabajo. También entienden que los fallos no ponen en entredicho sus capacidades ni son motivo para prescindir de sus servicios. Al contrario, solo los profesionales más cualificados, conscientes de que sus creaciones acabarán fallando, incorporan lo aprendido de fallos anteriores y son capaces de anticipar posibles fallos futuros.
Hace poco tuve que lidiar con uno de esos fallos: una tubería de aguas residuales de mi casa se atascó en un tramo intermedio del desagüe. La casa tiene más de 30 años, por lo que un fallo —una brecha— no debería sorprendernos. Al fin y al cabo, la probabilidad de que se produzca una brecha en cualquier sistema durante un periodo prolongado se aproxima al 100 %.
Esa es la cuestión. Prever que, con el tiempo, se producirá un fallo es tan válido para una solución de seguridad de aplicaciones como para el sistema de fontanería de mi casa. Además, asumir que «mi sistema de fontanería nunca fallará» no es más adecuado como estrategia de mantenimiento doméstico que pensar que «mis defensas cibernéticas nunca sufrirán una brecha de seguridad».
Por lo tanto, tanto el fontanero como el profesional de la ciberseguridad deben adoptar una mentalidad que contemple cómo afrontar el fallo —es decir, la brecha de seguridad— que tarde o temprano se producirá.
Tres componentes estratégicos clave del enfoque «Assume Breach»
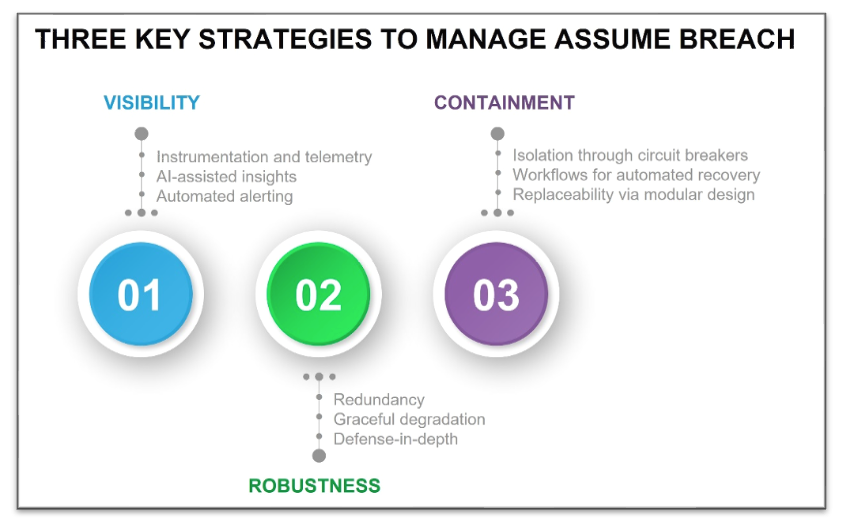
Una estrategia eficaz para hacer frente a fallos en los sistemas, ya sean físicos o cibernéticos, suele constar de tres componentes.
- Visibilidad. Garantice una visibilidad suficiente para poder detectar cualquier fallo lo antes posible. Una fuga en el desagüe de un cuarto de baño que no se repare provocará podredumbre y la aparición de hongos o moho en el subsuelo, algo que puede tardar meses o años en advertirse. También podría detectarse agua goteando del techo de la estancia situada debajo de un cuarto de baño de la segunda planta después de que se haya desbordado una bandeja de recogida de agua bajo el suelo y se haya empapado la placa de yeso. En cualquiera de estos casos, el problema se detecta cierto tiempo después del fallo inicial y después de que se hayan producido daños secundarios adicionales. El primer principio de asumir que se producirá un fallo o una brecha debe ser proporcionar indicios claros de una posible vulneración lo antes posible tras el fallo e, idealmente, incluso emitir notificaciones proactivas sobre posibles fallos. Por ejemplo, los sótanos que dependen de bombas de achique para evacuar el agua suelen disponer de sensores que activan una alarma cuando el nivel del agua supera un umbral preestablecido. En otras situaciones, cuando no es viable emitir alertas proactivas para todos los posibles modos de fallo, se realizan comprobaciones periódicas de mantenimiento; por ejemplo, se inspeccionan los calentadores de agua cada seis meses. En ciberseguridad, esto significa que la arquitectura de seguridad de la aplicación debe incluir una estrategia de telemetría bien estudiada y probada que tenga en cuenta los modos de fallo más importantes y proporcione visibilidad oportuna sobre cualquier posible brecha. En la práctica, la telemetría debe transmitirse a herramientas de análisis y notificación mediante prácticas de AISecOps y, al mismo tiempo, almacenarse de forma persistente en repositorios de datos para su uso posterior. Deben utilizarse herramientas de IA y de alertas para mejorar la eficacia, proporcionar contexto a las personas y garantizar una respuesta oportuna. Los datos almacenados deben utilizarse para aprender y contribuir a reforzar aún más la solidez del sistema en el futuro.
- Robustez. Las soluciones deben incluir mecanismos para sortear un fallo o reducir su duración. Los patrones habituales para lograr robustez en este contexto son (a) la degradación gradual o (b) la redundancia; la elección dependerá de si es viable seguir funcionando con un componente degradado. Algunos sistemas, como los calentadores de agua, pueden combinar ambos patrones. Por ejemplo, mi calentador de agua utiliza un sistema de recirculación alimentado por una bomba para que siempre haya agua caliente lista para usar. Sin embargo, si la bomba falla, seguiré teniendo agua caliente, aunque tendré que esperar un poco más. Por otro lado, el fallo de un sensor de la resistencia —cuando el elemento calefactor no se apaga— puede provocar un fallo catastrófico, por lo que se recurre a la redundancia mediante una válvula de alivio de presión. La robustez debe considerarse en distintos ámbitos del sistema. Por ejemplo, si se limita al conducto de desagüe, un fontanero que trabaje en una solución de uso comercial podría instalar dos conductos de evacuación redundantes, de modo que el fallo de cualquiera de ellos no inutilizara el desagüe. En cambio, un arquitecto que trabaje en el nivel de abstracción del sistema podría diseñar la redundancia a ese nivel, por ejemplo, añadiendo cerca un segundo lavabo o inodoro, lo que además permitiría afrontar más tipos de fallo que una simple obstrucción de los conductos de desagüe. Sin duda, la redundancia es una práctica habitual en ciberseguridad, ya que muchos dispositivos de seguridad se implementan en modo activo/en espera (redundancia total) o activo/activo (degradación gradual). Sin embargo, el mundo de la ciberseguridad difiere en cierta medida del mundo físico. En primer lugar, el hecho de que en el ámbito de la ciberseguridad haya atacantes activos, con intención e inteligencia, implica que los fallos rara vez se deben a causas naturales. Una segunda diferencia, aún más importante, es la escala. Como el software es virtual y no físico, sigue el paradigma «escribir una vez, desplegar muchas». Aunque esta propiedad resulta excelente para escalar, también implica que una vulnerabilidad en el código de un componente de software esencial probablemente afectará a todas las instancias de ese código en el sistema. Por tanto, la solución de ciberseguridad para lograr robustez también se basa en evitar puntos únicos de fallo —así como clases enteras de elementos que puedan constituirlos—, una estrategia que a veces se denomina «defensa en profundidad». La autenticación multifactor es un excelente ejemplo práctico de esta idea. El modo de fallo (el medio para vulnerarlo) de cada factor es distinto, y vulnerar uno solo de ellos no comprometerá el sistema en su conjunto.
- Contención. Es fundamental limitar el impacto —el radio de acción— de un fallo. Del mismo modo que aceptamos que se producirán fallos o brechas de seguridad, también debemos aceptar que no podremos evitar por completo los puntos únicos de fallo ni incorporar redundancia para cada requisito funcional. Por consiguiente, el arquitecto también debe plantearse cómo minimizar el impacto de un fallo, utilizando tanto el esfuerzo como las consecuencias como dos importantes criterios de calidad. Por ejemplo, un fontanero puede añadir bocas de limpieza en puntos estratégicos de las tuberías de desagüe para reducir el tiempo necesario para solucionar el problema. Ante fallos más catastróficos, un contratista podría optar por tuberías de desagüe de PVC en lugar de galvanizadas para facilitar la reparación de una fuga y reducir así el esfuerzo necesario. Una práctica habitual en la fontanería doméstica consiste en instalar válvulas de corte para limitar las consecuencias de un fallo (detectado), evitando así daños secundarios en muebles de baño y suelos. En el ámbito de la ciberseguridad, los conceptos análogos son aislamiento, mantenibilidad y modularidad. El aislamiento consiste en minimizar los daños colaterales o detener la propagación del daño; una buena práctica es disponer de una infraestructura que pueda actuar como cortacircuitos mediante tecnologías como la microsegmentación. La mantenibilidad consiste en posibilitar, siempre que sea posible, una transición rápida y con poco esfuerzo desde un estado comprometido a otro no comprometido; por ejemplo, reiniciar una carga de trabajo comprometida por ataques de desbordamiento de memoria podría ser un método de mitigación eficaz (aunque incompleto). La modularidad es la práctica de construir sistemas que permitan intercambiar fácilmente componentes funcionales equivalentes, de modo que, cuando el mantenimiento no sea posible o suficiente, se minimice el esfuerzo necesario para solucionar el problema.
Estas son algunas de las mejores prácticas que he aprendido para hacer frente a las brechas de seguridad, aunque desde luego no pretendo afirmar que no haya otras. Lo más importante es que los desarrolladores y los profesionales de la seguridad encargados de proteger las aplicaciones comprendan que habrá vulnerabilidades que pasarán desapercibidas y que, inevitablemente, se producirán brechas. Desde esta perspectiva, la forma en que nos preparamos para esos fallos y los afrontamos es igual de importante y merece tanta reflexión como las medidas que adoptamos para reducir su frecuencia.
En última instancia, se nos juzgará no solo por la frecuencia con la que se produzcan brechas de seguridad, sino también por lo bien que reaccionemos ante ellas cuando, inevitablemente, se produzcan.
Sobre el autor
Artículos relacionados del blog

Proteger los endpoints de las API dificulta la seguridad de las API
Descubre las complejidades de la seguridad de las API, los retos a los que se enfrentan las organizaciones, la evolución de los ataques contra endpoints de API y la necesidad de políticas de seguridad adaptadas.
¿Qué es el sesgo de la IA y por qué es importante para TI?
Descubre los fundamentos del aprendizaje de la IA. Aprende cómo pueden surgir sesgos en la IA y qué riesgos plantean para las TI y la transformación digital.
Redefiniendo la ciberseguridad en el extremo de la nube distribuida con IA y telemetría en tiempo real
La transformación digital y la adopción de tecnologías en la nube están provocando cambios en las arquitecturas de las aplicaciones. Estos cambios introducen nuevas superficies de ataque, que son el objetivo de métodos de ataque avanzados, altamente organizados y con motivaciones económicas. Mediante el uso del framework Morpheus de NVIDIA, F5 está investigando técnicas para detectar estas amenazas avanzadas con telemetría en tiempo real y análisis basados en IA.
El papel de la nube en las aplicaciones nativas del edge
No debería sorprender que, al igual que la aparición de la nube dio lugar a las aplicaciones nativas de la nube, el edge esté impulsando un conjunto de aplicaciones nativas del edge. Sin embargo, estas aplicaciones no residirán únicamente en el edge. Al mismo tiempo, están surgiendo nuevos patrones arquitectónicos que aprovechan las aplicaciones alojadas en la nube y en el centro de datos.
La creciente diversidad de ubicaciones y usuarios está impulsando a las empresas hacia el edge
En el contexto del ámbito de las aplicaciones, el término «usuario» siempre se ha referido a la entidad que interactúa con una aplicación. Del mismo modo que los cambios en las arquitecturas de las aplicaciones impulsan cambios en las tecnologías que permiten ofrecerlas y protegerlas, los cambios en la definición de usuario han provocado cambios en los lugares donde se despliegan las aplicaciones.
El edge está impulsando un renacimiento de las infraestructuras
A medida que las organizaciones aumentan la generación de datos y tratan de extraer valor empresarial de ellos, sin duda recurrirán a la analítica y la automatización basadas en la IA y el aprendizaje automático. Precisamente este tipo de cargas de trabajo son las que más se beneficiarían de una infraestructura optimizada y, sin embargo, hoy en día son las que menos probabilidades tienen de poder aprovecharla.