Se habla de inteligencia artificial generativa (GenAI) por todas partes. La cuestión es: ¿qué está calando? ¿Cómo está contribuyendo a mejorar el mundo? ¿Dónde reside el valor empresarial? Estas preguntas son igualmente pertinentes si se tienen en cuenta los retos a los que se enfrentan las organizaciones que están determinando si deben incorporar la GenAI a sus operaciones (AIOps) y cuándo hacerlo. Basándome en los experimentos que he realizado con la inteligencia artificial generativa durante el último año y en mi amplio conocimiento de las tendencias del sector, adquirido a través de mi labor diaria de investigación en F5, presento las siguientes cinco conclusiones para orientar a las organizaciones que desean comprender el impacto de la GenAI en las prácticas de gestión de datos operativos. De este modo, estarán mejor preparadas para adaptar los plazos de adopción de la tecnología GenAI a sus presupuestos, prácticas y culturas actuales.
1. A los modelos de IA generativa les encantan los datos semiestructurados y no estructurados
Los datos operativos son una amalgama de datos semiestructurados (objetos) y conjuntos de datos no estructurados. Los modelos de lenguaje de gran tamaño (LLM) son bastante flexibles y eficaces con esta variedad de formatos de datos. Esto convierte a los LLM en una tecnología perfecta para analizar conjuntos de datos operativos. Las organizaciones pueden llevar a cabo internamente diversos experimentos y evaluaciones para comprobar la eficacia, la facilidad de uso y el coste de distintas soluciones basadas en IA generativa. El uso de la inferencia de los LLM para detectar patrones de datos interesantes con menos falsos positivos permite adaptar la velocidad y la escala de las máquinas a los objetivos de los equipos que consumen flujos de datos operativos.
2. Las organizaciones no necesitan crear modelos
Las organizaciones que se centran en conocer qué técnicas utiliza cada modelo para las tareas específicas que deben realizar no necesitan crear sus propios modelos. Por ejemplo, el reconocimiento de entidades nombradas (NER) es una rama del procesamiento del lenguaje natural (NLP) que está demostrando ser una técnica eficaz para identificar elementos clave en datos semiestructurados. Un ejemplo de NER podría ser una lista que incluya una categoría, como los días de la semana, o una descripción, como los números enteros mayores que 1 y menores que 5. El resultado es una mayor precisión durante la inferencia que con las técnicas de coincidencia de patrones basadas en reglas que no utilizan IA generativa. A medida que avanzan la investigación y la aplicación de técnicas como el NER, los equipos de operaciones pueden centrar su atención en aprovechar las técnicas que han demostrado ser eficaces, en lugar de crear modelos.
Ejemplo de NER:
Entidad nombrada: Días de la semana
Lista: domingo, lunes, martes, miércoles, jueves, viernes, sábado
Figura 1. El reconocimiento de entidades con nombre ofrece una mayor precisión durante la inferencia que la coincidencia de patrones basada en reglas.
3. La gravedad de los datos es real
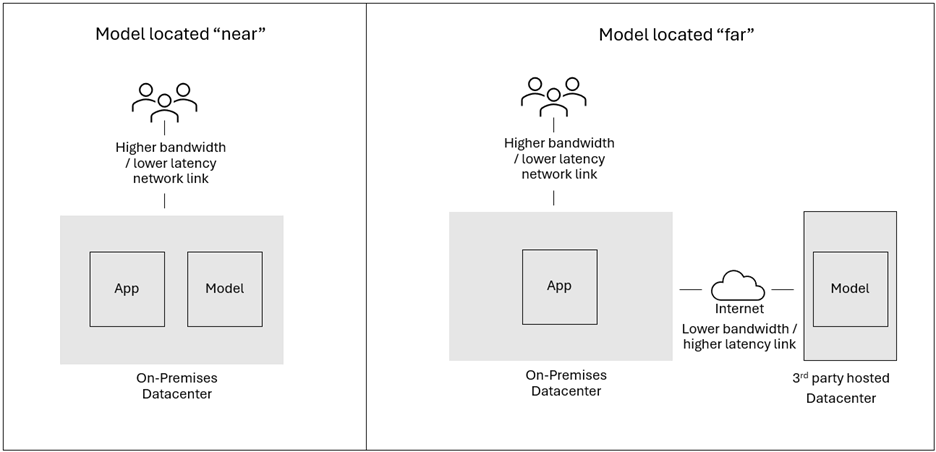
La gravedad de los datos es una fuerza subyacente que influye en la decisión de situar los recursos informáticos más cerca de donde se generan los datos o trasladar los datos más cerca de donde ya están desplegados dichos recursos. Cuanto mayor es el volumen de datos, más intensa es la fuerza gravitatoria, lo que hace que se ubique una mayor capacidad informática cerca de ellos. Para el entrenamiento (la creación y el ajuste de modelos), los datos se agregan y se trasladan más cerca de los recursos informáticos. Para la inferencia (el uso de modelos), el modelo se traslada más cerca de donde se envía la instrucción.
Si se accede a un modelo alojando una copia en las propias instalaciones —en lugar de llamar a la API de una instancia alojada por un tercero—, tiene sentido acercar el modelo al prompt o a cualquier conjunto de datos privados adicional vectorizado como parte de este. Por otro lado, si el modelo está alojado por un tercero que ofrece su API a través de Internet, ni el modelo ni las operaciones de inferencia se desplazan. En estos casos, la inferencia y los vectores de datos privados pueden trasladarse a una ubicación «cercana en la red» mediante una interconexión de coubicación en un centro de datos o intentando, si es posible, que las ubicaciones de alojamiento coincidan con las del proveedor del modelo.
Comprender las fuerzas que acercan los datos y la computación, así como aquellas que los separan, ayuda a tomar decisiones fundamentadas para encontrar el equilibrio adecuado entre coste y rendimiento.
4. No ignores los silos de datos: abórdalos
Con el procesamiento mediante IA generativa, es más importante que nunca eliminar los silos de datos para simplificar y agilizar el análisis de los datos operativos. Sin embargo, en un futuro próximo, parece que los silos de datos seguirán existiendo e incluso podrían proliferar.
La cuestión radica más bien en cómo abordar los silos de datos y qué opciones tecnológicas elegir. Para acceder a datos almacenados en varias ubicaciones, se puede optar por copiarlos y trasladarlos o por implementar una capa lógica de datos que utilice consultas federadas sin moverlos. Independientemente de la opción elegida, identificar las fuentes de datos en streaming existentes y evaluar los casos de uso operativos en función de sus requisitos de tiempo y actualización de los datos ayudará a seleccionar los elementos necesarios de la pila tecnológica de datos, como motores de streaming, motores de consulta, formatos de datos y catálogos. La posibilidad de elegir la tecnología permite a los equipos de datos seleccionar las soluciones más eficaces y fáciles de usar, manteniendo al mismo tiempo un equilibrio entre rendimiento y coste. Lo ideal es que las prácticas de datos de una organización maduren con el tiempo, sin dejar de ofrecerle la flexibilidad necesaria para elegir lo que mejor se adapte a sus necesidades en cada etapa de madurez.
5. La automatización es tu aliada: no la temas
Cuando las soluciones incorporan automatización, pueden escalar al convertir el conocimiento tácito de los expertos en privacidad de datos y SecOps en una práctica repetible basada en AIOps que las máquinas pueden ejecutar. Solo entonces los equipos de datos, seguridad y privacidad quedan libres para aportar inteligencia. La inteligencia mejora la eficacia de las políticas al definir con mayor precisión quién puede utilizar determinados datos, durante cuánto tiempo y con qué finalidad, a la vez que se controla dónde se encuentran, qué copias se realizan y con quién se comparten. Esto permite dedicar más tiempo a la planificación estratégica, la evaluación de nuevas tecnologías y la comunicación con las áreas de negocio para perfeccionar las políticas de acceso a los datos y aprobar excepciones.
La velocidad, la escalabilidad y la automatización son características de una práctica de AIOps madura, que permite obtener mejores resultados, tomar decisiones más rápidas y optimizar el capital humano. La IA generativa está abriendo puertas que la tecnología no había podido abrir… hasta ahora. Los cinco aprendizajes anteriores ofrecen algunas pautas que los equipos de operaciones de TI, operaciones de seguridad y operaciones de privacidad pueden tener en cuenta al incorporar la IA generativa a sus prácticas de AIOps. Los modelos de IA, la proximidad de la capacidad de computación a los datos operativos, los datos y la automatización constituyen elementos clave de la nueva plataforma de AIOps. En este enriquecedor entorno de aprendizaje, las organizaciones pueden desarrollar la cultura y las prácticas de las operaciones tecnológicas para la generación actual y las venideras.
Para profundizar en el impacto de la IA generativa en los datos, consulte el último informe «Índice de madurez de la empresa digital» de F5.
Sobre el autor
Artículos relacionados del blog

Proteger los endpoints de las API dificulta la seguridad de las API
Descubre las complejidades de la seguridad de las API, los retos a los que se enfrentan las organizaciones, la evolución de los ataques contra endpoints de API y la necesidad de políticas de seguridad adaptadas.
¿Qué es el sesgo de la IA y por qué es importante para TI?
Descubre los fundamentos del aprendizaje de la IA. Aprende cómo pueden surgir sesgos en la IA y qué riesgos plantean para las TI y la transformación digital.
Redefiniendo la ciberseguridad en el extremo de la nube distribuida con IA y telemetría en tiempo real
La transformación digital y la adopción de tecnologías en la nube están provocando cambios en las arquitecturas de las aplicaciones. Estos cambios introducen nuevas superficies de ataque, que son el objetivo de métodos de ataque avanzados, altamente organizados y con motivaciones económicas. Mediante el uso del framework Morpheus de NVIDIA, F5 está investigando técnicas para detectar estas amenazas avanzadas con telemetría en tiempo real y análisis basados en IA.
El papel de la nube en las aplicaciones nativas del edge
No debería sorprender que, al igual que la aparición de la nube dio lugar a las aplicaciones nativas de la nube, el edge esté impulsando un conjunto de aplicaciones nativas del edge. Sin embargo, estas aplicaciones no residirán únicamente en el edge. Al mismo tiempo, están surgiendo nuevos patrones arquitectónicos que aprovechan las aplicaciones alojadas en la nube y en el centro de datos.
La creciente diversidad de ubicaciones y usuarios está impulsando a las empresas hacia el edge
En el contexto del ámbito de las aplicaciones, el término «usuario» siempre se ha referido a la entidad que interactúa con una aplicación. Del mismo modo que los cambios en las arquitecturas de las aplicaciones impulsan cambios en las tecnologías que permiten ofrecerlas y protegerlas, los cambios en la definición de usuario han provocado cambios en los lugares donde se despliegan las aplicaciones.
El edge está impulsando un renacimiento de las infraestructuras
A medida que las organizaciones aumentan la generación de datos y tratan de extraer valor empresarial de ellos, sin duda recurrirán a la analítica y la automatización basadas en la IA y el aprendizaje automático. Precisamente este tipo de cargas de trabajo son las que más se beneficiarían de una infraestructura optimizada y, sin embargo, hoy en día son las que menos probabilidades tienen de poder aprovecharla.