À mesure que les agents d’IA évoluent de copilotes vers des acteurs autonomes, le secteur converge vers une abstraction commune : les compétences d’agent.
Les compétences d’agent formalisent ce qu’un agent sait faire. Elles regroupent les instructions, les comportements attendus et l’utilisation déclarée des outils dans des artefacts portables qui peuvent être partagés, versionnés et réutilisés par différents agents et sur différentes plateformes. Sur le plan conceptuel, elles jouent le même rôle que les plugins pour les environnements de développement intégrés ou les extensions pour les navigateurs.
Ce qui donne un véritable poids à ce modèle, c’est qu’il n’est plus expérimental ni propriétaire. Anthropic a publié une norme ouverte pour les compétences d’agents, faisant ainsi des compétences une couche portable et interopérable plutôt qu’un concept propre à un framework. Tout comme MCP a standardisé la manière dont les agents communiquent avec les outils, les compétences d’agents standardisent la manière dont les agents acquièrent des capacités.
C’est important. Les standards ouverts exercent une force d’attraction. Ils fédèrent des écosystèmes, des outils et des registres, avant de finir par être adoptés par les entreprises. Lorsque les fournisseurs s’accordent sur une abstraction commune, celle-ci cesse d’être une curiosité pour devenir une infrastructure. Le lancement en décembre 2025 comprenait des skills partenaires proposés par divers fournisseurs (Atlassian, Figma, Canva, Stripe, Notion et Zapier), ce qui montre que le standard bénéficie déjà d’une réelle dynamique.
Ce qui signifie que les implications en matière de sécurité ne sont plus hypothétiques.
Pourquoi les compétences des agents changent le modèle de sécurité
Les compétences des agents sont volontairement légères. Elles sont conçues pour être lisibles par les humains, faciles à créer et simples à distribuer. La plupart des implémentations s’appuient sur Markdown pour définir le comportement et sur YAML pour les métadonnées, car l’objectif est de permettre un partage fluide.
Du point de vue de la productivité des développeurs, c’est un avantage.
Du point de vue de la sécurité, cela crée un schéma bien connu, mais dangereux : une intention exécutable transmise sous forme de contenu.
Les compétences sont chargées au moment de l’exécution. Elles interviennent dans la boucle de raisonnement de l’agent. Elles peuvent influencer la planification, le choix des outils et l’ordre d’exécution. Elles sont souvent récupérées dynamiquement et combinées de manière transitive. En d’autres termes, elles s’apparentent moins à des fichiers de configuration qu’à des composants de la chaîne d’approvisionnement logicielle.
Point essentiel : les compétences n’imposent rien. Elles déclarent ce qu’un agent souhaiterait faire. Elles ne limitent pas ce que l’agent peut réellement faire.
Cette distinction est fondamentale.
Une fois qu’une compétence est activée, les contrôles traditionnels de type « shift left » sur lesquels s’appuient les développeurs perdent en grande partie leur pertinence. Il n’existe aucune demande de fusion pour le plan interne d’un agent. Aucun humain ne vérifie le code avant le déclenchement d’un appel d’outil. Il n’y a aucune pause entre le raisonnement et l’exécution.
Pour les agents, le développement s’effectue au moment de l’exécution.
Le déficit de contrôle que les compétences ne comblent pas
Il est tentant de considérer les compétences des agents comme une surface de sécurité. Après tout, elles répertorient les outils requis et le comportement attendu. Cela semble être l’endroit idéal pour mettre en place des garde-fous.
Mais les compétences se situent au mauvais niveau de la pile.
Elles se trouvent à l’intérieur de l’agent. Elles sont interprétées par le même modèle qui cherche à optimiser l’accomplissement des tâches et la progression. Demander à une compétence de faire respecter la sécurité revient à demander à l’agent de se brider lui-même. Cela n’a jamais fonctionné de manière fiable et ne fonctionnera jamais.
Plus important encore, les compétences n’ont aucune autorité. Elles ne peuvent ni révoquer des accès, ni limiter l’exécution, ni examiner les effets secondaires, ni empêcher l’exfiltration de données. Au mieux, elles fournissent des indications. Au pire, elles donnent une fausse impression de contrôle.
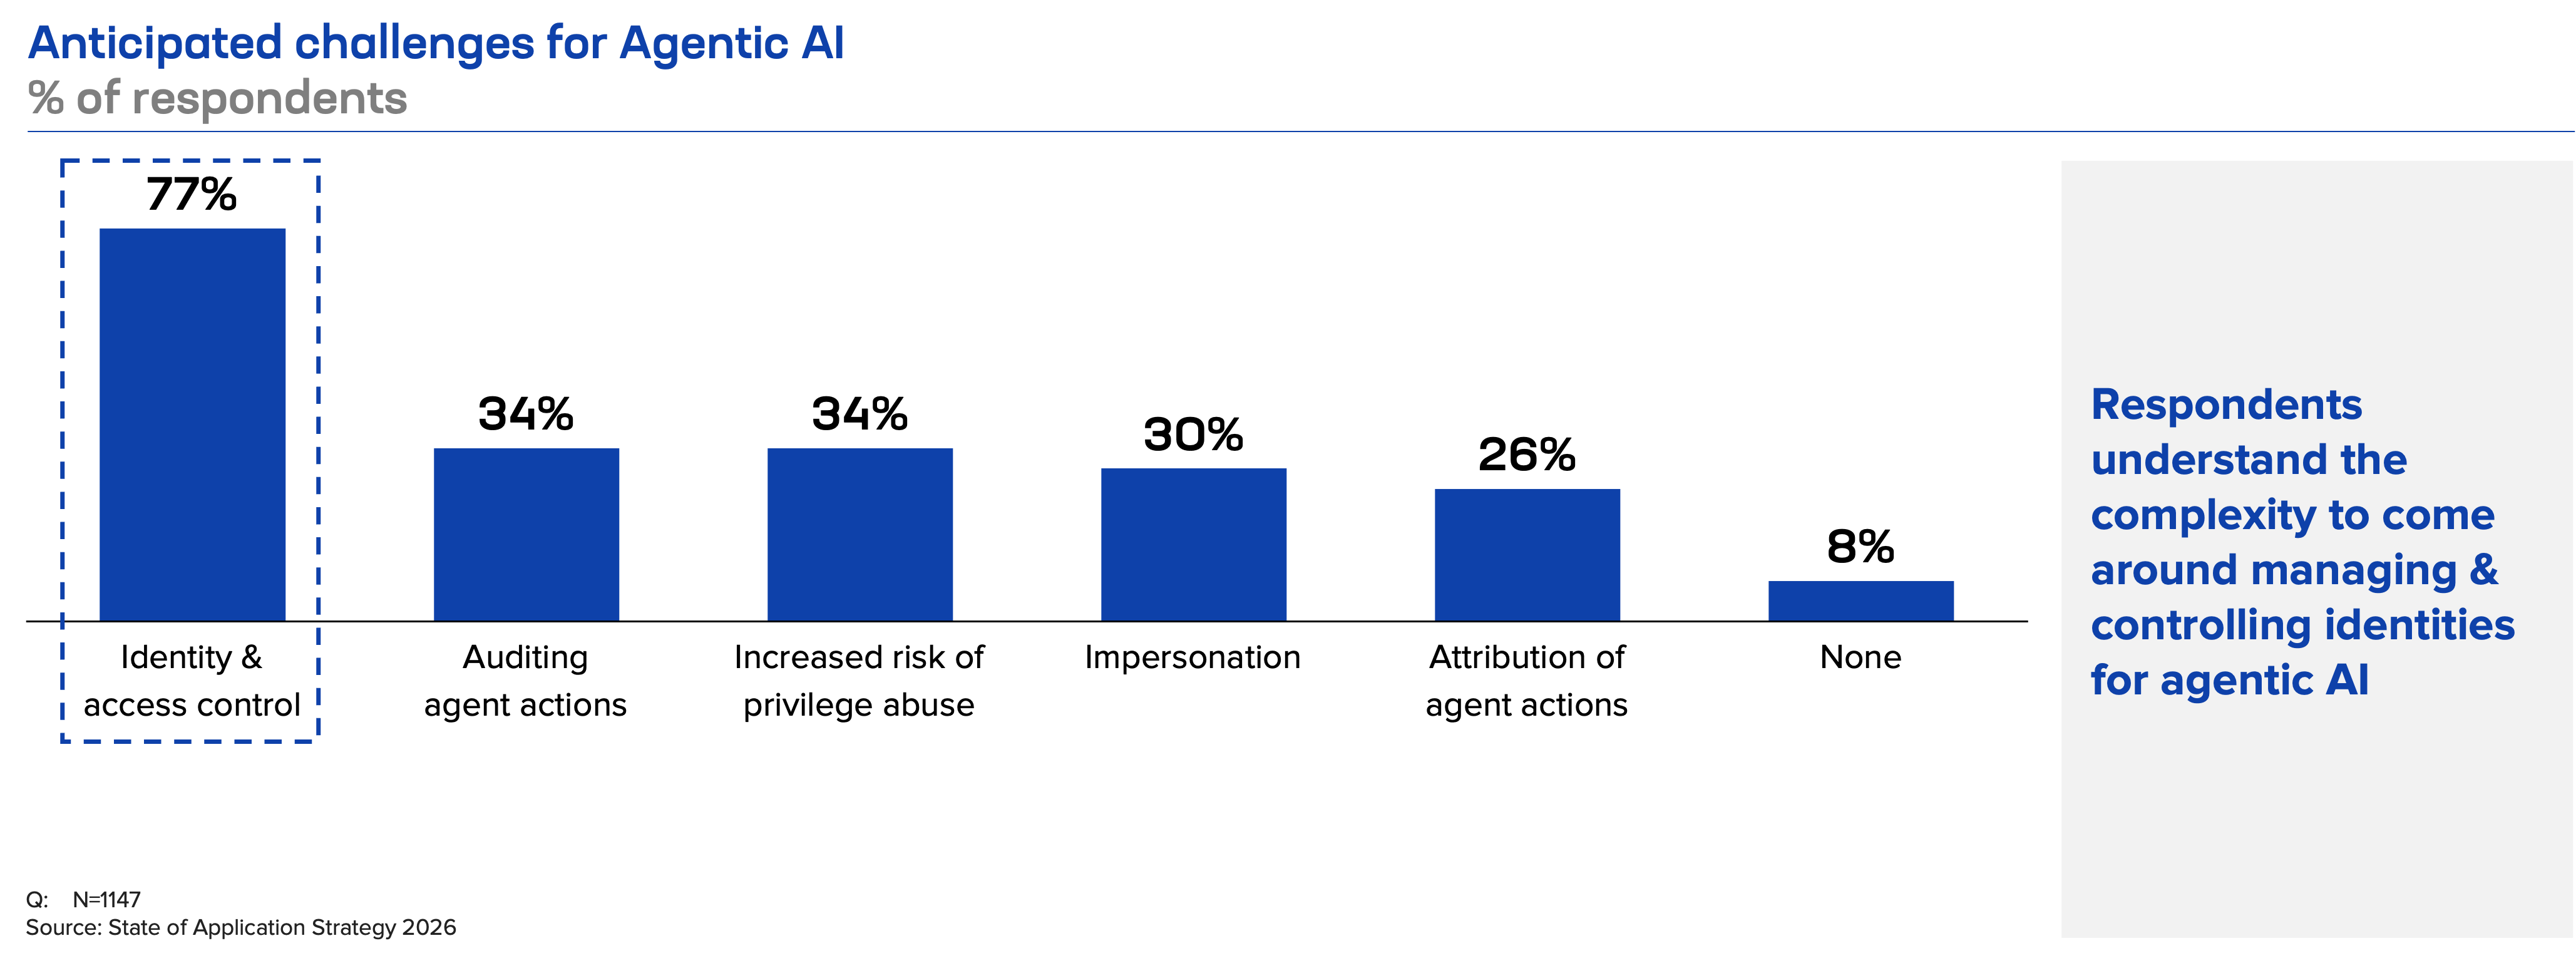
La sécurité ne peut pas se limiter à la description des intentions. Elle doit intervenir au niveau de l’exécution des capacités. En termes plus courants, il s’agit d’appliquer le contrôle des accès et la gestion des identités aux systèmes autonomes. Nos clients considèrent qu’il s’agit d’un défi majeur lié à l’IA agentique.
Pourquoi la couche d’outils est la seule véritable frontière sur laquelle on peut imposer des règles
Les agents ne causent pas de dommages parce qu’ils raisonnent mal. Ils en causent lorsque leur raisonnement se transforme en action au niveau de l’interface avec les outils.
Toute action significative d’un agent, qu’il s’agisse d’appeler une API, d’écrire du code, de déployer une infrastructure, d’interroger une base de données ou d’envoyer des données à un autre système, passe par une interface d’outil. Cette interface est le point de rencontre entre l’autonomie et la réalité. C’est aussi le dernier point qu’un agent ne peut pas contourner si le système est correctement conçu.
C’est pourquoi un « pare-feu d’outils » s’impose comme le meilleur plan de contrôle pour la sécurité des agents.
Un pare-feu d’outils sert d’intermédiaire pour chaque appel d’outil. Il s’interpose entre les agents et les systèmes avec lesquels ils interagissent, afin d’appliquer les règles avant l’exécution plutôt que de procéder à un audit une fois les dégâts causés. Contrairement aux contrôles intégrés aux prompts ou aux métadonnées des compétences, il fonctionne en dehors de la boucle de raisonnement de l’agent et ne dépend donc pas du respect des consignes par le modèle.
C’est la couche où la « sécurité MCP » rencontre les « garde-fous de l’IA ». MCP définit comment les agents communiquent avec les outils. Le pare-feu des outils détermine s’ils sont autorisés à le faire et sous quelles contraintes. Si les outils permettent aux agents d’apprendre de « nouveaux tours », alors le pare-feu des outils est le dispositif qui empêche ces tours de mettre le feu à la maison.
Sur le plan conceptuel, cette idée n’est pas nouvelle. Elle repose sur le même modèle que les passerelles d’API, les maillages de services et les architectures Zero Trust. Ce qui est nouveau, c’est l’acteur situé de l’autre côté de l’interface.
En pratique, un pare-feu d’outils fait office d’intermédiaire. Les agents ne détiennent jamais directement les identifiants d’accès aux systèmes externes. Ils demandent l’exécution d’actions. Le pare-feu détermine si ces actions sont autorisées, dans quelles conditions et avec quelles restrictions.
Un pare-feu d’outils évalue le contexte d’identité (quel agent, quelle compétence, quel environnement), inspecte les paramètres et les charges utiles, applique les politiques sous forme de code et ne délivre que lorsque cela est approprié des identifiants à courte durée de vie assortis des privilèges minimaux. Il observe les résultats, consigne leur provenance et fournit une piste d’audit vérifiable des comportements autonomes.
Cela fait des skills ce qu’ils devraient être : des demandes de capacité et non des délégations d’autorité.
Il reste au marché à déterminer quelle forme prendra le pare-feu d’outils. Mais son intégration à l’arsenal de sécurité des architectures d’agents est inévitable.
À propos de l’auteur

Lori MacVittie est ingénieure émérite et évangéliste en chef au sein du bureau du directeur technique de F5. Elle possède une expertise approfondie dans la fourniture d’applications, les stratégies d’automatisation et les infrastructures. Elle est réputée pour sa capacité à rendre la complexité intelligible, qu’elle définisse des garde-fous pour les agents d’IA, analyse des architectures multicloud fragiles ou explore les limites des systèmes évolutifs. Elle cumule plus de trente ans d’expérience dans le secteur, couvrant le développement d’applications, l’architecture informatique ainsi que l’exploitation des réseaux et des systèmes. Avant de rejoindre F5, elle a été rédactrice spécialisée dans les technologies et a reçu plusieurs distinctions. MacVittie est titulaire d’un master en informatique et est une autrice prolifique dont les publications couvrent la sécurité, le cloud et l’architecture d’entreprise. Elle est également une passionnée de jeux de société et de jeux vidéo, et assume pleinement ses avis bien tranchés sur le fromage.
Autres articles de Lori Mac VittieArticles de blog associés
Les paquets empoisonnés sont en train de tuer notre industrie
L’open source ne dispose pas d’un registre central recensant les paquets malveillants, alors même que l’IA et l’automatisation accélèrent les attaques contre la chaîne d’approvisionnement. L’écosystème a besoin d’un moyen fiable de signaler et de suivre les compromissions.
Top 10 des risques liés à la mise en production d’applications d’IA : manque de sécurité et de conformité réglementaire
L’IA étend la conformité au-delà de la sécurisation des chemins d’accès et des espaces de stockage pour englober la gouvernance du comportement à l’exécution — accès aux modèles, contexte de récupération, résultats et actions des agents —, de sorte que les contrôles doivent être rapprochés de l’inférence.

Top 10 de la livraison d’applications d’IA : politiques de livraison incompatibles
Les divergences de politiques deviennent des sources de pannes pour l’IA : des mécanismes de basculement, des délais d’expiration, des limites et des contrôles de sécurité incohérents entraînent des défaillances silencieuses, des résultats partiels et des résultats différents selon le point de terminaison.

Top 10 de la mise à disposition d’applications d’IA : orientation du trafic non optimisée
L’IA remet en cause les principes traditionnels de répartition du trafic : les backends ne sont pas interchangeables, les coûts varient et les agents multiplient les requêtes de manière imprévisible. Le routage doit donc tenir compte du modèle, de l’état des GPU et de la localisation des données.
Top 10 de la livraison d’applications d’IA : contrôles du trafic insuffisants
Les limites de débit et les mécanismes de régulation traditionnels ne tiennent pas compte de l’étendue réelle des répercussions. Les charges de travail d’IA se répartissent entre les modèles, les bases de données vectorielles et les services, provoquant des pics de latence, des défaillances en cascade et des nouvelles tentatives.
La gestion des fenêtres de contexte en IA n’a rien de magique. C’est une question d’architecture.
Découvrez pourquoi les créateurs d’applications d’IA doivent gérer le contexte, la mémoire et l’infrastructure, tout en faisant évoluer les processus de livraison et la sécurité afin d’éviter la dérive, la latence et les attaques par injection de prompts.