Demandez à un architecte télécom de dessiner un cluster d’IA et il représentera les baies, les GPU, le réseau d’interconnexion, le stockage, tout. Demandez-lui ensuite de montrer comment une requête parvient jusqu’à ce cluster, et son stylo s’arrête. Le trafic arrive, tout simplement. Il se présente à la porte, puis le cluster prend le relais.
Cet angle mort risque bientôt de coûter cher. Dans le cadre de l’inférence distribuée, cette lacune peut se traduire par des GPU inutilisés sur un site et des files d’attente saturées sur un autre. Un fournisseur de services disposant de 50 sites répartis dans tout un pays possède un atout qu’un hyperscaler n’en ayant que deux ne peut pas acheter : la proximité avec les utilisateurs, la diversité des sources d’alimentation électrique, une implantation souveraine et un réseau de fibre optique déjà déployé.
C’est l’argument le plus convaincant en faveur de l’inférence distribuée, qui consiste à exécuter les modèles depuis un réseau de sites plutôt que depuis un site unique. Mais ces 50 sites ne peuvent former un service d’inférence unifié que si un système détermine, pour chaque requête, lequel des 50 doit y répondre. Aujourd’hui, aucun système ne le fait. C’est cette lacune que F5 comble avec NVIDIA, AMD et d’autres fournisseurs d’infrastructures d’IA, afin que la décision s’appuie sur les données de télémétrie issues des accélérateurs et des piles d’inférence réellement déployés par les fournisseurs de services.
Le trafic n’arrive pas comme par magie
Voici ce qui se passe réellement. Une requête DNS sélectionne un site. Un répartiteur de charge global évalue la proximité, l’état de santé et la capacité, puis renvoie une adresse. Au sein du site, un proxy met fin à la connexion, vérifie l’identité du demandeur, applique les règles et un répartiteur de charge sélectionne un serveur. Cette chaîne est appelée routage applicatif. Depuis vingt ans, elle assure discrètement le fonctionnement de tous les services web et mobiles, et F5 en a conçu une grande partie.
La chaîne fonctionne toujours pour l’IA. Seulement, elle prend ses décisions sur la base de critères inadaptés. Le répartiteur global de charge des serveurs (GSLB) sait quel site est le plus proche et lequel est opérationnel. Il ne sait pas sur quel site le modèle est chargé, si les GPU de ce site sont saturés, ni si la requête correspond à une interaction vocale qui ne peut pas traverser le pays ou à une longue tâche agentique qui peut être exécutée là où la capacité est la moins chère. Il choisit donc le site opérationnel le plus proche, qui peut être en surchauffe alors qu’un cluster identique situé à 200 kilomètres de là tourne à moitié vide.
Du routage sensible aux applications au routage sensible à l’IA
Le changement de cap est le suivant : le routage tenant compte des applications doit désormais tenir compte des applications d’IA. Même chaîne, même DNS, mêmes proxys. Deux nouvelles données d’entrée.
La première est la télémétrie provenant de l’infrastructure d’IA. Chaque cluster sait quels modèles il exécute, quelle est la profondeur de ses files d’attente, quelle quantité de cache KV est utilisée, combien de requêtes sont en cours de traitement et combien de temps une nouvelle requête devra attendre avant de recevoir son premier jeton. F5 BIG-IP Next for Kubernetes se trouve déjà en frontal de ces clusters et dispose de toutes ces informations, jusqu’au nombre de jetons par requête. En transmettant ces données au niveau supérieur, les solutions DNS de F5 ne se contentent plus de cartographier l’emplacement des sites, mais offrent une vue en temps réel de ce que chaque site est capable de faire à l’instant présent.
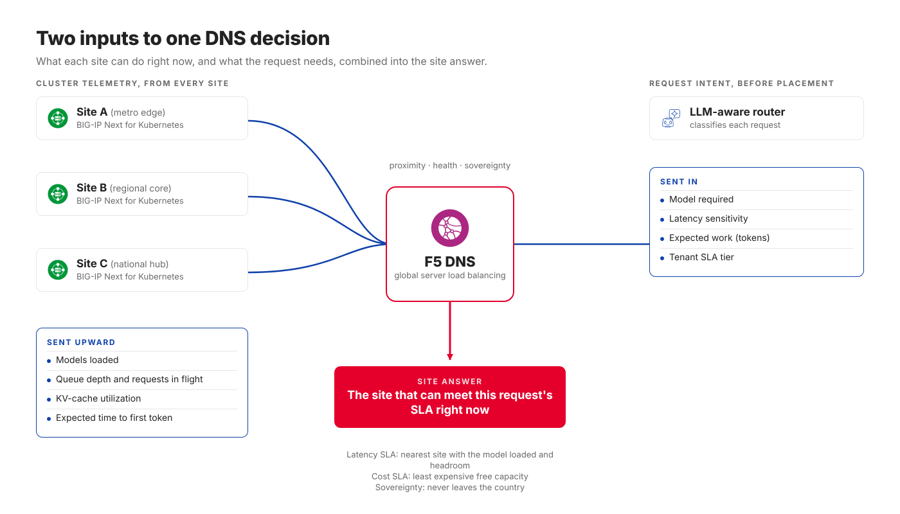
Le deuxième est l’intention de la requête. Un routeur adapté aux LLM peut classifier une requête avant qu’elle ne soit acheminée : le modèle dont elle a besoin, sa sensibilité à la latence, la charge de travail approximative qu’elle représente et le niveau de SLA auquel le locataire a souscrit. Cette intention devient ainsi un paramètre de la réponse DNS, au lieu d’être découverte une fois la requête arrivée au mauvais endroit.
En combinant les deux, un accord de niveau de service (SLA) cesse d’être un simple paragraphe dans un contrat pour devenir une règle de routage. Un SLA de latence achemine la requête vers le site le plus proche où le modèle est chargé et qui dispose d’une marge de capacité suffisante. Un SLA de coût l’achemine vers les ressources disponibles les moins coûteuses. Une exigence de souveraineté garantit que la requête ne quitte jamais le pays. Le GSLB prend la décision qu’il a toujours été capable de prendre, mais désormais avec les informations qui lui faisaient défaut.
Trois niveaux de décision, une seule réponse
Le placement ne relève pas d’une seule décision, mais de trois décisions imbriquées les unes dans les autres.
- À l’échelle mondiale, les solutions DNS de F5 sélectionnent le site ou l’usine d’IA en tenant désormais compte de la télémétrie d’inférence en temps réel et de l’intention de la requête, ainsi que de la proximité, de l’état de santé et de la souveraineté.
- Au niveau régional, la requête est dirigée vers un cluster disposant du modèle approprié et de la capacité nécessaire, puis franchit une frontière de sécurité propre au locataire qui garantit l’isolation avant toute sollicitation d’un GPU.
- Localement, au sein du cluster, BIG-IP Next for Kubernetes applique les politiques d’identité, d’accès et de trafic, tandis qu’Endpoint Picker choisit le nœud de travail.
C’est à ce dernier niveau que le routage cesse d’être un simple chemin vers le GPU pour devenir un facteur de performance de l’inférence. Lorsqu’un moteur traite un prompt, l’étape de préremplissage alimente le cache KV du GPU. Si la requête suivante partage ce préfixe et est dirigée vers un worker qui le conserve encore, le travail déjà effectué est réutilisé. Si elle est dirigée ailleurs, le GPU doit le recalculer. À faible charge, cela passe inaperçu. En conditions de production avec des requêtes simultanées, l’ensemble de travail finit par dépasser la capacité du cache, et le placement détermine alors si le travail est réutilisé ou recommencé.
Avec BIG-IP Next for Kubernetes 2.4, Endpoint Picker prend en compte le préfixe mis en cache, la profondeur de la file d’attente, les requêtes en cours, l’utilisation du cache KV et le délai estimé avant le premier jeton pour choisir un worker. Il prend en charge la dissociation des phases de préremplissage et de décodage, ainsi que des technologies d’inférence ouvertes telles que llm-d et la Kubernetes Gateway API Inference Extension. L’essentiel est que les trois niveaux partagent le même contexte. Un site choisi en fonction de sa capacité ne transfère pas la requête à un cluster saturé. Un cluster choisi pour un modèle n’envoie pas la requête à un worker qui doit reconstruire son contexte de zéro.
Le réseau qui sait ce que savent les GPU
Rien de tout cela ne nécessite une nouvelle plateforme en plus de l’infrastructure d’IA. La couche de pilotage globale existe déjà. L’intelligence au niveau du cluster existe également et est aujourd’hui déployée en production chez des clients de F5. Les travaux en cours portent sur le chaînon manquant : intégrer la télémétrie du cluster et l’intention de la requête afin d’alimenter une décision DNS unique.
Revenons donc à l’architecte, stylo en main. Pour l’inférence d’IA, cinquante centres de données valent effectivement mieux que deux, mais seulement si le réseau qui les relie sait ce que savent les GPU. Les 50 sites cessent alors d’être 50 îlots de capacité pour fonctionner comme un service d’inférence unique, capable de respecter un SLA et les frontières, tout en exploitant chaque GPU déjà financé.
Considérez ceci comme la bande-annonce. La version complète, qui expliquera comment la solution est conçue, avec quels outils et quels résultats ont été mesurés, arrive bientôt.
Découvrez comment F5 aide les entreprises à améliorer l’inférence distribuée, la gestion du trafic d’IA et l’utilisation des GPU dans les infrastructures d’IA modernes AI infrastructure.
À propos de l’auteur
.jpg)
Articles de blog associés
F5 rejoint le projet PQC du NIST pour contribuer à l’élaboration de normes résistantes aux attaques quantiques
En rejoignant le consortium du projet « Migration to PQC » du NIST, F5 contribue à élaborer des recommandations pratiques pour un monde résistant aux menaces quantiques.
La dernière version de F5 Distributed Cloud Bot Defense offre des fonctionnalités et des améliorations de nouvelle génération
Les mises à jour de la console de F5 Distributed Cloud Bot Defense améliorent la gestion des menaces automatisées et l’intégration dans des cadres de sécurité plus larges.

La nouvelle surface de risque liée à l’IA : invisible, autonome et déjà à l’intérieur
James White, vice-président de l’ingénierie chez F5 À mi-parcours de l’année 2025, le moment est bien choisi pour dresser un état des lieux de l’adoption de l’IA en entreprise et de la sécurité de l’IA. L’utilisation de l’IA générative est désormais la norme dans les entreprises De manière générale, les entreprises possèdent au moins une compréhension élémentaire de l’IA générative. Elles savent ce qu’elle est et où elle peut […]
Évaluation des LLM : renforcer la confiance grâce à la notation de sécurité
À mesure que l’adoption de l’IA s’accélère dans les entreprises, l’évaluation des LLM ne porte plus uniquement sur leurs performances, mais aussi sur la confiance qu’ils inspirent. Les équipes de sécurité doivent évaluer non seulement les performances d’un modèle, mais aussi la sûreté de son comportement. Pourtant, la plupart des cadres d’évaluation se concentrent sur des critères de précision, laissant les facteurs de sécurité et de risque dans le flou ou sans mesure.
Évaluer le niveau de préparation de votre organisation à la sécurité de l’IA
Dans un paysage de l’intelligence artificielle (IA) en constante évolution, il est non seulement important, mais impératif de savoir si votre organisation est prête à instaurer et à soutenir une culture de la sécurité de l’IA. À mesure que les technologies d’IA progressent, elles font émerger une multitude de nouveaux défis de sécurité qui, pour être gérés efficacement, exigent une approche réfléchie, globale et proactive […]
Déployer des LLM en entreprise : via une API dans un cloud privé
Pris isolément, sans mesures de protection spécialisées ni protocoles de sécurité en place, le déploiement de modèles d’IA générative (GenAI), en particulier de grands modèles de langage (LLM), à l’échelle de l’entreprise représente pour toute organisation une opportunité à haut risque, mais potentiellement très rentable. La manière précise dont votre organisation doit franchir ce grand pas dans l’univers de la GenAI nécessite une planification mûrement réfléchie. Peut-être serait-il […]