Chaque évolution majeure de l’architecture des applications oblige le réseau à s’adapter. Cette idée n’est ni nouvelle ni même révolutionnaire. Nous l’avons déjà constaté à maintes reprises. Et chaque fois, le même schéma s’est reproduit. Un nouveau type d’application dominant est apparu et « le réseau » s’est adapté pour le prendre en charge, car ces applications exigent des capacités que la pile existante ne peut pas fournir. C’est exactement cette pression que nous observons aujourd’hui avec l’inférence de l’IA.
L’inférence n’est pas l’entraînement. Ce n’est pas de l’expérimentation. Ce n’est pas un exercice de science des données. L’inférence relève du fonctionnement en production et se comporte comme une couche applicative. Elle a des utilisateurs, des profils de trafic, une sensibilité à la latence, des modes de défaillance, des contraintes de coûts et des risques de sécurité. La considérer comme un service backend ou une charge de travail spécialisée revient à passer à côté de ce qui se joue réellement.
L’inférence est un nouveau type d’application.
Notre étude annuelle met clairement cette réalité en évidence. Près de 80 % des organisations gèrent elles-mêmes l’inférence. Seule une petite minorité s’appuie exclusivement sur des services d’IA publics. La plupart des organisations exécutent l’inférence dans leurs propres environnements, sur plusieurs clouds, aux côtés d’applications et d’API traditionnelles. Elles sont déjà confrontées à des problématiques de routage, de disponibilité, de performances et de sécurité lors de l’inférence.
C’est là le point essentiel. Les problèmes surviennent pendant l’inférence ; ni avant, ni après, et certainement pas pendant l’entraînement.
Les techniques de distribution traditionnelles ne suffisent pas ici. L’équilibrage de charge suppose que les serveurs back-end sont interchangeables. Les contrôles d’intégrité supposent une disponibilité binaire. Le routage statique du trafic suppose un comportement prévisible. Or, aucune de ces hypothèses ne tient lorsque le coût, la qualité, la latence et le risque des requêtes varient en fonction des prompts, des tokens et du comportement du modèle.
Par conséquent, donc, et ainsi, « le réseau » doit à nouveau évoluer.
La nouvelle pile réseau
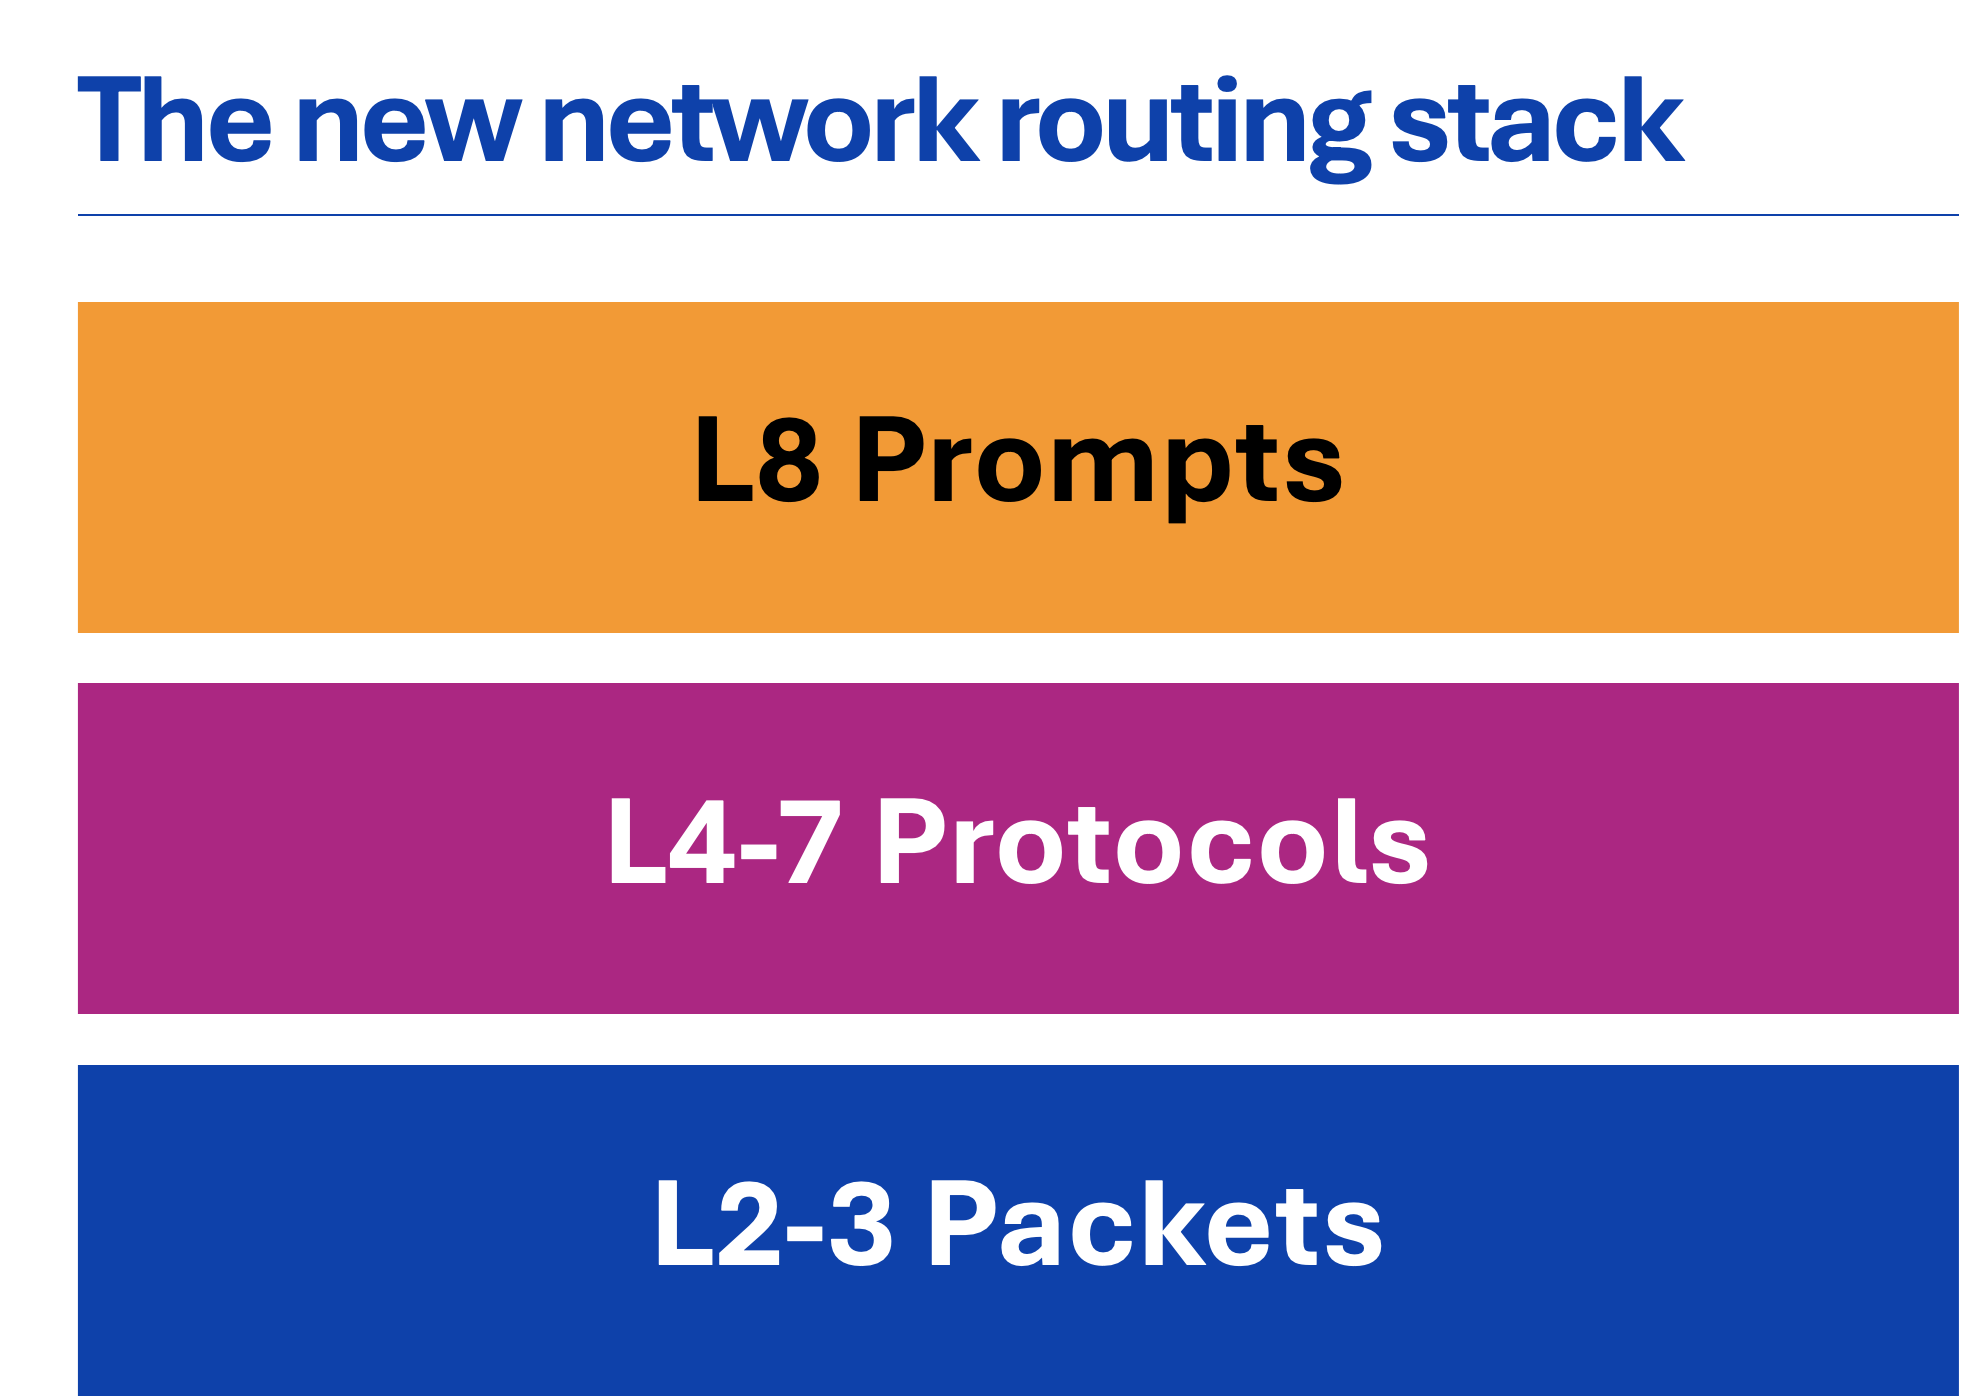
Pendant des décennies, la pile réseau a été décrite en termes de paquets et de protocoles. Les couches 2 et 3 prenaient en charge les paquets. Les couches 4 à 7 géraient les sessions, les protocoles et les applications. Cette représentation fonctionnait parce que les applications exprimaient leur intention et leur finalité au moyen de protocoles. Ce n’est pas le cas de l’inférence.
L’inférence exprime l’intention et la finalité au moyen de prompts.
C’est pourquoi nous assistons aujourd’hui à l’émergence d’une nouvelle couche dominante. La couche 8. La couche des prompts.
Attends une minute, Lori, vous dites-vous peut-être. Cela fait longtemps que nous effectuons le routage en fonction de certaines parties de la charge utile, alors qu’est-ce qui rend cette approche si différente ?
Merci d’avoir posé la question !
La différence est en réalité assez profonde, d’autant plus qu’avec l’inférence, les URI ne correspondent pas à des « fonctions » et que déterminer ce qui est invoqué nécessite d’extraire l’intention de… l’invite. C’est fondamentalement pour cette raison que l’orientation du trafic fondée sur la charge utile n’a pas atteint le statut de nouvelle couche. Elle n’a pas radicalement changé la donne. L’inférence ? Oh, non seulement elle change la donne, mais elle en réécrit régulièrement les règles.
L’enjeu majeur, c’est qu’au niveau de la « couche des prompts », les décisions de routage ne reposent plus uniquement sur les adresses IP, les ports, les URI, ni même sur certaines parties de la charge utile. Elles dépendent de qui formule la demande, de ce qui est demandé, de son coût, de son niveau de risque et du niveau de qualité attendu du résultat. Associée à la modération des sorties et au contrôle des jetons, cette couche de la pile est, selon notre dernière étude, celle où la distribution et la sécurité des applications ont le plus d’impact. Ajoutez-y le routage des modèles (également à la couche 8), et vous constaterez que la majorité des organisations reconnaissent déjà son importance pour sécuriser et faire évoluer l’inférence de l’IA.
L’inspection des prompts, le contrôle des jetons, la modération des résultats et le routage des modèles ne sont pas des fonctionnalités facultatives. Ce sont des prérequis indispensables à l’exploitation de l’inférence en production.
Rassurez-vous, les couches inférieures ne disparaissent pas, pas plus que les couches L2-3 n’ont disparu lorsque les couches L4-7 ont pris la tête de la pile. Elles deviennent simplement les fondations de l’ensemble. Le routage des paquets reste important. La gestion des protocoles aussi.
Mais ne vous y trompez pas : la valeur se situe désormais au niveau de la couche 8.
La réponse à l’inférence confirme ce changement
Les contrôleurs de mise à disposition d’applications sont apparus parce que les réseaux conçus pour acheminer des paquets ne pouvaient pas prendre en charge les applications. Les passerelles API sont apparues parce que les réseaux conçus pour les applications web ne pouvaient pas prendre en charge les API. La prise en charge de l’inférence émerge aujourd’hui parce que les réseaux conçus pour les API ne peuvent pas prendre en charge les applications autonomes, probabilistes et aux coûts variables.
La réaction du marché confirme cette évolution. Des start-up se créent autour du routage des modèles, des passerelles d’inférence, de la gouvernance des jetons et du contrôle des prompts. Les hyperscalers développent discrètement les mêmes capacités en interne.
La réaction des entreprises confirme cette évolution. Quatre-vingt-dix pour cent des organisations utilisent des services d’inférence, et 70 % d’entre elles ont recours à au moins deux services d’inférence différents, notamment à des services qu’elles exploitent elles-mêmes. Elles mettent en œuvre des stratégies multimodèles, expérimentent l’IA agentique et adoptent l’automatisation pilotée par l’IA dans leurs opérations.
Ce n’est pas un effet de mode. C’est un changement structurel.
L’inférence n’est pas une charge de travail comme les autres. Les architectures qui restent centrées sur les paquets et les protocoles continueront de fonctionner, mais ne pourront pas évoluer efficacement. Les piles réseau qui s’arrêtent aux API auront du mal à contrôler les systèmes autonomes.
L’inférence a déplacé le point de contrôle vers les couches supérieures de la pile. La suite est inévitable.
À propos de l’auteur

Lori MacVittie est ingénieure émérite et évangéliste en chef au sein du bureau du directeur technique de F5. Elle possède une expertise approfondie dans la fourniture d’applications, les stratégies d’automatisation et les infrastructures. Elle est réputée pour sa capacité à rendre la complexité intelligible, qu’elle définisse des garde-fous pour les agents d’IA, analyse des architectures multicloud fragiles ou explore les limites des systèmes évolutifs. Elle cumule plus de trente ans d’expérience dans le secteur, couvrant le développement d’applications, l’architecture informatique ainsi que l’exploitation des réseaux et des systèmes. Avant de rejoindre F5, elle a été rédactrice spécialisée dans les technologies et a reçu plusieurs distinctions. MacVittie est titulaire d’un master en informatique et est une autrice prolifique dont les publications couvrent la sécurité, le cloud et l’architecture d’entreprise. Elle est également une passionnée de jeux de société et de jeux vidéo, et assume pleinement ses avis bien tranchés sur le fromage.
Autres articles de Lori Mac VittieArticles de blog associés
Les paquets empoisonnés sont en train de tuer notre industrie
L’open source ne dispose pas d’un registre central recensant les paquets malveillants, alors même que l’IA et l’automatisation accélèrent les attaques contre la chaîne d’approvisionnement. L’écosystème a besoin d’un moyen fiable de signaler et de suivre les compromissions.
Top 10 des risques liés à la mise en production d’applications d’IA : manque de sécurité et de conformité réglementaire
L’IA étend la conformité au-delà de la sécurisation des chemins d’accès et des espaces de stockage pour englober la gouvernance du comportement à l’exécution — accès aux modèles, contexte de récupération, résultats et actions des agents —, de sorte que les contrôles doivent être rapprochés de l’inférence.
Top 10 de la livraison d’applications d’IA : politiques de livraison incompatibles
Les divergences de politiques deviennent des sources de pannes pour l’IA : des mécanismes de basculement, des délais d’expiration, des limites et des contrôles de sécurité incohérents entraînent des défaillances silencieuses, des résultats partiels et des résultats différents selon le point de terminaison.
Top 10 de la mise à disposition d’applications d’IA : orientation du trafic non optimisée
L’IA remet en cause les principes traditionnels de répartition du trafic : les backends ne sont pas interchangeables, les coûts varient et les agents multiplient les requêtes de manière imprévisible. Le routage doit donc tenir compte du modèle, de l’état des GPU et de la localisation des données.
Top 10 de la livraison d’applications d’IA : contrôles du trafic insuffisants
Les limites de débit et les mécanismes de régulation traditionnels ne tiennent pas compte de l’étendue réelle des répercussions. Les charges de travail d’IA se répartissent entre les modèles, les bases de données vectorielles et les services, provoquant des pics de latence, des défaillances en cascade et des nouvelles tentatives.
La gestion des fenêtres de contexte en IA n’a rien de magique. C’est une question d’architecture.
Découvrez pourquoi les créateurs d’applications d’IA doivent gérer le contexte, la mémoire et l’infrastructure, tout en faisant évoluer les processus de livraison et la sécurité afin d’éviter la dérive, la latence et les attaques par injection de prompts.