La rédaction – Cette série de sept articles est désormais terminée :
- Introduction aux microservices
- Créer des microservices : utiliser une passerelle API
- Création de microservices : communication interprocessus dans une architecture de microservices
- Découverte de services dans une architecture de microservices
- Gestion des données pilotée par les événements pour les microservices
- Choisir une stratégie de déploiement des microservices (cet article)
- Refactoriser un monolithe en microservices
Vous pouvez également télécharger l’ensemble des articles, ainsi que des informations sur la mise en œuvre de microservices avec NGINX Plus, sous forme d’ebook : « Microservices : de la conception au déploiement ». Consultez également notre série sur l’architecture de référence des microservices ainsi que la page des solutions de microservices.
Ceci est le sixième article d’une série consacrée au développement d’applications à l’aide de microservices. Le premier article présente le modèle d’architecture de microservices et examine les avantages et les inconvénients de l’utilisation des microservices. Les articles suivants abordent différents aspects de l’architecture de microservices : l’utilisation d’une passerelle API, la communication interprocessus, la découverte de services et la gestion des données pilotée par les événements. Dans cet article, nous examinons les différentes stratégies de déploiement des microservices.
Motivations
Déployer une application monolithique consiste à exécuter plusieurs copies identiques d’une même application, généralement volumineuse. En règle générale, vous provisionnez N serveurs (physiques ou virtuels) et exécutez M instances de l’application sur chacun d’eux. Le déploiement d’une application monolithique n’est pas toujours totalement simple, mais il est bien plus facile que celui d’une application basée sur des microservices.
Une application de microservices se compose de dizaines, voire de centaines de services. Ces services sont écrits dans divers langages et frameworks. Chacun constitue une mini-application ayant ses propres exigences en matière de déploiement, de ressources, de mise à l’échelle et de supervision. Par exemple, vous devez exécuter un certain nombre d’instances de chaque service en fonction de la demande. Chaque instance doit également disposer des ressources appropriées en matière de processeur, de mémoire et d’E/S. Plus difficile encore, malgré cette complexité, le déploiement des services doit être rapide, fiable et rentable.
Il existe plusieurs modèles de déploiement des microservices. Examinons tout d’abord le modèle « Plusieurs instances de service par hôte ».
Modèle de déploiement de plusieurs instances de service par hôte
Une façon de déployer vos microservices consiste à utiliser le modèle « Plusieurs instances de service par hôte ». Avec ce modèle, vous provisionnez un ou plusieurs hôtes physiques ou virtuels et exécutez plusieurs instances de service sur chacun d’eux. À bien des égards, il s’agit de l’approche traditionnelle du déploiement d’applications. Chaque instance de service s’exécute sur un port connu d’un ou de plusieurs hôtes. Les machines hôtes sont généralement traitées comme des animaux de compagnie.
Le schéma suivant illustre la structure de ce modèle.
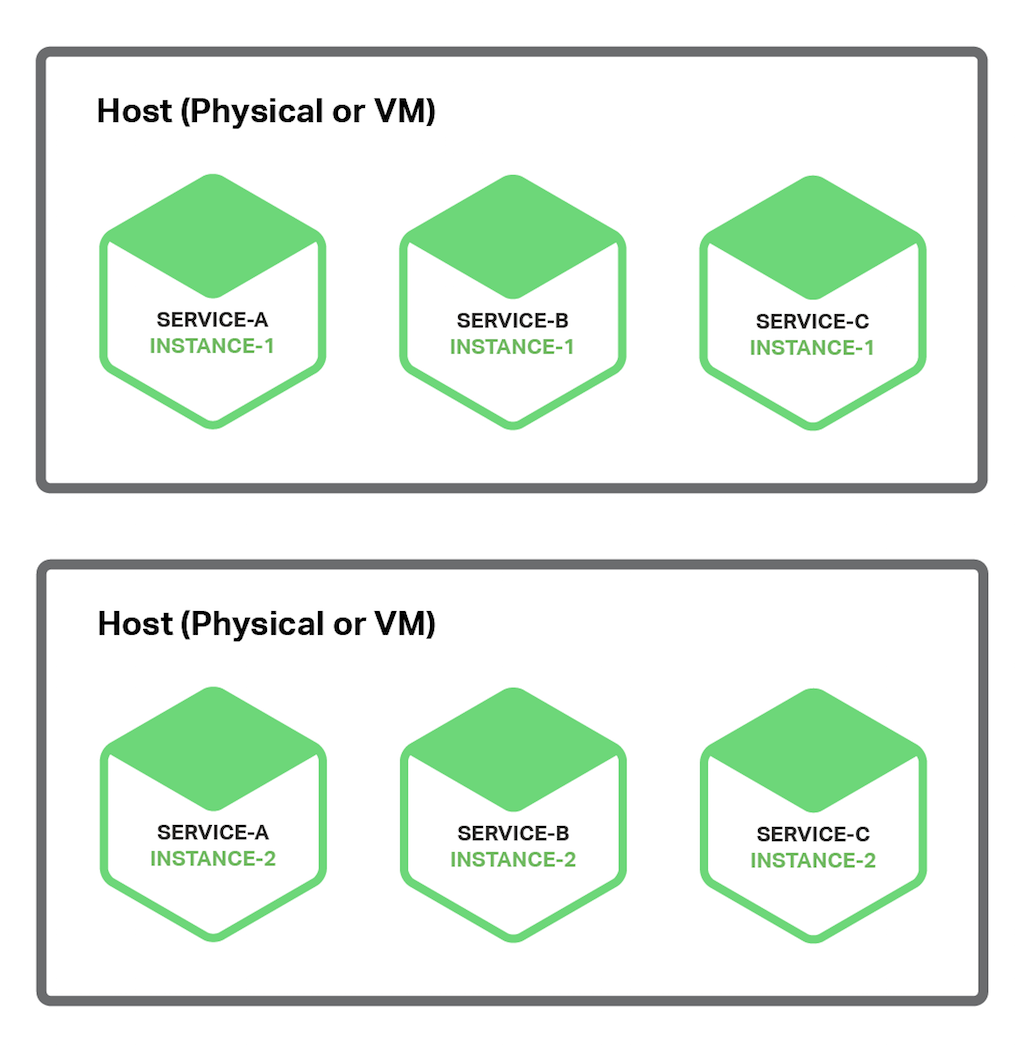
Ce modèle comporte plusieurs variantes. Dans l’une d’elles, chaque instance de service correspond à un processus ou à un groupe de processus. Par exemple, vous pouvez déployer une instance de service Java sous forme d’application web sur un serveur Apache Tomcat. Une instance de service Node.js peut être constituée d’un processus parent et d’un ou plusieurs processus enfants.
L’autre variante de ce modèle consiste à exécuter plusieurs instances de service au sein d’un même processus ou groupe de processus. Par exemple, vous pouvez déployer plusieurs applications web Java sur le même serveur Apache Tomcat ou exécuter plusieurs bundles OSGI dans le même conteneur OSGI.
Le modèle « Plusieurs instances de service par hôte » présente à la fois des avantages et des inconvénients. L’un de ses principaux avantages est son utilisation relativement efficace des ressources. Plusieurs instances de service partagent le serveur et son système d’exploitation. L’efficacité est encore meilleure lorsqu’un processus ou un groupe de processus exécute plusieurs instances de service, par exemple lorsque plusieurs applications web partagent le même serveur Apache Tomcat et la même JVM.
Un autre avantage de ce modèle est que le déploiement d’une instance de service est relativement rapide. Il suffit de copier le service sur un hôte et de le démarrer. Si le service est écrit en Java, vous copiez un fichier JAR ou WAR. Pour d’autres langages, tels que Node.js ou Ruby, vous copiez le code source. Dans les deux cas, le nombre d’octets transférés sur le réseau est relativement faible.
De plus, en raison de la faible surcharge, le démarrage d’un service est généralement très rapide. Si le service s’exécute dans son propre processus, il suffit de le démarrer. Sinon, s’il s’agit de l’une des nombreuses instances exécutées au sein du même processus de conteneur ou groupe de processus, vous devez soit la déployer dynamiquement dans le conteneur, soit redémarrer celui-ci.
Malgré son intérêt, le modèle Plusieurs instances de service par hôte présente des inconvénients importants. L’un des principaux est que les instances de service sont peu ou pas isolées, sauf si chacune d’elles s’exécute dans un processus distinct. Bien qu’il soit possible de surveiller précisément l’utilisation des ressources de chaque instance de service, il n’est pas possible de limiter les ressources qu’elle utilise. Une instance de service défaillante peut ainsi consommer toute la mémoire ou toutes les ressources processeur de l’hôte.
Il n’y a aucune isolation lorsque plusieurs instances de service s’exécutent dans le même processus. Par exemple, toutes les instances peuvent partager le même tas JVM. Une instance de service défaillante pourrait facilement perturber les autres services s’exécutant dans le même processus. De plus, vous n’avez aucun moyen de surveiller les ressources utilisées par chaque instance de service.
Un autre problème majeur de cette approche tient au fait que l’équipe d’exploitation chargée de déployer un service doit connaître précisément la procédure à suivre. Les services pouvant être écrits dans divers langages et frameworks, l’équipe de développement doit communiquer de nombreux détails à l’équipe d’exploitation. Cette complexité accroît le risque d’erreurs lors du déploiement.
Comme vous pouvez le constater, malgré son caractère familier, le modèle Plusieurs instances de service par hôte présente des inconvénients importants. Examinons maintenant d’autres méthodes de déploiement des microservices qui permettent d’éviter ces problèmes.
Modèle « Une instance de service par hôte »
Une autre façon de déployer vos microservices consiste à utiliser le modèle « Instance de service par hôte ». Lorsque vous utilisez ce modèle, chaque instance de service s’exécute de manière isolée sur son propre hôte. Il existe deux spécialisations distinctes de ce modèle : Instance de service par machine virtuelle et Instance de service par conteneur.
Modèle « Instance de service par machine virtuelle »
Lorsque vous utilisez le modèle « Instance de service par machine virtuelle », vous empaquetez chaque service sous la forme d’une image de machine virtuelle (VM), telle qu’une AMI Amazon EC2. Chaque instance de service est une VM (par exemple, une instance EC2) lancée à partir de cette image de VM. Le schéma suivant illustre la structure de ce modèle :
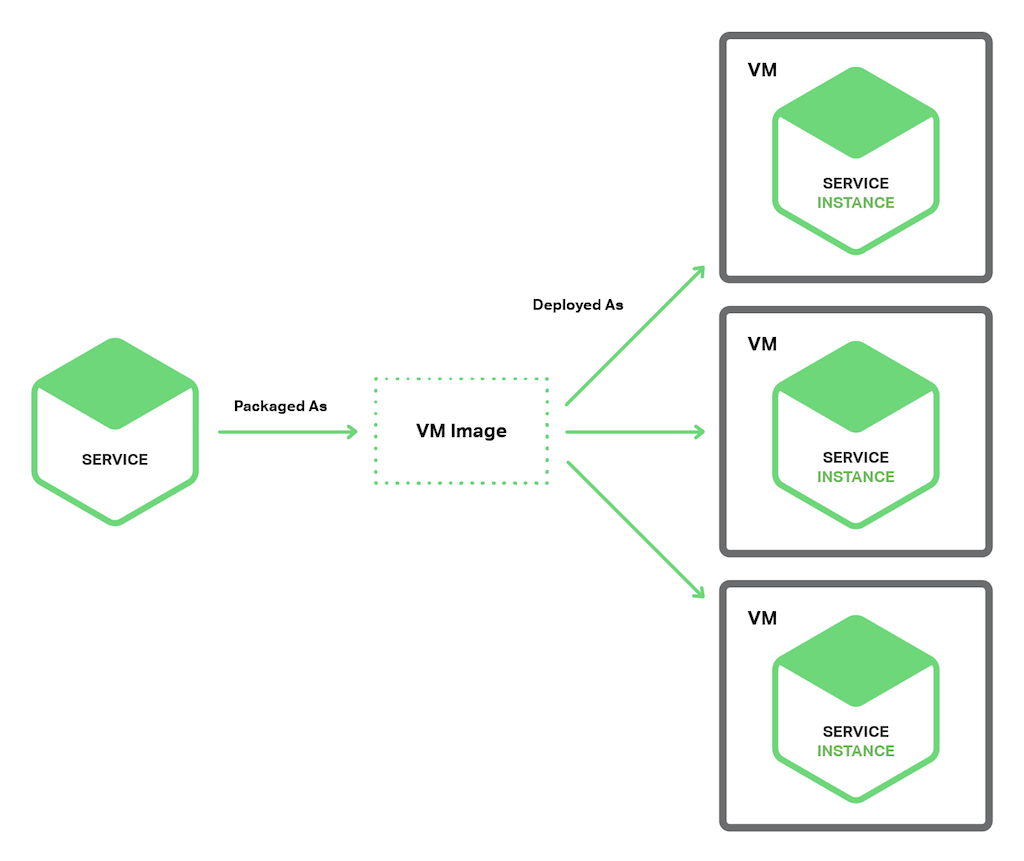
Il s’agit de la principale approche utilisée par Netflix pour déployer son service de streaming vidéo. Netflix regroupe chacun de ses services dans une AMI EC2 à l’aide d’Aminator. Chaque instance de service en cours d’exécution est une instance EC2.
Il existe différents outils permettant de créer vos propres machines virtuelles. Vous pouvez configurer votre serveur d’intégration continue (CI) (par exemple, Jenkins) afin qu’il appelle Aminator pour empaqueter vos services sous forme d’AMI EC2. Packer.io constitue une autre solution pour automatiser la création d’images de machines virtuelles. Contrairement à Aminator, il prend en charge diverses technologies de virtualisation, notamment EC2, DigitalOcean, VirtualBox et VMware.
La société Boxfuse propose une méthode convaincante pour créer des images de machines virtuelles, qui permet de remédier aux inconvénients des machines virtuelles décrits ci-dessous. Boxfuse transforme votre application Java en une image de machine virtuelle minimale. Ces images sont rapides à créer et à démarrer, et sont plus sécurisées, car elles offrent une surface d’attaque limitée.
L’entreprise CloudNative propose Bakery, une offre SaaS permettant de créer des AMI EC2. Vous pouvez configurer votre serveur d’intégration continue pour qu’il appelle Bakery une fois les tests de votre microservice réussis. Bakery empaquette ensuite votre service sous forme d’AMI. En utilisant une offre SaaS telle que Bakery, vous évitez de perdre un temps précieux à mettre en place l’infrastructure de création des AMI.
Le modèle « une instance de service par machine virtuelle » présente plusieurs avantages. L’un des principaux avantages des machines virtuelles est que chaque instance de service s’exécute de manière totalement isolée. Elle dispose d’une quantité fixe de ressources processeur et de mémoire et ne peut pas accaparer les ressources des autres services.
Un autre avantage du déploiement de vos microservices sous forme de machines virtuelles est que vous pouvez tirer parti d’une infrastructure cloud mature. Les plateformes cloud telles qu’AWS proposent des fonctionnalités utiles, comme l’équilibrage de charge et la mise à l’échelle automatique.
Un autre avantage majeur du déploiement de votre service sous forme de machine virtuelle est qu’il permet d’encapsuler la technologie utilisée pour sa mise en œuvre. Une fois qu’un service a été conditionné sous forme de machine virtuelle, il devient une boîte noire. L’API de gestion de la machine virtuelle devient alors l’API utilisée pour déployer le service. Le déploiement devient ainsi beaucoup plus simple et plus fiable.
Le modèle « une instance de service par machine virtuelle » présente toutefois quelques inconvénients. L’un d’eux est une utilisation moins efficace des ressources. Chaque instance de service supporte la surcharge liée à une machine virtuelle complète, y compris le système d’exploitation. De plus, dans une infrastructure IaaS publique classique, les machines virtuelles sont proposées dans des tailles prédéfinies et risquent donc d’être sous-utilisées.
De plus, un fournisseur d’IaaS public facture généralement les machines virtuelles, qu’elles soient utilisées ou inactives. Une plateforme IaaS telle qu’AWS propose la mise à l’échelle automatique, mais il est difficile de réagir rapidement aux variations de la demande. Par conséquent, il faut souvent surdimensionner le nombre de machines virtuelles, ce qui augmente le coût du déploiement.
Un autre inconvénient de cette approche est que le déploiement d’une nouvelle version d’un service est généralement lent. La création des images de machines virtuelles prend généralement du temps en raison de leur taille. De même, l’instanciation des machines virtuelles est généralement lente, là encore en raison de leur taille. En outre, le démarrage d’un système d’exploitation prend généralement un certain temps. Il convient toutefois de noter que ce n’est pas toujours le cas, puisqu’il existe des machines virtuelles légères, telles que celles créées par Boxfuse.
Un autre inconvénient du modèle « une instance de service par machine virtuelle » est que vous (ou quelqu’un d’autre au sein de votre organisation) devez généralement prendre en charge de nombreuses tâches lourdes sans valeur ajoutée particulière. À moins d’utiliser un outil tel que Boxfuse, qui se charge de la création et de la gestion des machines virtuelles, cette responsabilité vous incombe. Cette activité nécessaire, mais chronophage, vous détourne de votre cœur de métier.
Examinons maintenant une autre façon de déployer des microservices, plus légère, mais qui conserve néanmoins bon nombre des avantages des machines virtuelles.
Modèle d’instance de service par conteneur
Lorsque vous utilisez le modèle « Instance de service par conteneur », chaque instance de service s’exécute dans son propre conteneur. Les conteneurs constituent un mécanisme de virtualisation au niveau du système d’exploitation. Un conteneur se compose d’un ou de plusieurs processus s’exécutant dans un environnement isolé. Du point de vue des processus, ceux-ci disposent de leur propre espace de noms de ports et de leur propre système de fichiers racine. Vous pouvez limiter les ressources mémoire et processeur d’un conteneur. Certaines implémentations de conteneurs permettent également de limiter le débit des entrées/sorties. Parmi les technologies de conteneurs figurent notamment Docker et Solaris Zones.
Le diagramme suivant illustre la structure de ce modèle :
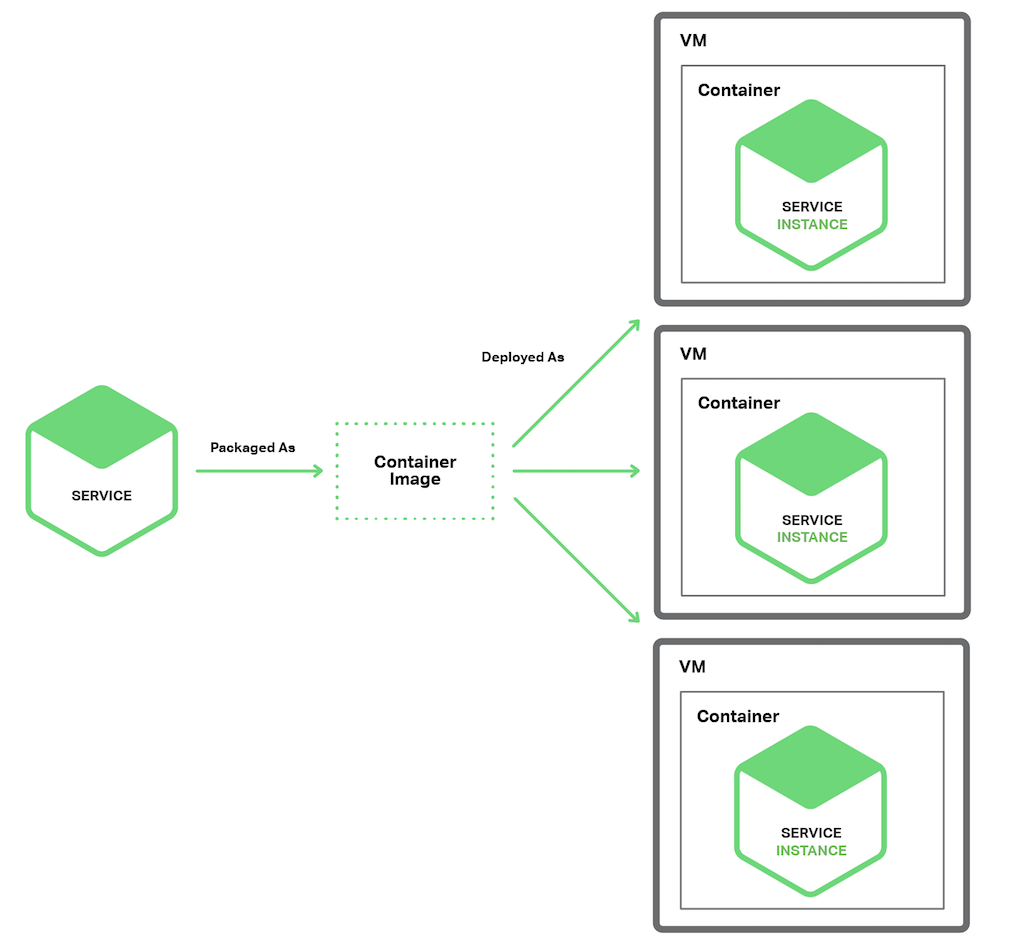
Pour utiliser ce modèle, vous empaquetez votre service sous la forme d’une image de conteneur. Une image de conteneur est une image de système de fichiers qui contient les applications et les bibliothèques nécessaires à l’exécution du service. Certaines images de conteneur comprennent un système de fichiers racine Linux complet. D’autres sont plus légères. Pour déployer un service Java, par exemple, vous créez une image de conteneur contenant l’environnement d’exécution Java, éventuellement un serveur Apache Tomcat, ainsi que votre application Java compilée.
Une fois votre service empaqueté sous forme d’image de conteneur, vous lancez un ou plusieurs conteneurs. En général, vous exécutez plusieurs conteneurs sur chaque hôte physique ou virtuel. Vous pouvez utiliser un gestionnaire de cluster tel que Kubernetes ou Marathon pour gérer vos conteneurs. Un gestionnaire de cluster considère les hôtes comme un pool de ressources. Il détermine où placer chaque conteneur en fonction des ressources dont celui-ci a besoin et de celles disponibles sur chaque hôte.
Le modèle « une instance de service par conteneur » présente à la fois des avantages et des inconvénients. Les avantages des conteneurs sont similaires à ceux des machines virtuelles. Ils isolent vos instances de service les unes des autres. Vous pouvez facilement surveiller les ressources consommées par chaque conteneur. De plus, à l’instar des machines virtuelles, les conteneurs encapsulent la technologie utilisée pour mettre en œuvre vos services. L’API de gestion des conteneurs sert également d’API pour gérer vos services.
Cependant, contrairement aux machines virtuelles, les conteneurs sont une technologie légère. Les images de conteneurs sont généralement très rapides à créer. Par exemple, sur mon ordinateur portable, il ne faut que 5 secondes pour empaqueter une application Spring Boot sous forme de conteneur Docker. Les conteneurs démarrent également très rapidement, car ils ne nécessitent pas le long processus de démarrage d’un système d’exploitation. Lorsqu’un conteneur démarre, c’est le service qui s’exécute.
L’utilisation de conteneurs présente certains inconvénients. Bien que l’infrastructure des conteneurs gagne rapidement en maturité, elle n’est pas aussi mature que celle des machines virtuelles. En outre, les conteneurs ne sont pas aussi sécurisés que les machines virtuelles, car ils partagent entre eux le noyau du système d’exploitation hôte.
Un autre inconvénient des conteneurs est que vous devez vous charger des tâches lourdes et indifférenciées liées à l’administration des images de conteneurs. De plus, à moins d’utiliser une solution de conteneurs hébergée telle que Google Container Engine ou Amazon EC2 Container Service (ECS), vous devez administrer l’infrastructure de conteneurs et éventuellement l’infrastructure de machines virtuelles sur laquelle elle s’exécute.
De plus, les conteneurs sont souvent déployés sur une infrastructure dont la tarification s’effectue par machine virtuelle. Par conséquent, comme indiqué précédemment, vous devrez probablement supporter le coût supplémentaire lié au surdimensionnement des machines virtuelles afin de faire face aux pics de charge.
Il est intéressant de noter que la distinction entre les conteneurs et les machines virtuelles devrait s’estomper. Comme indiqué précédemment, les machines virtuelles Boxfuse sont rapides à créer et à démarrer. Le projet Clear Containers vise à créer des machines virtuelles légères. [Note de l’éditeur – Comme annoncé en décembre 2017, le développement de Clear Containers se poursuit désormais dans le cadre du projet open source Kata Containers.] Les unikernels suscitent également un intérêt croissant. Docker, Inc. a récemment acquis Unikernel Systems.
Il existe également un concept plus récent et de plus en plus populaire, celui du déploiement sans serveur, une approche qui évite d’avoir à choisir entre le déploiement de services dans des conteneurs ou dans des machines virtuelles. Examinons maintenant ce concept.
Déploiement sans serveur
AWS Lambda est un exemple de technologie de déploiement sans serveur. Elle prend en charge les services Java, Node.js et Python. Pour déployer un microservice, vous le regroupez dans un fichier ZIP et le chargez sur AWS Lambda. Vous fournissez également des métadonnées qui précisent, entre autres, le nom de la fonction appelée pour traiter une requête (également appelée événement). AWS Lambda exécute automatiquement suffisamment d’instances de votre microservice pour traiter les requêtes. Chaque requête vous est simplement facturée en fonction du temps d’exécution et de la mémoire consommée. Bien entendu, le diable se cache dans les détails et vous verrez bientôt qu’AWS Lambda présente certaines limites. Mais l’idée que ni vous, en tant que développeur, ni personne au sein de votre organisation n’ayez à vous soucier des serveurs, des machines virtuelles ou des conteneurs est extrêmement séduisante.
Une fonction Lambda est un service sans état. Elle traite généralement les requêtes en faisant appel à des services AWS. Par exemple, une fonction Lambda appelée lorsqu’une image est chargée dans un compartiment S3 pourrait insérer un élément dans une table d’images DynamoDB et publier un message dans un flux Kinesis afin de déclencher le traitement de l’image. Une fonction Lambda peut également faire appel à des services web tiers.
Il existe quatre façons d’invoquer une fonction Lambda :
- Directement, à l’aide d’une requête de service web
- Automatiquement, en réponse à un événement généré par un service AWS tel que S3, DynamoDB, Kinesis ou Simple Email Service
- Automatiquement, via Amazon API Gateway, pour traiter les requêtes HTTP provenant des clients de l’application
- Périodiquement, selon une planification de type «
cron»
Comme vous pouvez le constater, AWS Lambda constitue un moyen pratique de déployer des microservices. Grâce à la tarification basée sur le nombre de requêtes, vous ne payez que pour le travail réellement effectué par vos services. De plus, comme vous n’avez pas à gérer l’infrastructure informatique, vous pouvez vous concentrer sur le développement de votre application.
Il existe toutefois certaines limitations importantes. AWS Lambda n’est pas conçu pour déployer des services de longue durée, tels qu’un service qui consomme des messages provenant d’un courtier de messages tiers. Les requêtes doivent s’exécuter en moins de 300 secondes. Les services doivent être sans état, car, en théorie, AWS Lambda peut exécuter une instance distincte pour chaque requête. Ils doivent être écrits dans l’un des langages pris en charge. Les services doivent également démarrer rapidement, faute de quoi ils risquent de dépasser le délai imparti et d’être interrompus.
Résumé
Le déploiement d’une application de microservices est complexe. Celle-ci peut comporter des dizaines, voire des centaines de services écrits dans différents langages et frameworks. Chacun constitue une mini-application ayant ses propres exigences en matière de déploiement, de ressources, de mise à l’échelle et de supervision. Il existe plusieurs modèles de déploiement de microservices, notamment une instance de service par machine virtuelle et une instance de service par conteneur. AWS Lambda, une approche sans serveur, constitue une autre option intéressante pour déployer des microservices. Dans le prochain et dernier volet de cette série, nous verrons comment migrer une application monolithique vers une architecture de microservices.
Éditeur – Cette série de sept articles est désormais terminée :
- Introduction aux microservices
- Créer des microservices : utiliser une passerelle API
- Créer des microservices : communication interprocessus dans une architecture de microservices
- Découverte de services dans une architecture de microservices
- Gestion des données pilotée par les événements pour les microservices
- Choisir une stratégie de déploiement des microservices (cet article)
- Refactoriser un monolithe en microservices
Vous pouvez également télécharger l’ensemble des articles, ainsi que des informations sur la mise en œuvre de microservices avec NGINX Plus, sous forme d’ebook : « Microservices : de la conception au déploiement ». Consultez également notre série consacrée à l’architecture de référence pour les microservices ainsi que la page des solutions de microservices.
Le blogueur invité Chris Richardson est le fondateur du site original CloudFoundry.com, l’une des premières plateformes Java en tant que service (PaaS) pour Amazon EC2. Il conseille désormais des organisations afin d’améliorer leurs méthodes de développement et de déploiement d’applications. Il publie également régulièrement des articles sur les microservices à l’adresse https://microservices.io.
À propos de l’auteur
Articles de blog associés

Tendances actuelles des technologies cloud natives, de l’ingénierie de plateforme et de l’IA
Découvrez les principaux enseignements tirés des réponses à l’enquête annuelle F5 NGINX sur les dernières tendances en matière de technologies cloud natives, de sécurité, d’ingénierie de plateforme et d’IA.

Quels contrôleurs Ingress NGINX sont affectés par les vulnérabilités CVE-2022-4886, CVE-2023-5043 et CVE-2023-5044 ?
Lorsque de nouvelles CVE sont signalées, il est facile de ne plus savoir si elles concernent un outil de contrôleur Ingress NGINX particulier, car il existe plusieurs projets. Cet article présente les CVE et explique comment distinguer les différents projets de contrôleurs Ingress afin de dissiper toute confusion.
Votre API est-elle en temps réel ? Testez sa latence avec l’outil rtapi de NGINX
Votre API répond-elle aux requêtes en moins de 30 ms ? Si ce n’est pas le cas, il ne s’agit pas d’une API en temps réel offrant la faible latence exigée par la grande majorité des organisations. Mesurez la latence de votre API avec l’outil rtapi de NGINX et découvrez comment NGINX peut l’aider à offrir une réactivité en temps réel.

Un testeur d’expressions régulières pour NGINX et NGINX Plus
Le testeur d’expressions régulières (regex) pour NGINX et NGINX Plus vous évite de tâtonner en vous indiquant si une expression régulière utilisée dans un bloc location ou map correspond aux valeurs comme prévu. Il génère la configuration appropriée et affiche les valeurs des groupes de capture.
Caches partagés avec les clusters de cache NGINX Plus, partie 1
Optimisez la capacité de votre cache web en le répartissant entre plusieurs serveurs de cache web NGINX ou NGINX Plus. Découvrez comment procéder dans cet article.
Introduction aux microservices
Les microservices suscitent actuellement beaucoup d’intérêt. Cet article de blog est le premier d’une série de sept consacrée à la conception, au développement et au déploiement de microservices.