La rédaction – Cette série de sept articles est désormais terminée :
- Introduction aux microservices
- Créer des microservices : utiliser une passerelle API
- Créer des microservices : communication interprocessus dans une architecture de microservices
- Découverte de services dans une architecture de microservices
- Gestion des données pilotée par les événements pour les microservices (cet article)
- Choisir une stratégie de déploiement des microservices
- Refactoriser un monolithe en microservices
Vous pouvez également télécharger l’ensemble des articles, ainsi que des informations sur la mise en œuvre de microservices avec NGINX Plus, sous forme d’ebook : « Microservices : de la conception au déploiement ». Consultez également notre série sur l’architecture de référence des microservices et notre page consacrée aux solutions de microservices.
Voici le cinquième article d’une série consacrée à la création d’applications à l’aide de microservices. Le premier article présente le modèle d’architecture de microservices et examine les avantages et les inconvénients de l’utilisation des microservices. Les deuxième<.htmla> et troisième articles de la série décrivent différents aspects de la communication au sein d’une architecture de microservices. Le quatrième article aborde la question étroitement liée de la découverte de services. Dans cet article, nous changeons de sujet pour nous intéresser aux problèmes de gestion des données distribuées qui se posent dans une architecture de microservices.
Les microservices et le problème de la gestion des données distribuées
Une application monolithique ne dispose généralement que d’une seule base de données relationnelle. L’un des principaux avantages d’une base de données relationnelle est que votre application peut utiliser des transactions ACID, qui offrent certaines garanties importantes :
- Atomicité – Les modifications sont effectuées de manière atomique
- Cohérence – L’état de la base de données est toujours cohérent
- Isolation – Même si les transactions sont exécutées simultanément, elles semblent être exécutées de manière séquentielle
- Durabilité – Une fois qu’une transaction a été validée, elle ne peut pas être annulée
Par conséquent, votre application peut simplement démarrer une transaction, modifier plusieurs lignes (en les insérant, en les mettant à jour ou en les supprimant), puis valider la transaction.
Un autre avantage majeur de l’utilisation d’une base de données relationnelle est qu’elle fournit SQL, un langage de requête riche, déclaratif et normalisé. Vous pouvez facilement écrire une requête qui combine les données de plusieurs tables. L’optimiseur de requêtes du SGBDR détermine ensuite la manière optimale d’exécuter la requête. Vous n’avez pas à vous soucier des détails de bas niveau, tels que la façon d’accéder à la base de données. Et comme toutes les données de votre application se trouvent dans une seule base de données, elles sont faciles à interroger.
Malheureusement, l’accès aux données devient beaucoup plus complexe lorsque l’on adopte une architecture de microservices. En effet, les données détenues par chaque microservice sont propres à ce microservice et ne sont accessibles que par l’intermédiaire de son API. L’encapsulation des données garantit un couplage faible entre les microservices et leur permet d’évoluer indépendamment les uns des autres. Si plusieurs services accèdent aux mêmes données, toute modification du schéma nécessite une mise à jour coordonnée et chronophage de l’ensemble des services.
Pour ne rien arranger, les différents microservices utilisent souvent différents types de bases de données. Les applications modernes stockent et traitent des données de natures diverses, et une base de données relationnelle n’est pas toujours le meilleur choix. Pour certains cas d’usage, une base de données NoSQL particulière peut proposer un modèle de données plus adapté ainsi que des performances et une évolutivité nettement supérieures. Par exemple, il est judicieux qu’un service qui stocke du texte et effectue des recherches dans celui-ci utilise un moteur de recherche textuelle tel qu’Elasticsearch. De même, un service qui stocke des données de graphe social devrait probablement utiliser une base de données orientée graphe, telle que Neo4j. Par conséquent, les applications basées sur des microservices utilisent souvent une combinaison de bases de données SQL et NoSQL, selon l’approche dite de « persistance polyglotte ».
Une architecture de stockage des données partitionnée et fondée sur la persistance polyglotte présente de nombreux avantages, notamment des services faiblement couplés ainsi que de meilleures performances et une plus grande évolutivité. Elle pose toutefois certains défis en matière de gestion des données distribuées.
Le premier défi consiste à mettre en œuvre des transactions métier qui garantissent la cohérence entre plusieurs services. Pour comprendre pourquoi cela pose problème, prenons l’exemple d’une boutique B2B en ligne. Le service client gère les informations relatives aux clients, notamment leurs lignes de crédit. Le service de gestion des commandes traite les commandes et doit vérifier qu’une nouvelle commande ne dépasse pas la limite de crédit du client. Dans la version monolithique de cette application, ce service peut simplement utiliser une transaction ACID pour vérifier le crédit disponible et créer la commande.
En revanche, dans une architecture de microservices, les tables ORDER et CUSTOMER sont privées et propres à leurs services respectifs, comme l’illustre le schéma suivant.
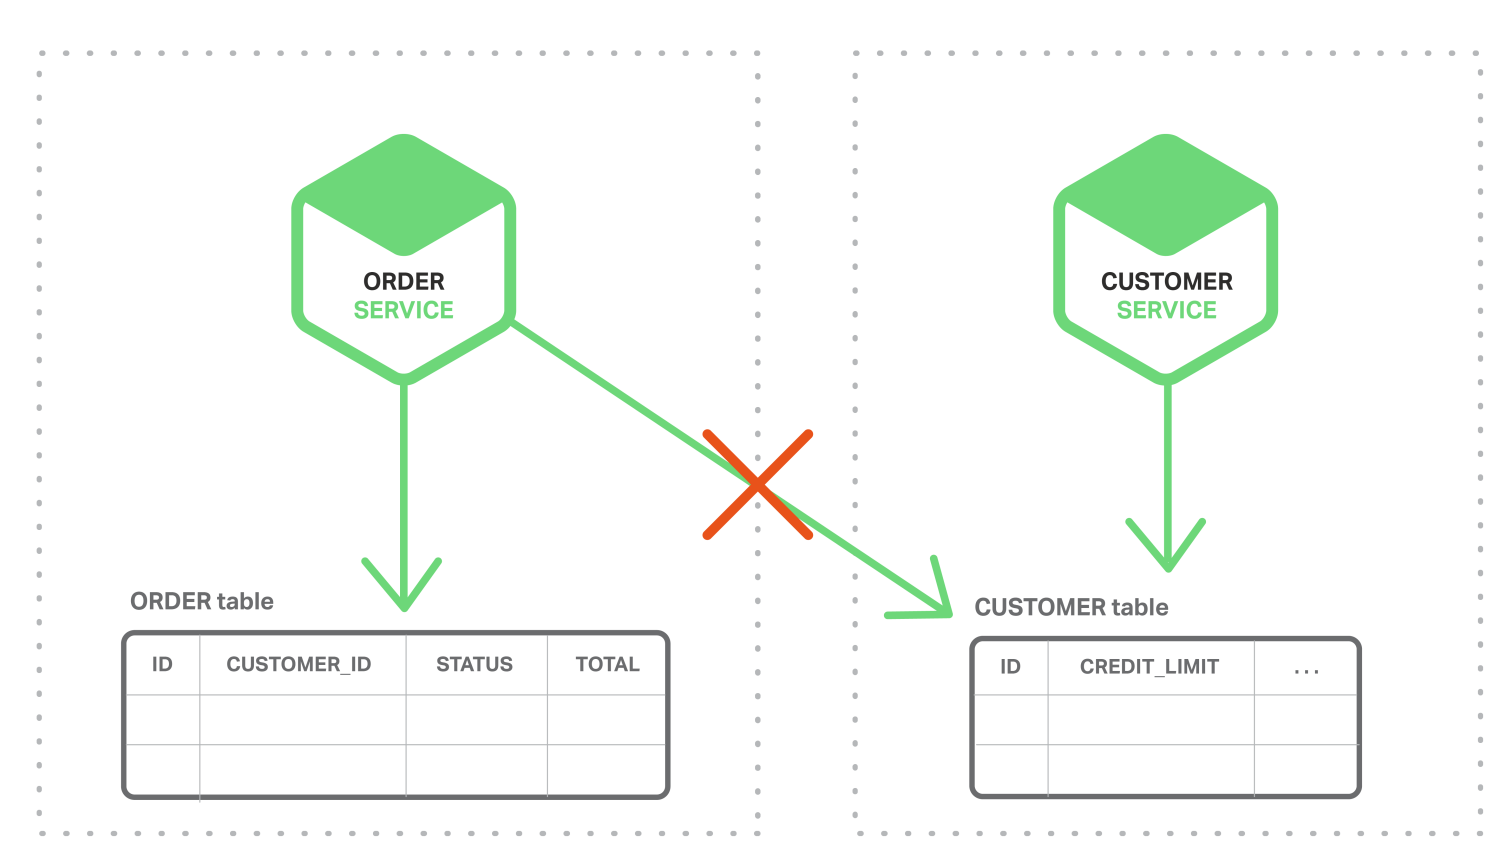
Le service de gestion des commandes ne peut pas accéder directement à la table CUSTOMER. Il peut uniquement utiliser l’API fournie par le service client. Le service de gestion des commandes pourrait éventuellement utiliser des transactions distribuées, également appelées validation en deux phases (2PC). Cependant, le protocole 2PC n’est généralement pas une option viable dans les applications modernes. Le théorème CAP impose de choisir entre la disponibilité et la cohérence de type ACID, la disponibilité étant généralement préférable. En outre, de nombreuses technologies modernes, notamment la plupart des bases de données NoSQL, ne prennent pas en charge le protocole 2PC. Il est essentiel de préserver la cohérence des données entre les services et les bases de données. Nous devons donc trouver une autre solution.
Le deuxième défi consiste à mettre en œuvre des requêtes permettant de récupérer des données auprès de plusieurs services. Imaginons, par exemple, que l’application doive afficher un client et ses commandes récentes. Si le service de gestion des commandes fournit une API permettant de récupérer les commandes d’un client, vous pouvez obtenir ces données en effectuant une jointure côté application. L’application récupère les informations du client auprès du service de gestion des clients et ses commandes auprès du service de gestion des commandes. Supposons toutefois que le service de gestion des commandes permette uniquement de rechercher les commandes à partir de leur clé primaire (peut-être utilise-t-il une base de données NoSQL qui ne prend en charge que les recherches par clé primaire). Dans ce cas, il n’existe aucun moyen évident de récupérer les données nécessaires.
Architecture événementielle
Pour de nombreuses applications, la solution consiste à utiliser une architecture pilotée par les événements. Dans cette architecture, un microservice publie un événement lorsqu’un fait notable se produit, par exemple lorsqu’il met à jour une entité métier. D’autres microservices s’abonnent à ces événements. Lorsqu’un microservice reçoit un événement, il peut mettre à jour ses propres entités métier, ce qui peut entraîner la publication d’autres événements.
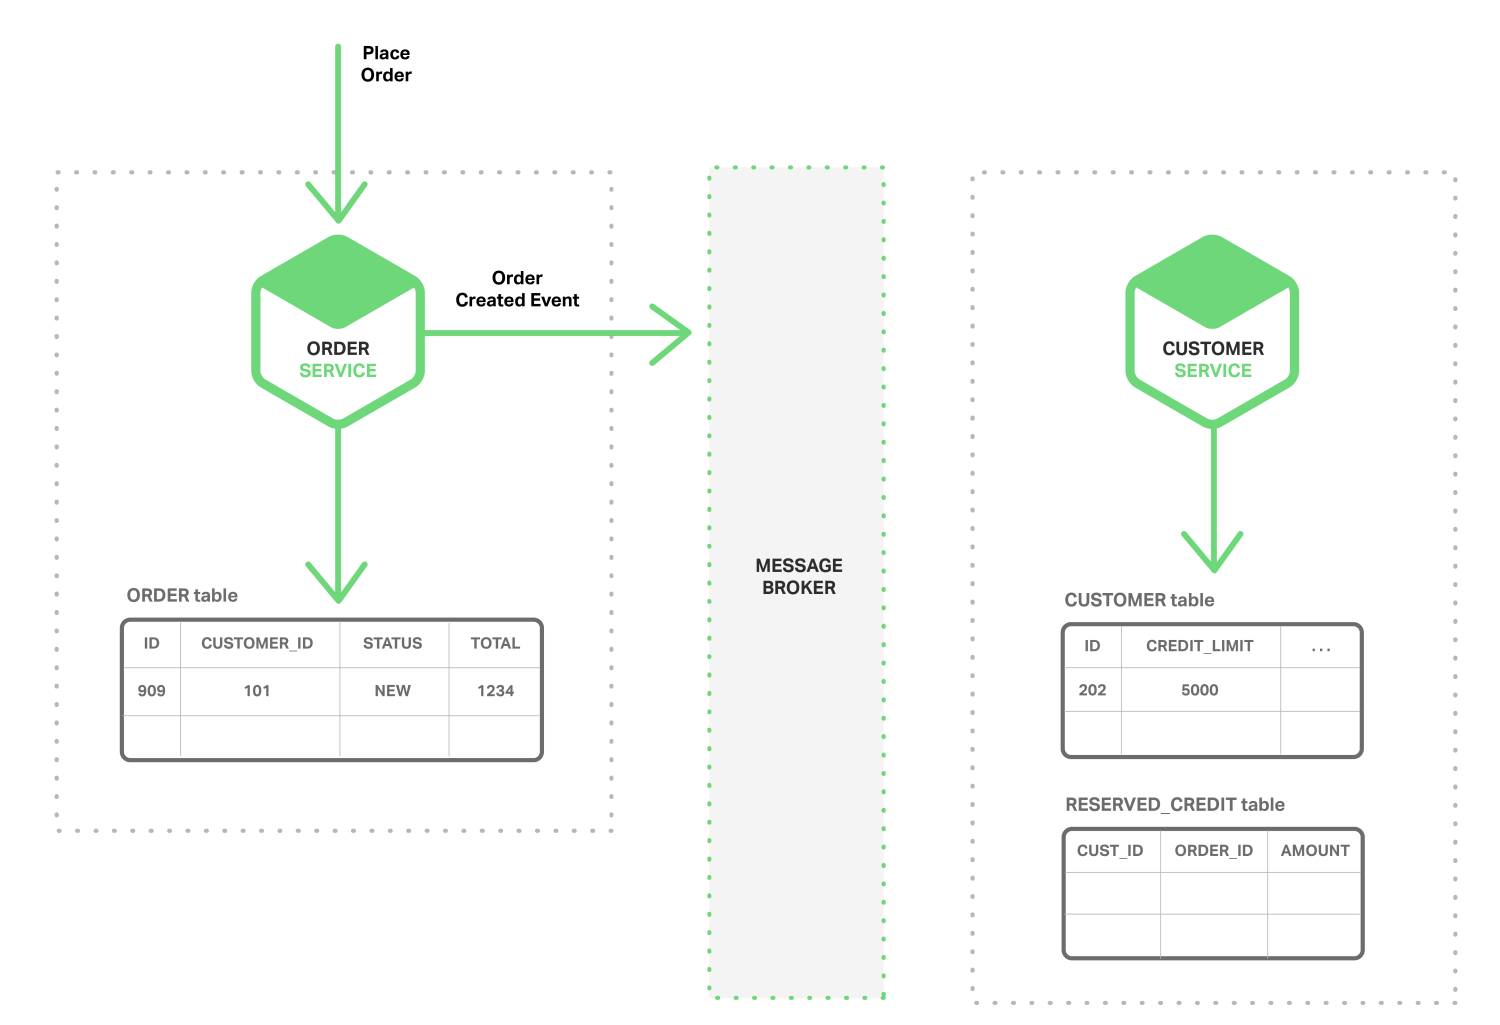
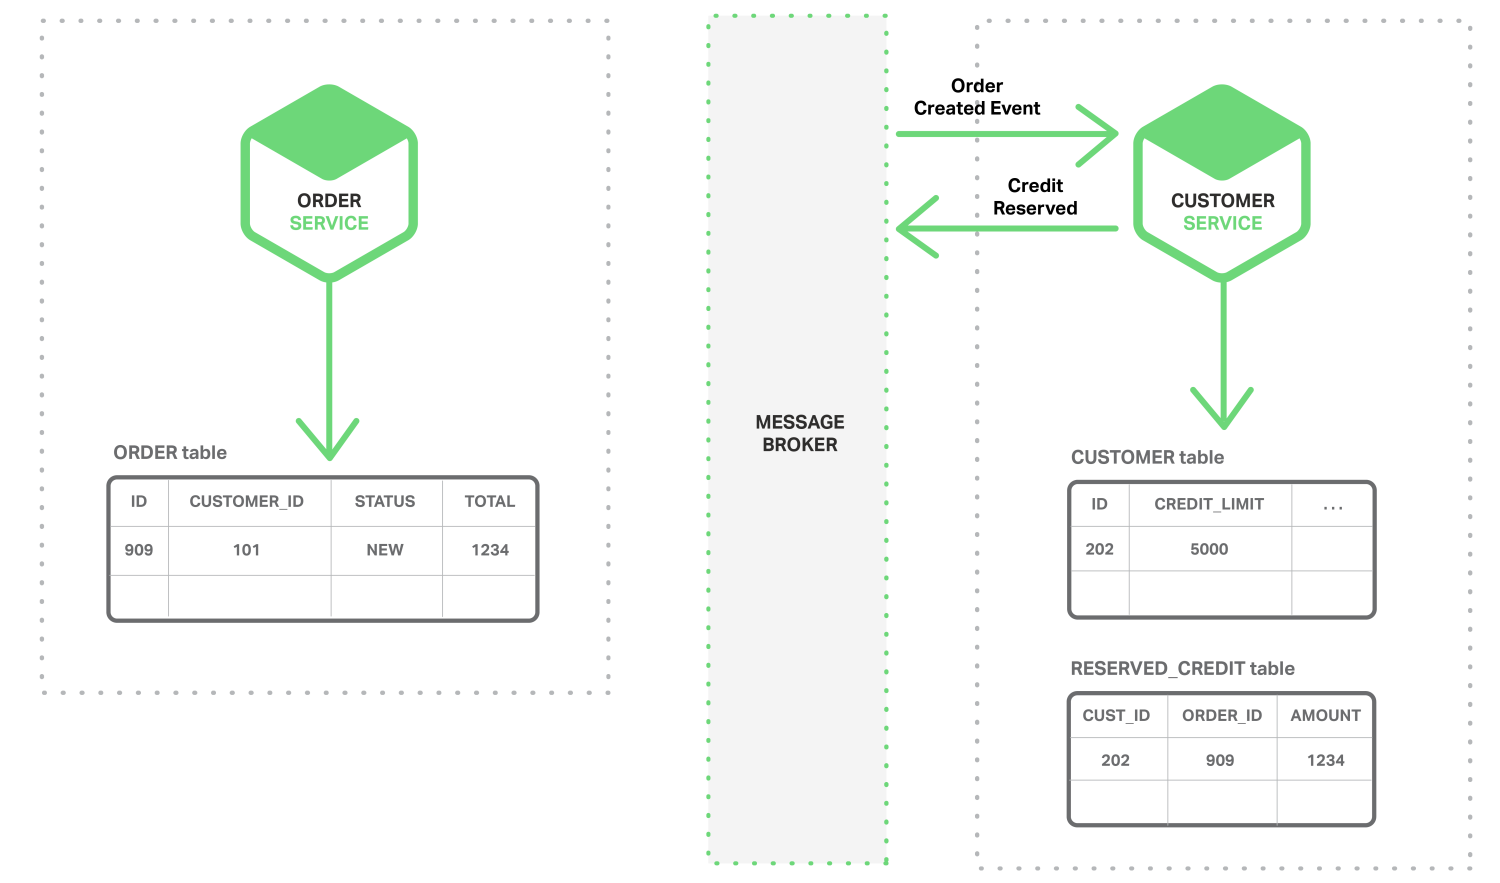
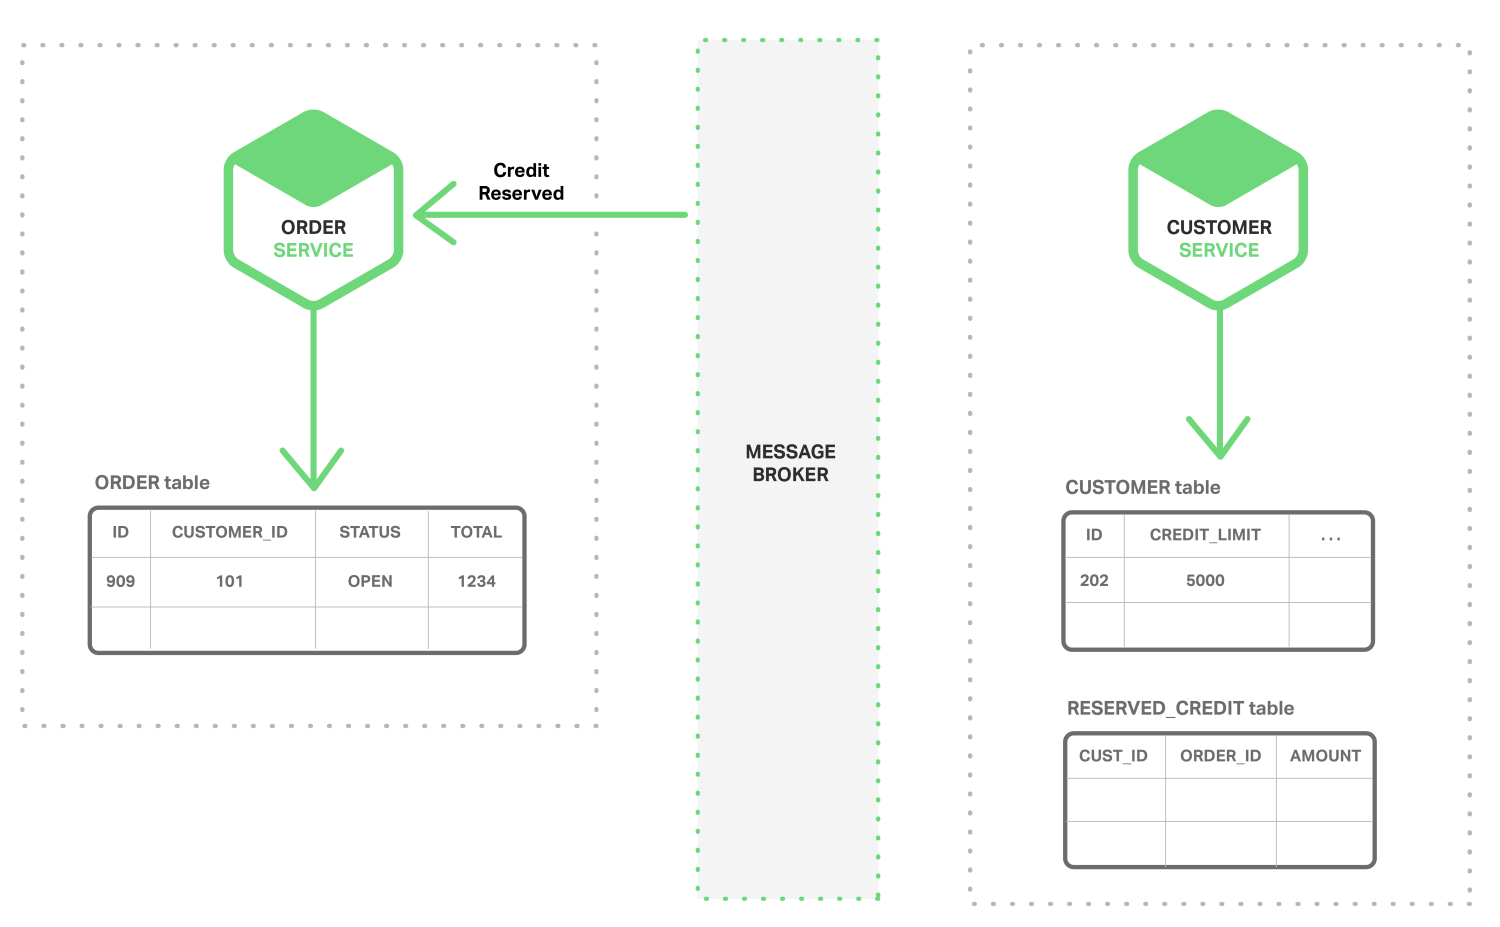
Vous pouvez utiliser des événements pour mettre en œuvre des transactions métier couvrant plusieurs services. Une transaction se compose d’une série d’étapes. À chaque étape, un microservice met à jour une entité métier et publie un événement qui déclenche l’étape suivante. La séquence de diagrammes ci-dessous montre comment utiliser une approche événementielle pour vérifier le crédit disponible lors de la création d’une commande. Les microservices échangent des événements par l’intermédiaire d’un courtier de messages.
- Le service de commande crée une commande avec le statut NEW et publie un événement « Order Created ».
- Le service client consomme l’événement « Commande créée », réserve le crédit nécessaire pour la commande et publie un événement « Crédit réservé ».
- Le service de commande consomme l’événement « Crédit réservé » et fait passer le statut de la commande à OUVERT.
Un scénario plus complexe pourrait comporter des étapes supplémentaires, comme la réservation des stocks en même temps que la vérification du crédit du client.
À condition que (a) chaque service mette à jour la base de données et publie un événement de manière atomique – nous y reviendrons plus tard – et que (b) le courtier de messages garantisse que les événements sont livrés au moins une fois, vous pouvez alors mettre en œuvre des transactions métier couvrant plusieurs services. Il est important de noter qu’il ne s’agit pas de transactions ACID. Elles offrent des garanties bien plus faibles, telles que la cohérence à terme. Ce modèle de transaction est appelé le modèle BASE.
Vous pouvez également utiliser des événements pour maintenir des vues matérialisées qui préjoignent les données détenues par plusieurs microservices. Le service chargé de maintenir la vue s’abonne aux événements pertinents et met à jour la vue. Par exemple, le service de mise à jour de la vue des commandes clients, qui maintient une vue des commandes clients, s’abonne aux événements publiés par le service client et le service de gestion des commandes.
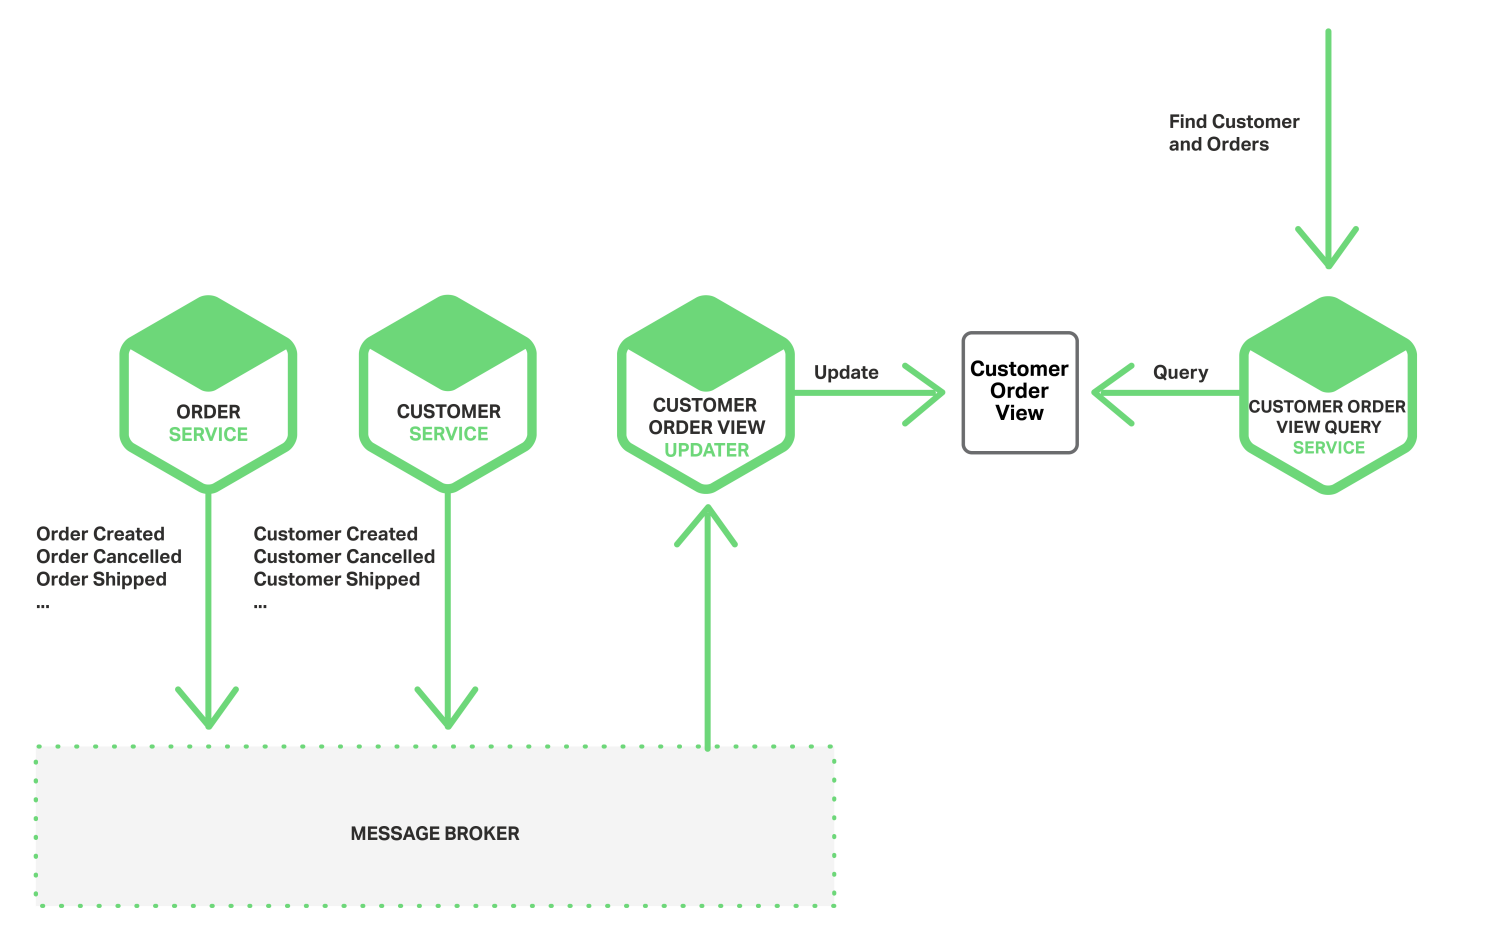
Lorsque le service de mise à jour de la vue des commandes clients reçoit un événement Customer ou Order, il met à jour le magasin de données de la vue des commandes clients. Vous pouvez implémenter cette vue à l’aide d’une base de données orientée documents telle que MongoDB et stocker un document pour chaque client. Le service d’interrogation de la vue des commandes clients traite les requêtes portant sur un client et ses commandes récentes en interrogeant le magasin de données de la vue des commandes clients.
Une architecture pilotée par les événements présente plusieurs avantages et inconvénients. Elle permet de mettre en œuvre des transactions couvrant plusieurs services et assurant une cohérence à terme. Elle permet également à une application de maintenir des vues matérialisées. En revanche, le modèle de programmation est plus complexe que celui reposant sur des transactions ACID. Il est souvent nécessaire de mettre en œuvre des transactions compensatoires pour remédier aux défaillances au niveau de l’application ; par exemple, il faut annuler une commande si la vérification de solvabilité échoue. Les applications doivent également gérer des données incohérentes, car les modifications apportées par les transactions en cours sont visibles. L’application peut aussi constater des incohérences si elle lit une vue matérialisée qui n’a pas encore été mise à jour. Autre inconvénient : les abonnés doivent détecter et ignorer les événements en double.
Garantir l’atomicité
Dans une architecture pilotée par les événements, se pose également le problème de la mise à jour atomique de la base de données et de la publication d’un événement. Par exemple, le service de gestion des commandes doit insérer une ligne dans la table ORDER et publier un événement « Commande créée ». Il est essentiel que ces deux opérations soient effectuées de manière atomique. Si le service tombe en panne après avoir mis à jour la base de données, mais avant d’avoir publié l’événement, le système devient incohérent. La méthode habituelle pour garantir l’atomicité consiste à utiliser une transaction distribuée impliquant la base de données et le courtier de messages. Toutefois, pour les raisons évoquées précédemment, telles que le théorème CAP, c’est précisément ce que nous ne voulons pas faire.
Publication d’événements à l’aide de transactions locales
Une façon de garantir l’atomicité consiste, pour l’application, à publier les événements au moyen d’un processus en plusieurs étapes faisant uniquement appel à des transactions locales. L’astuce consiste à créer, dans la base de données qui stocke l’état des entités métier, une table EVENT faisant office de file d’attente de messages. L’application démarre une transaction de base de données (locale), met à jour l’état des entités métier, insère un événement dans la table EVENT, puis valide la transaction. Un thread ou un processus distinct de l’application interroge la table EVENT, publie les événements sur le courtier de messages, puis utilise une transaction locale pour marquer les événements comme publiés. Le schéma suivant illustre cette conception.
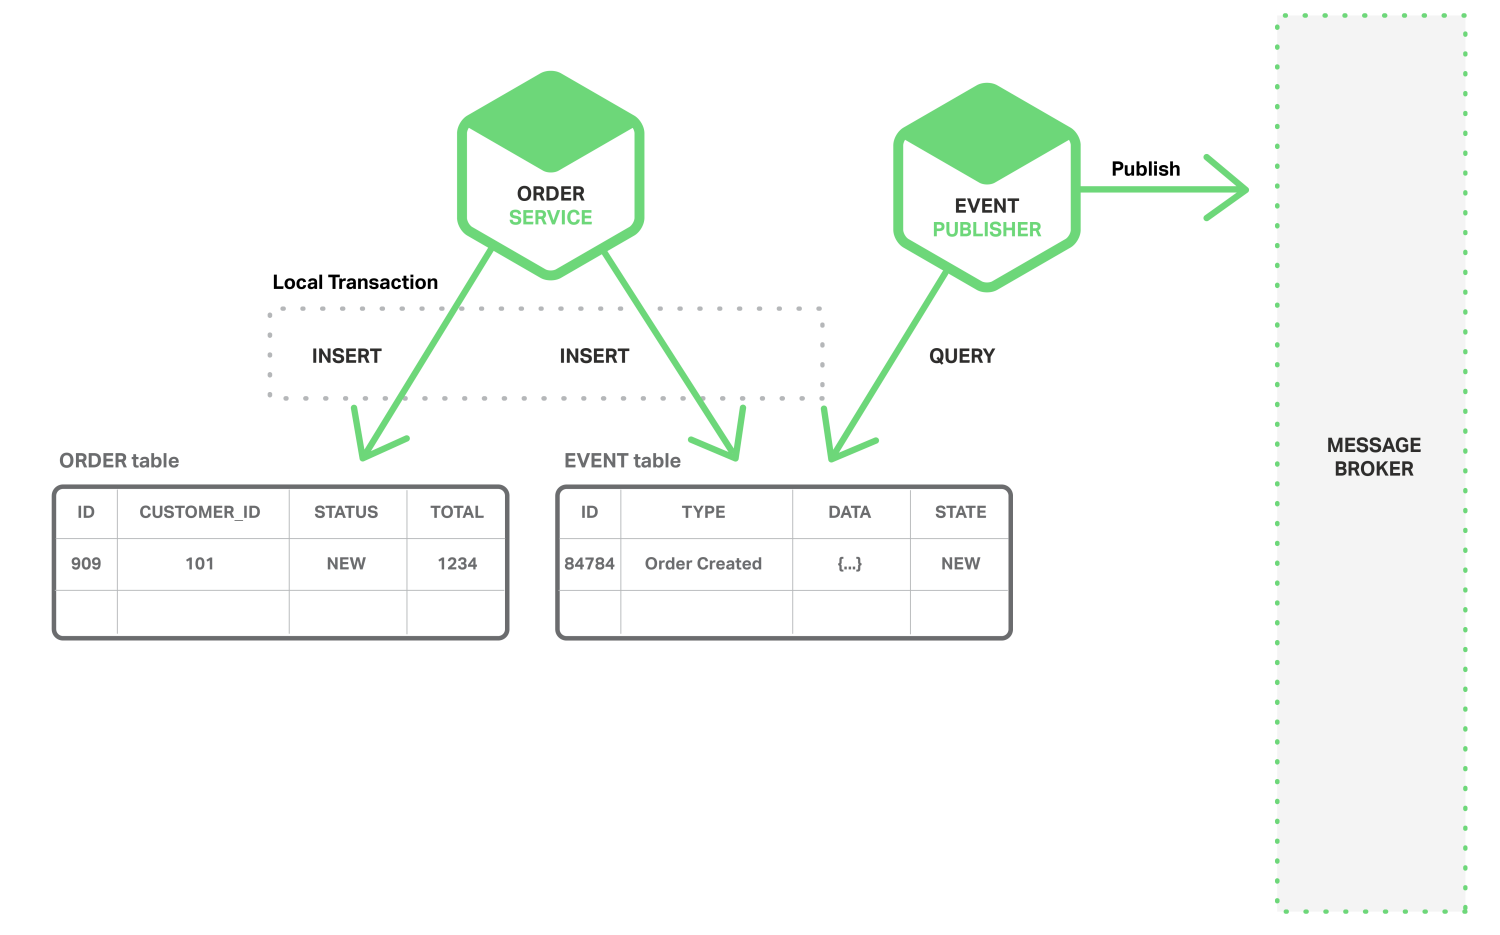
Le service de commande insère une ligne dans la table ORDER et un événement « Order Created » dans la table EVENT. Le thread ou le processus de publication des événements recherche dans la table EVENT les événements non publiés, les publie, puis met à jour la table EVENT afin de les marquer comme publiés.
Cette approche présente plusieurs avantages et inconvénients. L’un de ses avantages est qu’elle garantit la publication d’un événement pour chaque mise à jour sans recourir au 2PC. En outre, l’application publie des événements métier, ce qui évite d’avoir à les déduire. L’un des inconvénients de cette approche est qu’elle est potentiellement sujette aux erreurs, car le développeur doit penser à publier les événements. Cette approche présente également une limite : elle est difficile à mettre en œuvre avec certaines bases de données NoSQL en raison de leurs capacités limitées en matière de transactions et de requêtes.
Cette approche élimine le recours au 2PC en faisant en sorte que l’application utilise des transactions locales pour mettre à jour l’état et publier des événements. Examinons maintenant une approche qui garantit l’atomicité en demandant simplement à l’application de mettre à jour l’état.
Exploitation du journal des transactions d’une base de données
Une autre façon de garantir l’atomicité sans recourir au 2PC consiste à faire publier les événements par un thread ou un processus qui analyse le journal des transactions ou des validations de la base de données. L’application met à jour la base de données, ce qui entraîne l’enregistrement des modifications dans le journal des transactions de celle-ci. Le thread ou processus Transaction Log Miner lit le journal des transactions et publie les événements sur le Message Broker. Le schéma suivant illustre cette conception.
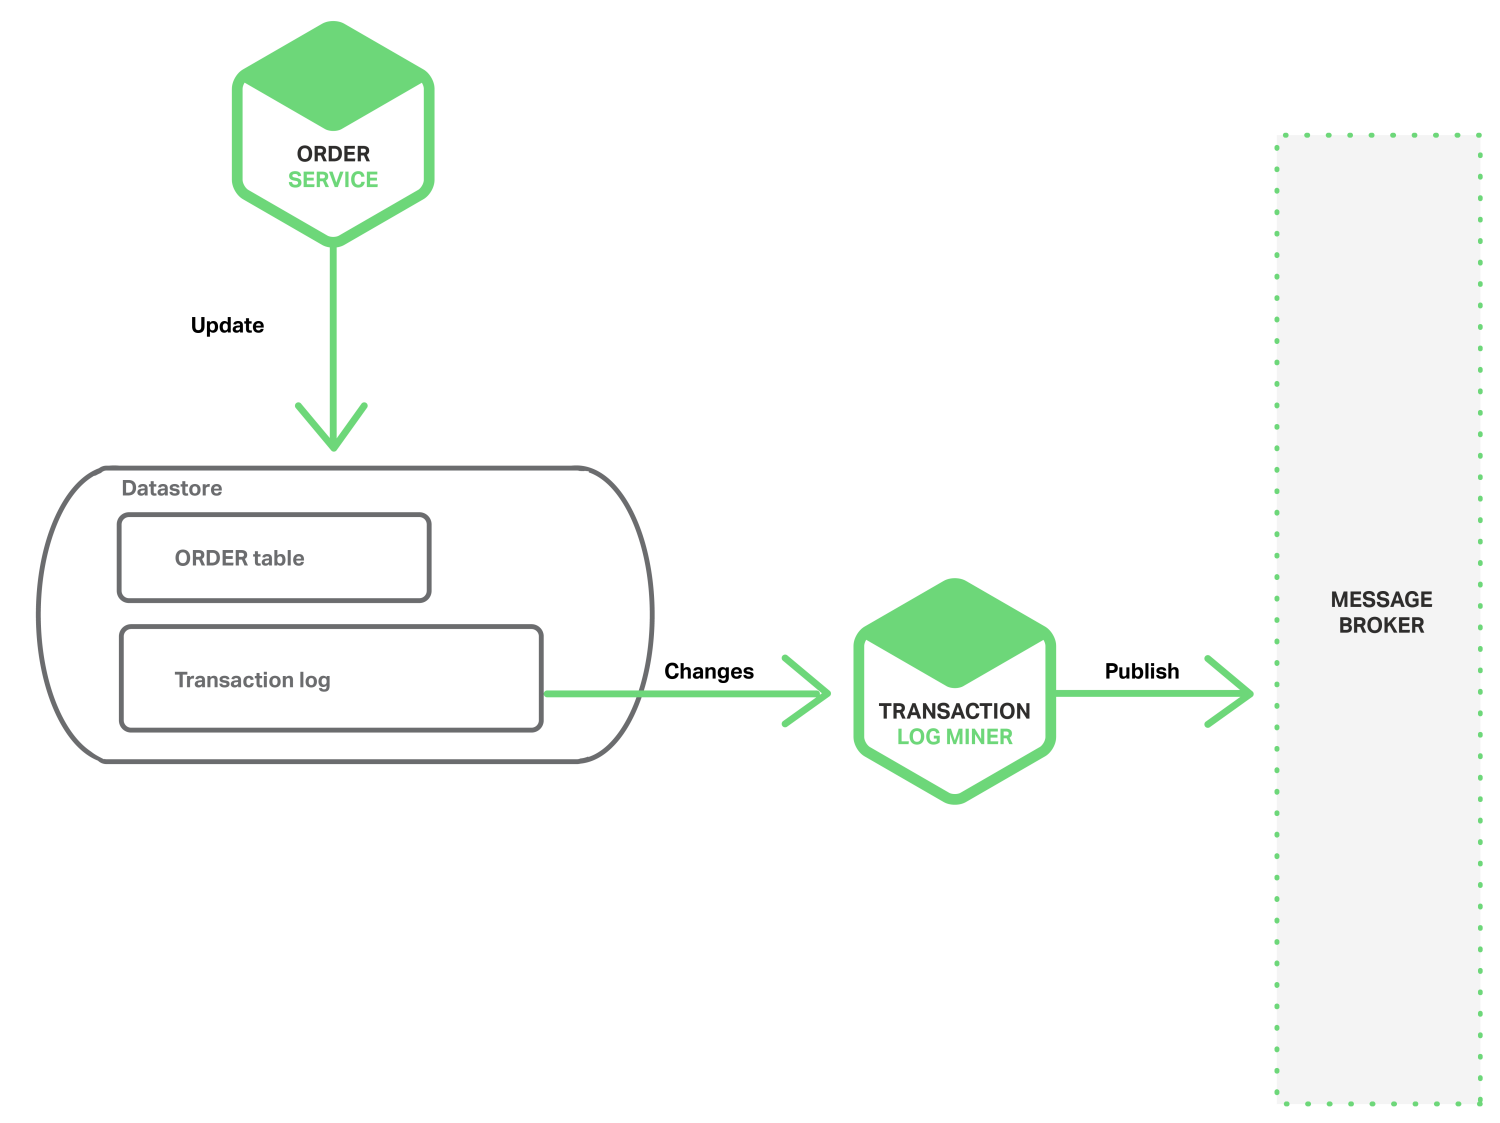
Le projet open source « LinkedIn Databus » illustre cette approche. Databus analyse le journal des transactions Oracle et publie les événements correspondant aux modifications. LinkedIn utilise Databus pour assurer la cohérence de différents magasins de données dérivées avec le système de référence.
Un autre exemple est le mécanisme de flux d’AWS DynamoDB, qui est une base de données NoSQL gérée. Un flux DynamoDB contient la séquence chronologique des modifications (opérations de création, de mise à jour et de suppression) apportées aux éléments d’une table DynamoDB au cours des dernières 24 heures. Une application peut lire ces modifications dans le flux et, par exemple, les publier sous forme d’événements.
L’exploitation du journal des transactions présente divers avantages et inconvénients. L’un de ses avantages est qu’elle garantit la publication d’un événement pour chaque mise à jour sans recourir au protocole 2PC. Elle peut également simplifier l’application en dissociant la publication des événements de la logique métier de l’application. Son principal inconvénient est que le format du journal des transactions est propre à chaque base de données et peut même varier d’une version à l’autre. En outre, il peut être difficile de reconstituer les événements métier de haut niveau à partir des mises à jour de bas niveau consignées dans le journal des transactions.
L’analyse du journal des transactions élimine le recours au 2PC en faisant en sorte que l’application n’effectue qu’une seule opération : mettre à jour la base de données. Examinons maintenant une autre approche qui supprime les mises à jour et repose uniquement sur les événements.
Utilisation de l’Event Sourcing
L’Event Sourcing garantit l’atomicité sans validation en deux phases (2PC) grâce à une approche radicalement différente, centrée sur les événements, pour assurer la persistance des entités métier. Au lieu de stocker l’état actuel d’une entité, l’application conserve une séquence d’événements modifiant son état. Elle reconstitue l’état actuel de l’entité en rejouant ces événements. Chaque fois que l’état d’une entité métier change, un nouvel événement est ajouté à la liste. Comme l’enregistrement d’un événement constitue une opération unique, il est intrinsèquement atomique.
Pour comprendre le fonctionnement de l’event sourcing, prenons l’entité Order comme exemple. Dans une approche traditionnelle, chaque commande correspond à une ligne de la table ORDER et à des lignes d’une table telle que ORDER_LINE_ITEM. En revanche, avec l’event sourcing, le service Order stocke une commande sous la forme des événements qui en modifient l’état : Created, Approved, Shipped, Cancelled. Chaque événement contient suffisamment de données pour reconstituer l’état de la commande.
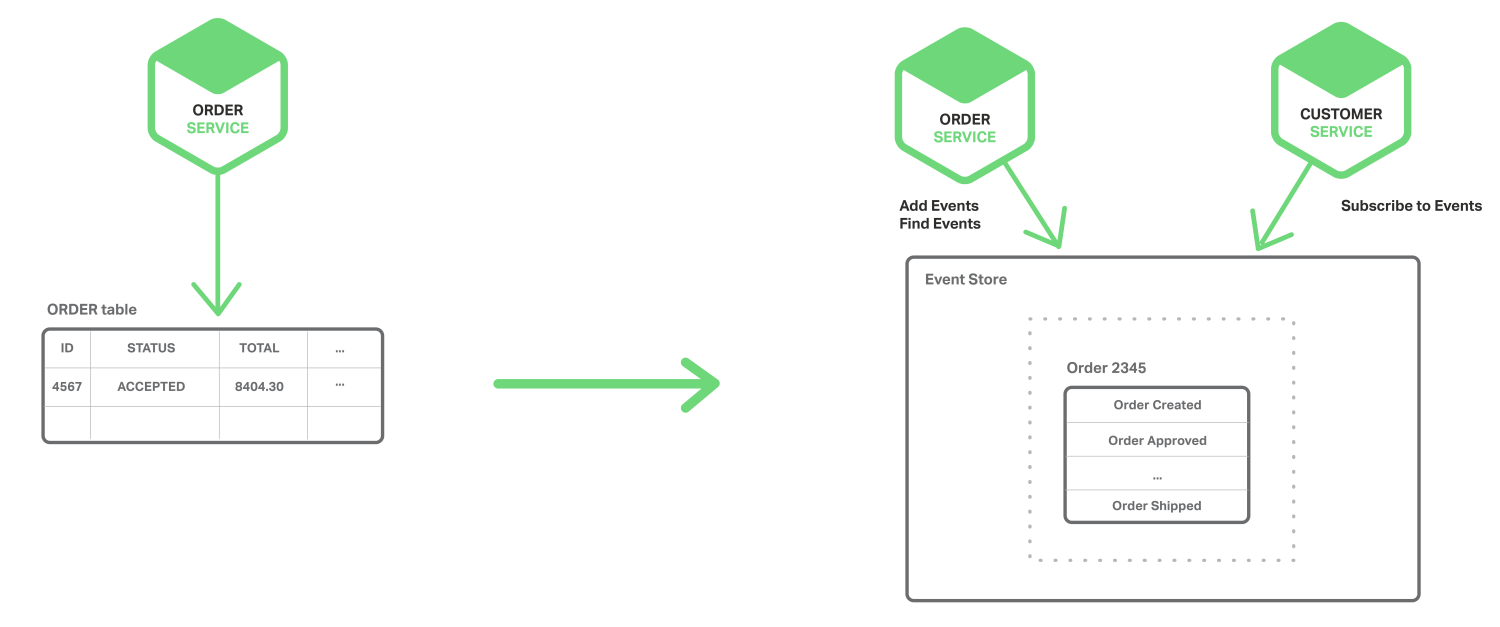
Les événements sont conservés dans un Event Store, qui est une base de données d’événements. Ce dernier dispose d’une API permettant d’ajouter et de récupérer les événements d’une entité. L’Event Store joue également le rôle du Message Broker dans les architectures décrites précédemment. Il fournit une API qui permet aux services de s’abonner aux événements. L’Event Store transmet tous les événements à l’ensemble des abonnés intéressés. Il constitue la colonne vertébrale d’une architecture de microservices pilotée par les événements.
L’event sourcing présente plusieurs avantages. Il résout l’un des principaux problèmes liés à la mise en œuvre d’une architecture pilotée par les événements et permet de publier des événements de manière fiable à chaque changement d’état. Il résout ainsi les problèmes de cohérence des données dans une architecture de microservices. De plus, comme il conserve les événements plutôt que les objets du domaine, il évite en grande partie le problème d’inadéquation objet-relationnel. L’event sourcing fournit également un journal d’audit totalement fiable des modifications apportées à une entité métier et permet de mettre en œuvre des requêtes temporelles afin de déterminer l’état d’une entité à tout moment. Un autre avantage majeur de l’event sourcing est que votre logique métier se compose d’entités métier faiblement couplées qui échangent des événements. Cela facilite considérablement la migration d’une application monolithique vers une architecture de microservices.
L’Event Sourcing présente également quelques inconvénients. Il s’agit d’un style de programmation différent et peu familier, qui nécessite donc un temps d’apprentissage. Le magasin d’événements ne permet directement de rechercher les entités métier que par leur clé primaire. Vous devez utiliser la séparation des responsabilités entre commandes et requêtes (CQRS) pour mettre en œuvre les requêtes. Par conséquent, les applications doivent gérer des données à cohérence éventuelle.
Résumé
Dans une architecture de microservices, chaque microservice dispose de son propre magasin de données privé. Différents microservices peuvent utiliser différentes bases de données SQL et NoSQL. Bien que cette architecture de bases de données présente des avantages considérables, elle pose certains défis en matière de gestion des données distribuées. Le premier consiste à mettre en œuvre des transactions métier qui garantissent la cohérence entre plusieurs services. Le second consiste à mettre en œuvre des requêtes permettant de récupérer des données provenant de plusieurs services.
Pour de nombreuses applications, la solution consiste à utiliser une architecture pilotée par les événements. L’un des défis liés à la mise en œuvre d’une telle architecture est de parvenir à mettre à jour l’état et à publier les événements de manière atomique. Plusieurs approches permettent d’y parvenir, notamment l’utilisation de la base de données comme file de messages, l’analyse du journal des transactions et l’event sourcing.
Dans de prochains articles de blog, nous continuerons à approfondir d’autres aspects des microservices.
Éditeur – Cette série de sept articles est désormais terminée :
- Introduction aux microservices
- Créer des microservices : utiliser une passerelle API
- Concevoir des microservices : communication interprocessus dans une architecture de microservices
- Découverte de services dans une architecture de microservices
- Gestion des données pilotée par les événements pour les microservices (cet article)
- Choisir une stratégie de déploiement des microservices
- Refactoriser un monolithe en microservices
Vous pouvez également télécharger l’ensemble des articles, ainsi que des informations sur la mise en œuvre de microservices avec NGINX Plus, sous forme d’ebook : « Microservices : de la conception au déploiement ». Consultez également notre série sur l’architecture de référence des microservices ainsi que notre page consacrée aux solutions de microservices.
Le blogueur invité Chris Richardson est le fondateur du site original « CloudFoundry.com », l’une des premières plateformes Java en tant que service (PaaS) pour Amazon EC2. Il conseille aujourd’hui des organisations afin d’améliorer leurs méthodes de développement et de déploiement d’applications. Il publie également régulièrement des articles sur les microservices à l’adresse http://microservices.io.
À propos de l’auteur
Articles de blog associés
Tendances actuelles des technologies cloud natives, de l’ingénierie de plateforme et de l’IA
Découvrez les principaux enseignements tirés des réponses à l’enquête annuelle F5 NGINX sur les dernières tendances en matière de technologies cloud natives, de sécurité, d’ingénierie de plateforme et d’IA.

Quels contrôleurs Ingress NGINX sont affectés par les vulnérabilités CVE-2022-4886, CVE-2023-5043 et CVE-2023-5044 ?
Lorsque de nouvelles CVE sont signalées, il est facile de ne plus savoir si elles concernent un outil de contrôleur Ingress NGINX particulier, car il existe plusieurs projets. Cet article présente les CVE et explique comment distinguer les différents projets de contrôleurs Ingress afin de dissiper toute confusion.
Votre API est-elle en temps réel ? Testez sa latence avec l’outil rtapi de NGINX
Votre API répond-elle aux requêtes en moins de 30 ms ? Si ce n’est pas le cas, il ne s’agit pas d’une API en temps réel offrant la faible latence exigée par la grande majorité des organisations. Mesurez la latence de votre API avec l’outil rtapi de NGINX et découvrez comment NGINX peut l’aider à offrir une réactivité en temps réel.
Un testeur d’expressions régulières pour NGINX et NGINX Plus
Le testeur d’expressions régulières (regex) pour NGINX et NGINX Plus vous évite de tâtonner en vous indiquant si une expression régulière utilisée dans un bloc location ou map correspond aux valeurs comme prévu. Il génère la configuration appropriée et affiche les valeurs des groupes de capture.
Caches partagés avec les clusters de cache NGINX Plus, partie 1
Optimisez la capacité de votre cache web en le répartissant entre plusieurs serveurs de cache web NGINX ou NGINX Plus. Découvrez comment procéder dans cet article.
Introduction aux microservices
Les microservices suscitent actuellement beaucoup d’intérêt. Cet article de blog est le premier d’une série de sept consacrée à la conception, au développement et au déploiement de microservices.