Éditeur – Cette série de sept articles est désormais terminée :
- Introduction aux microservices
- Créer des microservices : utiliser une passerelle API
- Créer des microservices : communication interprocessus dans une architecture de microservices
- Découverte de services dans une architecture de microservices (cet article)
- Gestion des données pilotée par les événements pour les microservices
- Choisir une stratégie de déploiement des microservices
- Refactoriser un monolithe en microservices
Vous pouvez également télécharger l’ensemble des articles, ainsi que des informations sur la mise en œuvre de microservices avec NGINX Plus, sous forme d’ebook : « Microservices : de la conception au déploiement ». Nous vous invitons également à consulter la nouvelle page consacrée aux solutions de microservices.
Voici le quatrième article de notre série consacrée au développement d’applications à l’aide de microservices. Le premier article présente le modèle d’architecture de microservices et aborde les avantages et les inconvénients de l’utilisation des microservices. Les deuxième<.htmla> et troisième articles de la série décrivent différents aspects de la communication au sein d’une architecture de microservices. Dans cet article, nous explorons la problématique étroitement liée de la découverte de services.
Pourquoi utiliser la découverte de services ?
Imaginons que vous écriviez du code qui appelle un service doté d’une API REST ou Thrift. Pour effectuer une requête, votre code doit connaître l’emplacement réseau (adresse IP et port) d’une instance du service. Dans une application traditionnelle exécutée sur du matériel physique, les emplacements réseau des instances de service sont relativement statiques. Par exemple, votre code peut lire ces emplacements dans un fichier de configuration mis à jour occasionnellement.
Cependant, dans une application moderne de microservices basée sur le cloud, ce problème est bien plus difficile à résoudre, comme l’illustre le schéma suivant.
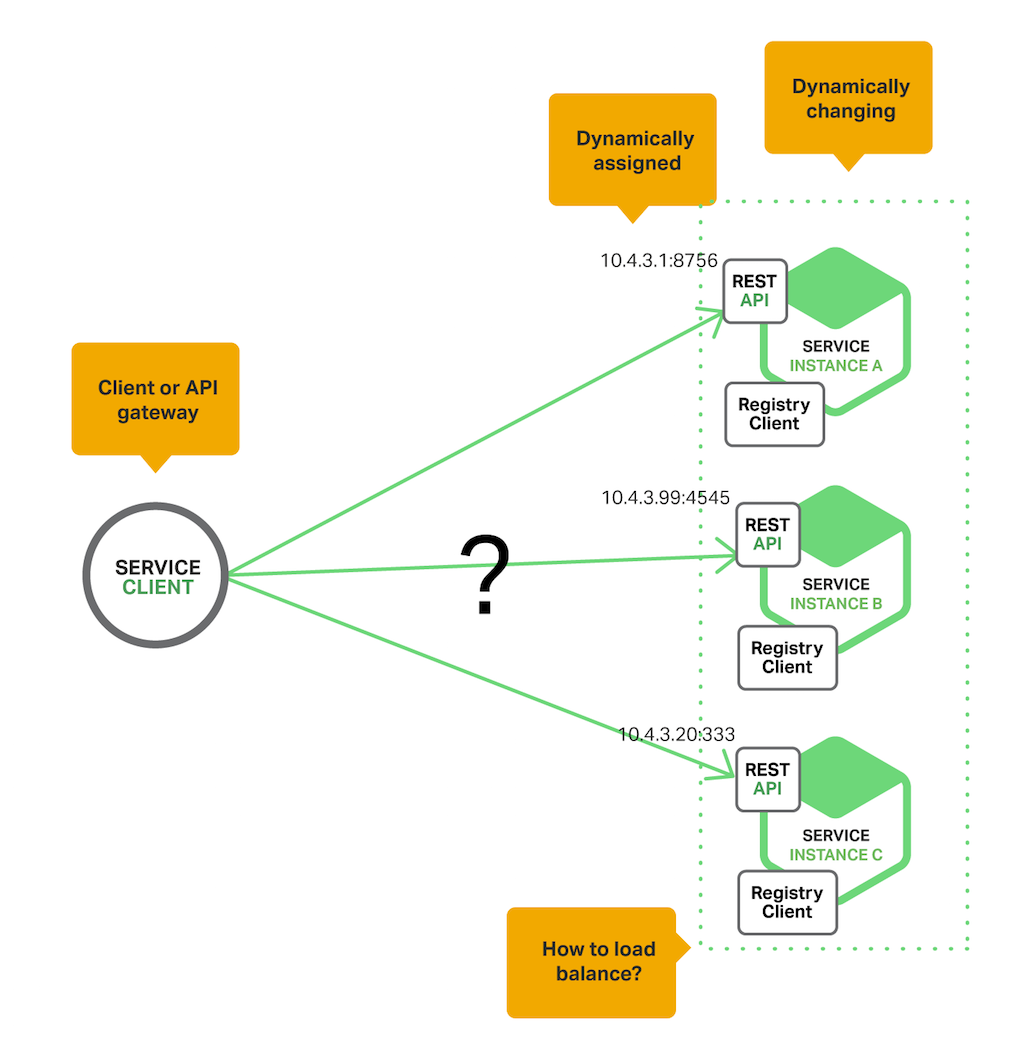
Les emplacements réseau des instances de service sont attribués dynamiquement. De plus, l’ensemble des instances de service évolue de manière dynamique en raison de la mise à l’échelle automatique, des défaillances et des mises à niveau. Par conséquent, votre code client doit utiliser un mécanisme de découverte de services plus élaboré.
Il existe deux principaux modèles de découverte de services : la découverte côté client et la découverte côté serveur. Examinons d’abord la découverte côté client.
Le modèle de découverte côté client
Lors de l’utilisation de la découverte côté client, le client est chargé de déterminer les emplacements réseau des instances de service disponibles et de répartir les requêtes entre elles. Il interroge un registre de services, qui est une base de données répertoriant les instances de service disponibles. Il utilise ensuite un algorithme d’équilibrage de charge pour sélectionner l’une de ces instances et lui envoyer une requête.
Le schéma suivant illustre la structure de ce modèle.
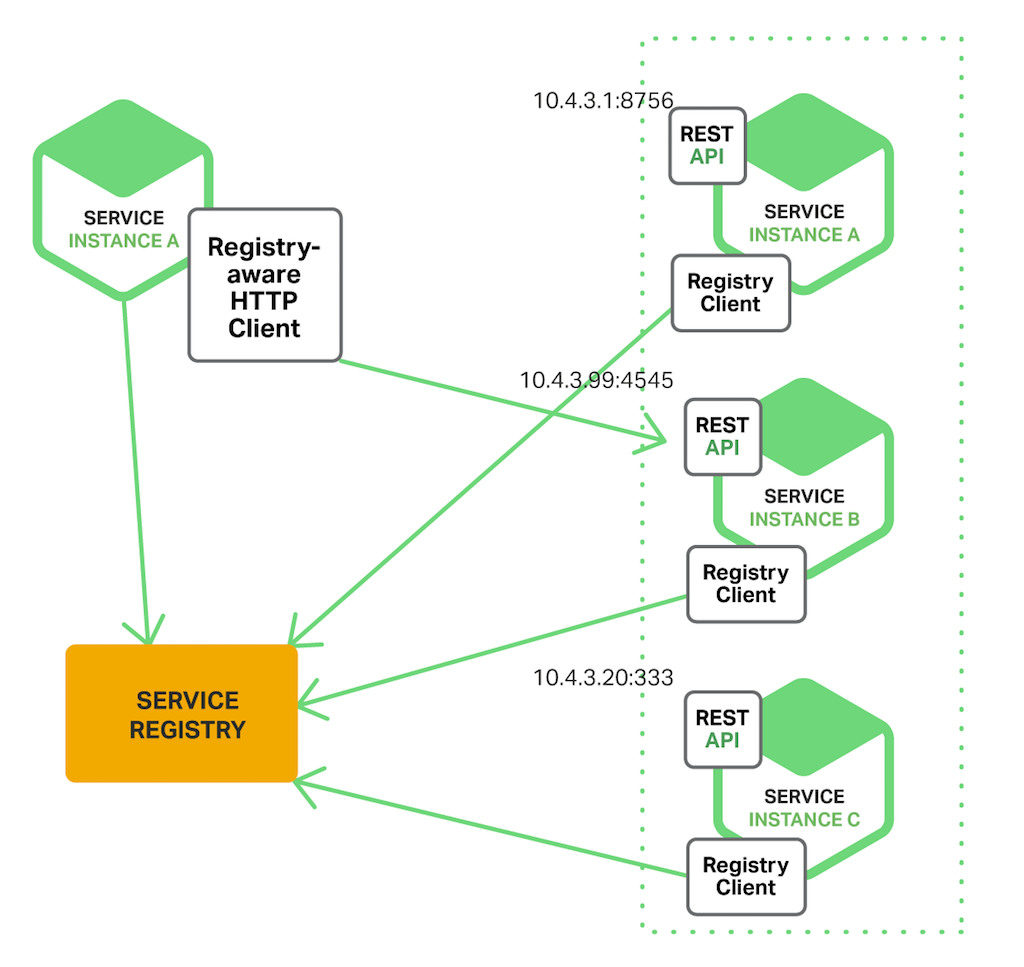
L’emplacement réseau d’une instance de service est enregistré dans le registre de services lors de son démarrage. Il en est supprimé lorsque l’instance s’arrête. L’enregistrement de l’instance de service est généralement actualisé périodiquement à l’aide d’un mécanisme de pulsation.
Netflix OSS constitue un excellent exemple du modèle de découverte côté client. Netflix Eureka est un registre de services. Il fournit une API REST permettant de gérer l’enregistrement des instances de service et d’interroger les instances disponibles. Netflix Ribbon est un client IPC qui fonctionne avec Eureka afin de répartir la charge des requêtes entre les instances de service disponibles. Nous aborderons Eureka plus en détail dans la suite de cet article.
Le modèle de découverte côté client présente divers avantages et inconvénients. Ce modèle est relativement simple et, hormis le registre de services, ne comporte aucun autre composant. De plus, comme le client connaît les instances de service disponibles, il peut prendre des décisions intelligentes d’équilibrage de charge propres à l’application, par exemple en utilisant un hachage cohérent. L’un des principaux inconvénients de ce modèle est qu’il crée un couplage entre le client et le registre de services. Vous devez implémenter une logique de découverte de services côté client pour chaque langage de programmation et chaque framework utilisés par vos clients de service.
Maintenant que nous avons examiné la découverte côté client, intéressons-nous à la découverte côté serveur.
Le modèle de découverte côté serveur
L’autre approche de la découverte de services est le « modèle de découverte côté serveur ». Le schéma suivant illustre la structure de ce modèle.
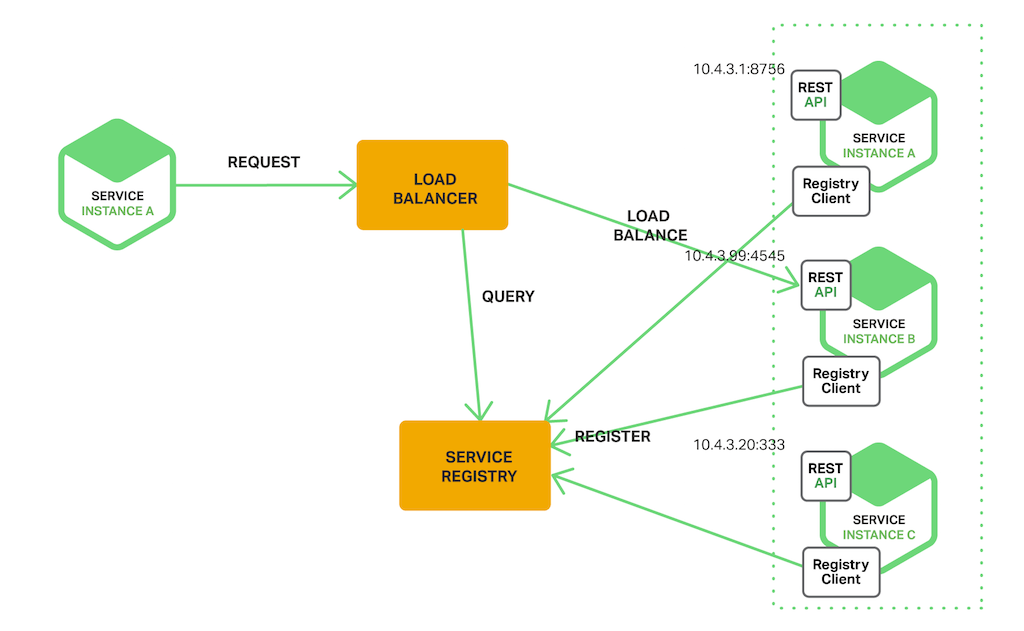
Le client envoie une requête à un service par l’intermédiaire d’un répartiteur de charge. Celui-ci interroge le registre des services et achemine chaque requête vers une instance de service disponible. Comme pour la découverte côté client, les instances de service sont enregistrées dans le registre des services et en sont retirées.
L’AWS Elastic Load Balancer (ELB) est un exemple de routeur de découverte côté serveur. Un ELB est couramment utilisé pour répartir le trafic externe provenant d’Internet. Toutefois, vous pouvez également utiliser un ELB pour répartir le trafic interne à un cloud privé virtuel (VPC). Un client envoie des requêtes (HTTP ou TCP) via l’ELB en utilisant son nom DNS. L’ELB répartit le trafic entre un ensemble d’instances Elastic Compute Cloud (EC2) ou de conteneurs EC2 Container Service (ECS) enregistrés. Il n’existe pas de registre de services distinct. Les instances EC2 et les conteneurs ECS sont enregistrés directement auprès de l’ELB.
Les serveurs HTTP et les répartiteurs de charge tels que NGINX Plus et NGINX peuvent également être utilisés comme répartiteurs de charge pour la découverte côté serveur. Par exemple, cet article de blog explique comment utiliser Consul Template pour reconfigurer dynamiquement le proxy inverse de NGINX. Consul Template est un outil qui régénère périodiquement des fichiers de configuration arbitraires à partir des données de configuration stockées dans le registre de services Consul. Il exécute une commande shell arbitraire chaque fois que les fichiers sont modifiés. Dans l’exemple décrit dans l’article de blog, Consul Template génère un fichier nginx.conf, qui configure le proxy inverse, puis exécute une commande demandant à NGINX de recharger la configuration. Une implémentation plus sophistiquée pourrait reconfigurer dynamiquement NGINX Plus à l’aide de son API HTTP ou de DNS.
Certains environnements de déploiement tels que Kubernetes et Marathon exécutent un proxy sur chaque hôte du cluster. Ce proxy joue le rôle d’un équilibreur de charge avec découverte côté serveur. Pour envoyer une requête à un service, un client l’achemine via le proxy en utilisant l’adresse IP de l’hôte et le port attribué au service. Le proxy transmet ensuite la requête de manière transparente à une instance disponible du service s’exécutant quelque part dans le cluster.
Le modèle de découverte côté serveur présente plusieurs avantages et inconvénients. L’un de ses principaux avantages est que les détails de la découverte sont masqués au client. Les clients se contentent d’envoyer des requêtes à l’équilibreur de charge. Il n’est donc plus nécessaire d’implémenter une logique de découverte pour chaque langage de programmation et chaque framework utilisés par les clients de vos services. De plus, comme indiqué précédemment, certains environnements de déploiement fournissent gratuitement cette fonctionnalité. Ce modèle présente toutefois aussi quelques inconvénients. À moins que l’équilibreur de charge ne soit fourni par l’environnement de déploiement, il constitue un composant système hautement disponible supplémentaire que vous devez configurer et gérer.
Le registre de services
Le registre de services est un élément clé de la découverte de services. Il s’agit d’une base de données contenant les emplacements réseau des instances de service. Un registre de services doit être hautement disponible et à jour. Les clients peuvent mettre en cache les emplacements réseau obtenus auprès du registre de services. Toutefois, ces informations finissent par devenir obsolètes, empêchant les clients de découvrir les instances de service. Par conséquent, un registre de services se compose d’un cluster de serveurs qui utilisent un protocole de réplication pour assurer la cohérence.
Comme indiqué précédemment, Netflix Eureka est un bon exemple de registre de services. Il fournit une API REST permettant d’enregistrer et d’interroger les instances de service. Une instance de service enregistre son emplacement réseau à l’aide d’une requête POST. Toutes les 30 secondes, elle doit actualiser son enregistrement à l’aide d’une requête PUT. Un enregistrement est supprimé soit au moyen d’une requête HTTP DELETE, soit à l’expiration du délai d’enregistrement de l’instance. Comme on peut s’y attendre, un client peut récupérer les instances de service enregistrées à l’aide d’une requête HTTP GET.
Netflix assure une haute disponibilité en exécutant un ou plusieurs serveurs Eureka dans chaque zone de disponibilité Amazon EC2. Chaque serveur Eureka s’exécute sur une instance EC2 disposant d’une adresse IP Elastic. Les enregistrements DNS TEXT servent à stocker la configuration du cluster Eureka, qui associe chaque zone de disponibilité à une liste d’emplacements réseau de serveurs Eureka. Lorsqu’un serveur Eureka démarre, il interroge le DNS pour récupérer la configuration du cluster Eureka, localise ses pairs et s’attribue une adresse IP Elastic inutilisée.
Les clients Eureka – services et clients de services – interrogent le DNS pour découvrir les emplacements réseau des serveurs Eureka. Ils utilisent de préférence un serveur Eureka situé dans la même zone de disponibilité. Toutefois, si aucun n’est disponible, le client utilise un serveur Eureka situé dans une autre zone de disponibilité.
Voici d’autres exemples de registres de services :
- etcd – Un magasin clé-valeur distribué, cohérent et hautement disponible, utilisé pour la configuration partagée et la découverte de services. Kubernetes et Cloud Foundry sont deux projets notables qui utilisent etcd.
- consul – Un outil permettant de découvrir et de configurer des services. Il fournit une API qui permet aux clients d’enregistrer et de découvrir des services. Consul peut effectuer des contrôles d’intégrité afin de déterminer la disponibilité des services.
- Apache Zookeeper – Un service de coordination hautes performances largement utilisé pour les applications distribuées. Apache Zookeeper était à l’origine un sous-projet de Hadoop, mais constitue désormais un projet de premier niveau.
De plus, comme indiqué précédemment, certains systèmes tels que Kubernetes, Marathon et AWS ne disposent pas d’un registre de services explicite. Le registre de services fait simplement partie intégrante de l’infrastructure.
Maintenant que nous avons examiné le concept de registre de services, voyons comment les instances de service y sont enregistrées.
Options d’enregistrement des services
Comme indiqué précédemment, les instances de service doivent être inscrites dans le registre de services et en être désinscrites. Il existe plusieurs façons de gérer leur inscription et leur désinscription. Une possibilité consiste à laisser les instances de service s’inscrire elles-mêmes : il s’agit du modèle d’auto-inscription. Une autre possibilité consiste à confier la gestion de l’inscription des instances de service à un autre composant du système : il s’agit du modèle d’inscription par un tiers. Examinons d’abord le modèle d’auto-inscription.
Le modèle d’auto-enregistrement
Lors de l’utilisation du « modèle d’auto-enregistrement », une instance de service est chargée de s’enregistrer auprès du registre de services et de s’en désinscrire. Si nécessaire, elle envoie également des requêtes de pulsation afin d’éviter l’expiration de son enregistrement. Le schéma suivant illustre la structure de ce modèle.
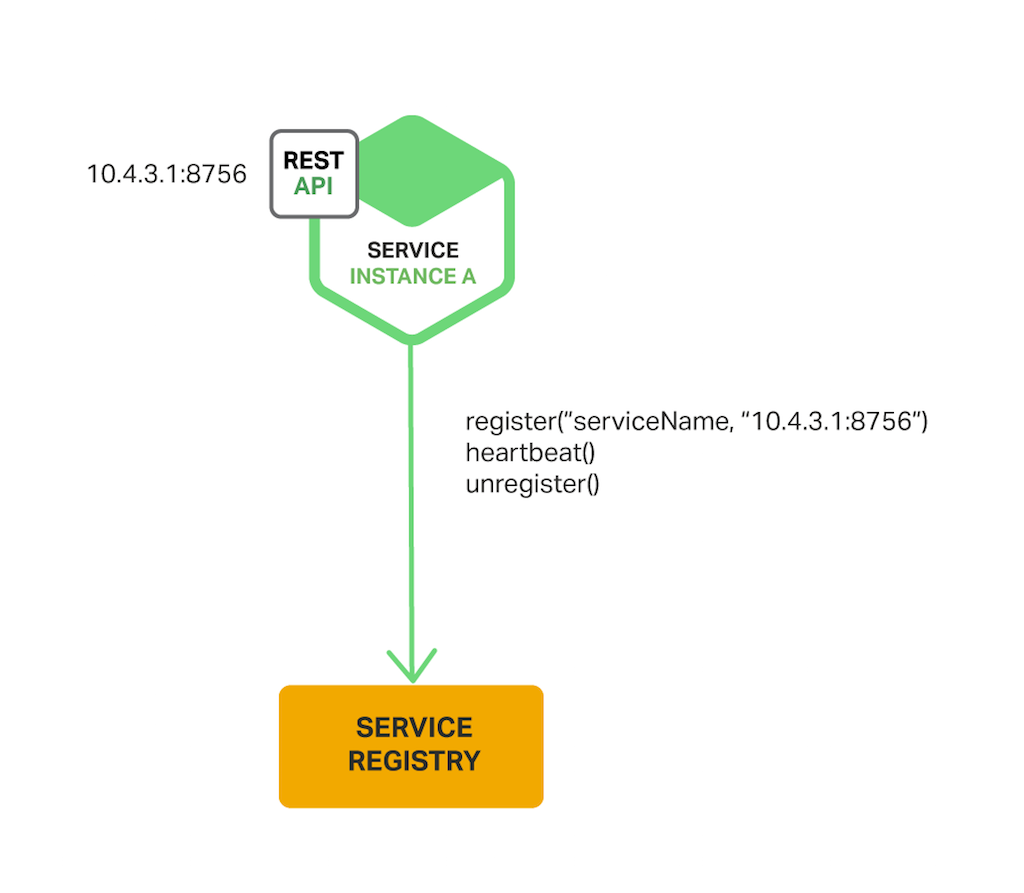
Le client Eureka de Netflix OSS est un bon exemple de cette approche. Le client Eureka gère tous les aspects de l’enregistrement et du désenregistrement des instances de service. Le projet Spring Cloud, qui met en œuvre différents modèles, notamment la découverte de services, permet d’enregistrer facilement et automatiquement une instance de service auprès d’Eureka. Il vous suffit d’ajouter l’annotation @EnableEurekaClient à votre classe de configuration Java.
Le modèle d’auto-enregistrement présente divers avantages et inconvénients. L’un de ses avantages est qu’il est relativement simple et ne nécessite aucun autre composant système. Toutefois, son principal inconvénient est qu’il crée un couplage entre les instances de service et le registre de services. Vous devez implémenter le code d’enregistrement dans chaque langage de programmation et framework utilisés par vos services.
L’approche alternative, qui découple les services du registre de services, est le modèle d’enregistrement par un tiers.
Le modèle d’enregistrement par un tiers
Lors de l’utilisation du modèle d’enregistrement par un tiers, les instances de service ne sont pas chargées de s’enregistrer elles-mêmes auprès du registre de services. Cette tâche est assurée par un autre composant du système, appelé service d’enregistrement (« service registrar »). Celui-ci suit l’évolution de l’ensemble des instances en cours d’exécution, soit en interrogeant régulièrement l’environnement de déploiement, soit en s’abonnant à des événements. Lorsqu’il détecte une nouvelle instance de service disponible, il l’enregistre auprès du registre de services. Il désenregistre également les instances de service arrêtées. Le schéma suivant illustre la structure de ce modèle.
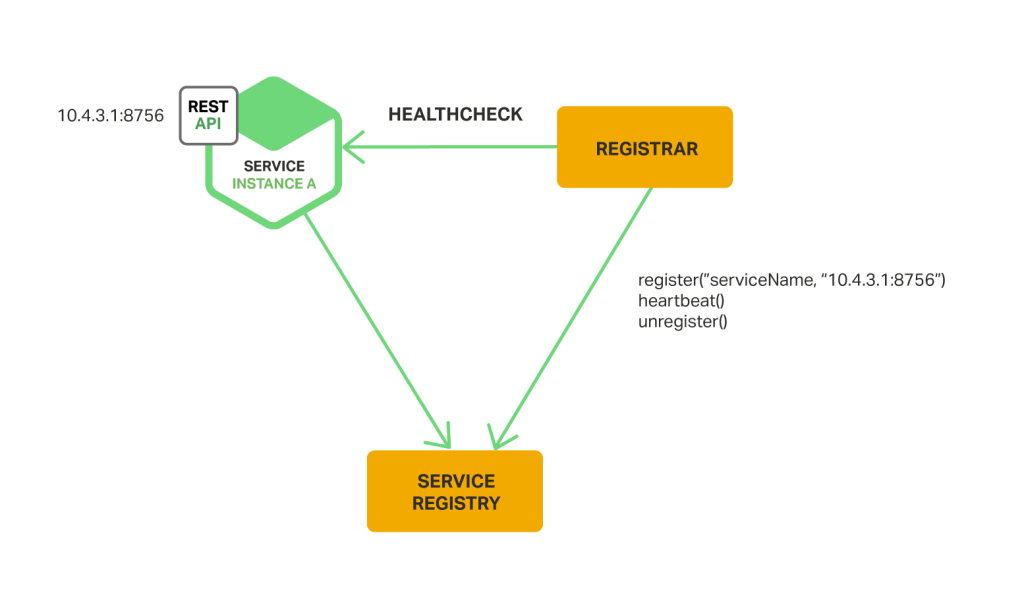
Le projet open source Registrator est un exemple de registre de services. Il enregistre et désenregistre automatiquement les instances de service déployées sous forme de conteneurs Docker. Registrator prend en charge plusieurs annuaires de services, notamment etcd et Consul.
Un autre exemple de registre de services est NetflixOSS Prana. Principalement destinée aux services écrits dans des langages non-JVM, cette application side-car s’exécute aux côtés d’une instance de service. Prana enregistre et désenregistre l’instance de service auprès de Netflix Eureka.
Le registre de services est un composant intégré aux environnements de déploiement. Les instances EC2 créées par un groupe Auto Scaling peuvent être automatiquement enregistrées auprès d’un ELB. Les services Kubernetes sont automatiquement enregistrés et rendus disponibles pour la découverte.
Le modèle d’enregistrement par un tiers présente divers avantages et inconvénients. L’un de ses principaux avantages est que les services sont découplés du registre de services. Vous n’avez pas besoin d’implémenter une logique d’enregistrement des services pour chaque langage de programmation et framework utilisés par vos développeurs. L’enregistrement des instances de service est au contraire géré de manière centralisée au sein d’un service dédié.
L’un des inconvénients de ce modèle est que, s’il n’est pas intégré à l’environnement de déploiement, il constitue un composant système hautement disponible supplémentaire que vous devez configurer et gérer.
Résumé
Dans une application de microservices, l’ensemble des instances de service en cours d’exécution évolue de manière dynamique. Les emplacements réseau des instances sont attribués dynamiquement. Par conséquent, pour qu’un client puisse envoyer une requête à un service, il doit utiliser un mécanisme de découverte de services.
Un élément clé de la découverte de services est le registre de services. Le registre de services est une base de données répertoriant les instances de service disponibles. Il fournit une API de gestion et une API de requête. Les instances de service sont enregistrées dans le registre de services et désenregistrées de celui-ci à l’aide de l’API de gestion. L’API de requête est utilisée par les composants du système pour découvrir les instances de service disponibles.
Il existe deux principaux modèles de découverte de services : la découverte côté client et la découverte côté serveur. Dans les systèmes qui utilisent la découverte de services côté client, les clients interrogent le registre de services, sélectionnent une instance disponible et lui envoient une requête. Dans les systèmes qui utilisent la découverte côté serveur, les clients envoient leurs requêtes via un routeur, qui interroge le registre de services et transmet la requête à une instance disponible.
Il existe deux principales façons d’inscrire les instances de service dans le registre de services et de les en retirer. La première consiste à laisser les instances de service s’inscrire elles-mêmes dans le registre de services selon le modèle d’auto-inscription. L’autre consiste à confier à un autre composant du système la gestion de l’inscription et du retrait pour le compte du service selon le modèle d’inscription par un tiers.
Dans certains environnements de déploiement, vous devez mettre en place votre propre infrastructure de découverte de services à l’aide d’un registre de services tel que Netflix Eureka, etcd ou Apache Zookeeper. Dans d’autres environnements de déploiement, la découverte de services est intégrée. Par exemple, Kubernetes et Marathon gèrent l’enregistrement et la désinscription des instances de service. Ils exécutent également un proxy sur chaque hôte du cluster, qui joue le rôle de routeur de découverte côté serveur.
Un proxy inverse HTTP et équilibreur de charge tel que NGINX peut également être utilisé comme équilibreur de charge pour la découverte côté serveur. Le registre de services peut transmettre les informations de routage à NGINX et déclencher une mise à jour transparente de la configuration ; par exemple, vous pouvez utiliser Consul Template. NGINX Plus prend en charge des mécanismes supplémentaires de reconfiguration dynamique – il peut récupérer les informations sur les instances de service depuis le registre à l’aide du DNS et fournit une API permettant la reconfiguration à distance.
Dans de prochains articles de blog, nous continuerons à explorer d’autres aspects des microservices. Inscrivez-vous à la liste de diffusion de NGINX (le formulaire se trouve ci-dessous) pour être informé de la publication des prochains articles de la série.
Éditeur – Cette série de sept articles est désormais terminée :
- Introduction aux microservices
- Créer des microservices : utiliser une passerelle API
- Concevoir des microservices : communication interprocessus dans une architecture de microservices
- Découverte de services dans une architecture de microservices (cet article)
- Gestion des données pilotée par les événements pour les microservices
- Choisir une stratégie de déploiement des microservices
- Refactoriser un monolithe en microservices
Vous pouvez également télécharger l’ensemble des articles, ainsi que des informations sur la mise en œuvre de microservices avec NGINX Plus, sous forme d’ebook : « Microservices : de la conception au déploiement ».
Le blogueur invité Chris Richardson est le fondateur du premier CloudFoundry.com, l’une des premières plateformes Java PaaS (Platform as a Service) pour Amazon EC2. Il conseille aujourd’hui des organisations afin d’améliorer leurs méthodes de développement et de déploiement d’applications. Il publie également régulièrement des articles sur les microservices à l’adresse https://microservices.io.
À propos de l’auteur
Articles de blog associés

Tendances actuelles des technologies cloud natives, de l’ingénierie de plateforme et de l’IA
Découvrez les principaux enseignements tirés des réponses à l’enquête annuelle F5 NGINX sur les dernières tendances en matière de technologies cloud natives, de sécurité, d’ingénierie de plateforme et d’IA.

Quels contrôleurs Ingress NGINX sont affectés par les vulnérabilités CVE-2022-4886, CVE-2023-5043 et CVE-2023-5044 ?
Lorsque de nouvelles CVE sont signalées, il est facile de ne plus savoir si elles concernent un outil de contrôleur Ingress NGINX particulier, car il existe plusieurs projets. Cet article présente les CVE et explique comment distinguer les différents projets de contrôleurs Ingress afin de dissiper toute confusion.
Votre API est-elle en temps réel ? Testez sa latence avec l’outil rtapi de NGINX
Votre API répond-elle aux requêtes en moins de 30 ms ? Si ce n’est pas le cas, il ne s’agit pas d’une API en temps réel offrant la faible latence exigée par la grande majorité des organisations. Mesurez la latence de votre API avec l’outil rtapi de NGINX et découvrez comment NGINX peut l’aider à offrir une réactivité en temps réel.

Un testeur d’expressions régulières pour NGINX et NGINX Plus
Le testeur d’expressions régulières (regex) pour NGINX et NGINX Plus vous évite de tâtonner en vous indiquant si une expression régulière utilisée dans un bloc location ou map correspond aux valeurs comme prévu. Il génère la configuration appropriée et affiche les valeurs des groupes de capture.
Caches partagés avec les clusters de cache NGINX Plus, partie 1
Optimisez la capacité de votre cache web en le répartissant entre plusieurs serveurs de cache web NGINX ou NGINX Plus. Découvrez comment procéder dans cet article.
Introduction aux microservices
Les microservices suscitent actuellement beaucoup d’intérêt. Cet article de blog est le premier d’une série de sept consacrée à la conception, au développement et au déploiement de microservices.