Dans un précédent article de blog, j’expliquais que, face à un modèle de classe Mythos, l’endroit où l’on intercepte une attaque importe davantage que sa détection, et que le chemin emprunté par le trafic constitue le seul point de contrôle qu’un adversaire capable de raisonnement ne peut contourner. Cet article transpose cette réflexion au sein de l’entreprise : qu’est-ce qui circule réellement sur ce chemin lorsqu’une organisation met l’IA à contribution, et pourquoi la réponse change-t-elle notre façon de concevoir la sécurité ?
Il y a quelques mois, j’ai assisté à une discussion sur l’IA en entreprise qui a commencé comme la plupart d’entre elles. Quel modèle devrions-nous utiliser ? Devrions-nous l’exécuter nous-mêmes ou faire appel à un modèle public ? Comment améliorer la précision et réduire les hallucinations ? Toutes ces questions sont pertinentes. Mais personne n’a demandé ce qui se passe une fois le modèle choisi.
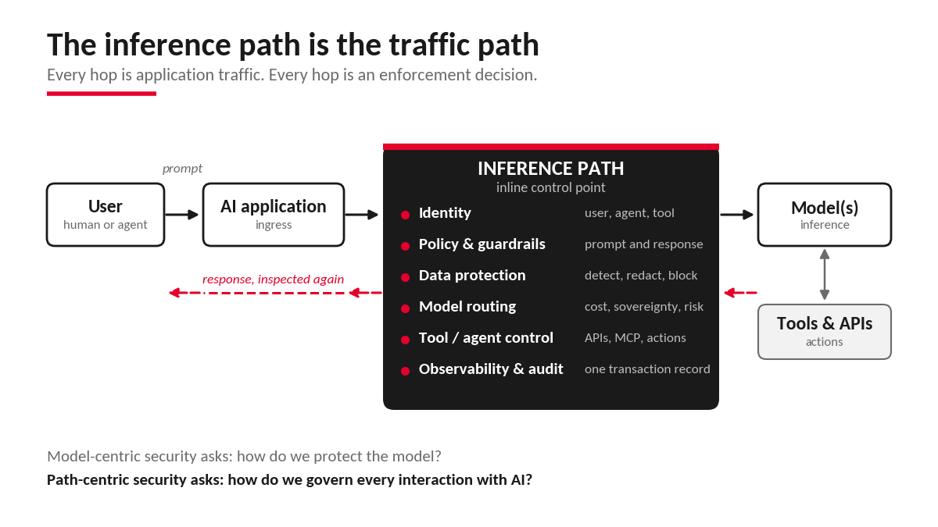
Voici ce qui se passe. Un utilisateur envoie une requête. Une application la reçoit, vérifie l’identité de l’utilisateur, récupère des éléments de contexte dans un référentiel de documents ou une base de données, puis appelle quelques API internes. Un agent peut décider qu’un outil est nécessaire. La requête ainsi constituée parvient au modèle, qui génère des jetons. Ces jetons peuvent constituer une réponse. Mais ils peuvent aussi servir d’instruction pour déclencher l’appel d’API suivant, le processus suivant ou une modification dans un système de référence.
Vu sous cet angle, le modèle n’est qu’un maillon d’une chaîne bien plus longue. C’est cette chaîne que j’appelle le chemin d’inférence, et ce billet repose sur un constat simple : Le chemin d’inférence est le chemin emprunté par le trafic.
“Le trafic conventionnel transporte des données. Le trafic d’inférence véhicule des intentions, du contexte et des décisions.”
Ce qu’est réellement le chemin d’inférence
L’entraînement permet à un modèle d’apprendre. L’inférence correspond au moment où le modèle entraîné est mis à contribution. Lorsqu’un collaborateur demande à un assistant d’entreprise de « résumer les derniers résultats et de rédiger un e-mail à l’intention de l’équipe de direction », la requête suit un parcours qui ressemble à ceci :
Utilisateur → Application → Identité → Contexte et récupération → API → Agent → Modèle → Outils → Modèle → Réponse → Utilisateur
Chaque étape de ce parcours génère du trafic réseau et applicatif. Elle implique des points de terminaison, de la latence, des décisions de routage et une identité qui lui est associée. Elle transporte des données, consomme du budget et, de plus en plus, confère le pouvoir d’agir.
Ma collègue Lori MacVittie a soulevé un point connexe plus tôt cette année : l’inférence est un comportement d’exécution en production et fonctionne comme une couche applicative, avec des utilisateurs, des schémas de trafic, une sensibilité à la latence, des modes de défaillance, des contraintes de coûts et des risques de sécurité. Kunal Anand, directeur des produits de F5, décrit ce même parcours comme une nouvelle chaîne de valeur, depuis le prompt jusqu’au point d’entrée, en passant par les workflows et l’inférence, puis de nouveau jusqu’à l’utilisateur. Dès lors que l’on adopte cette perspective, la réflexion sur la sécurité doit évoluer en conséquence. Dans son récent article de blog, Mani Ganesan, vice-président de la gestion des produits de sécurité de l’IA chez F5, examine les conséquences de cette évolution sur la surface d’attaque : « Votre IA est désormais une surface d’attaque. Êtes-vous prêt à la sécuriser ? »
Quatre idées reçues qu’il est temps d’abandonner
Alors que les RSSI renforcent la sécurité de l’IA, voici quatre idées reçues dont nous devons tous nous défaire :
- « Tout repose sur le modèle. » Le modèle concentre l’attention parce qu’il constitue la partie visible. Mais le prompt peut contenir des données sensibles, l’étape de récupération peut extraire des documents confidentiels, l’agent peut détenir des identifiants d’API et l’outil qu’il appelle peut être en mesure d’écrire dans une base de données. Sécuriser uniquement le modèle revient à renforcer la sécurité d’une base de données tout en négligeant l’application et les API qui communiquent avec elle. La surface d’attaque couvre l’ensemble du parcours.
- « Le passage du pilote à la production est un exercice de mise à l’échelle. » Un projet pilote comprend généralement un modèle, une poignée d’utilisateurs, une application et des accès approuvés manuellement. La production n’a rien à voir avec cela. Le rapport 2026 de F5 sur l’état des stratégies applicatives révèle que les entreprises coordonnent en moyenne sept modèles d’IA, 77 % d’entre elles déclarant que l’inférence, et non l’entraînement, constitue désormais leur principale activité liée à l’IA, tandis que 52 % enchaînent ou orchestrent plusieurs modèles. Il ne s’agit pas de la même architecture avec davantage d’utilisateurs, mais d’une architecture différente, et le modèle de sécurité doit évoluer en conséquence.
- « La rapidité, la sécurité et la gouvernance sont des couches distinctes. » Prenons l’exemple d’une requête contenant des informations personnelles. Entre l’utilisateur et le modèle, cette requête doit être inspectée, expurgée lorsque la politique l’exige, acheminée vers un modèle approuvé, surveillée et consignée à des fins d’audit, le tout pendant son transit. Le même point de décision qui demande : « Où cette requête doit-elle être envoyée ? » doit désormais aussi déterminer : « Doit-elle vraiment y être envoyée ? » Il s’agit d’une seule décision de traitement du trafic, et non de trois fonctions ajoutées les unes aux autres.
- « Nous pouvons assembler des outils spécialisés. » Une organisation peut tout à fait constituer sa propre pile technologique : passerelle API, WAF, DLP, IAM, garde-fous pour l’IA, passerelle de modèles, observabilité, SIEM, contrôles des agents, sécurité MCP. Aucun de ces outils n’est mauvais en soi. Le problème réside dans les points de jonction entre eux. Imaginez une requête traversant six points de contrôle, chacun doté de son propre moteur de règles et de son propre contexte d’identité. Qui sait que l’utilisateur ayant saisi le prompt correspond à l’identité qui invoque maintenant l’outil ? Qui peut voir que l’appel d’API, l’appel au modèle et l’appel à l’outil constituent une seule et même transaction ? Qui peut appliquer une politique cohérente tout au long du parcours et prouver ensuite ce qui s’est passé ?
Dans mon précédent article de blog, j’expliquais que les points de jonction sont les premiers endroits qu’un adversaire capable de raisonnement cherchera à exploiter. Il en va de même pour un agent bien intentionné qui s’écarte simplement des règles établies.
Quand le trafic commence à véhiculer une intention
L’IA ajoute de nouvelles étapes à la séquence habituelle requête-routage-politique-réponse : contexte, récupération, orchestration et appel d’outils. Mais le changement le plus profond concerne ce que transporte le trafic. Le trafic conventionnel transporte des données. Le trafic d’inférence transporte des intentions, du contexte et des décisions.
C’est particulièrement important dans le cas des agents. Un assistant qui répond à une question est une chose. Un agent capable de consulter les dossiers clients, de créer des tickets, d’envoyer des e-mails, d’exécuter du code, de modifier l’infrastructure ou d’émettre un ordre de paiement en est une tout autre. Le parcours d’inférence devient alors un parcours d’action, et les conséquences d’une mauvaise décision ne se limitent plus à la sphère informationnelle.
La transaction d’inférence est la nouvelle unité de sécurité
La sécurité traditionnelle raisonne en termes d’utilisateurs, d’appareils, d’applications, d’API, de charges de travail et de données. Le modèle Zero Trust nous a appris à ne pas seulement demander « Qui êtes-vous ? », mais aussi « À quoi essayez-vous d’accéder ? ». Les systèmes d’IA imposent une troisième question : « Que demandez-vous à l’IA de faire, avec quelles données, par l’intermédiaire de quel modèle, et quelles actions cette interaction pourrait-elle déclencher ? »
Pour y répondre, il faut disposer d’un contexte qu’aucun contrôle existant ne détient à lui seul. Prenons le cas d’un utilisateur authentifié d’un copilote financier : sa requête transmet des données financières confidentielles à un modèle externe, passe le relais à un agent financier et aboutit à un appel à l’API de l’ERP afin de créer une instruction de paiement. L’identité de l’utilisateur ne suffit pas, à elle seule, à prendre cette décision. Celle-ci doit s’appuyer sur l’ensemble de la transaction.
C’est pourquoi l’identité, la sécurité des applications, la sécurité des API, la sécurité de l’IA et la gestion du trafic convergent. Leur point de convergence est la transaction d’inférence : identité, prompt, contexte, modèle, données, outils, résultat et action. Il s’agit d’un objet bien plus riche qu’une requête HTTP.
Dès lors que l’on raisonne en termes de transactions, la sécurité cesse d’être un simple point de contrôle pour devenir un processus continu. Avant l’inférence, il faut déterminer qui formule la demande, quelles données sont fournies, si le prompt est malveillant et à quel modèle il doit être adressé.
Pendant l’inférence, il faut déterminer si la requête respecte les règles et le budget, et si un agent tente d’appeler un outil pour lequel il n’a jamais reçu d’autorisation. Après l’inférence, il faut vérifier si la réponse peut être renvoyée en toute sécurité, si elle a déclenché une action et quelles informations doivent être consignées. Chacune de ces décisions doit être prise là où transite le trafic, car c’est le seul endroit où l’ensemble du contexte est disponible simultanément.
Ce que cela implique pour les RSSI
Nous avons déjà observé ce schéma. Les monolithes ont cédé la place aux applications distribuées, le modèle client-serveur aux API et aux microservices, et la sécurité périmétrique à des contrôles tenant compte de l’identité et des applications. À chaque fois, l’infrastructure chargée d’acheminer et de sécuriser le trafic a acquis une importance stratégique. L’inférence constitue la prochaine étape de ce cycle.
La question à poser à votre équipe d’architecture ne porte donc pas uniquement sur l’emplacement de vos modèles. Demandez-lui où circulent les flux d’inférence, ce qu’ils transportent, à quoi ils peuvent accéder, quelles décisions ils prennent et quelles actions ils peuvent déclencher. Posez ensuite la question la plus difficile : où pouvons-nous appliquer des règles à l’ensemble de ces éléments sans ralentir l’application ?
Car, à l’ère de l’IA, le périmètre de sécurité le plus important ne se situe peut-être plus autour du modèle, mais sur le chemin des données qui y entrent et en sortent.
Pour en savoir plus sur l’approche de F5 en la matière, consultez la page F5 AI Gateway. N’oubliez pas non plus de lire mon précédent article de blog, « Arrêter l’IA de pointe au niveau du réseau : pourquoi le contrôle en ligne constitue un avantage essentiel face aux modèles de classe Mythos. »
À propos de l’auteur
Articles de blog associés
IA et cybersécurité
Découvrez comment l’IA et la cybersécurité fonctionnent de concert. Découvrez comment l’IA et le machine learning (ML) permettent à votre entreprise de rester sécurisée, efficace et prête à innover avec F5.

Suivre le rythme de l’innovation de pointe ne suffit pas à faire avancer l’entreprise : se préparer à la réglementation de l’IA
À mesure que la réglementation de l’IA évolue, réfléchissez aux mesures de protection que vous pouvez mettre en place dès maintenant.
Les contrôleurs de mise à disposition d’applications reviennent au cœur des priorités stratégiques
L’IA rebat les cartes de la livraison d’applications. Nirav Shah de F5 revient sur la nouvelle étude de Gartner® consacrée aux ADC et explique ce qu’elle implique pour les décisions des entreprises en matière d’infrastructure.
Ce que nos clients nous disent sur l’IA, le multicloud hybride et la sécurité des applications
Le nouveau vice-président senior du marketing produit de F5 explique les pressions liées à l’IA auxquelles sont confrontés les dirigeants d’entreprise et ce dont ils ont besoin pour renforcer leur organisation.

Cinq niveaux de cyberrésilience antifragile transforment les pratiques en résultats
Découvrez comment cinq niveaux de résilience antifragile transforment les perturbations en comportements adaptatifs qui limitent les défaillances et renforcent l’architecture multicloud hybride.

Optimiser les pipelines d’IA en éliminant les goulets d’étranglement dans les charges de travail modernes
À mesure que les charges de travail d’IA montent en puissance, les entreprises constatent des ralentissements provenant du pipeline de données en amont qui alimente le modèle d’IA. Voici comment F5 BIG-IP peut les aider.