Ultimamente, muito se tem falado — em salas de reunião, em teleconferências de resultados e em um fluxo constante de artigos de opinião — sobre uma única ideia: o próximo grande avanço na economia da IA não virá apenas de chips mais rápidos.
O argumento é válido, mas a lição é mais abrangente. A primeira queda acentuada no custo por token resultou da combinação de avanços em silício e software: aceleradores mais rápidos, sistemas de memória melhores, formatos de menor precisão, PagedAttention, processamento contínuo em lotes, otimização do cache de chave-valor e frameworks de inferência como o vLLM. O setor se tornou muito mais eficiente em extrair trabalho útil de cada acelerador.
Então, o setor foi em busca da próxima área em que pudesse aplicar o mesmo rigor e encontrou o caminho dos dados, especialmente o armazenamento. Esse trabalho é essencial, mas representa apenas metade da história.
O caminho dos dados é apenas metade da história
O armazenamento em uma fábrica de IA deixou de ser passivo. Os modelos são carregados a partir dele. Os checkpoints são restaurados a partir dele. A geração aumentada por recuperação depende dele sob pressão de latência. Em escala suficiente, as camadas de contexto e cache podem se estender para além da GPU e da memória do sistema, pois refazer um trabalho já concluído é um uso dispendioso de um acelerador.
Mas a economia da IA é moldada por dois fluxos interligados. Um deles é a movimentação dos dados que alimentam o modelo: onde os bytes ficam armazenados, com que rapidez podem ser recuperados e com que frequência precisam ser transferidos. O outro é o caminho percorrido por uma solicitação de inferência — de um usuário, aplicativo ou agente, passando pelo gerenciamento de tráfego e pela aplicação de políticas, até um servidor de modelos e, então, de volta à origem.
Esse segundo fluxo transporta dados em trânsito. Em comparação com a computação e o armazenamento, ele ainda é pouco mensurado e pouco otimizado em muitos ambientes de produção. É aí que será definida a próxima rodada de ganhos — e também de desperdícios.
O imposto dos tokens
Em um nó de GPU, a unidade central de processamento do host não fica ociosa. Ela executa tarefas de rede, encerra conexões com segurança da camada de transporte, aplica políticas, processa o tráfego leste-oeste, gera telemetria e transfere dados entre interfaces e aceleradores. Nenhuma dessas tarefas produz tokens diretamente. Quando ela se torna um gargalo, reduz a capacidade útil de inferência.
Chame isso de imposto sobre tokens: a sobrecarga de infraestrutura que consome recursos do host e reduz silenciosamente o retorno econômico do nó. A solução nem sempre é um processador de host mais rápido. Em grande escala, funções adequadas de rede, criptografia, gerenciamento de tráfego e segurança podem ser transferidas para uma infraestrutura programável que já está no caminho dos dados.
Em testes encomendados pela F5 e realizados de forma independente pelo The Tolly Group, o F5 BIG-IP Next for Kubernetes implantado em DPUs NVIDIA BlueField-3 proporcionou uma taxa de transferência de tokens até 40% maior, um tempo até o primeiro token 61% menor e uma latência de solicitação 34% menor do que as alternativas testadas hospedadas em CPU.
A implicação financeira é clara. Se uma infraestrutura fixa produzir 1,4 vez mais tokens comercializáveis dentro dos objetivos de nível de serviço exigidos, o custo de infraestrutura por token cairá aproximadamente 29%. A receita por acelerador também poderá aumentar onde houver demanda. Essa é uma afirmação de negócios mais útil do que simplesmente dizer que a rede é mais rápida.
O roteamento se transformou em agendamento
O balanceamento de carga convencional distribui as solicitações. Isso funciona quando elas são aproximadamente intercambiáveis. A inferência de modelos de linguagem de grande porte invalida essa premissa, pois o custo de uma solicitação depende do tamanho do contexto, do tamanho da saída, do estado do cache, da seleção do modelo, do tamanho da fila e da carga atual do acelerador.
- Um prompt curto com uma resposta breve pode ter um custo várias ordens de grandeza menor do que um contexto muito longo com uma resposta extensa.
- Uma solicitação que encontra um cache de chave-valor já aquecido pode evitar o alto custo de recalcular o prefill.
- Solicitações com alta carga de prefill e solicitações com alta carga de decodificação podem interferir umas nas outras quando são direcionadas ao mesmo acelerador.
- Um servidor de modelos com oito solicitações na fila e outro sem nenhuma podem parecer igualmente saudáveis para uma verificação sem estado.
Um gerenciador de tráfego sem visibilidade dessas condições inevitavelmente tomará decisões inadequadas de alocação. O custo se manifesta duas vezes: na latência percebida pelo usuário como tempo até o primeiro token e na recomputação que a empresa paga na forma de trabalho duplicado.
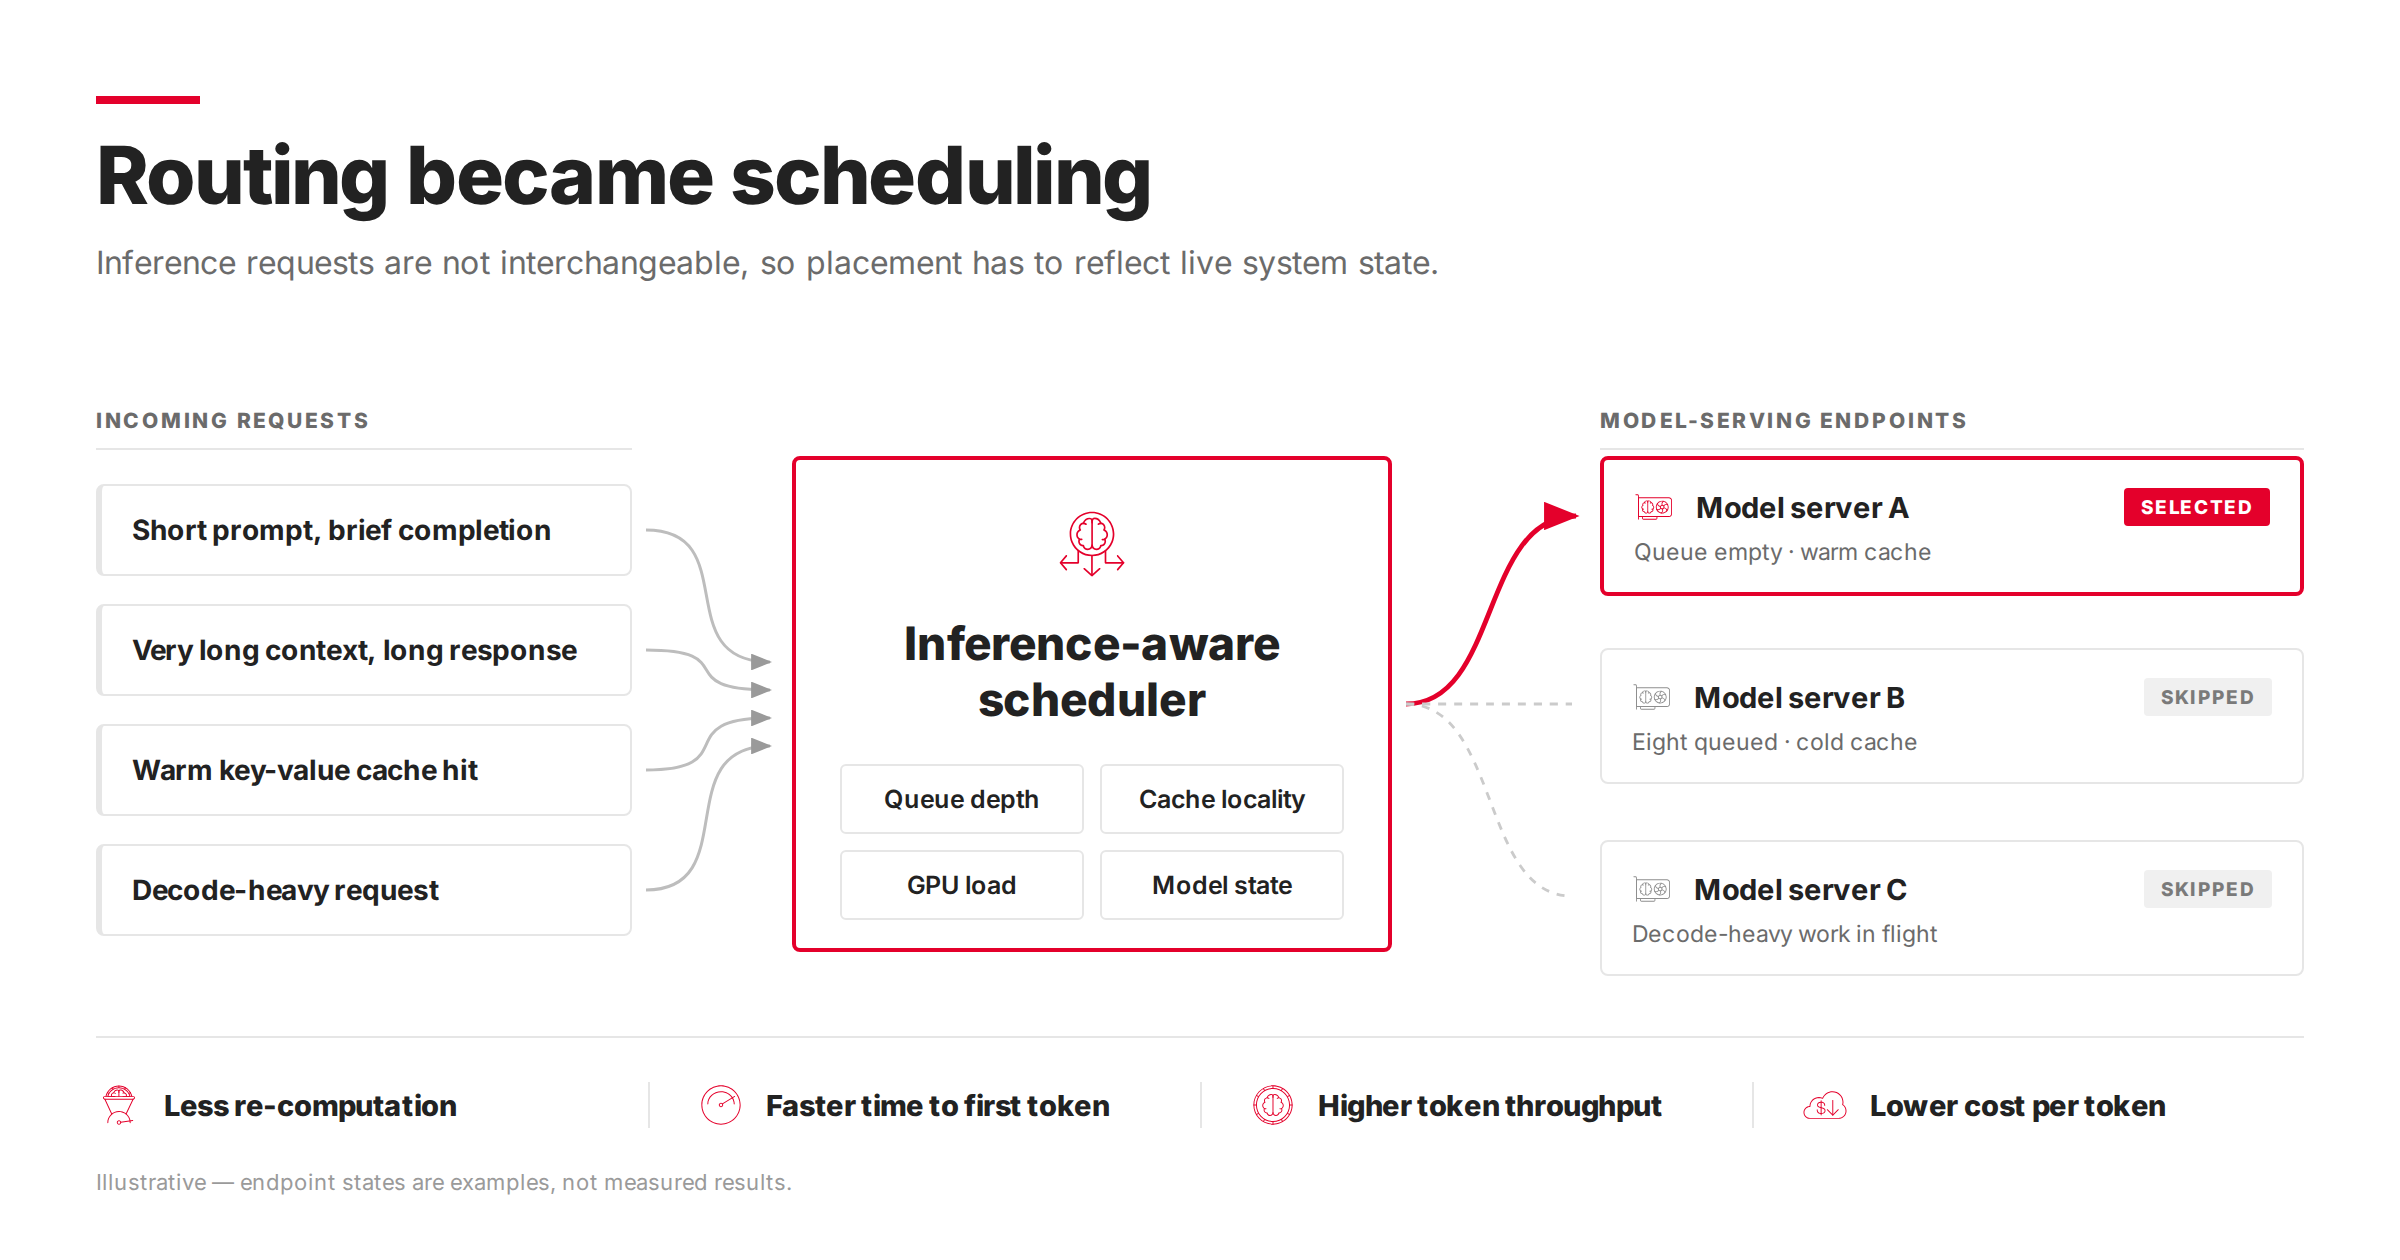
Portanto, o roteamento em uma fábrica de IA deixou de ser apenas uma função de rede. Ele é uma decisão de escalonamento que ocorre na rede e se beneficia dos mesmos dados de entrada necessários a qualquer escalonador: estado dos servidores de modelos em tempo real, profundidade da fila, telemetria dos aceleradores, localidade do cache e sinais de execução da estrutura de inferência.
A segurança também é uma função de custo
A segurança em uma fábrica de IA costuma ser discutida em termos de riscos: injeção de prompts, vazamento de dados, agentes que excedem sua autoridade e exposição regulatória. Todos são reais. Uma pesquisa da F5 constatou que 88% das organizações relatam pelo menos um desafio operacional ou de segurança relacionado à IA.
Há também um argumento relacionado à economia unitária. As solicitações bloqueadas antes da execução do modelo evitam gastos desnecessários com inferência. Já as solicitações avaliadas somente após a geração de uma resposta completa consomem recursos computacionais antes que a política entre em vigor. Multiplique isso pelo tráfego de scraping, por tempestades de novas tentativas, por um agente preso em um loop ou por repetidas tentativas de jailbreak, e o ponto de aplicação dos controles passa a afetar tanto os custos quanto os riscos.
O princípio não é concentrar todos os controles em um único lugar. Algumas proteções exigem uma avaliação mais aprofundada no nível da aplicação ou do modelo, e esses controles têm seu próprio custo computacional. O objetivo é aplicar o controle eficaz de menor custo o mais cedo possível e, em seguida, realizar uma inspeção mais aprofundada onde ela agregar valor.
O tráfego de agentes agrava esse problema. Os agentes fazem novas tentativas, distribuem chamadas em paralelo e acionam ferramentas que chamam modelos, que por sua vez chamam outros modelos. Eles geram tráfego em velocidade de máquina, que os limites de taxa projetados para a escala humana não foram concebidos para suportar. O modo de falha nem sempre é uma violação de segurança. Às vezes, é simplesmente uma conta.
A camada comercial está ausente
Se um operador não consegue contabilizar os tokens por locatário, modelo, usuário e aplicação, torna-se difícil definir preços, medir o consumo, fazer o repasse de custos, garantir a equidade ou preservar uma margem. A infraestrutura pode ter uma excelente telemetria sobre o consumo de energia e a integridade dos sistemas, mas oferecer visibilidade limitada sobre a atribuição de receita.
A multilocação agrava o problema. Uma infraestrutura de GPUs compartilhada sem isolamento eficaz e contabilização por locatário significa que um pico de uso de um locatário pode causar uma violação do nível de serviço de outro. Um vizinho barulhento em um cluster de IA não é apenas um incômodo de desempenho. Ele pode levar à perda de clientes.
O caminho de inferência oferece o ponto de observação transversal mais consistente, pois permite monitorar solicitações e respostas de diferentes usuários, aplicações, modelos e locatários. Os servidores de modelos e os sistemas de faturamento continuam sendo importantes, mas é nesse caminho que a medição e a aplicação de políticas podem ser realizadas de forma consistente.
O plano de serviço de inferência
Ao reunir essas questões, um terceiro plano arquitetural começa a ganhar forma. O plano de computação é composto pelas GPUs e pelos aceleradores para os quais todos reservam orçamento. O caminho de dados abrange armazenamento, recuperação, cache e memória. O plano de serviço de inferência determina como as solicitações chegam aos aceleradores, como são agendadas de acordo com o estado real do sistema, o que é interrompido antes de consumir recursos computacionais desnecessários, o que é contabilizado e quem é cobrado.
Essa camada já existe, mas muitas vezes como resultado acidental da combinação de diferentes componentes: um balanceador de carga aqui, um gateway de API ali, uma malha de serviços, um firewall de aplicações web, coletores de telemetria e, no fim, uma planilha. Raramente ela foi projetada como um sistema coeso, com telemetria compartilhada, políticas consistentes e pontos de aplicação deliberadamente definidos.
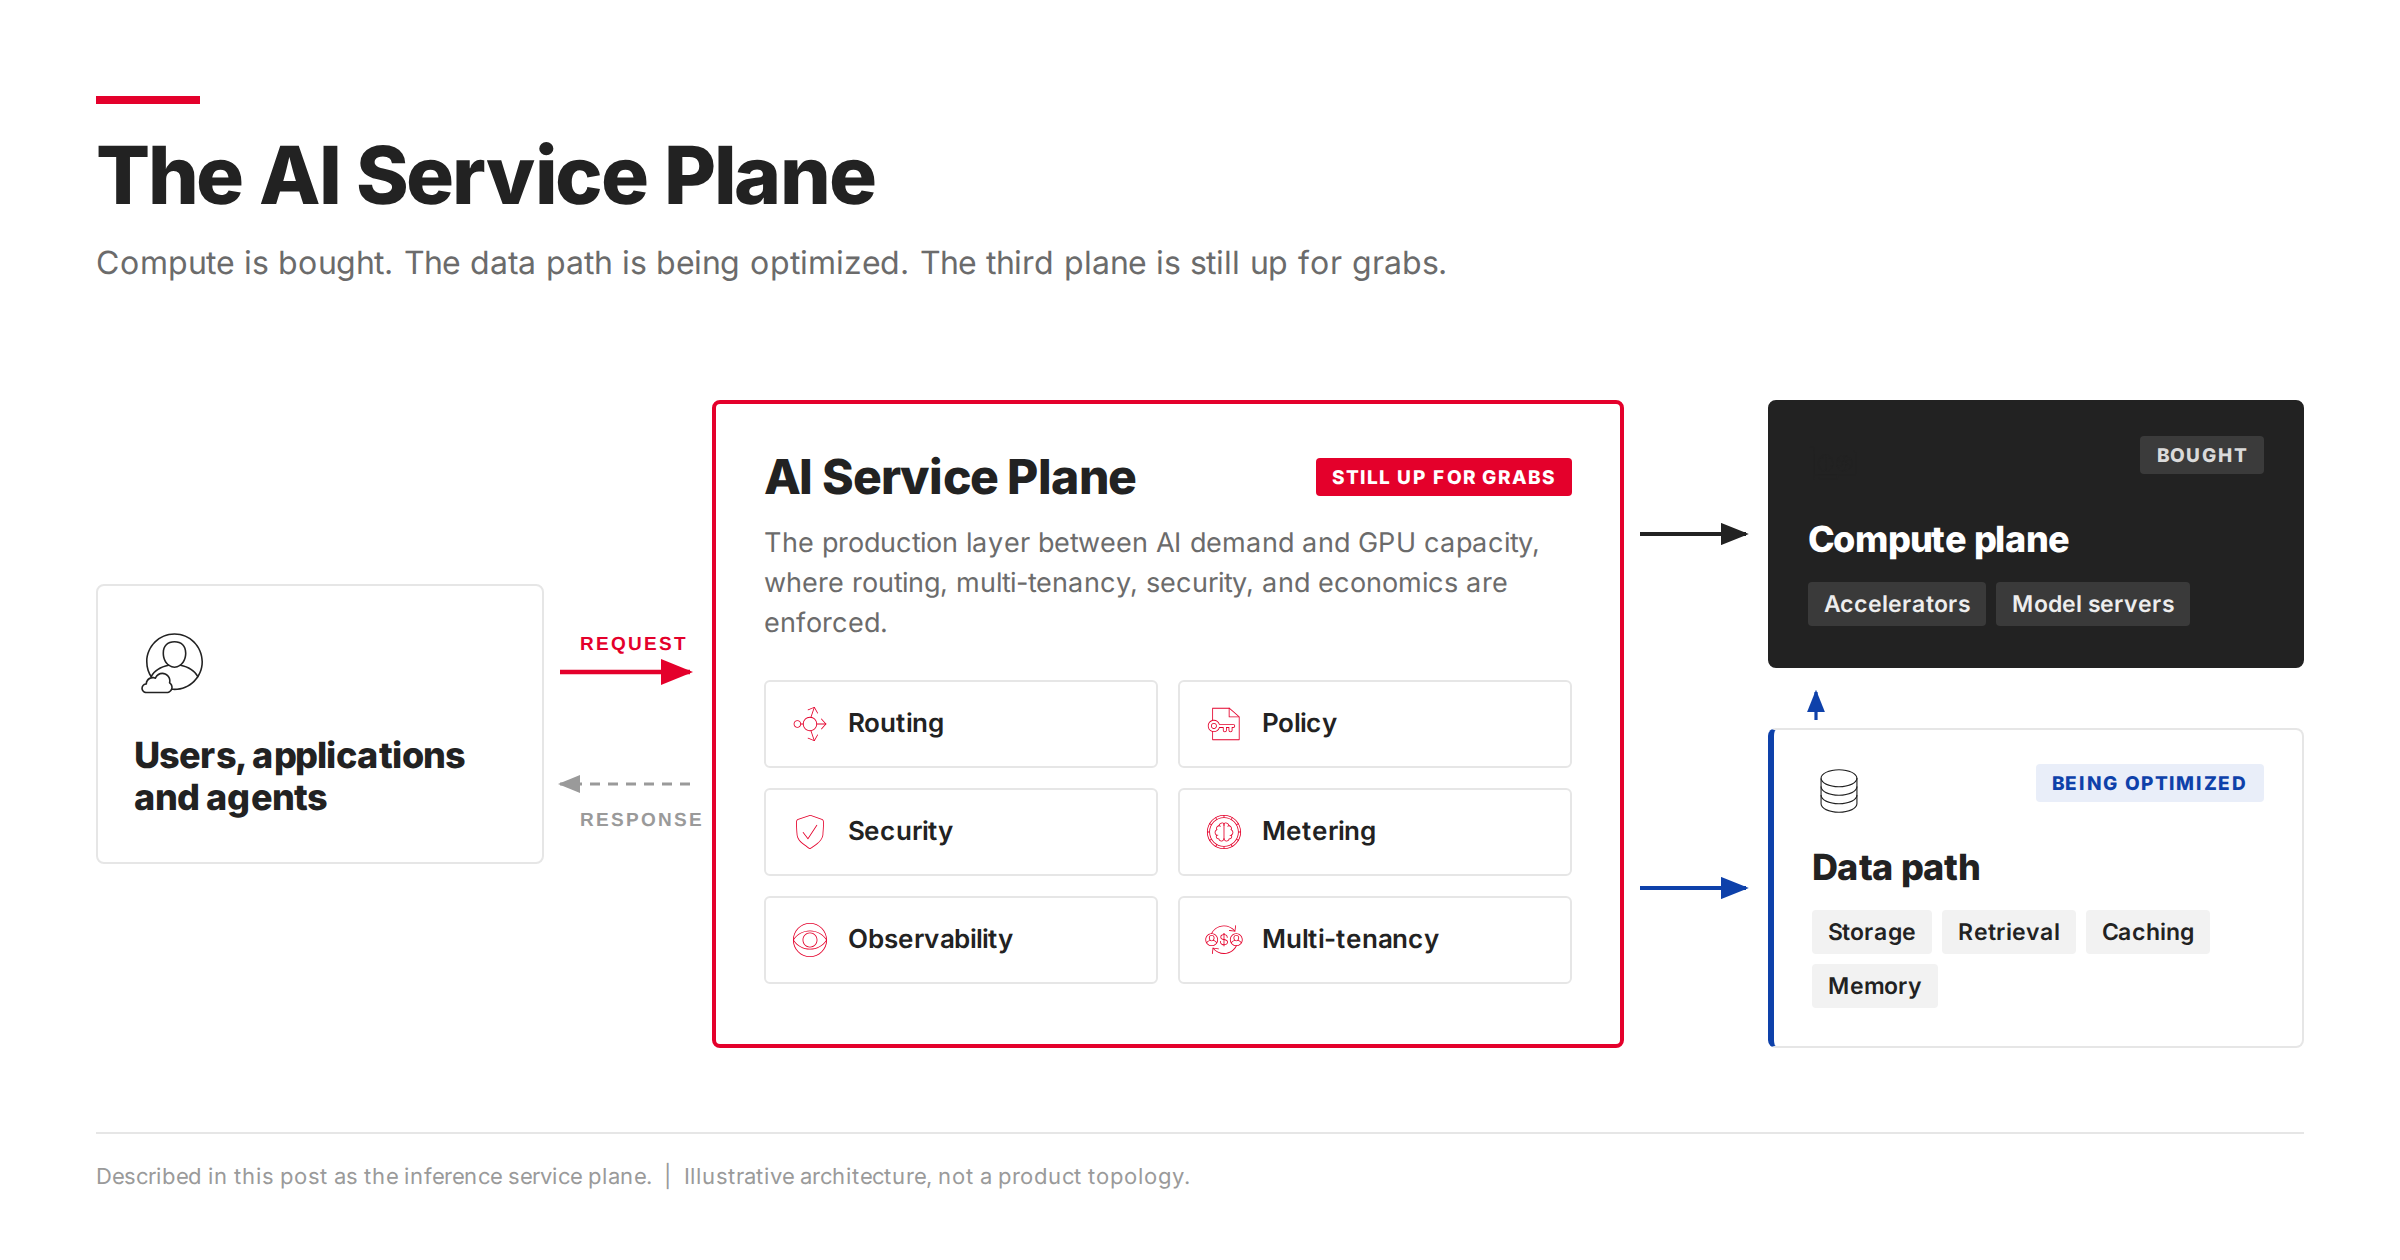
F5 BIG-IP Next for Kubernetes pode ser executado no host ou em DPUs NVIDIA BlueField. Ele oferece gerenciamento de tráfego nativo do Kubernetes, segurança, políticas multilocatário, observabilidade, balanceamento de carga inteligente e governança de tokens em todo o caminho de inferência.
Na camada de aplicação, F5 AI Gateway adiciona governança de modelos e agentes, roteamento, armazenamento em cache, medição, controles de segurança e auditabilidade em prompts, respostas, modelos e ferramentas.
A direção arquitetural é mais importante do que qualquer produto isolado: defina as políticas com clareza, aplique-as onde forem mais eficazes e compartilhe a telemetria entre as camadas de infraestrutura e de aplicação. É assim que os operadores reduzem os pontos cegos e evitam que equipes distintas mantenham controles divergentes.
Projete o caminho de forma intencional
Três perguntas devem fazer parte da próxima análise da infraestrutura de IA. Qual é o rendimento de tokens úteis da capacidade de aceleradores já provisionada? Quanto processamento do host é consumido por tarefas que não produzem tokens diretamente? Qual é o custo de uma solicitação rejeitada quando ela chega à execução do modelo antes que os mecanismos de controle entrem em ação?
Em todo o setor, a discussão está mudando da capacidade para a conversão — da infraestrutura disponível para o que se pode extrair dela de forma confiável. O próximo grande avanço na economia da IA não virá apenas de chips mais rápidos nem apenas do armazenamento. Virá de tratar o fluxo de inferência como um sistema econômico.
O plano de computação já foi adquirido. O caminho dos dados está sendo otimizado. O plano de serviços de inferência ainda está em disputa.
Para saber mais, leia o relatório de desempenho de IA.
Sobre o autor
Publicações relacionadas no blog

IA agêntica em cibersegurança: promessas e riscos
Saiba por que o uso de IA agêntica na cibersegurança é essencial para combater ameaças impulsionadas por IA e por que os agentes também criam novos riscos para as empresas.

Como os clientes da F5 no setor financeiro lidam com a soberania digital sem desacelerar a inovação
Como é a soberania digital na prática? Dois projetos recentes da F5 com clientes mostram como diferentes empresas estão enfrentando esses desafios.

Soberania operacional: construindo resiliência em um mundo imprevisível
Para muitas organizações, a questão já não se resume apenas a controlar os dados. Trata-se de manter a capacidade de operar, adaptar-se e se recuperar à medida que as leis e as condições evoluem.

Segurança de IA com evidências: o que levaremos ao Gartner SRM
Antes de sua sessão no Gartner SRM, o vice-presidente sênior de Marketing de Produtos da F5 explica como a F5 ajuda as organizações a proteger a IA em três etapas práticas.

Gestão de riscos de IA: como as proteções podem ajudar a mitigá-los
O risco da IA é impulsionado por comportamentos probabilísticos e pela explicabilidade limitada, não apenas por falhas de segurança. Uma gestão eficaz exige controle operacional contínuo.

Lei de IA do Colorado (SB 205): o que as empresas precisam saber antes de 2026
A SB 205 do Colorado, a lei pioneira do estado sobre inteligência artificial, foi sancionada pelo governador Jared Polis em 17 de maio de 2024. O projeto de lei estabelece requisitos para que as empresas que utilizam IA implementem controles destinados a proteger os cidadãos do Colorado.