Embora os clusters de GPU e as fábricas de IA dominem as manchetes, as operações essenciais dos negócios dependem de pipelines de armazenamento de objetos menos visíveis. O arquivamento e o backup de bancos de dados precisam funcionar de forma confiável. Se esses pipelines pararem, as aplicações perderão o acesso a dados críticos e os processos de negócios serão interrompidos imediatamente. Para os CIOs, os gargalos de armazenamento não são meros detalhes de infraestrutura; são ameaças à continuidade dos negócios. Esses pipelines dão suporte à conformidade e à recuperação de desastres.
A entrega de dados para IA intensifica essa pressão operacional. Grandes modelos de linguagem e sistemas de geração aumentada por recuperação (RAG) exigem acesso rápido e confiável aos dados. Consequentemente, o principal desafio deixou de ser a quantidade de dados que você consegue armazenar e passou a ser a rapidez e a segurança com que você consegue transferi-los entre plataformas e modelos.
Os pipelines de armazenamento de objetos nos quais ninguém pensa até que falhem
O armazenamento de objetos corporativo atende a diferentes cargas de trabalho. Enquanto algumas dão suporte a projetos de IA de grande visibilidade, outras sustentam as operações do dia a dia. Esses pipelines operacionais raramente recebem atenção da liderança, mas determinam se é possível se recuperar de uma interrupção e atingir os objetivos de nível de serviço.
Esses pipelines abrangem quatro responsabilidades operacionais essenciais. Se qualquer um deles falhar, as operações da empresa serão interrompidas:
- Continuidade dos negócios: Logs de gravação antecipada (WAL) de bancos de dados e backups. Tradicionalmente, os WALs eram gravados em unidades de estado sólido (SSDs) locais. Hoje, os bancos de dados modernos na nuvem podem gravar WALs em armazenamento compatível com S3. Juntos, esses fluxos de trabalho permitem que as equipes restaurem os sistemas essenciais imediatamente após falhas.
- Operações de segurança: Logs de SIEM e evidências forenses. As equipes de resposta a incidentes e detecção de ameaças dependem desses dados para investigar ataques em andamento.
- Conformidade e governança: Arquivos regulatórios e cofres imutáveis. Para essas cargas de trabalho, a disponibilidade dos dados é uma exigência legal rigorosa, e não uma preferência operacional.
- Plataformas de dados empresariais: Data lakes e bases de conhecimento para RAG. Esses pipelines alimentam os aplicativos e os mecanismos de aprendizado de máquina que impulsionam seus produtos.
Nenhuma dessas cargas de trabalho de backend é glamourosa. No entanto, são justamente elas que determinam se sua empresa se mantém em conformidade e preparada durante uma crise.
Os riscos ocultos estão no caminho dos dados
Embora tradicionalmente gerenciado como infraestrutura de back-end, o armazenamento de objetos moderno é, na verdade, um serviço de rede ativo. Quer você use o Amazon S3 ou sistemas privados de armazenamento de objetos, as aplicações consultam o armazenamento por HTTP/S usando APIs REST. Essa realidade arquitetural significa que os pipelines de armazenamento de objetos herdam exatamente os mesmos riscos de desempenho e segurança que ameaçam as aplicações e os serviços web modernos.
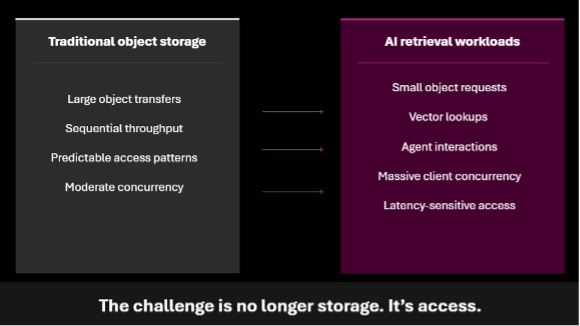
Os riscos à disponibilidade surgem quando picos de tráfego sobrecarregam as interfaces de rede ou quando os controladores de armazenamento falham. Os gargalos de desempenho são igualmente prejudiciais. Picos de latência e congestionamentos de rede comprometem fluxos de trabalho críticos do backend, mesmo quando os discos de armazenamento subjacentes estão funcionando normalmente. Por exemplo, um atraso no fluxo de arquivamento de um banco de dados pode interromper os logs de gravação antecipada (WAL), prejudicando o desempenho do banco de dados e provocando uma indisponibilidade repentina. O verdadeiro risco não está na falha inicial, mas no alcance de sua propagação. Sem isolamento no caminho dos dados, um problema em um único pipeline se transforma em uma indisponibilidade de todo o sistema.
Usar APIs web para acessar o armazenamento amplia a superfície de ataque da sua empresa. Esses endpoints são vulneráveis a ataques DDoS. Como as equipes de segurança e os desenvolvedores dependem do armazenamento de objetos para alimentar análises em tempo real e modelos de IA, um comprometimento da segurança na camada da API de armazenamento tem graves consequências operacionais.
Gerenciar a capacidade bruta já não é o principal obstáculo. O grande desafio de engenharia é manter o controle sobre a movimentação dos dados entre aplicações e repositórios. Proteger e otimizar esse trajeto agora é tão importante quanto manter a plataforma de armazenamento subjacente.
Aplicando o rigor da engenharia aos pipelines de dados de armazenamento de objetos
Modernizar a infraestrutura de dados para análise de dados e IA significa que você não pode mais tratar o armazenamento de objetos como um repositório passivo. É preciso gerenciar o próprio caminho dos dados. Assim como você usa um controlador de entrega de aplicações (ADC) para proteger aplicações web voltadas ao usuário, você precisa de pontos de controle equivalentes para os pipelines de armazenamento de backend que viabilizam sua entrega de dados para IA. Ao posicionar o F5 BIG-IP à frente dos seus buckets de armazenamento, você transforma um endpoint de API passivo e vulnerável em um pipeline de entrega de dados seguro, acelerado e de alta disponibilidade.
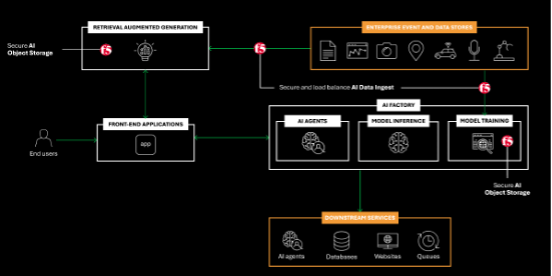
Como o armazenamento de objetos moderno é acessado pela rede por meio de APIs HTTP/S, ele se comporta exatamente como uma aplicação web. Isso significa que um ADC como o F5 BIG-IP é a ferramenta nativa para gerenciá-lo. Como camada de controle entre aplicações e repositórios de dados, o BIG-IP protege e estabiliza a movimentação de dados.
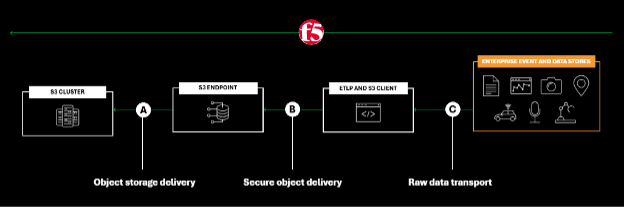
Essa arquitetura oferece enormes vantagens operacionais sem exigir que você refatore aplicações ou reprojete plataformas de armazenamento:
- Sem refatoração do armazenamento: Atualizar o armazenamento para adicionar segurança e roteamento é um projeto caro que leva vários anos. Posicionar o BIG-IP à frente do armazenamento adiciona imediatamente recursos de roteamento e registro de logs de nível empresarial, sem exigir alterações no armazenamento subjacente ou no código da aplicação.
- Desempenho acelerado com a transferência do processamento de rede: Os sistemas de armazenamento são projetados para ler e gravar dados, não para gerenciar a sobrecarga de rede. O BIG-IP assume tarefas que exigem uso intensivo do processador, como a descriptografia SSL/TLS. Ao retirar do array de armazenamento essas tarefas com alta demanda de rede, a CPU do sistema de armazenamento pode se concentrar nas operações de E/S e reduzir os tempos de resposta às consultas de IA.
- Proteção ativa de segurança: A segurança tradicional de armazenamento é passiva e depende de chaves de acesso que não conseguem detectar consultas maliciosas. O BIG-IP atua como um escudo ativo, inspecionando o tráfego de entrada da API de armazenamento com um firewall de aplicações web (WAF) para bloquear injeções de SQL e ataques DDoS antes que essas ameaças atinjam a camada de armazenamento.
Para garantir alta disponibilidade, o BIG-IP monitora a integridade dos endpoints e direciona o tráfego para evitar nós offline. Ele também distribui dinamicamente as consultas entre data centers. Isso limita o impacto de falhas nos componentes e mantém seus níveis de serviço previsíveis à medida que os volumes de dados e as demandas dos modelos de IA aumentam.
A movimentação confiável de dados agora é um requisito de negócios
Ao inserir uma camada de controle baseada em ADC entre as aplicações e o armazenamento, você estabelece um caminho de dados resiliente e controlável. Essa escolha arquitetural aplica aos pipelines de armazenamento de objetos o mesmo rigor de engenharia que você já utiliza nas suas principais aplicações e APIs voltadas ao cliente.
Os pipelines de dados mais críticos de uma empresa costumam ser os menos visíveis. Seja na recuperação de desastres ou na manutenção da conformidade, a estabilidade operacional depende inteiramente da confiabilidade com que os dados trafegam pela sua rede.
À medida que as exigências de desempenho aumentam, não é mais possível avaliar o armazenamento de objetos apenas pela capacidade e pela escala. Para os líderes empresariais, o objetivo não é simplesmente armazenar mais dados, mas também garantir que os dados que sustentam suas operações críticas e iniciativas de IA permaneçam sempre disponíveis e seguros. Armazenar dados é apenas o primeiro passo; é preciso projetar ativamente o próprio caminho dos dados para garantir resiliência, controle e contenção.
O foco da F5 em IA vai além — descubra como a F5 protege e entrega aplicações de IA em qualquer lugar.
Sobre o autor
Publicações relacionadas no blog
Segurança de APIs sem concessões: apresentamos novas opções flexíveis de descoberta com F5 API security
As opções ampliadas de descoberta de APIs da F5 foram desenvolvidas para oferecer o máximo de flexibilidade e atender às organizações onde quer que estejam.

Governe sua IA no presente e antecipe o futuro da sua IA
Aprenda com nosso CISO de campo, Chuck Herrin, como se preparar para o novo desafio de proteger modelos e agentes de IA.

Segurança de IA para a cadeia de suprimentos
As cadeias de suprimentos são cada vez mais impulsionadas pela IA — desde a previsão de demanda e o planejamento logístico até a análise de riscos de fornecedores e a gestão de estoque em tempo real. Essas ferramentas ajudam as empresas a reduzir custos, aumentar a resiliência e se adaptar a disrupções globais. No entanto, elas também criam novos riscos em um vasto ecossistema: nossas soluções de segurança de IA em tempo de execução protegem o setor de Cadeia de Suprimentos […]
Segurança de IA para Recursos Humanos
A IA está revolucionando o RH. As empresas estão implementando copilotos de recrutamento com IA, assistentes de integração, chatbots de suporte aos funcionários e ferramentas de análise da força de trabalho para reduzir custos e melhorar a experiência dos colaboradores. No entanto, as aplicações de RH também apresentam riscos específicos que podem expor as organizações a falhas de conformidade, alegações de viés e danos à reputação: nossas soluções de segurança de IA em tempo de execução protegem o setor de RH com […]
Equilibrando o desempenho da IA e a gestão de recursos
As organizações dependem cada vez mais de ferramentas e iniciativas de IA para impulsionar a inovação e a transformação. Cada avanço incremental na sofisticação das ferramentas de IA torna o equilíbrio entre desempenho e gestão de recursos um desafio maior e mais relevante para as equipes de TI e segurança. No entanto, esse equilíbrio é essencial para maximizar o ROI, garantir a segurança e manter a eficiência em toda a […]
Integração de APIs em IA: a base técnica
A integração de APIs é um canal essencial no ecossistema de IA, por meio do qual diferentes sistemas, plataformas e aplicações interagem. Analisamos as nuances técnicas da integração de APIs em IA, com ênfase em sua importância para aprimorar a eficiência e os recursos dos sistemas de IA. As APIs permitem a troca fluida de dados e funcionalidades entre diferentes soluções de IA […]