Editor – Esta serie de siete artículos ya está completa:
- Introducción a los microservicios
- Creación de microservicios: uso de una puerta de enlace de API (este artículo)
- Creación de microservicios: comunicación entre procesos en una arquitectura de microservicios
- Descubrimiento de servicios en una arquitectura de microservicios
- Gestión de datos basada en eventos para microservicios
- Cómo elegir una estrategia de despliegue de microservicios
- Refactorización de un monolito en microservicios
También puede descargar la colección completa de artículos, junto con información sobre cómo implementar microservicios con NGINX Plus, en formato de libro electrónico: «Microservicios: del diseño a la implementación». Asimismo, le recomendamos consultar la nueva página de soluciones de microservicios.
El primer artículo de esta serie de siete partes sobre el diseño, la creación y la implementación de microservicios presentó el patrón de arquitectura de microservicios. En él se analizaron las ventajas y desventajas de utilizar microservicios y cómo, a pesar de su complejidad, suelen ser la opción ideal para aplicaciones complejas. Este es el segundo artículo de la serie y abordará la creación de microservicios mediante una puerta de enlace de API.
Cuando decides crear tu aplicación como un conjunto de microservicios, debes determinar cómo interactuarán los clientes de la aplicación con ellos. En una aplicación monolítica solo hay un conjunto de puntos de conexión (normalmente replicados y con equilibrio de carga). Sin embargo, en una arquitectura de microservicios, cada microservicio expone un conjunto de puntos de conexión que suelen ser muy específicos. En este artículo analizamos cómo afecta esto a la comunicación entre el cliente y la aplicación, y proponemos un enfoque que utiliza una puerta de enlace de API.
Introducción
Imaginemos que estás desarrollando un cliente móvil nativo para una aplicación de compras. Es probable que necesites implementar una página de detalles del producto que muestre información sobre cualquier producto determinado.
Por ejemplo, el siguiente diagrama muestra lo que verá al desplazarse por los detalles del producto en la aplicación móvil de Amazon para Android.
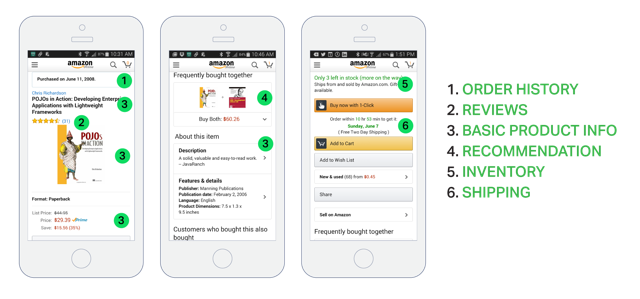
Aunque se trata de una aplicación para smartphones, la página de detalles del producto muestra mucha información. Por ejemplo, además de la información básica del producto (como el nombre, la descripción y el precio), esta página también muestra:
- Número de artículos en el carrito de compra
- Historial de pedidos
- Reseñas de clientes
- Aviso de existencias bajas
- Opciones de envío
- Varias recomendaciones, incluidos otros productos que suelen comprarse junto con este producto, otros productos adquiridos por clientes que compraron este producto y otros productos vistos por clientes que compraron este producto
- Opciones de compra alternativas
Al utilizar una arquitectura de aplicación monolítica, un cliente móvil recuperaría estos datos realizando una única llamada REST (GET api.company.com/productdetails/productId) a la aplicación. Un balanceador de carga dirige la solicitud a una de las N instancias idénticas de la aplicación. A continuación, la aplicación consultaría varias tablas de la base de datos y devolvería la respuesta al cliente.
En cambio, cuando se utiliza una arquitectura de microservicios, los datos que se muestran en la página de detalles del producto pertenecen a varios microservicios. Estos son algunos de los posibles microservicios a los que pertenecen los datos mostrados en la página de detalles del producto del ejemplo:
- Servicio de carrito de la compra – Número de artículos en el carrito de la compra
- Servicio de pedidos – Historial de pedidos
- Servicio de catálogo – Información básica del producto, como su nombre, imagen y precio
- Servicio de reseñas – Reseñas de clientes
- Servicio de inventario – Aviso de existencias bajas
- Servicio de envíos – Opciones, plazos y costes de envío obtenidos por separado de la API del proveedor de envíos
- Servicio(s) de recomendaciones – Artículos sugeridos
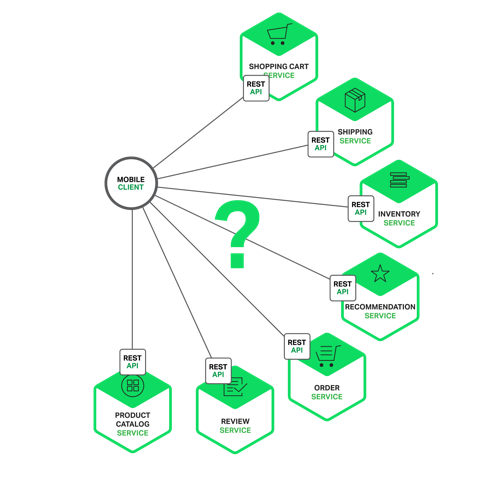
Tenemos que decidir cómo accede el cliente móvil a estos servicios. Veamos las opciones.
Comunicación directa entre el cliente y los microservicios
En teoría, un cliente podría enviar solicitudes directamente a cada uno de los microservicios. Cada microservicio tendría un punto de conexión público (https://serviceName.api.company.name). Esta URL apuntaría al balanceador de carga del microservicio, que distribuiría las solicitudes entre las instancias disponibles. Para obtener los detalles del producto, el cliente móvil enviaría solicitudes a cada uno de los servicios indicados anteriormente.
Lamentablemente, esta opción presenta dificultades y limitaciones. Uno de los problemas es el desajuste entre las necesidades del cliente y las API específicas que expone cada uno de los microservicios. En este ejemplo, el cliente tiene que realizar siete solicitudes independientes. En aplicaciones más complejas, podría tener que realizar muchas más. Por ejemplo, Amazon explica que cientos de servicios intervienen en la generación de su página de producto. Aunque un cliente podría realizar tantas solicitudes a través de una red LAN, probablemente sería demasiado ineficiente hacerlo a través de la Internet pública y, sin duda, resultaría inviable en una red móvil. Este enfoque también hace que el código del cliente sea mucho más complejo.
Otro problema de que el cliente llame directamente a los microservicios es que algunos podrían utilizar protocolos poco compatibles con la web. Un servicio podría utilizar RPC binario de Thrift, mientras que otro podría utilizar el protocolo de mensajería AMQP. Ninguno de estos protocolos es especialmente compatible con los navegadores ni con los cortafuegos, por lo que es preferible utilizarlos internamente. Fuera del cortafuegos, una aplicación debería utilizar protocolos como HTTP y WebSocket.
Otro inconveniente de este enfoque es que dificulta la refactorización de los microservicios. Con el tiempo, puede que queramos cambiar la forma en que el sistema se divide en servicios. Por ejemplo, podríamos fusionar dos servicios o dividir uno en dos o más servicios. Sin embargo, si los clientes se comunican directamente con los servicios, llevar a cabo este tipo de refactorización puede resultar extremadamente difícil.
Debido a este tipo de problemas, rara vez tiene sentido que los clientes se comuniquen directamente con los microservicios.
Uso de una puerta de enlace de API
Por lo general, un enfoque mucho mejor consiste en utilizar lo que se conoce como una puerta de enlace de API. Una puerta de enlace de API es un servidor que actúa como único punto de entrada al sistema. Es similar al patrón Fachada del diseño orientado a objetos. La puerta de enlace de API encapsula la arquitectura interna del sistema y proporciona una API adaptada a cada cliente. También puede asumir otras responsabilidades, como la autenticación, la supervisión, el equilibrio de carga, el almacenamiento en caché, la configuración y gestión de solicitudes y la gestión de respuestas estáticas.
El siguiente diagrama muestra cómo suele integrarse una puerta de enlace de API en la arquitectura:
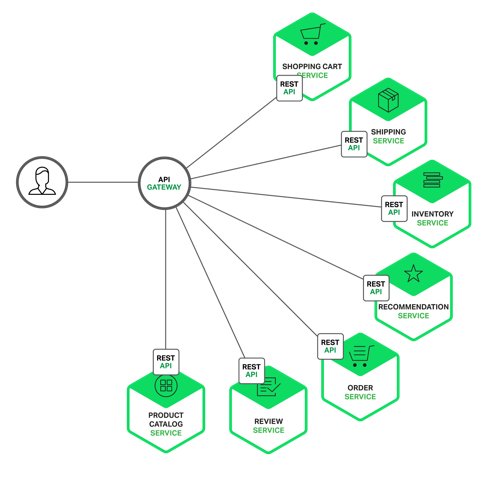
La puerta de enlace de API se encarga del enrutamiento y la composición de las solicitudes, así como de la traducción de protocolos. Todas las solicitudes de los clientes pasan primero por la puerta de enlace de API, que las dirige al microservicio correspondiente. A menudo, la puerta de enlace de API procesa una solicitud invocando varios microservicios y agregando los resultados. Puede traducir entre protocolos web, como HTTP y WebSocket, y protocolos no compatibles con la web que se utilizan internamente.
La puerta de enlace de API también puede proporcionar a cada cliente una API personalizada. Normalmente, ofrece una API de grano grueso para clientes móviles. Pensemos, por ejemplo, en el caso de los detalles de un producto. La puerta de enlace de API puede proporcionar un punto de conexión (/productdetails?productid=xxx) que permite a un cliente móvil obtener todos los detalles del producto con una sola solicitud. La puerta de enlace de API gestiona la solicitud invocando los distintos servicios —información del producto, recomendaciones, reseñas, etc.— y combinando los resultados.
Un excelente ejemplo de una puerta de enlace de API es la puerta de enlace de API de Netflix. El servicio de streaming de Netflix está disponible en cientos de tipos de dispositivos diferentes, como televisores, descodificadores, smartphones, consolas de videojuegos, tabletas, etc. Al principio, Netflix intentó ofrecer una API única para todos para su servicio de streaming. Sin embargo, descubrió que no funcionaba bien debido a la gran variedad de dispositivos y a sus necesidades específicas. Actualmente, utiliza una puerta de enlace de API que proporciona una API adaptada a cada dispositivo mediante la ejecución de código adaptador específico para dicho dispositivo. Por lo general, un adaptador gestiona cada solicitud invocando una media de entre seis y siete servicios de backend. La puerta de enlace de API de Netflix gestiona miles de millones de solicitudes al día.
Ventajas y desventajas de una puerta de enlace de API
Como cabría esperar, el uso de una puerta de enlace de API presenta tanto ventajas como inconvenientes. Una de sus principales ventajas es que encapsula la estructura interna de la aplicación. En lugar de tener que invocar servicios específicos, los clientes se comunican directamente con la puerta de enlace. La puerta de enlace de API proporciona una API específica para cada tipo de cliente. Esto reduce el número de intercambios entre el cliente y la aplicación, además de simplificar el código del cliente.
La puerta de enlace de API también presenta algunos inconvenientes. Es otro componente de alta disponibilidad que debe desarrollarse, implementarse y gestionarse. También existe el riesgo de que la puerta de enlace de API se convierta en un cuello de botella para el desarrollo. Los desarrolladores deben actualizarla para exponer los endpoints de cada microservicio. Es importante que el proceso de actualización de la puerta de enlace de API sea lo más ágil posible. De lo contrario, los desarrolladores se verán obligados a esperar su turno para actualizarla. Sin embargo, a pesar de estos inconvenientes, en la mayoría de las aplicaciones reales tiene sentido utilizar una puerta de enlace de API.
Implementación de una puerta de enlace de API
Ahora que hemos analizado las motivaciones y las ventajas e inconvenientes de utilizar una puerta de enlace de API, veamos varias cuestiones de diseño que debe tener en cuenta.
Rendimiento y escalabilidad
Solo unas pocas empresas operan a la escala de Netflix y necesitan gestionar miles de millones de solicitudes al día. Sin embargo, para la mayoría de las aplicaciones, el rendimiento y la escalabilidad de la puerta de enlace de API suelen ser muy importantes. Por tanto, tiene sentido desarrollar la puerta de enlace de API sobre una plataforma que admita E/S asíncrona y no bloqueante. Existen diversas tecnologías que pueden utilizarse para implementar una puerta de enlace de API escalable. En la JVM se puede utilizar uno de los frameworks basados en NIO, como Netty, Vertx, Spring Reactor o JBoss Undertow. Una opción popular ajena a la JVM es Node.js, una plataforma basada en el motor JavaScript de Chrome. Otra opción es utilizar NGINX Plus. NGINX Plus ofrece un servidor web y un proxy inverso maduros, escalables y de alto rendimiento, que se pueden desplegar, configurar y programar fácilmente. NGINX Plus puede gestionar la autenticación, el control de acceso, el equilibrio de carga de las solicitudes y el almacenamiento en caché de las respuestas, además de proporcionar comprobaciones de estado y supervisión adaptadas a la aplicación.
Uso de un modelo de programación reactiva
La puerta de enlace de API gestiona algunas solicitudes simplemente dirigiéndolas al servicio de backend correspondiente. Otras solicitudes las gestiona invocando varios servicios de backend y agregando los resultados. En algunas solicitudes, como las de detalles de un producto, las solicitudes a los servicios de backend son independientes entre sí. Para minimizar el tiempo de respuesta, la puerta de enlace de API debe realizar las solicitudes independientes de forma simultánea. Sin embargo, a veces existen dependencias entre las solicitudes. Es posible que la puerta de enlace de API tenga que validar primero la solicitud llamando a un servicio de autenticación antes de dirigirla a un servicio de backend. Del mismo modo, para obtener información sobre los productos de la lista de deseos de un cliente, la puerta de enlace de API debe recuperar primero el perfil del cliente que contiene dicha información y, a continuación, obtener la información de cada producto. Otro ejemplo interesante de composición de API es la cuadrícula de vídeos de Netflix.
Escribir código de composición de API mediante el enfoque tradicional de retrollamadas asíncronas conduce rápidamente al infierno de las retrollamadas. El código será enrevesado, difícil de entender y propenso a errores. Un enfoque mucho mejor consiste en escribir el código de la puerta de enlace de API con un estilo declarativo y un enfoque reactivo. Algunos ejemplos de abstracciones reactivas son Future en Scala, CompletableFuture en Java 8 y Promise en JavaScript. También existe Reactive Extensions (también llamado Rx o ReactiveX), desarrollado originalmente por Microsoft para la plataforma .NET. Netflix creó RxJava para la JVM específicamente para utilizarlo en su puerta de enlace de API. También existe RxJS para JavaScript, que se ejecuta tanto en el navegador como en Node.js. El uso de un enfoque reactivo permite escribir código sencillo y eficiente para la puerta de enlace de API.
Invocación de servicios
Una aplicación basada en microservicios es un sistema distribuido y debe utilizar un mecanismo de comunicación entre procesos. Existen dos tipos de comunicación entre procesos. Una opción consiste en utilizar un mecanismo asíncrono basado en mensajería. Algunas implementaciones utilizan un bróker de mensajes, como JMS o AMQP. Otras, como Zeromq, no utilizan ningún bróker y los servicios se comunican directamente. El otro tipo de comunicación entre procesos es un mecanismo síncrono, como HTTP o Thrift. Por lo general, un sistema utilizará tanto el modelo asíncrono como el síncrono. Incluso puede utilizar varias implementaciones de cada modelo. Por consiguiente, la puerta de enlace de la API deberá admitir diversos mecanismos de comunicación.
Descubrimiento de servicios
La puerta de enlace de API necesita conocer la ubicación (dirección IP y puerto) de cada microservicio con el que se comunica. En una aplicación tradicional, probablemente se podrían configurar las ubicaciones de forma fija, pero en una aplicación moderna de microservicios basada en la nube, este no es un problema trivial. Los servicios de infraestructura, como un bróker de mensajes, suelen tener una ubicación estática que puede especificarse mediante variables de entorno del sistema operativo. Sin embargo, determinar la ubicación de un servicio de aplicación no es tan sencillo. Las ubicaciones de los servicios de aplicación se asignan dinámicamente. Además, el conjunto de instancias de un servicio cambia de forma dinámica debido al escalado automático y a las actualizaciones. Por tanto, la puerta de enlace de API, como cualquier otro cliente de servicio del sistema, debe utilizar el mecanismo de descubrimiento de servicios del sistema: ya sea descubrimiento del lado del servidor o descubrimiento del lado del cliente. En un artículo posterior se describirá con más detalle el descubrimiento de servicios. Por ahora, conviene señalar que, si el sistema utiliza el descubrimiento del lado del cliente, la puerta de enlace de API debe poder consultar el registro de servicios, que es una base de datos de todas las instancias de microservicios y sus ubicaciones.
Gestión de fallos parciales
Otro problema que debe abordar al implementar una puerta de enlace de API es el de los fallos parciales. Este problema surge en todos los sistemas distribuidos cuando un servicio llama a otro que responde con lentitud o no está disponible. La puerta de enlace de API nunca debe quedarse bloqueada indefinidamente esperando a un servicio posterior. Sin embargo, la forma de gestionar el fallo depende del escenario concreto y del servicio que esté fallando. Por ejemplo, si el servicio de recomendaciones no responde en el escenario de los detalles del producto, la puerta de enlace de API debe devolver al cliente el resto de los detalles del producto, ya que siguen siendo útiles para el usuario. Las recomendaciones podrían estar vacías o sustituirse, por ejemplo, por una lista predefinida de los diez productos más destacados. Sin embargo, si el servicio de información del producto no responde, la puerta de enlace de API debe devolver un error al cliente.
La puerta de enlace de API también podría devolver datos almacenados en caché si estuvieran disponibles. Por ejemplo, dado que los precios de los productos cambian con poca frecuencia, la puerta de enlace de API podría devolver datos de precios almacenados en caché si el servicio de precios no estuviera disponible. La propia puerta de enlace de API puede almacenar los datos en caché, o bien estos pueden guardarse en una caché externa, como Redis o Memcached. Al devolver datos predeterminados o almacenados en caché, la puerta de enlace de API garantiza que los fallos del sistema no afecten a la experiencia del usuario.
Netflix Hystrix es una biblioteca increíblemente útil para escribir código que invoca servicios remotos. Hystrix establece un tiempo de espera para las llamadas que superan el umbral especificado. Implementa un patrón de cortocircuito que evita que el cliente espere innecesariamente a un servicio que no responde. Si la tasa de errores de un servicio supera un umbral especificado, Hystrix activa el cortocircuito y todas las solicitudes fallan de inmediato durante un periodo de tiempo determinado. Hystrix permite definir una acción alternativa cuando falla una solicitud, como leer datos de una caché o devolver un valor predeterminado. Si utiliza la JVM, debería plantearse seriamente usar Hystrix. Y si trabaja en un entorno que no sea JVM, debería utilizar una biblioteca equivalente.
Resumen
Para la mayoría de las aplicaciones basadas en microservicios, tiene sentido implementar una puerta de enlace de API, que actúe como punto de entrada único al sistema. La puerta de enlace de API se encarga del enrutamiento y la composición de las solicitudes, así como de la traducción de protocolos. Proporciona una API personalizada a cada cliente de la aplicación. También puede ocultar los fallos de los servicios de backend devolviendo datos almacenados en caché o predeterminados. En el próximo artículo de la serie, analizaremos la comunicación entre servicios.
Editor – Esta serie de siete artículos ya está completa:
- Introducción a los microservicios
- Creación de microservicios: uso de una puerta de enlace de API (este artículo)
- Creación de microservicios: comunicación entre procesos en una arquitectura de microservicios
- Descubrimiento de servicios en una arquitectura de microservicios
- Gestión de datos basada en eventos para microservicios
- Cómo elegir una estrategia de despliegue de microservicios
- Refactorización de un monolito en microservicios
También puede descargar la colección completa de artículos, junto con información sobre cómo implementar microservicios con NGINX Plus, en formato de libro electrónico: «Microservicios: del diseño a la implementación».
Para obtener información detallada sobre otros casos de uso, consulte nuestra serie de tres artículos del blog, «Implementación de NGINX Plus como puerta de enlace de API»:
- Parte 1 proporciona instrucciones de configuración detalladas para varios casos de uso.
- Parte 2 amplía esos casos de uso y analiza una serie de medidas de protección que pueden aplicarse para proteger y asegurar los servicios de API de backend en producción.
- Parte 3 explica cómo implementar NGINX Plus como puerta de enlace de API para servicios gRPC.
El bloguero invitado Chris Richardson es el fundador de la plataforma original CloudFoundry.com, una de las primeras PaaS (plataforma como servicio) de Java para Amazon EC2. Actualmente asesora a organizaciones para mejorar la forma en que desarrollan e implementan aplicaciones. También publica regularmente sobre microservicios en http://microservices.io.
Sobre el autor
Artículos relacionados del blog

Únete a F5 NGINX en AppWorld 2024
Descubre las numerosas razones para asistir al evento insignia de F5, que incluirá un emocionante anuncio sobre la cartera de productos NGINX.
Rotación de certificados SSL/TLS sin reinicios en NGINX Open Source
La función de diccionario compartido permite configurar NGINX sin necesidad de reiniciarlo al renovar los certificados SSL/TLS.
Exposición de APIs en Kubernetes
La unidad 2 de Microservices March 2022 se centra en cómo exponer tus API en Kubernetes. Aquí tienes enlaces a los recursos que necesitas: la retransmisión en directo del 14 de marzo, artículos de blog y otros recursos de preparación, y el laboratorio práctico «Protege las API de Kubernetes mediante la limitación de solicitudes».
NGINX Sprint 2.0: visión clara, código renovado y nuevos compromisos con el código abierto
Hoy, en NGINX Sprint 2.0, anunciamos cómo respaldaremos nuestra visión del futuro de las aplicaciones modernas con una mayor presencia en la comunidad de código abierto, incluida la participación en el proyecto comunitario Kubernetes, nuevos proyectos de software de código abierto y la arquitectura de referencia para aplicaciones modernas.
Presentamos NGINX Plus R22
NGINX Plus R22 incorpora nuevas funcionalidades, como la compatibilidad con OCSP para verificar la revocación de certificados en TLS mutuo, el uso de varios proveedores de identidad OIDC en una configuración, el seguimiento en tiempo real de la limitación de solicitudes y conexiones en el panel de NGINX Plus y mejoras en NGINX JavaScript.
Presentamos NGINX Plus R17
NGINX Plus R17 incorpora compatibilidad con la limitación de velocidad en dos fases y con TLS 1.3, la versión más reciente del protocolo Transport Layer Security. La configuración de OpenID Connect es más sencilla y NGINX ModSecurity WAF es el doble de rápido que antes. También se ha actualizado el módulo JavaScript de NGINX.