Editor – Esta serie de siete artículos ya está completa:
- Introducción a los microservicios
- Creación de microservicios: uso de una puerta de enlace de API
- Creación de microservicios: comunicación entre procesos en una arquitectura de microservicios
- Descubrimiento de servicios en una arquitectura de microservicios (este artículo)
- Gestión de datos basada en eventos para microservicios
- Cómo elegir una estrategia de despliegue de microservicios
- Refactorización de un monolito en microservicios
También puede descargar la colección completa de artículos, junto con información sobre cómo implementar microservicios con NGINX Plus, en formato de libro electrónico: «Microservicios: del diseño a la implementación». Asimismo, consulte la nueva página de soluciones de microservicios.
Este es el cuarto artículo de nuestra serie sobre la creación de aplicaciones con microservicios. El primer artículo presenta el patrón de arquitectura de microservicios y analiza las ventajas y desventajas de utilizar microservicios. Los artículos segundo<.htmla> y tercero de la serie describen distintos aspectos de la comunicación dentro de una arquitectura de microservicios. En este artículo, exploramos el problema estrechamente relacionado del descubrimiento de servicios.
¿Por qué utilizar el descubrimiento de servicios?
Imaginemos que está escribiendo código que invoca un servicio que dispone de una API REST o una API Thrift. Para realizar una solicitud, el código necesita conocer la ubicación de red (dirección IP y puerto) de una instancia del servicio. En una aplicación tradicional que se ejecuta en hardware físico, las ubicaciones de red de las instancias del servicio son relativamente estáticas. Por ejemplo, el código puede leer las ubicaciones de red de un archivo de configuración que se actualiza ocasionalmente.
Sin embargo, en una aplicación moderna de microservicios basada en la nube, este problema es mucho más difícil de resolver, como se muestra en el siguiente diagrama.
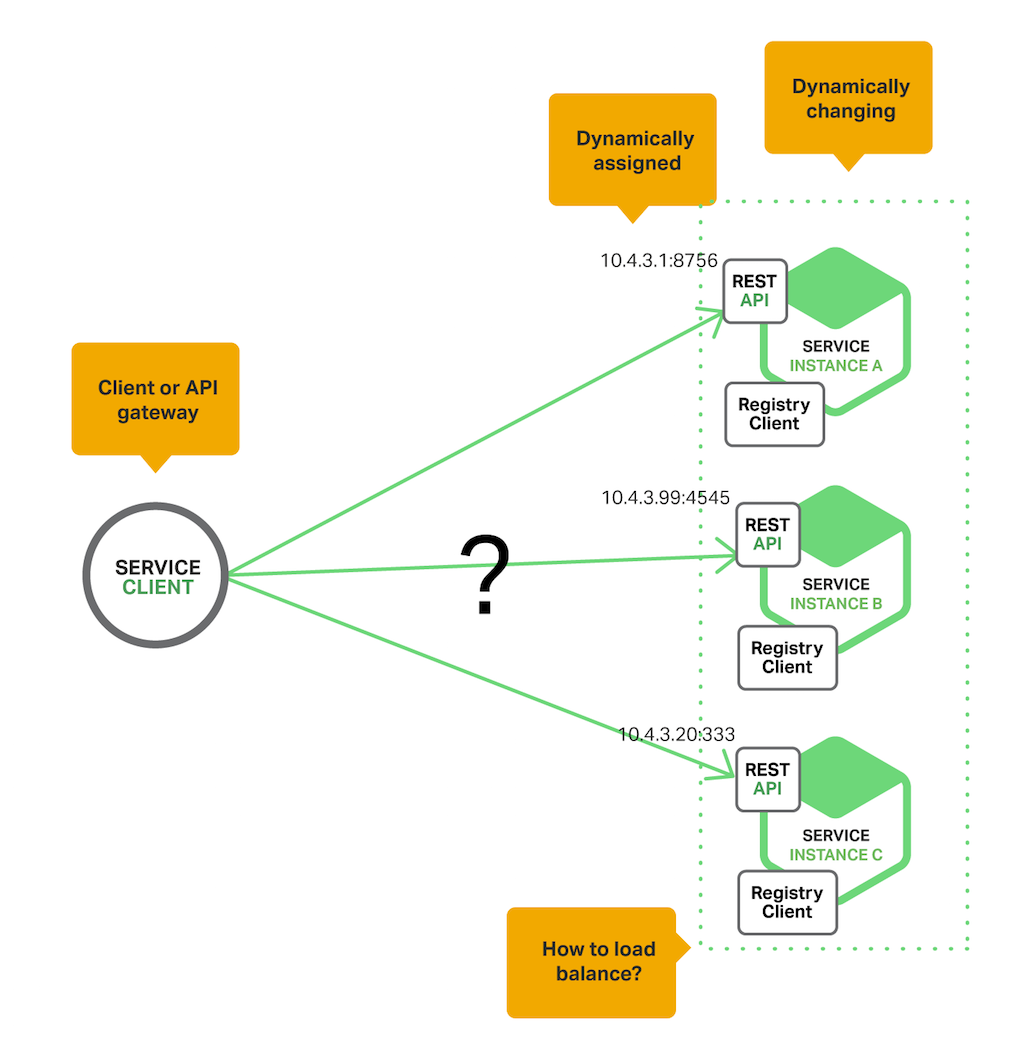
Las instancias de servicio tienen ubicaciones de red asignadas dinámicamente. Además, el conjunto de instancias de servicio cambia de forma dinámica debido al escalado automático, los fallos y las actualizaciones. Por consiguiente, el código del cliente debe utilizar un mecanismo de descubrimiento de servicios más sofisticado.
Existen dos patrones principales de descubrimiento de servicios: descubrimiento del lado del cliente y descubrimiento del lado del servidor. Veamos primero el descubrimiento del lado del cliente.
El patrón de descubrimiento del lado del cliente
Cuando se utiliza el descubrimiento del lado del cliente, el cliente se encarga de determinar las ubicaciones de red de las instancias de servicio disponibles y de equilibrar las solicitudes entre ellas. El cliente consulta un registro de servicios, que es una base de datos de las instancias de servicio disponibles. A continuación, utiliza un algoritmo de equilibrio de carga para seleccionar una de las instancias de servicio disponibles y realizar una solicitud.
El siguiente diagrama muestra la estructura de este patrón.
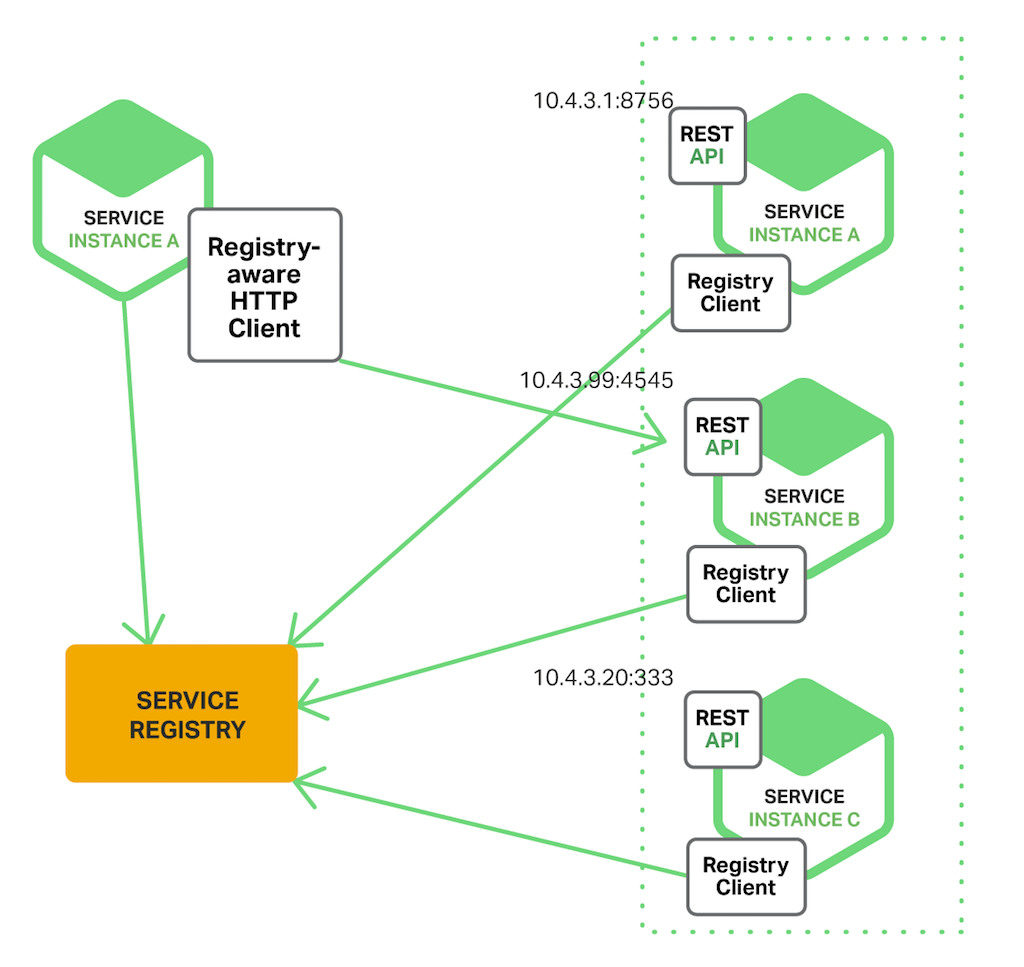
La ubicación de red de una instancia de servicio se registra en el registro de servicios cuando se inicia. Se elimina del registro de servicios cuando la instancia finaliza. El registro de la instancia de servicio suele actualizarse periódicamente mediante un mecanismo de latido.
Netflix OSS ofrece un excelente ejemplo del patrón de descubrimiento del lado del cliente. Netflix Eureka es un registro de servicios. Proporciona una API REST para gestionar el registro de instancias de servicio y consultar las instancias disponibles. Netflix Ribbon es un cliente IPC que funciona con Eureka para equilibrar la carga de las solicitudes entre las instancias de servicio disponibles. Más adelante en este artículo analizaremos Eureka con mayor profundidad.
El patrón de descubrimiento del lado del cliente presenta diversas ventajas e inconvenientes. Este patrón es relativamente sencillo y, aparte del registro de servicios, no hay otros componentes implicados. Además, como el cliente conoce las instancias de servicio disponibles, puede tomar decisiones inteligentes de equilibrio de carga específicas de la aplicación, como utilizar un hash coherente. Un inconveniente importante de este patrón es que acopla el cliente al registro de servicios. Debe implementar la lógica de descubrimiento de servicios del lado del cliente para cada lenguaje de programación y framework que utilicen sus clientes de servicio.
Ahora que hemos visto el descubrimiento del lado del cliente, veamos el descubrimiento del lado del servidor.
El patrón de descubrimiento del lado del servidor
El otro enfoque para la detección de servicios es el patrón de detección del lado del servidor. El siguiente diagrama muestra la estructura de este patrón.
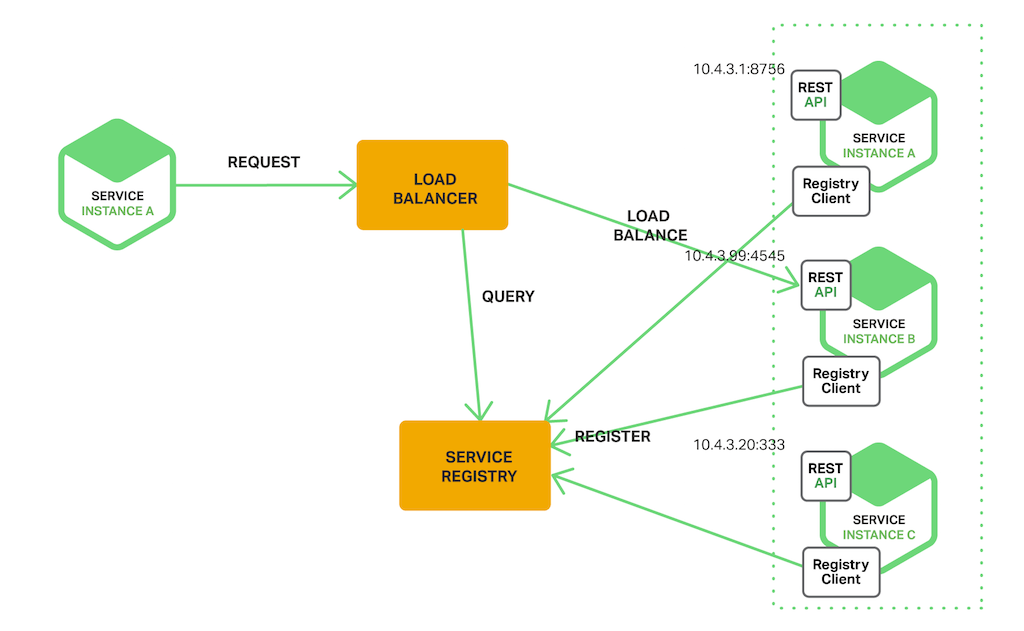
El cliente realiza una solicitud a un servicio a través de un equilibrador de carga. El equilibrador de carga consulta el registro de servicios y dirige cada solicitud a una instancia de servicio disponible. Al igual que con la detección del lado del cliente, las instancias de servicio se registran y se dan de baja en el registro de servicios.
El AWS Elastic Load Balancer (ELB) es un ejemplo de enrutador de detección del lado del servidor. Un ELB se utiliza habitualmente para equilibrar el tráfico externo procedente de Internet. Sin embargo, también se puede utilizar para equilibrar el tráfico interno de una nube privada virtual (VPC). Un cliente realiza solicitudes (HTTP o TCP) a través del ELB utilizando su nombre DNS. El ELB equilibra el tráfico entre un conjunto de instancias registradas de Elastic Compute Cloud (EC2) o contenedores de EC2 Container Service (ECS). No existe un registro de servicios independiente. En su lugar, las instancias de EC2 y los contenedores de ECS se registran en el propio ELB.
Los servidores HTTP y los balanceadores de carga como NGINX Plus y NGINX también pueden utilizarse como balanceadores de carga con detección del lado del servidor. Por ejemplo, esta entrada de blog describe cómo utilizar Consul Template para reconfigurar dinámicamente el proxy inverso de NGINX. Consul Template es una herramienta que regenera periódicamente archivos de configuración arbitrarios a partir de los datos de configuración almacenados en el registro de servicios de Consul. Ejecuta un comando de shell arbitrario cada vez que cambian los archivos. En el ejemplo descrito en la entrada de blog, Consul Template genera un archivo nginx.conf, que configura el proxy inverso, y después ejecuta un comando que indica a NGINX que vuelva a cargar la configuración. Una implementación más sofisticada podría reconfigurar dinámicamente NGINX Plus mediante su API HTTP o DNS.
Algunos entornos de despliegue, como Kubernetes y Marathon, ejecutan un proxy en cada host del clúster. El proxy actúa como equilibrador de carga para la detección de servicios del lado del servidor. Para realizar una solicitud a un servicio, el cliente la enruta a través del proxy utilizando la dirección IP del host y el puerto asignado al servicio. A continuación, el proxy reenvía de forma transparente la solicitud a una instancia disponible del servicio que se esté ejecutando en algún lugar del clúster.
El patrón de descubrimiento del lado del servidor presenta varias ventajas e inconvenientes. Una gran ventaja de este patrón es que los detalles del descubrimiento quedan abstraídos del cliente. Los clientes simplemente envían solicitudes al balanceador de carga. Esto elimina la necesidad de implementar la lógica de descubrimiento para cada lenguaje de programación y framework que utilicen los clientes de sus servicios. Además, como se ha mencionado anteriormente, algunos entornos de despliegue ofrecen esta funcionalidad de forma gratuita. Sin embargo, este patrón también presenta algunos inconvenientes. A menos que el entorno de despliegue proporcione el balanceador de carga, este constituye otro componente de alta disponibilidad del sistema que deberá configurar y gestionar.
El registro de servicios
El registro de servicios es una parte fundamental del descubrimiento de servicios. Se trata de una base de datos que contiene las ubicaciones de red de las instancias de servicio. Un registro de servicios debe ofrecer una alta disponibilidad y estar actualizado. Los clientes pueden almacenar en caché las ubicaciones de red obtenidas del registro de servicios. Sin embargo, con el tiempo esa información queda obsoleta y los clientes dejan de poder descubrir instancias de servicio. Por consiguiente, un registro de servicios consta de un clúster de servidores que utilizan un protocolo de replicación para mantener la coherencia.
Como se mencionó anteriormente, Netflix Eureka es un buen ejemplo de registro de servicios. Proporciona una API REST para registrar y consultar instancias de servicios. Una instancia de servicio registra su ubicación de red mediante una solicitud POST. Cada 30 segundos, debe renovar su registro mediante una solicitud PUT. Un registro se elimina mediante una solicitud HTTP DELETE o cuando caduca el registro de la instancia. Como cabría esperar, un cliente puede recuperar las instancias de servicios registradas mediante una solicitud HTTP GET.
Netflix logra una alta disponibilidad ejecutando uno o varios servidores Eureka en cada zona de disponibilidad de Amazon EC2. Cada servidor Eureka se ejecuta en una instancia EC2 que tiene una dirección IP elástica. Los registros TEXT de DNS se utilizan para almacenar la configuración del clúster de Eureka, que consiste en una correspondencia entre las zonas de disponibilidad y una lista de las ubicaciones de red de los servidores Eureka. Cuando se inicia un servidor Eureka, consulta el DNS para recuperar la configuración del clúster de Eureka, localiza a sus pares y se asigna una dirección IP elástica que no esté en uso.
Los clientes de Eureka —servicios y clientes de servicios— consultan el DNS para descubrir las ubicaciones de red de los servidores de Eureka. Los clientes prefieren utilizar un servidor de Eureka que se encuentre en la misma zona de disponibilidad. Sin embargo, si no hay ninguno disponible, utilizan un servidor de Eureka de otra zona de disponibilidad.
Otros ejemplos de registros de servicios son:
- etcd – Un almacén de pares clave-valor distribuido, coherente y de alta disponibilidad que se utiliza para la configuración compartida y el descubrimiento de servicios. Dos proyectos destacados que utilizan etcd son Kubernetes y Cloud Foundry.
- consul – Una herramienta para descubrir y configurar servicios. Proporciona una API que permite a los clientes registrar y descubrir servicios. Consul puede realizar comprobaciones de estado para determinar la disponibilidad de los servicios.
- Apache Zookeeper – Un servicio de coordinación de alto rendimiento ampliamente utilizado para aplicaciones distribuidas. Apache Zookeeper fue originalmente un subproyecto de Hadoop, pero ahora es un proyecto de primer nivel.
Además, como se ha señalado anteriormente, algunos sistemas como Kubernetes, Marathon y AWS no disponen de un registro de servicios explícito. En su lugar, el registro de servicios forma parte de la propia infraestructura.
Ahora que hemos visto el concepto de registro de servicios, veamos cómo se registran las instancias de servicio en él.
Opciones de registro de servicios
Como se ha mencionado anteriormente, las instancias de servicio deben registrarse en el registro de servicios y darse de baja de él. Existen varias formas de gestionar el alta y la baja. Una opción es que las propias instancias de servicio se registren, lo que se conoce como patrón de autorregistro. La otra opción es que otro componente del sistema gestione el registro de las instancias de servicio, lo que se conoce como patrón de registro por terceros. Veamos primero el patrón de autorregistro.
El patrón de autorregistro
Cuando se utiliza el patrón de autorregistro, una instancia de servicio se encarga de registrarse y darse de baja en el registro de servicios. Además, si es necesario, envía solicitudes de latido para evitar que su registro caduque. El siguiente diagrama muestra la estructura de este patrón.
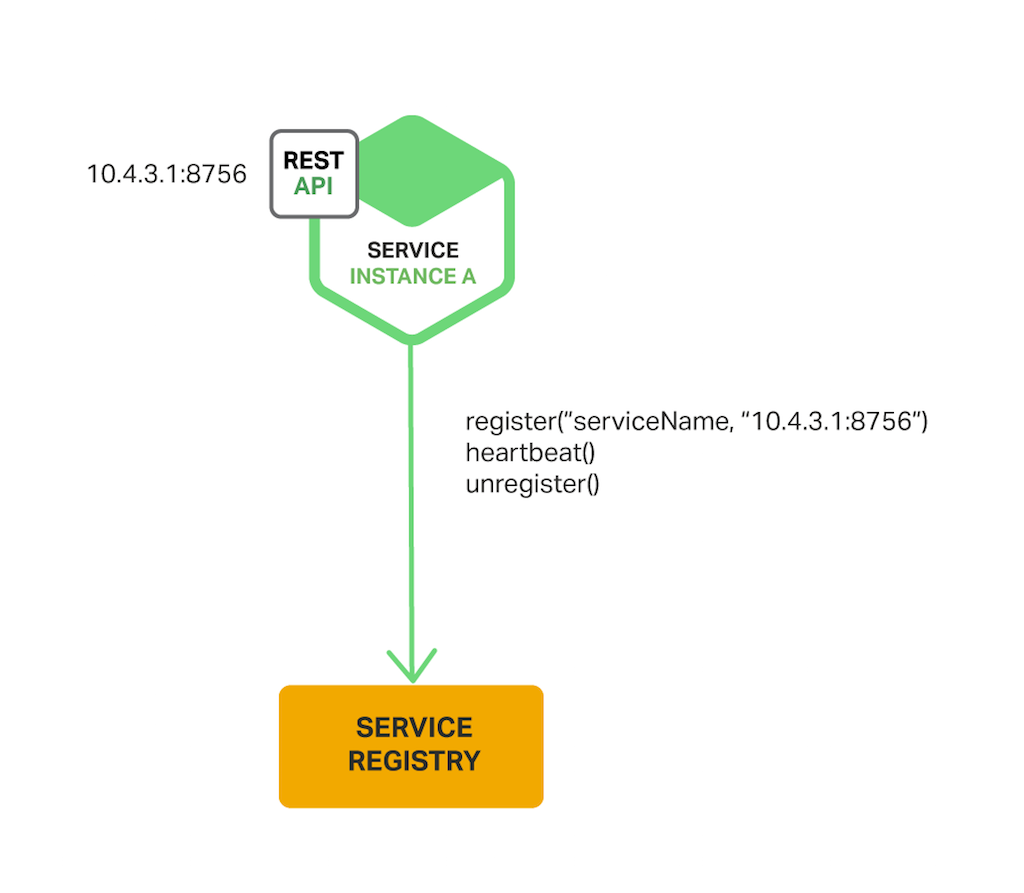
Un buen ejemplo de este enfoque es el cliente Eureka de Netflix OSS. El cliente Eureka se encarga de todos los aspectos del registro y la anulación del registro de las instancias de servicio. El proyecto Spring Cloud, que implementa varios patrones, incluido el descubrimiento de servicios, permite registrar automáticamente y de forma sencilla una instancia de servicio en Eureka. Basta con añadir a la clase de configuración de Java la anotación @EnableEurekaClient.
El patrón de autorregistro presenta diversas ventajas e inconvenientes. Una de sus ventajas es que es relativamente sencillo y no requiere ningún otro componente del sistema. Sin embargo, un inconveniente importante es que acopla las instancias de servicio al registro de servicios. Debe implementar el código de registro en cada lenguaje de programación y framework que utilicen sus servicios.
El enfoque alternativo, que desacopla los servicios del registro de servicios, es el patrón de registro de terceros.
El patrón de registro de terceros
Cuando se utiliza el patrón de registro mediante terceros, las instancias de servicio no son responsables de registrarse en el registro de servicios. En su lugar, otro componente del sistema, conocido como registrador de servicios, se encarga del registro. El registrador de servicios realiza un seguimiento de los cambios en el conjunto de instancias en ejecución, ya sea consultando periódicamente el entorno de despliegue o suscribiéndose a eventos. Cuando detecta una nueva instancia de servicio disponible, la registra en el registro de servicios. El registrador de servicios también da de baja las instancias de servicio que han finalizado. El siguiente diagrama muestra la estructura de este patrón.
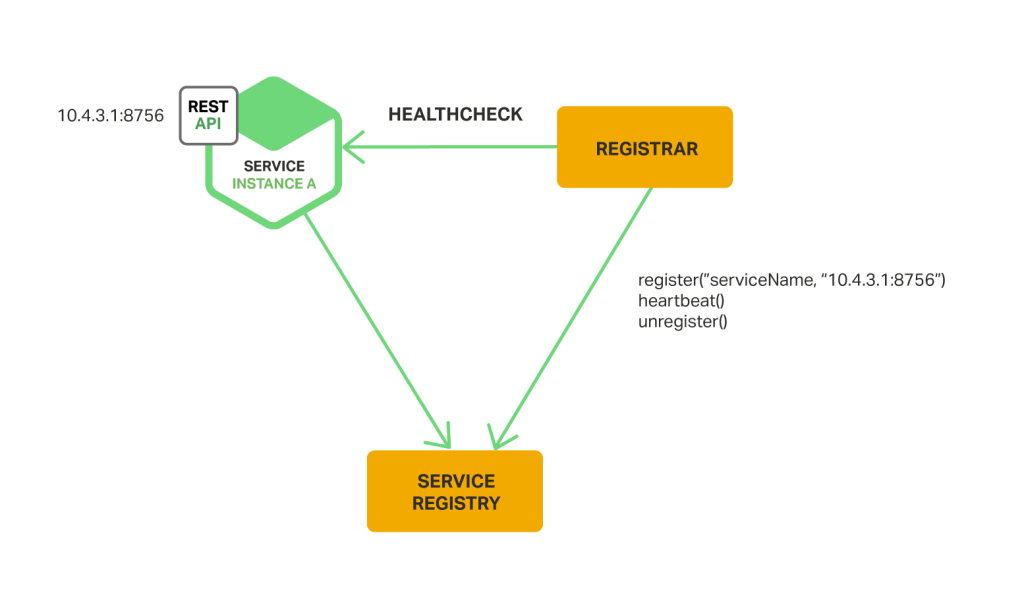
Un ejemplo de registrador de servicios es el proyecto de código abierto «Registrator». Este registra y da de baja automáticamente las instancias de servicio implementadas como contenedores Docker. Registrator admite varios registros de servicios, entre ellos etcd y Consul.
Otro ejemplo de registrador de servicios es NetflixOSS Prana. Diseñada principalmente para servicios escritos en lenguajes que no se ejecutan en la JVM, es una aplicación auxiliar que se ejecuta junto a una instancia de servicio. Prana registra y anula el registro de la instancia de servicio en Netflix Eureka.
El registrador de servicios es un componente integrado en los entornos de despliegue. Las instancias EC2 creadas por un grupo de escalado automático pueden registrarse automáticamente en un ELB. Los servicios de Kubernetes se registran automáticamente y quedan disponibles para su detección.
El patrón de registro mediante terceros presenta diversas ventajas e inconvenientes. Una ventaja importante es que los servicios están desacoplados del registro de servicios. No es necesario implementar la lógica de registro de servicios para cada lenguaje de programación y framework que utilicen los desarrolladores. En su lugar, el registro de las instancias de servicio se gestiona de forma centralizada mediante un servicio específico.
Una desventaja de este patrón es que, a menos que esté integrado en el entorno de despliegue, constituye otro componente más del sistema que debe tener una alta disponibilidad y que es necesario configurar y gestionar.
Resumen
En una aplicación de microservicios, el conjunto de instancias de servicio en ejecución cambia dinámicamente. Las instancias tienen ubicaciones de red asignadas de forma dinámica. Por consiguiente, para que un cliente pueda realizar una solicitud a un servicio, debe utilizar un mecanismo de descubrimiento de servicios.
Una parte fundamental del descubrimiento de servicios es el registro de servicios. El registro de servicios es una base de datos de las instancias de servicio disponibles. El registro de servicios proporciona una API de gestión y una API de consulta. Las instancias de servicio se registran y se dan de baja en el registro de servicios mediante la API de gestión. Los componentes del sistema utilizan la API de consulta para descubrir las instancias de servicio disponibles.
Existen dos patrones principales de descubrimiento de servicios: el descubrimiento del lado del cliente y el descubrimiento del lado del servidor. En los sistemas que utilizan el descubrimiento de servicios del lado del cliente, los clientes consultan el registro de servicios, seleccionan una instancia disponible y realizan una solicitud. En los sistemas que utilizan el descubrimiento del lado del servidor, los clientes realizan solicitudes a través de un enrutador, que consulta el registro de servicios y reenvía la solicitud a una instancia disponible.
Hay dos formas principales de registrar y dar de baja las instancias de servicio en el registro de servicios. Una opción consiste en que las propias instancias de servicio se registren en el registro de servicios, lo que se conoce como patrón de autorregistro. La otra opción consiste en que otro componente del sistema se encargue del registro y la baja en nombre del servicio, lo que se conoce como patrón de registro por terceros.
En algunos entornos de despliegue, es necesario configurar una infraestructura propia de descubrimiento de servicios mediante un registro de servicios como Netflix Eureka, etcd o Apache Zookeeper. En otros entornos de despliegue, el descubrimiento de servicios está integrado. Por ejemplo, Kubernetes y Marathon se encargan del registro y la baja de las instancias de servicio. También ejecutan un proxy en cada host del clúster que desempeña la función de enrutador de descubrimiento del lado del servidor.
Un proxy inverso HTTP y equilibrador de carga como NGINX también puede utilizarse como equilibrador de carga para la detección del lado del servidor. El registro de servicios puede enviar la información de enrutamiento a NGINX e iniciar una actualización fluida de la configuración; por ejemplo, puede utilizar Consul Template. NGINX Plus admite mecanismos adicionales de reconfiguración dinámica; puede obtener información sobre las instancias de servicio del registro mediante DNS y proporciona una API para la reconfiguración remota.
En futuras entradas del blog, seguiremos profundizando en otros aspectos de los microservicios. Suscríbete a la lista de correo de NGINX (el formulario se encuentra más abajo) para recibir notificaciones cuando se publiquen nuevos artículos de la serie.
Editor – Esta serie de siete artículos ya está completa:
- Introducción a los microservicios
- Creación de microservicios: uso de una puerta de enlace de API
- Creación de microservicios: comunicación entre procesos en una arquitectura de microservicios
- Descubrimiento de servicios en una arquitectura de microservicios (este artículo)
- Gestión de datos basada en eventos para microservicios
- Cómo elegir una estrategia de despliegue de microservicios
- Refactorización de un monolito en microservicios
También puede descargar la colección completa de artículos, junto con información sobre cómo implementar microservicios con NGINX Plus, en formato de libro electrónico: «Microservicios: del diseño a la implementación».
El bloguero invitado Chris Richardson es el fundador del CloudFoundry.com original, una de las primeras PaaS (plataforma como servicio) de Java para Amazon EC2. Actualmente asesora a organizaciones para mejorar sus procesos de desarrollo e implementación de aplicaciones. También publica regularmente sobre microservicios en https://microservices.io.
Sobre el autor
Artículos relacionados del blog

Únete a F5 NGINX en AppWorld 2024
Descubre las numerosas razones para asistir al evento insignia de F5, que incluirá un emocionante anuncio sobre la cartera de productos NGINX.
Rotación de certificados SSL/TLS sin reinicios en NGINX Open Source
La función de diccionario compartido permite configurar NGINX sin necesidad de reiniciarlo al renovar los certificados SSL/TLS.
Exposición de APIs en Kubernetes
La unidad 2 de Microservices March 2022 se centra en cómo exponer tus API en Kubernetes. Aquí tienes enlaces a los recursos que necesitas: la retransmisión en directo del 14 de marzo, artículos de blog y otros recursos de preparación, y el laboratorio práctico «Protege las API de Kubernetes mediante la limitación de solicitudes».
NGINX Sprint 2.0: visión clara, código renovado y nuevos compromisos con el código abierto
Hoy, en NGINX Sprint 2.0, anunciamos cómo respaldaremos nuestra visión del futuro de las aplicaciones modernas con una mayor presencia en la comunidad de código abierto, incluida la participación en el proyecto comunitario Kubernetes, nuevos proyectos de software de código abierto y la arquitectura de referencia para aplicaciones modernas.
Presentamos NGINX Plus R22
NGINX Plus R22 incorpora nuevas funcionalidades, como la compatibilidad con OCSP para verificar la revocación de certificados en TLS mutuo, el uso de varios proveedores de identidad OIDC en una configuración, el seguimiento en tiempo real de la limitación de solicitudes y conexiones en el panel de NGINX Plus y mejoras en NGINX JavaScript.
Presentamos NGINX Plus R17
NGINX Plus R17 incorpora compatibilidad con la limitación de velocidad en dos fases y con TLS 1.3, la versión más reciente del protocolo Transport Layer Security. La configuración de OpenID Connect es más sencilla y NGINX ModSecurity WAF es el doble de rápido que antes. También se ha actualizado el módulo JavaScript de NGINX.