Editor – Esta serie de siete artículos ya está completa:
- Introducción a los microservicios
- Creación de microservicios: uso de una puerta de enlace de API
- Creación de microservicios: comunicación entre procesos en una arquitectura de microservicios
- Descubrimiento de servicios en una arquitectura de microservicios
- Gestión de datos basada en eventos para microservicios (este artículo)
- Elegir una estrategia de despliegue de microservicios
- Refactorización de un monolito en microservicios
También puede descargar la colección completa de artículos, junto con información sobre cómo implementar microservicios con NGINX Plus, en formato de libro electrónico: Microservicios: del diseño a la implementación. Consulte también nuestra serie sobre la arquitectura de referencia de microservicios y la página de soluciones de microservicios.
Este es el quinto artículo de una serie sobre la creación de aplicaciones con microservicios. El primer artículo presenta el patrón de arquitectura de microservicios y analiza las ventajas y desventajas de utilizar microservicios. Los artículos segundo<.htmla> y tercero de la serie describen distintos aspectos de la comunicación dentro de una arquitectura de microservicios. El cuarto artículo aborda el problema estrechamente relacionado del descubrimiento de servicios. En este artículo, cambiamos de tema y analizamos los problemas de gestión de datos distribuidos que surgen en una arquitectura de microservicios.
Los microservicios y el problema de la gestión de datos distribuidos
Una aplicación monolítica suele tener una única base de datos relacional. Una ventaja clave de utilizar una base de datos relacional es que la aplicación puede usar transacciones ACID, que ofrecen algunas garantías importantes:
- Atomicidad – Los cambios se realizan de forma atómica
- Consistencia – El estado de la base de datos siempre es coherente
- Aislamiento – Aunque las transacciones se ejecutan simultáneamente, parece que se ejecutan de forma secuencial
- Durabilidad – Una vez confirmada una transacción, no se puede deshacer
Como resultado, su aplicación puede simplemente iniciar una transacción, modificar varias filas (insertarlas, actualizarlas y eliminarlas) y confirmar la transacción.
Otra gran ventaja de utilizar una base de datos relacional es que proporciona SQL, un lenguaje de consulta completo, declarativo y estandarizado. Puede escribir fácilmente una consulta que combine datos de varias tablas. A continuación, el planificador de consultas del RDBMS determina la forma óptima de ejecutarla. No tiene que preocuparse por detalles de bajo nivel, como la forma de acceder a la base de datos. Además, como todos los datos de su aplicación se encuentran en una única base de datos, resulta fácil consultarlos.
Por desgracia, el acceso a los datos se vuelve mucho más complejo cuando pasamos a una arquitectura de microservicios. Esto se debe a que los datos que posee cada microservicio son privados de ese microservicio y solo se puede acceder a ellos a través de su API. La encapsulación de los datos garantiza que los microservicios estén débilmente acoplados y puedan evolucionar de forma independiente. Si varios servicios acceden a los mismos datos, las actualizaciones del esquema requieren actualizaciones coordinadas de todos los servicios, lo que lleva mucho tiempo.
Para complicar aún más las cosas, los distintos microservicios suelen utilizar diferentes tipos de bases de datos. Las aplicaciones modernas almacenan y procesan diversos tipos de datos, y una base de datos relacional no siempre es la mejor opción. Para determinados casos de uso, una base de datos NoSQL concreta puede ofrecer un modelo de datos más adecuado, así como un rendimiento y una escalabilidad mucho mejores. Por ejemplo, tiene sentido que un servicio que almacena y consulta texto utilice un motor de búsqueda de texto como Elasticsearch. Del mismo modo, un servicio que almacena datos de grafos sociales probablemente debería utilizar una base de datos de grafos, como Neo4j. Por consiguiente, las aplicaciones basadas en microservicios suelen utilizar una combinación de bases de datos SQL y NoSQL, lo que se conoce como enfoque de persistencia políglota.
Una arquitectura de almacenamiento de datos particionada y con persistencia políglota ofrece muchas ventajas, como servicios débilmente acoplados y un mejor rendimiento y escalabilidad. Sin embargo, también plantea algunos retos relacionados con la gestión distribuida de datos.
El primer reto consiste en implementar transacciones empresariales que mantengan la coherencia entre varios servicios. Para entender por qué esto supone un problema, veamos el ejemplo de una tienda B2B en línea. El Servicio de Clientes mantiene la información de los clientes, incluidas sus líneas de crédito. El Servicio de Pedidos gestiona los pedidos y debe comprobar que un nuevo pedido no supere el límite de crédito del cliente. En la versión monolítica de esta aplicación, el Servicio de Pedidos puede utilizar simplemente una transacción ACID para comprobar el crédito disponible y crear el pedido.
En cambio, en una arquitectura de microservicios, las tablas ORDER y CUSTOMER son privadas para sus respectivos servicios, como se muestra en el siguiente diagrama.
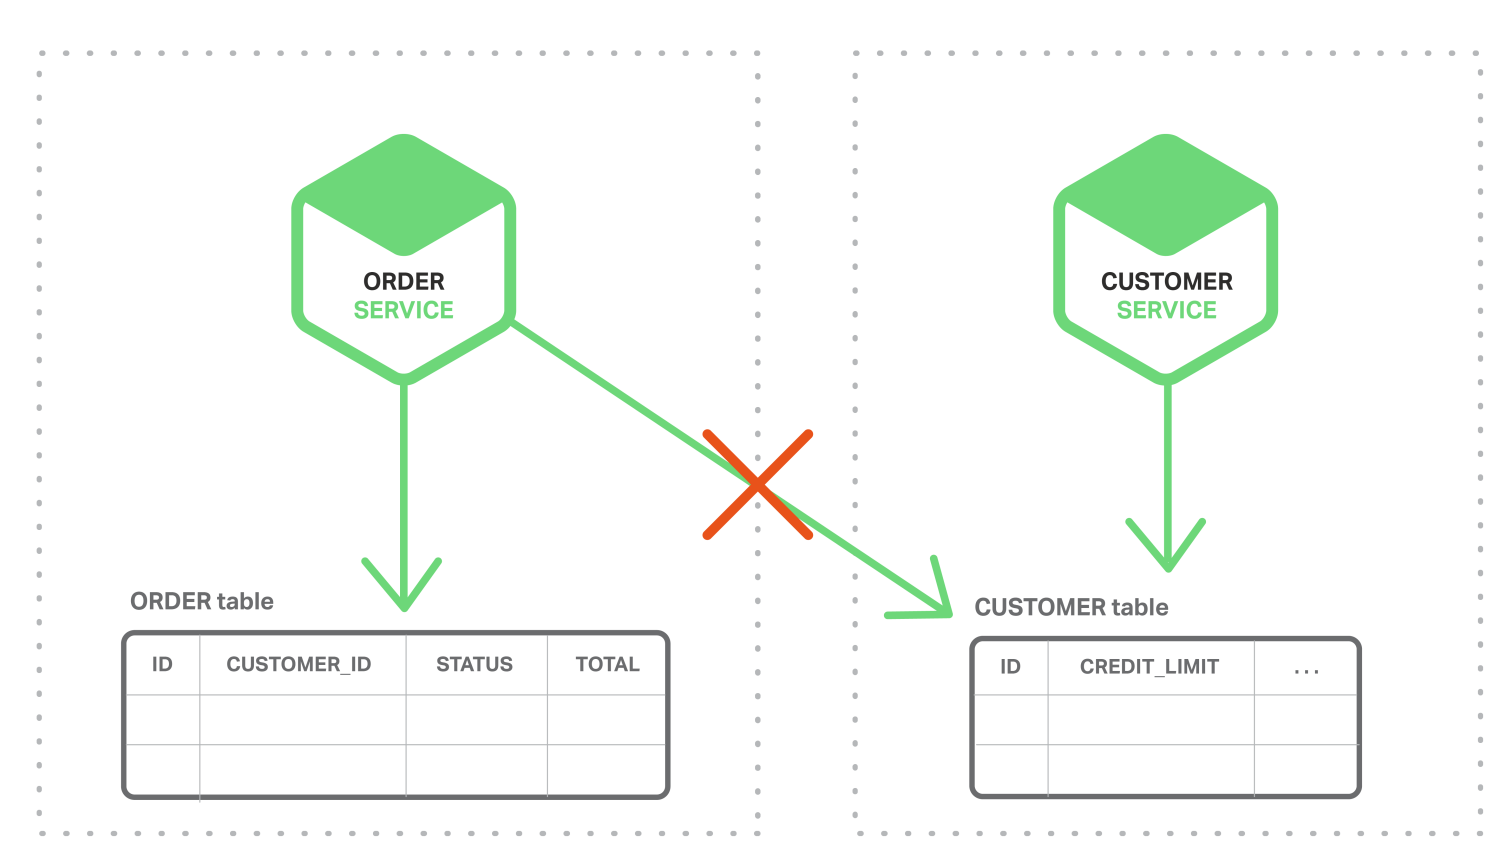
El servicio de pedidos no puede acceder directamente a la tabla CUSTOMER. Solo puede utilizar la API proporcionada por el servicio de clientes. El servicio de pedidos podría utilizar transacciones distribuidas, también conocidas como confirmación en dos fases (2PC). Sin embargo, 2PC no suele ser una opción viable en las aplicaciones modernas. El teorema CAP obliga a elegir entre la disponibilidad y la consistencia de tipo ACID, y la disponibilidad suele ser la mejor opción. Además, muchas tecnologías modernas, como la mayoría de las bases de datos NoSQL, no admiten 2PC. Mantener la consistencia de los datos entre servicios y bases de datos es esencial, por lo que necesitamos otra solución.
El segundo reto consiste en implementar consultas que recuperen datos de varios servicios. Por ejemplo, imaginemos que la aplicación necesita mostrar un cliente y sus pedidos recientes. Si el Servicio de Pedidos proporciona una API para recuperar los pedidos de un cliente, estos datos se pueden obtener mediante una combinación en la aplicación. La aplicación recupera el cliente del Servicio de Clientes y sus pedidos del Servicio de Pedidos. Sin embargo, supongamos que el Servicio de Pedidos solo permite buscar pedidos por su clave principal (quizá utilice una base de datos NoSQL que solo admita búsquedas por clave principal). En esta situación, no hay ninguna forma evidente de recuperar los datos necesarios.
Arquitectura basada en eventos
Para muchas aplicaciones, la solución consiste en utilizar una arquitectura basada en eventos. En esta arquitectura, un microservicio publica un evento cuando sucede algo relevante, como cuando actualiza una entidad de negocio. Otros microservicios se suscriben a esos eventos. Cuando un microservicio recibe un evento, puede actualizar sus propias entidades de negocio, lo que podría dar lugar a la publicación de más eventos.
Puede utilizar eventos para implementar transacciones empresariales que abarquen varios servicios. Una transacción consta de una serie de pasos. En cada paso, un microservicio actualiza una entidad empresarial y publica un evento que desencadena el paso siguiente. La siguiente secuencia de diagramas muestra cómo puede utilizar un enfoque basado en eventos para comprobar el crédito disponible al crear un pedido. Los microservicios intercambian eventos a través de un bróker de mensajes.
- El servicio de pedidos crea un pedido con el estado NUEVO y publica un evento de pedido creado.
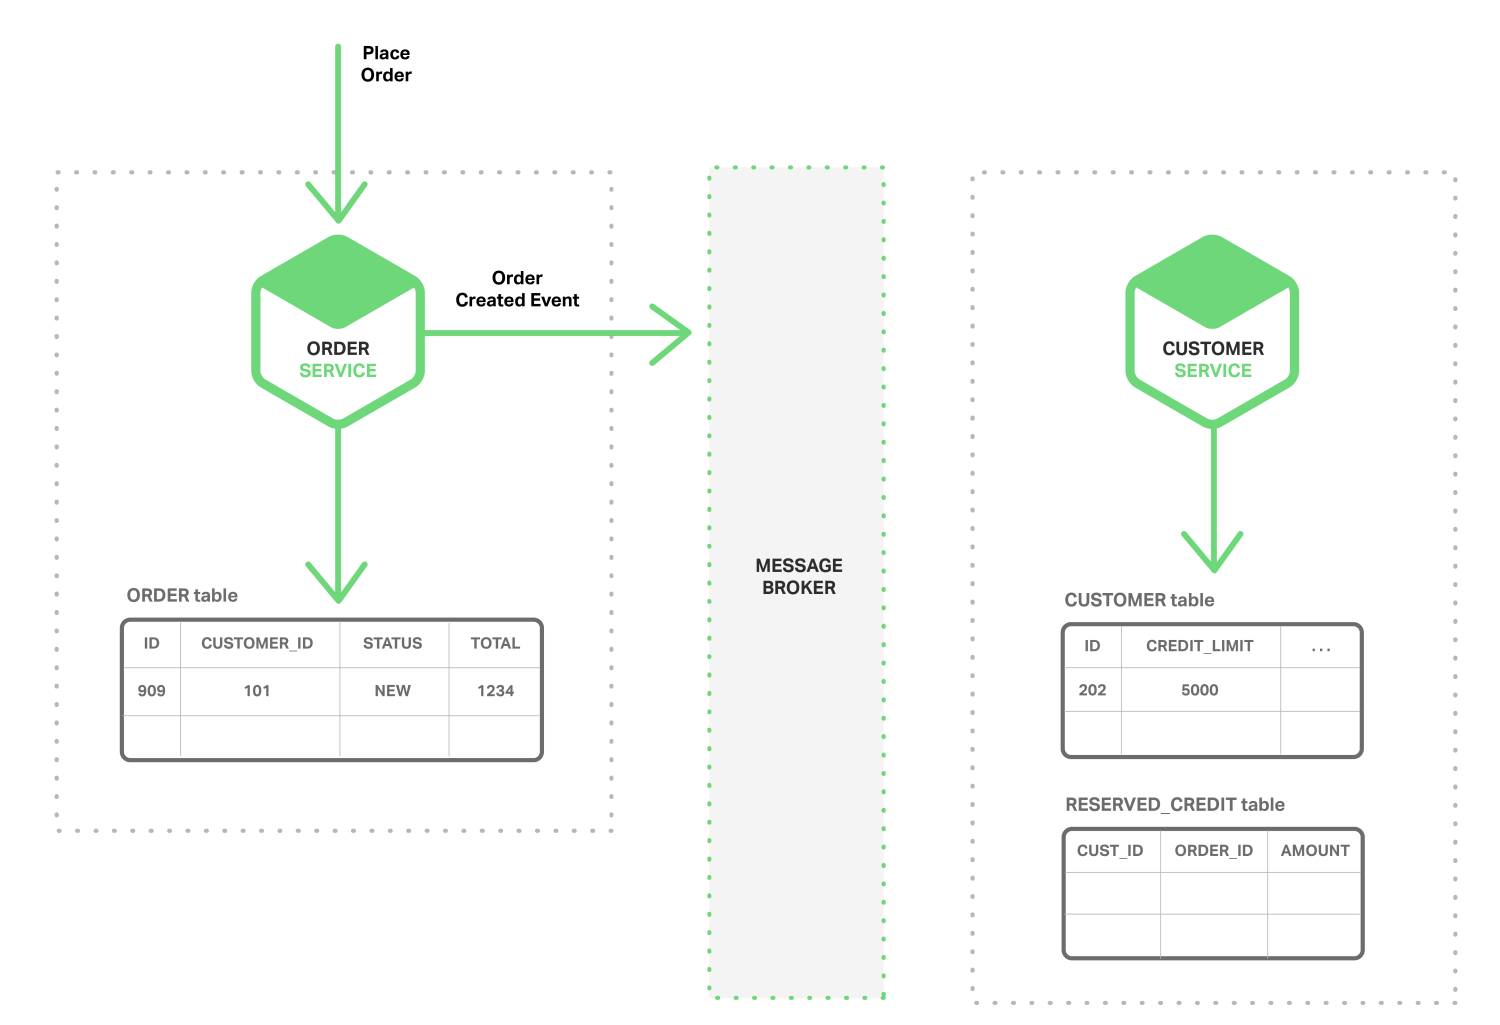
- El Servicio de Clientes consume el evento Pedido creado, reserva crédito para el pedido y publica un evento Crédito reservado.
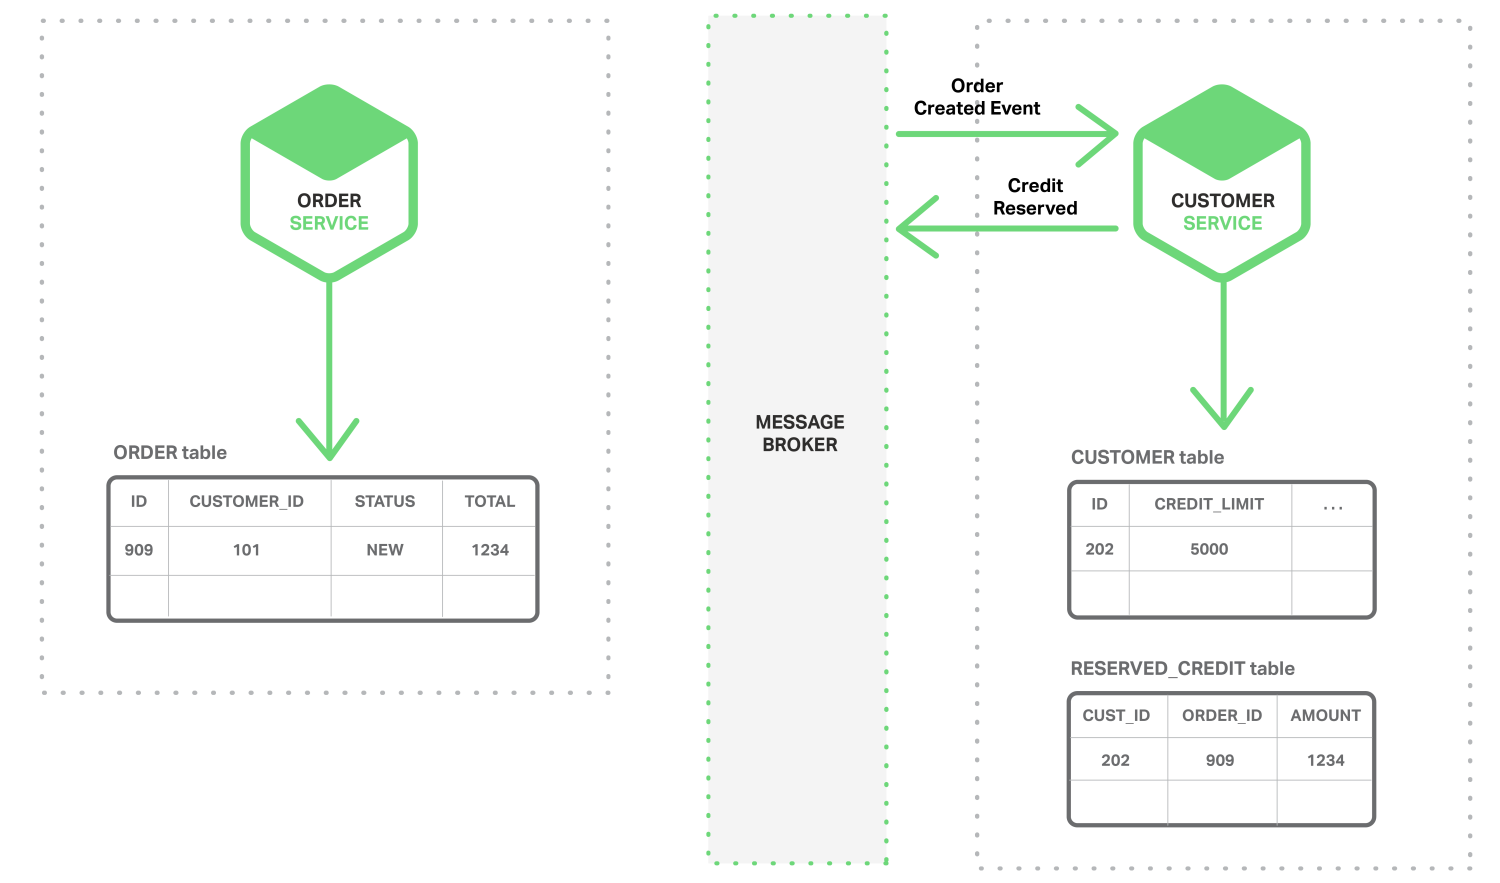
- El servicio de pedidos consume el evento Crédito reservado y cambia el estado del pedido a ABIERTO.
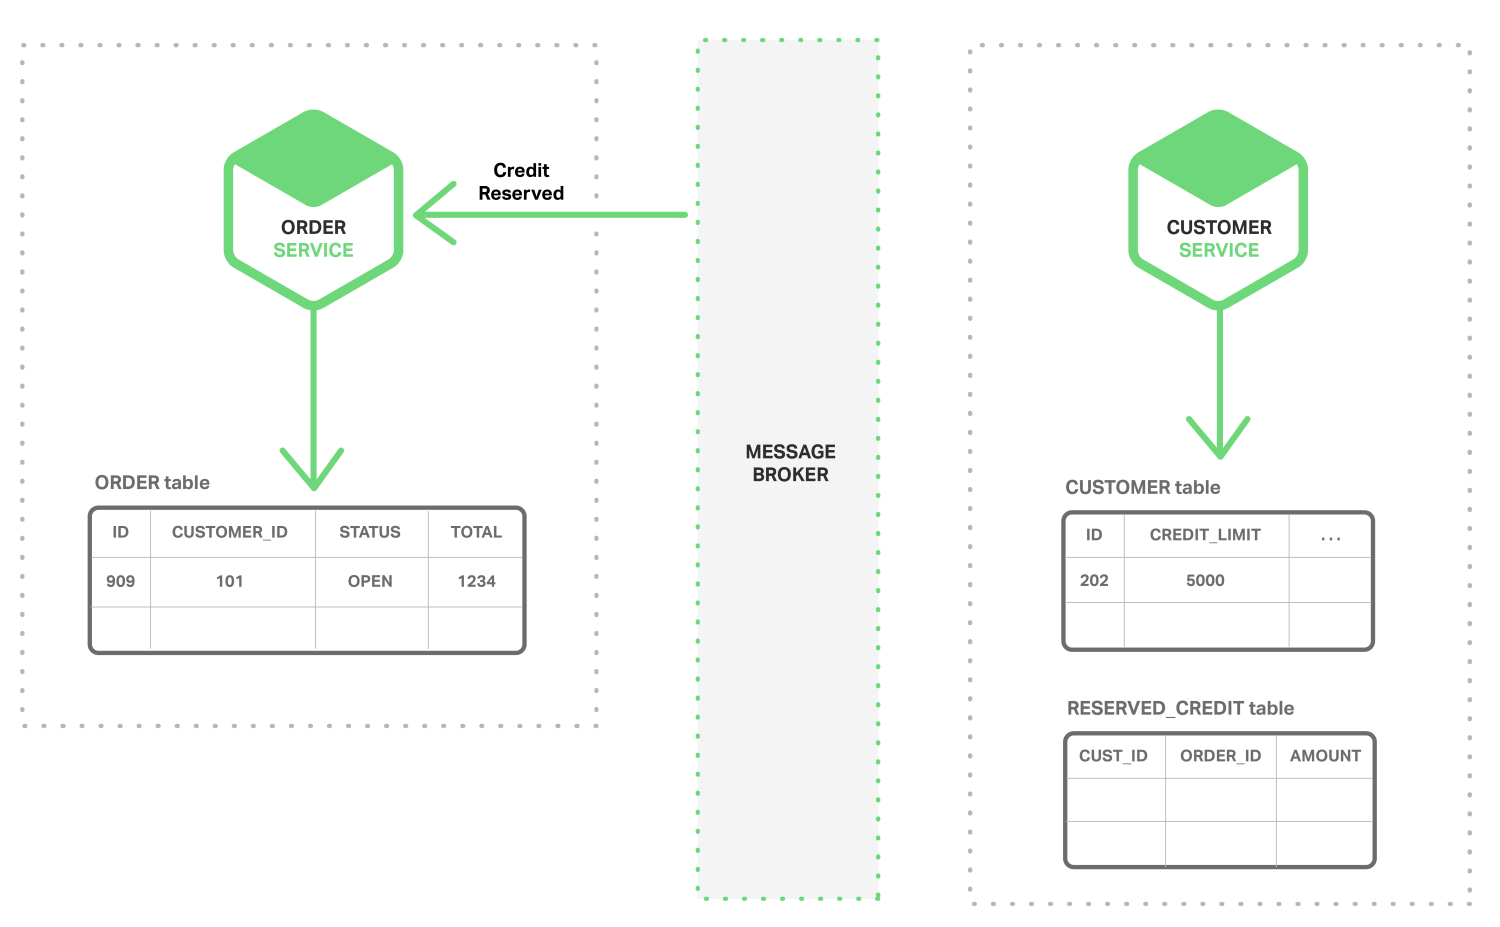
Un escenario más complejo podría incluir pasos adicionales, como reservar el inventario al mismo tiempo que se comprueba el crédito del cliente.
Siempre que (a) cada servicio actualice la base de datos y publique un evento de forma atómica —más adelante se profundizará en ello— y (b) el bróker de mensajes garantice que los eventos se entregan al menos una vez, se pueden implementar transacciones de negocio que abarquen varios servicios. Es importante señalar que no se trata de transacciones ACID. Ofrecen garantías mucho más débiles, como la consistencia eventual. Este modelo de transacciones se conoce como modelo BASE.
También puede utilizar eventos para mantener vistas materializadas que combinan previamente datos pertenecientes a varios microservicios. El servicio encargado de mantener la vista se suscribe a los eventos pertinentes y actualiza la vista. Por ejemplo, el servicio de actualización de la vista de pedidos de clientes, que mantiene una vista de pedidos de clientes, se suscribe a los eventos publicados por el servicio de clientes y el servicio de pedidos.
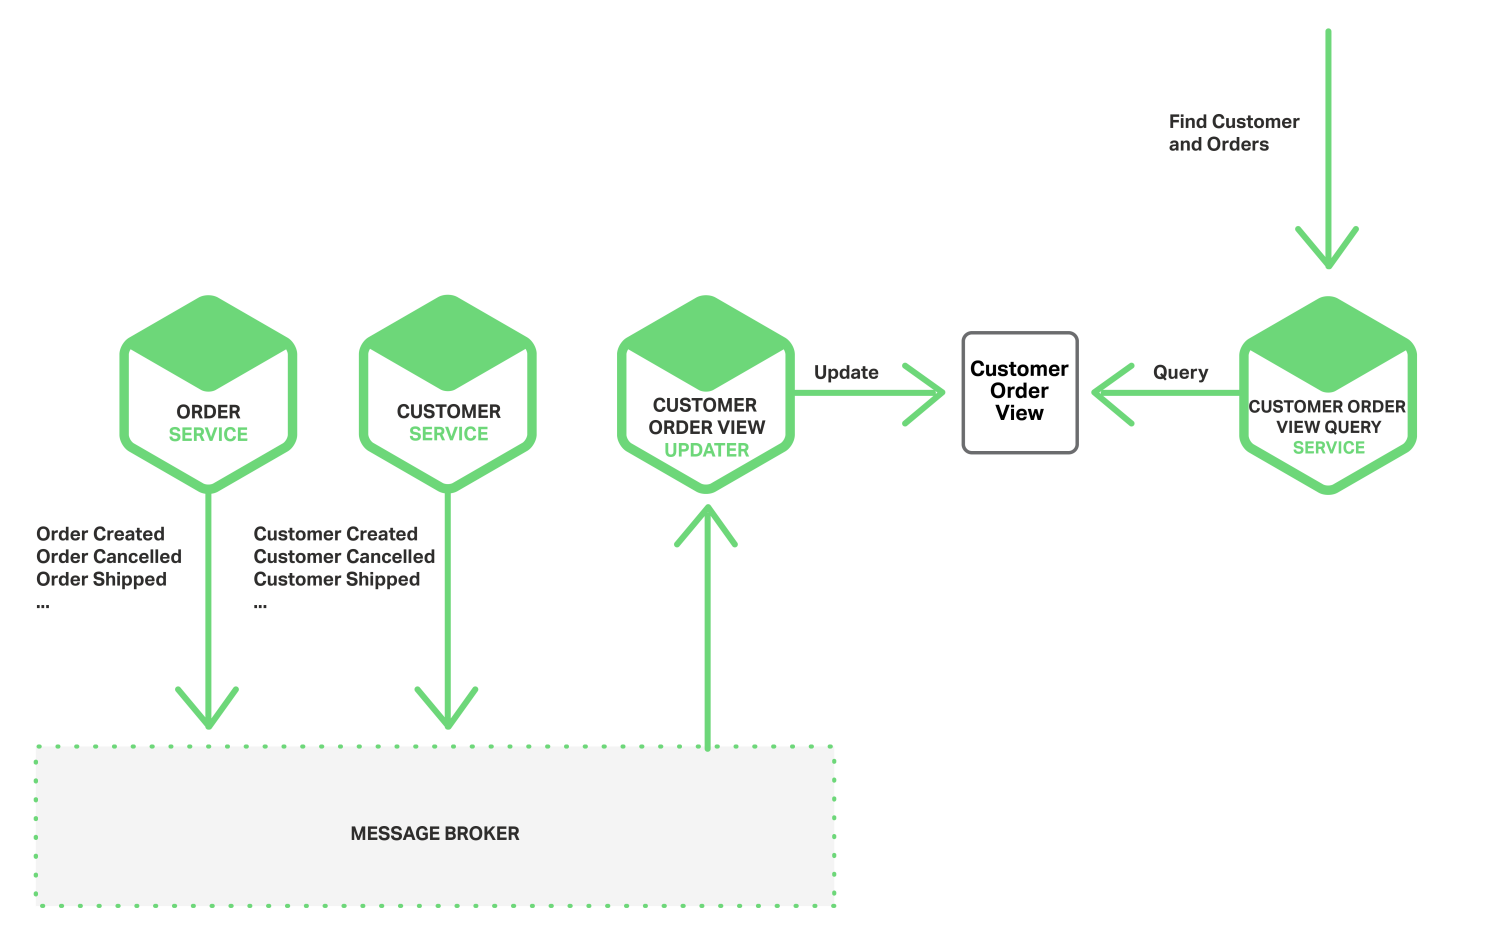
Cuando el servicio de actualización de la vista de pedidos de clientes recibe un evento de cliente o de pedido, actualiza el almacén de datos de dicha vista. La vista de pedidos de clientes se podría implementar mediante una base de datos documental como MongoDB y almacenar un documento por cada cliente. El servicio de consulta de la vista de pedidos de clientes atiende las solicitudes de información sobre un cliente y sus pedidos recientes consultando el almacén de datos de dicha vista.
Una arquitectura basada en eventos presenta varias ventajas e inconvenientes. Permite implementar transacciones que abarcan varios servicios y ofrecen consistencia eventual. Otra ventaja es que permite a una aplicación mantener vistas materializadas. Uno de sus inconvenientes es que el modelo de programación resulta más complejo que cuando se utilizan transacciones ACID. A menudo es necesario implementar transacciones de compensación para recuperarse de fallos en la aplicación; por ejemplo, se debe cancelar un pedido si falla la comprobación de crédito. Además, las aplicaciones deben gestionar datos incoherentes, ya que los cambios realizados por las transacciones en curso son visibles. La aplicación también puede detectar incoherencias si lee datos de una vista materializada que aún no se ha actualizado. Otro inconveniente es que los suscriptores deben detectar e ignorar los eventos duplicados.
Lograr la atomicidad
En una arquitectura basada en eventos también existe el problema de actualizar la base de datos y publicar un evento de forma atómica. Por ejemplo, el Servicio de Pedidos debe insertar una fila en la tabla ORDER y publicar un evento de Pedido Creado. Es fundamental que estas dos operaciones se realicen de forma atómica. Si el servicio falla después de actualizar la base de datos, pero antes de publicar el evento, el sistema queda en un estado incoherente. La forma habitual de garantizar la atomicidad consiste en utilizar una transacción distribuida que abarque la base de datos y el bróker de mensajes. Sin embargo, por los motivos descritos anteriormente, como el teorema CAP, esto es precisamente lo que no queremos hacer.
Publicación de eventos mediante transacciones locales
Una forma de lograr la atomicidad consiste en que la aplicación publique eventos mediante un proceso de varios pasos que solo implica transacciones locales. El truco consiste en disponer de una tabla EVENT, que funciona como una cola de mensajes, en la base de datos que almacena el estado de las entidades de negocio. La aplicación inicia una transacción de base de datos (local), actualiza el estado de las entidades de negocio, inserta un evento en la tabla EVENT y confirma la transacción. Un hilo o proceso independiente de la aplicación consulta la tabla EVENT, publica los eventos en el bróker de mensajes y, a continuación, utiliza una transacción local para marcar los eventos como publicados. El siguiente diagrama muestra el diseño.
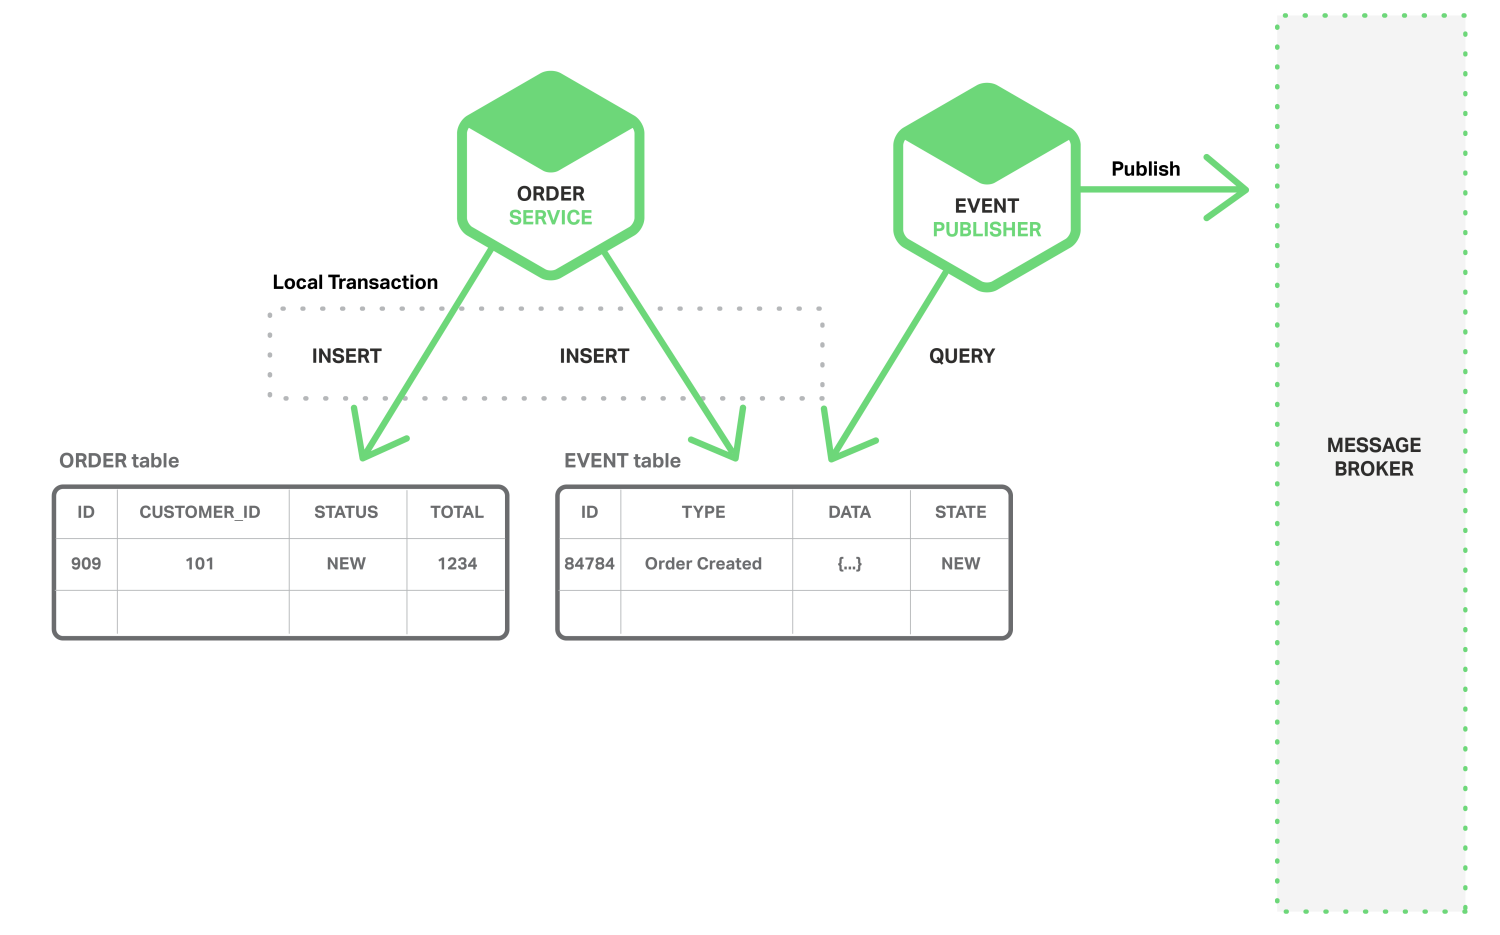
El servicio de pedidos inserta una fila en la tabla ORDER y un evento de creación de pedido en la tabla EVENT. El hilo o proceso de publicación de eventos consulta la tabla EVENT para buscar eventos no publicados, los publica y, a continuación, actualiza la tabla EVENT para marcarlos como publicados.
Este enfoque presenta varias ventajas e inconvenientes. Una de sus ventajas es que garantiza la publicación de un evento por cada actualización sin depender de 2PC. Además, la aplicación publica eventos de negocio, lo que elimina la necesidad de inferirlos. Uno de los inconvenientes de este enfoque es que puede dar lugar a errores, ya que el desarrollador debe acordarse de publicar los eventos. Otra limitación es que resulta difícil de implementar con algunas bases de datos NoSQL debido a sus capacidades limitadas de transacción y consulta.
Este enfoque elimina la necesidad de usar 2PC al hacer que la aplicación utilice transacciones locales para actualizar el estado y publicar eventos. Veamos ahora un enfoque que logra la atomicidad haciendo que la aplicación se limite a actualizar el estado.
Análisis de un registro de transacciones de base de datos
Otra forma de lograr la atomicidad sin 2PC consiste en que los eventos sean publicados por un hilo o proceso que analice el registro de transacciones o de confirmaciones de la base de datos. La aplicación actualiza la base de datos, lo que hace que los cambios queden registrados en el registro de transacciones de la base de datos. El hilo o proceso de análisis del registro de transacciones lee dicho registro y publica los eventos en el bróker de mensajes. El siguiente diagrama muestra el diseño.
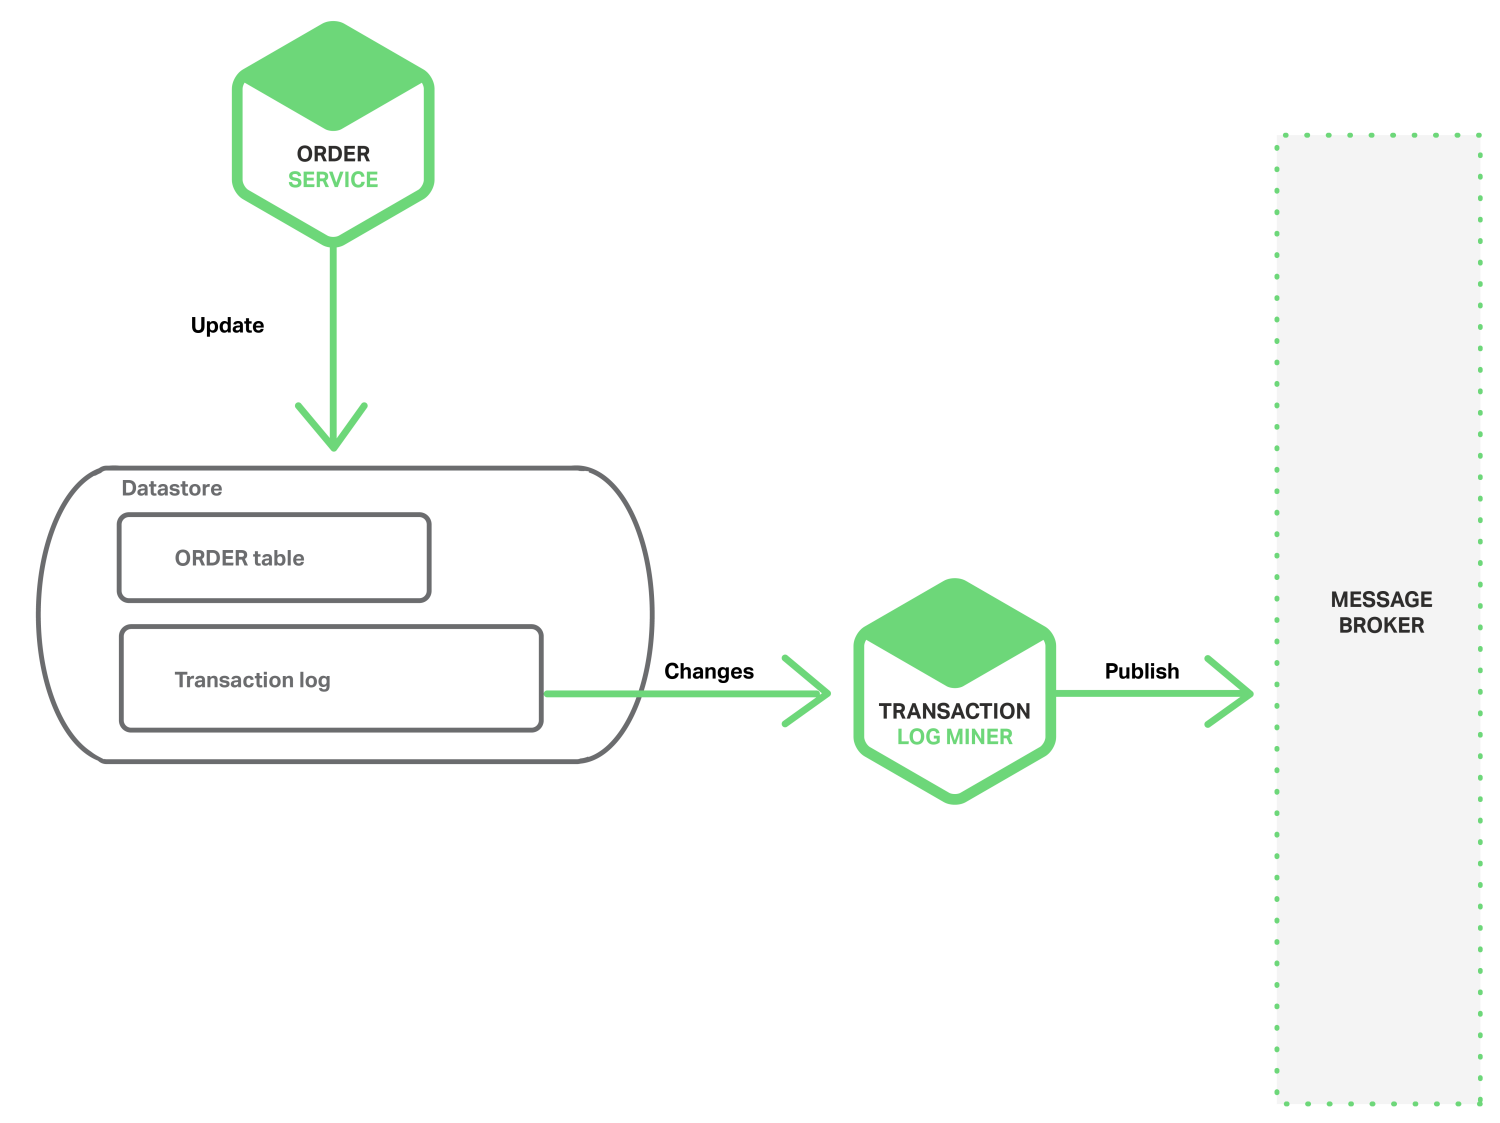
Un ejemplo de este enfoque es el proyecto de código abierto LinkedIn Databus, que analiza el registro de transacciones de Oracle y publica eventos correspondientes a los cambios. LinkedIn utiliza Databus para mantener sincronizados diversos almacenes de datos derivados con el sistema de registro.
Otro ejemplo es el mecanismo de flujos de AWS DynamoDB, una base de datos NoSQL gestionada. Un flujo de DynamoDB contiene la secuencia cronológica de los cambios (operaciones de creación, actualización y eliminación) realizados en los elementos de una tabla de DynamoDB durante las últimas 24 horas. Una aplicación puede leer esos cambios del flujo y, por ejemplo, publicarlos como eventos.
La extracción de datos del registro de transacciones presenta diversas ventajas e inconvenientes. Una ventaja es que garantiza la publicación de un evento por cada actualización sin utilizar 2PC. También puede simplificar la aplicación al separar la publicación de eventos de la lógica de negocio de la aplicación. Un inconveniente importante es que el formato del registro de transacciones es específico de cada base de datos e incluso puede cambiar entre versiones. Además, puede resultar difícil reconstruir mediante ingeniería inversa los eventos de negocio de alto nivel a partir de las actualizaciones de bajo nivel registradas en el registro de transacciones.
La minería del registro de transacciones elimina la necesidad de usar 2PC al hacer que la aplicación realice una única tarea: actualizar la base de datos. Veamos ahora un enfoque diferente que elimina las actualizaciones y se basa exclusivamente en eventos.
Uso del abastecimiento de eventos
El abastecimiento de eventos logra la atomicidad sin 2PC mediante un enfoque radicalmente distinto, centrado en eventos, para conservar las entidades de negocio. En lugar de almacenar el estado actual de una entidad, la aplicación almacena una secuencia de eventos que modifican su estado. La aplicación reconstruye el estado actual de una entidad reproduciendo los eventos. Cada vez que cambia el estado de una entidad de negocio, se añade un nuevo evento a la lista de eventos. Dado que guardar un evento es una única operación, esta es intrínsecamente atómica.
Para ver cómo funciona el abastecimiento de eventos, tomemos como ejemplo la entidad Pedido. En un enfoque tradicional, cada pedido se corresponde con una fila de una tabla ORDER y con varias filas de, por ejemplo, una tabla ORDER_LINE_ITEM. Sin embargo, cuando se utiliza el abastecimiento de eventos, el Servicio de Pedidos almacena un Pedido en forma de eventos que modifican su estado: Creado, Aprobado, Enviado y Cancelado. Cada evento contiene datos suficientes para reconstruir el estado del Pedido.
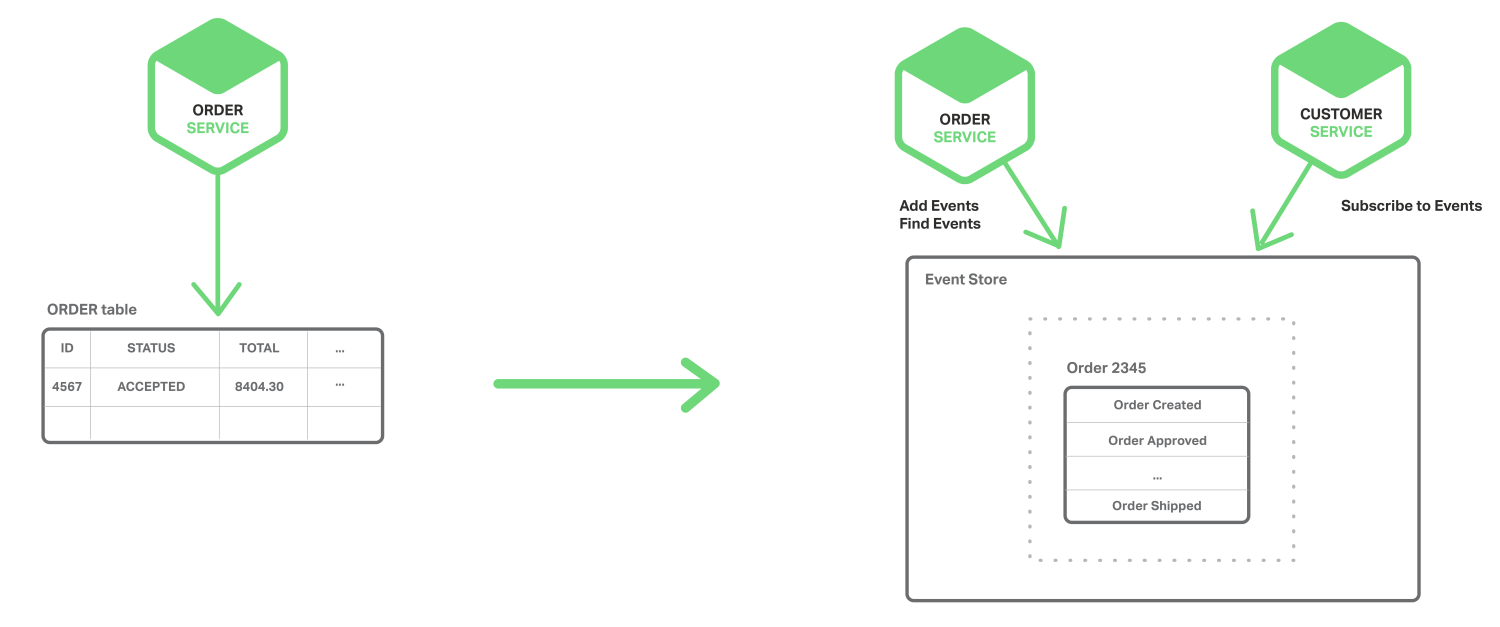
Los eventos se almacenan de forma persistente en un almacén de eventos, que es una base de datos de eventos. El almacén dispone de una API para añadir y recuperar los eventos de una entidad. El almacén de eventos también actúa como el bróker de mensajes en las arquitecturas descritas anteriormente. Proporciona una API que permite a los servicios suscribirse a los eventos. El almacén de eventos entrega todos los eventos a todos los suscriptores interesados. El almacén de eventos es la columna vertebral de una arquitectura de microservicios basada en eventos.
El abastecimiento de eventos ofrece varias ventajas. Resuelve uno de los principales problemas a la hora de implementar una arquitectura basada en eventos y permite publicar eventos de forma fiable cada vez que cambia el estado. Como resultado, soluciona los problemas de coherencia de datos en una arquitectura de microservicios. Además, dado que conserva los eventos en lugar de los objetos de dominio, evita en gran medida el problema de la incompatibilidad objeto-relacional. El abastecimiento de eventos también proporciona un registro de auditoría totalmente fiable de los cambios realizados en una entidad de negocio y permite implementar consultas temporales que determinan el estado de una entidad en cualquier momento. Otra ventaja importante del abastecimiento de eventos es que la lógica de negocio se compone de entidades de negocio débilmente acopladas que intercambian eventos. Esto facilita considerablemente la migración de una aplicación monolítica a una arquitectura de microservicios.
El abastecimiento de eventos también presenta algunos inconvenientes. Es un estilo de programación diferente y poco conocido, por lo que requiere un proceso de aprendizaje. El almacén de eventos solo permite buscar directamente entidades de negocio por su clave primaria. Para implementar consultas, se debe utilizar la segregación de responsabilidades entre comandos y consultas (CQRS). Como consecuencia, las aplicaciones deben gestionar datos con consistencia eventual.
Resumen
En una arquitectura de microservicios, cada microservicio dispone de su propio almacén de datos privado. Los distintos microservicios pueden utilizar diferentes bases de datos SQL y NoSQL. Aunque esta arquitectura de bases de datos ofrece importantes ventajas, también plantea algunos retos relacionados con la gestión distribuida de datos. El primer reto consiste en implementar transacciones empresariales que mantengan la coherencia entre varios servicios. El segundo consiste en implementar consultas que recuperen datos de varios servicios.
Para muchas aplicaciones, la solución consiste en utilizar una arquitectura basada en eventos. Uno de los retos a la hora de implementar una arquitectura basada en eventos es cómo actualizar el estado y publicar eventos de forma atómica. Hay varias formas de conseguirlo, como utilizar la base de datos como cola de mensajes, analizar el registro de transacciones y aplicar el abastecimiento de eventos.
En futuras publicaciones del blog, seguiremos profundizando en otros aspectos de los microservicios.
Editor – Esta serie de siete artículos ya está completa:
- Introducción a los microservicios
- Creación de microservicios: uso de una puerta de enlace de API
- Creación de microservicios: comunicación entre procesos en una arquitectura de microservicios
- Descubrimiento de servicios en una arquitectura de microservicios
- Gestión de datos basada en eventos para microservicios (este artículo)
- Cómo elegir una estrategia de despliegue de microservicios
- Refactorización de un monolito en microservicios
También puede descargar la colección completa de artículos, junto con información sobre cómo implementar microservicios con NGINX Plus, en formato de libro electrónico: «Microservicios: del diseño a la implementación». Consulte también nuestra serie sobre la arquitectura de referencia de microservicios y la página de soluciones de microservicios.
El bloguero invitado Chris Richardson es el fundador de la plataforma original CloudFoundry.com, una de las primeras PaaS (plataforma como servicio) de Java para Amazon EC2. Actualmente asesora a organizaciones para mejorar la forma en que desarrollan e implementan aplicaciones. También publica habitualmente sobre microservicios en http://microservices.io.
Sobre el autor
Artículos relacionados del blog

Únete a F5 NGINX en AppWorld 2024
Descubre las numerosas razones para asistir al evento insignia de F5, que incluirá un emocionante anuncio sobre la cartera de productos NGINX.
Rotación de certificados SSL/TLS sin reinicios en NGINX Open Source
La función de diccionario compartido permite configurar NGINX sin necesidad de reiniciarlo al renovar los certificados SSL/TLS.
Exposición de APIs en Kubernetes
La unidad 2 de Microservices March 2022 se centra en cómo exponer tus API en Kubernetes. Aquí tienes enlaces a los recursos que necesitas: la retransmisión en directo del 14 de marzo, artículos de blog y otros recursos de preparación, y el laboratorio práctico «Protege las API de Kubernetes mediante la limitación de solicitudes».
NGINX Sprint 2.0: visión clara, código renovado y nuevos compromisos con el código abierto
Hoy, en NGINX Sprint 2.0, anunciamos cómo respaldaremos nuestra visión del futuro de las aplicaciones modernas con una mayor presencia en la comunidad de código abierto, incluida la participación en el proyecto comunitario Kubernetes, nuevos proyectos de software de código abierto y la arquitectura de referencia para aplicaciones modernas.
Presentamos NGINX Plus R22
NGINX Plus R22 incorpora nuevas funcionalidades, como la compatibilidad con OCSP para verificar la revocación de certificados en TLS mutuo, el uso de varios proveedores de identidad OIDC en una configuración, el seguimiento en tiempo real de la limitación de solicitudes y conexiones en el panel de NGINX Plus y mejoras en NGINX JavaScript.
Presentamos NGINX Plus R17
NGINX Plus R17 incorpora compatibilidad con la limitación de velocidad en dos fases y con TLS 1.3, la versión más reciente del protocolo Transport Layer Security. La configuración de OpenID Connect es más sencilla y NGINX ModSecurity WAF es el doble de rápido que antes. También se ha actualizado el módulo JavaScript de NGINX.