Editor – Esta serie de siete artículos ya está completa:
- Introducción a los microservicios
- Creación de microservicios: uso de una puerta de enlace de API
- Creación de microservicios: comunicación entre procesos en una arquitectura de microservicios
- Descubrimiento de servicios en una arquitectura de microservicios
- Gestión de datos basada en eventos para microservicios
- Elegir una estrategia de despliegue de microservicios (este artículo)
- Refactorización de un monolito en microservicios
También puede descargar la colección completa de artículos, junto con información sobre cómo implementar microservicios con NGINX Plus, en forma de libro electrónico: «Microservicios: del diseño a la implementación». Consulte también nuestra serie sobre la arquitectura de referencia para microservicios y la página de soluciones de microservicios.
Este es el sexto artículo de una serie sobre el desarrollo de aplicaciones con microservicios. El primer artículo presenta el patrón de arquitectura de microservicios y analiza las ventajas y desventajas de utilizar microservicios. Los siguientes artículos abordan distintos aspectos de la arquitectura de microservicios: el uso de una puerta de enlace de API, la comunicación entre procesos, el descubrimiento de servicios y la gestión de datos basada en eventos. En este artículo, analizamos distintas estrategias para desplegar microservicios.
Motivaciones
Desplegar una aplicación monolítica implica ejecutar varias copias idénticas de una única aplicación, normalmente de gran tamaño. Por lo general, se aprovisionan N servidores (físicos o virtuales) y se ejecutan M instancias de la aplicación en cada uno de ellos. El despliegue de una aplicación monolítica no siempre es del todo sencillo, pero es mucho más simple que desplegar una aplicación de microservicios.
Una aplicación de microservicios consta de decenas o incluso cientos de servicios. Los servicios están escritos en diversos lenguajes y frameworks. Cada uno es una miniaplicación con sus propios requisitos específicos de despliegue, recursos, escalado y supervisión. Por ejemplo, es necesario ejecutar un número determinado de instancias de cada servicio en función de su demanda. Además, cada instancia de servicio debe disponer de los recursos adecuados de CPU, memoria y E/S. Lo que resulta aún más difícil es que, a pesar de esta complejidad, el despliegue de los servicios debe ser rápido, fiable y rentable.
Existen varios patrones de despliegue de microservicios. Veamos primero el patrón de múltiples instancias de servicio por host.
Patrón de múltiples instancias de servicio por host
Una forma de desplegar sus microservicios es utilizar el patrón de varias instancias de servicio por host. Al utilizar este patrón, se aprovisionan uno o varios hosts físicos o virtuales y se ejecutan varias instancias de servicio en cada uno de ellos. En muchos sentidos, este es el enfoque tradicional para el despliegue de aplicaciones. Cada instancia de servicio se ejecuta en un puerto conocido de uno o varios hosts. Las máquinas host suelen tratarse como mascotas.
El siguiente diagrama muestra la estructura de este patrón.
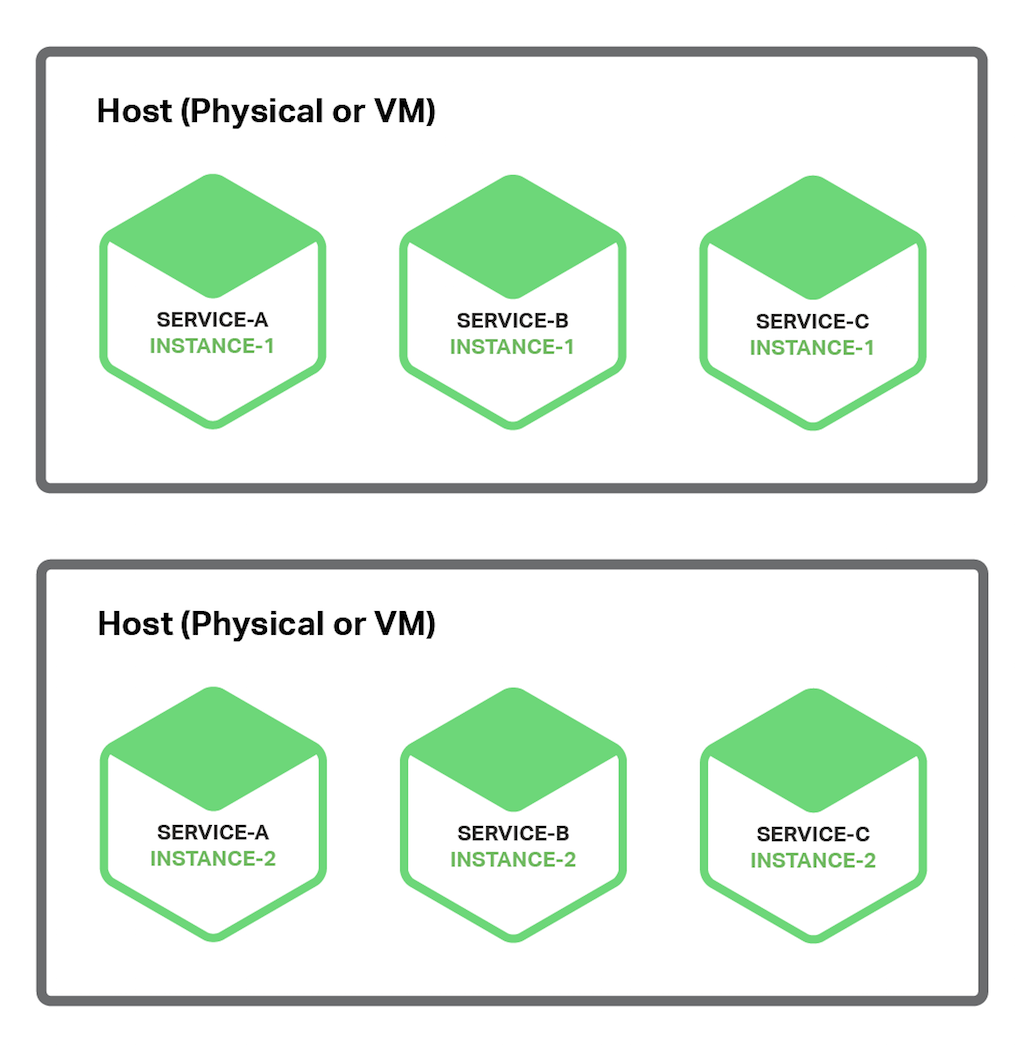
Este patrón presenta un par de variantes. En una de ellas, cada instancia de servicio es un proceso o un grupo de procesos. Por ejemplo, se podría desplegar una instancia de servicio Java como una aplicación web en un servidor Apache Tomcat. Una instancia de servicio de Node.js podría constar de un proceso principal y uno o varios procesos secundarios.
La otra variante de este patrón consiste en ejecutar varias instancias de servicio en el mismo proceso o grupo de procesos. Por ejemplo, se podrían desplegar varias aplicaciones web Java en el mismo servidor Apache Tomcat o ejecutar varios paquetes OSGI en el mismo contenedor OSGI.
El patrón Varias instancias de servicio por host presenta tanto ventajas como inconvenientes. Una de sus principales ventajas es que hace un uso relativamente eficiente de los recursos. Varias instancias de servicio comparten el servidor y su sistema operativo. Resulta aún más eficiente si un proceso o grupo de procesos ejecuta varias instancias de servicio; por ejemplo, varias aplicaciones web que comparten el mismo servidor Apache Tomcat y la misma JVM.
Otra ventaja de este patrón es que desplegar una instancia de servicio es relativamente rápido. Basta con copiar el servicio en un host e iniciarlo. Si el servicio está escrito en Java, se copia un archivo JAR o WAR. En el caso de otros lenguajes, como Node.js o Ruby, se copia el código fuente. En ambos casos, la cantidad de bytes que se copian a través de la red es relativamente pequeña.
Además, debido a la ausencia de sobrecarga, iniciar un servicio suele ser muy rápido. Si el servicio se ejecuta en su propio proceso, basta con iniciarlo. De lo contrario, si el servicio es una de varias instancias que se ejecutan en el mismo proceso de contenedor o grupo de procesos, puede desplegarlo dinámicamente en el contenedor o reiniciar el contenedor.
A pesar de su atractivo, el patrón Varias instancias de servicio por host presenta algunos inconvenientes importantes. Uno de los principales es que las instancias de servicio están poco o nada aisladas, a menos que cada una se ejecute como un proceso independiente. Aunque se puede supervisar con precisión el uso de recursos de cada instancia de servicio, no es posible limitar los recursos que utiliza cada una. Una instancia de servicio que no funcione correctamente podría llegar a consumir toda la memoria o la CPU del host.
No existe ningún tipo de aislamiento si varias instancias de servicio se ejecutan en el mismo proceso. Por ejemplo, todas las instancias podrían compartir el mismo montón de la JVM. Una instancia de servicio con un comportamiento incorrecto podría afectar fácilmente a los demás servicios que se ejecutan en el mismo proceso. Además, no hay forma de supervisar los recursos utilizados por cada instancia de servicio.
Otro problema importante de este enfoque es que el equipo de operaciones encargado de desplegar un servicio debe conocer los detalles específicos para hacerlo. Los servicios pueden estar escritos en distintos lenguajes y frameworks, por lo que el equipo de desarrollo debe compartir numerosos detalles con el equipo de operaciones. Esta complejidad aumenta el riesgo de que se produzcan errores durante el despliegue.
Como puede ver, a pesar de resultar familiar, el patrón Varias instancias de servicio por host presenta algunos inconvenientes importantes. Veamos ahora otras formas de desplegar microservicios que eviten estos problemas.
Patrón de instancia de servicio por host
Otra forma de desplegar sus microservicios es el patrón Instancia de servicio por host. Cuando se utiliza este patrón, cada instancia de servicio se ejecuta de forma aislada en su propio host. Existen dos especializaciones distintas de este patrón: Instancia de servicio por máquina virtual e Instancia de servicio por contenedor.
Patrón de instancia de servicio por máquina virtual
Cuando se utiliza el patrón Instancia de servicio por máquina virtual, cada servicio se empaqueta como una imagen de máquina virtual (VM), como una AMI de Amazon EC2. Cada instancia de servicio es una VM (por ejemplo, una instancia de EC2) que se inicia utilizando dicha imagen de VM. El siguiente diagrama muestra la estructura de este patrón:
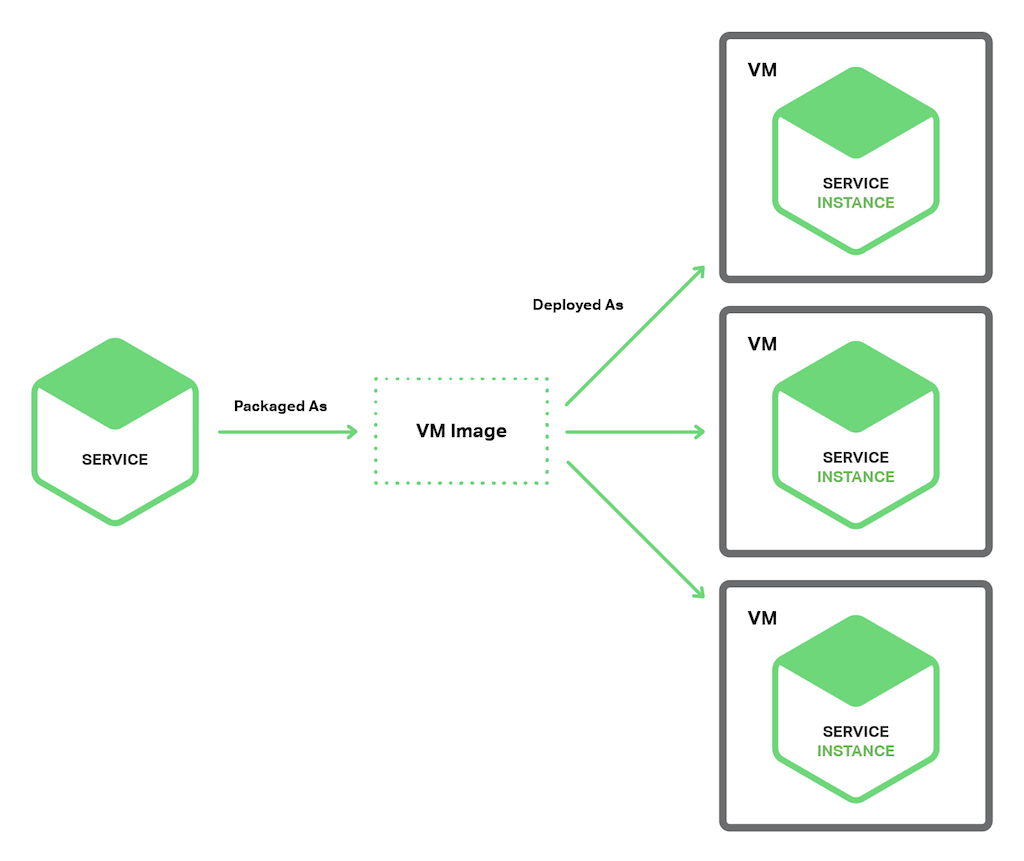
Este es el principal enfoque que utiliza Netflix para desplegar su servicio de streaming de vídeo. Netflix empaqueta cada uno de sus servicios como una AMI de EC2 mediante Aminator. Cada instancia de servicio en ejecución es una instancia de EC2.
Hay diversas herramientas que puede utilizar para crear sus propias máquinas virtuales. Puede configurar su servidor de integración continua (CI) (por ejemplo, Jenkins) para que invoque Aminator y empaquete sus servicios como una AMI de EC2. Packer.io es otra opción para la creación automatizada de imágenes de máquinas virtuales. A diferencia de Aminator, admite diversas tecnologías de virtualización, como EC2, DigitalOcean, VirtualBox y VMware.
La empresa Boxfuse ofrece una forma muy interesante de crear imágenes de máquinas virtuales que solventa los inconvenientes de estas que describo a continuación. Boxfuse empaqueta su aplicación Java como una imagen mínima de máquina virtual. Estas imágenes se crean rápidamente, arrancan con rapidez y son más seguras, ya que presentan una superficie de ataque limitada.
La empresa CloudNative ofrece Bakery, una solución SaaS para crear AMI de EC2. Puede configurar su servidor de CI para que invoque Bakery una vez superadas las pruebas de su microservicio. A continuación, Bakery empaqueta su servicio como una AMI. Utilizar una solución SaaS como Bakery evita tener que perder un tiempo valioso configurando la infraestructura de creación de AMI.
El patrón «Instancia de servicio por máquina virtual» ofrece varias ventajas. Una de las principales ventajas de las máquinas virtuales es que cada instancia de servicio se ejecuta de forma totalmente aislada. Dispone de una cantidad fija de CPU y memoria y no puede acaparar recursos de otros servicios.
Otra ventaja de desplegar los microservicios como máquinas virtuales es que permite aprovechar una infraestructura en la nube consolidada. Los proveedores de servicios en la nube, como AWS, ofrecen funciones útiles como el equilibrio de carga y el escalado automático.
Otra gran ventaja de desplegar el servicio como una máquina virtual es que encapsula la tecnología con la que está implementado. Una vez empaquetado como máquina virtual, el servicio se convierte en una caja negra. La API de gestión de la máquina virtual pasa a ser la API para desplegar el servicio. El despliegue se vuelve mucho más sencillo y fiable.
Sin embargo, el patrón de una instancia de servicio por máquina virtual presenta algunos inconvenientes. Uno de ellos es un uso menos eficiente de los recursos. Cada instancia de servicio conlleva la sobrecarga de una máquina virtual completa, incluido el sistema operativo. Además, en una IaaS pública típica, las máquinas virtuales se ofrecen en tamaños fijos, por lo que es posible que estén infrautilizadas.
Además, una IaaS pública suele cobrar por las máquinas virtuales independientemente de si están ocupadas o inactivas. Una IaaS como AWS ofrece escalado automático, pero resulta difícil reaccionar rápidamente a los cambios en la demanda. Por consiguiente, a menudo es necesario sobredimensionar el número de máquinas virtuales, lo que aumenta el coste del despliegue.
Otro inconveniente de este enfoque es que el despliegue de una nueva versión de un servicio suele ser lento. Las imágenes de máquinas virtuales suelen tardar en generarse debido a su tamaño. Además, las máquinas virtuales suelen tardar en crearse, también debido a su tamaño. Asimismo, un sistema operativo suele tardar cierto tiempo en arrancar. Sin embargo, cabe señalar que esto no siempre es así, ya que existen máquinas virtuales ligeras, como las creadas por Boxfuse.
Otro inconveniente del patrón «Instancia de servicio por máquina virtual» es que, por lo general, tú (u otra persona de tu organización) debes encargarte de una gran cantidad de trabajo pesado que no aporta valor diferencial. A menos que utilices una herramienta como Boxfuse, que se ocupe de la carga que supone crear y gestionar las máquinas virtuales, esta responsabilidad recaerá sobre ti. Esta actividad, necesaria pero laboriosa, te distrae de la actividad principal de tu empresa.
Veamos ahora una forma alternativa de desplegar microservicios que es más ligera, pero que sigue ofreciendo muchas de las ventajas de las máquinas virtuales.
Patrón de instancia de servicio por contenedor
Cuando se utiliza el patrón Instancia de servicio por contenedor, cada instancia de servicio se ejecuta en su propio contenedor. Los contenedores son un mecanismo de virtualización a nivel del sistema operativo. Un contenedor consta de uno o varios procesos que se ejecutan en un entorno aislado. Desde la perspectiva de los procesos, estos disponen de su propio espacio de nombres de puertos y sistema de archivos raíz. Es posible limitar los recursos de memoria y CPU de un contenedor. Algunas implementaciones de contenedores también permiten limitar la velocidad de E/S. Entre las tecnologías de contenedores se incluyen Docker y Solaris Zones.
El siguiente diagrama muestra la estructura de este patrón:
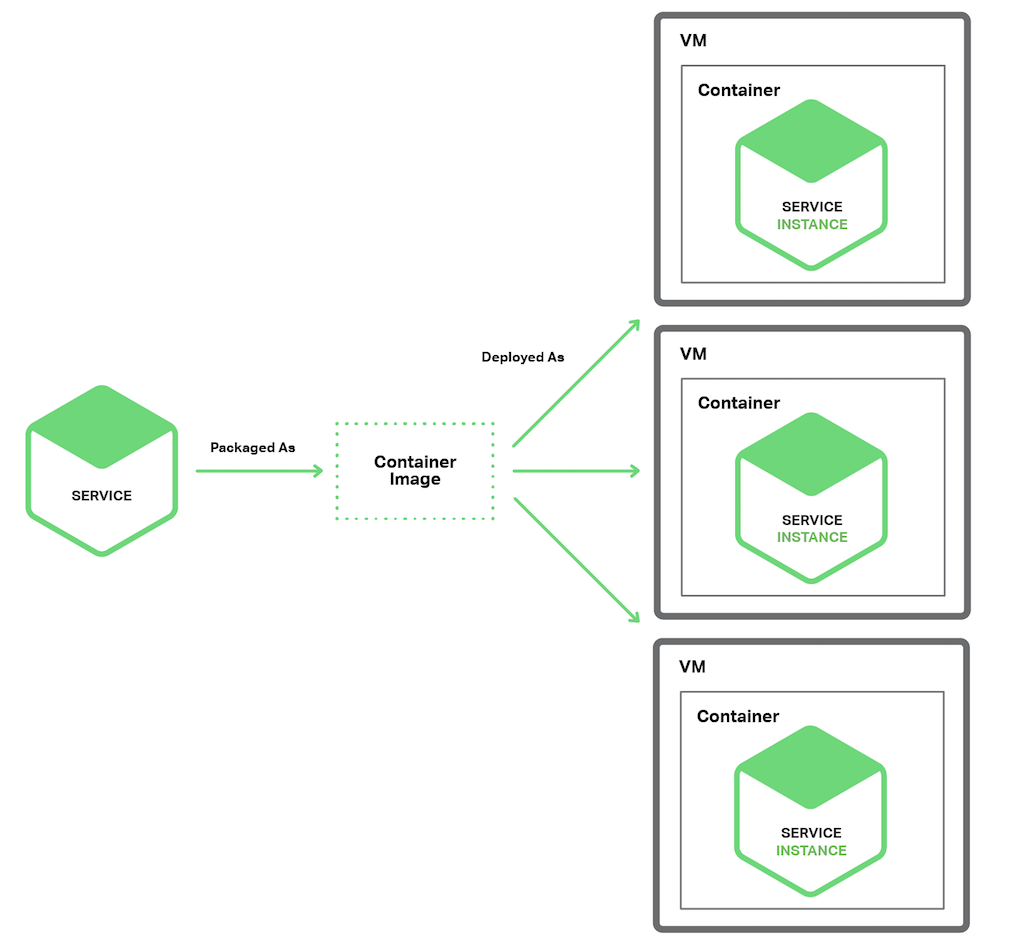
Para utilizar este patrón, debe empaquetar el servicio como una imagen de contenedor. Una imagen de contenedor es una imagen del sistema de archivos que contiene las aplicaciones y bibliotecas necesarias para ejecutar el servicio. Algunas imágenes de contenedor incluyen un sistema de archivos raíz de Linux completo. Otras son más ligeras. Para desplegar un servicio Java, por ejemplo, debe crear una imagen de contenedor que contenga el entorno de ejecución de Java, quizá un servidor Apache Tomcat, y la aplicación Java compilada.
Una vez que haya empaquetado el servicio como una imagen de contenedor, deberá iniciar uno o varios contenedores. Normalmente, se ejecutan varios contenedores en cada host físico o virtual. Puede utilizar un gestor de clústeres como Kubernetes o Marathon para gestionar los contenedores. Un gestor de clústeres trata los hosts como un conjunto de recursos y decide dónde ubicar cada contenedor en función de los recursos que este necesita y de los disponibles en cada host.
El patrón de una instancia de servicio por contenedor presenta tanto ventajas como inconvenientes. Las ventajas de los contenedores son similares a las de las máquinas virtuales. Permiten aislar las instancias de servicio entre sí. Puede supervisar fácilmente los recursos que consume cada contenedor. Además, al igual que las máquinas virtuales, los contenedores encapsulan la tecnología utilizada para implementar sus servicios. La API de gestión de contenedores también sirve como API para gestionar sus servicios.
Sin embargo, a diferencia de las máquinas virtuales, los contenedores son una tecnología ligera. Las imágenes de contenedor suelen crearse muy rápidamente. Por ejemplo, en mi portátil se tarda tan solo 5 segundos en empaquetar una aplicación Spring Boot como contenedor Docker. Los contenedores también se inician muy rápidamente, ya que no hay un largo proceso de arranque del sistema operativo. Cuando se inicia un contenedor, lo que se ejecuta es el servicio.
El uso de contenedores presenta algunos inconvenientes. Aunque la infraestructura de contenedores está madurando rápidamente, aún no está tan consolidada como la infraestructura para máquinas virtuales. Además, los contenedores no son tan seguros como las máquinas virtuales, ya que comparten entre sí el núcleo del sistema operativo anfitrión.
Otro inconveniente de los contenedores es que usted debe encargarse de la ardua y poco diferenciada tarea de administrar las imágenes de los contenedores. Además, a menos que utilice una solución de contenedores alojada, como Google Container Engine o Amazon EC2 Container Service (ECS), deberá administrar la infraestructura de contenedores y, posiblemente, la infraestructura de máquinas virtuales en la que se ejecuta.
Además, los contenedores suelen implementarse en una infraestructura cuyo precio se calcula por máquina virtual. Por consiguiente, como se ha descrito anteriormente, es probable que tenga que asumir el coste adicional de sobredimensionar las máquinas virtuales para hacer frente a los picos de carga.
Curiosamente, es probable que la distinción entre los contenedores y las máquinas virtuales se difumine. Como se ha mencionado anteriormente, las máquinas virtuales de Boxfuse se crean e inician rápidamente. El proyecto Clear Containers tiene como objetivo crear máquinas virtuales ligeras. [Editor: Tal como se anunció en diciembre de 2017, el desarrollo de Clear Containers continúa ahora en el proyecto de código abierto Kata Containers.] También existe un interés creciente por los unikernels. Docker, Inc. adquirió recientemente Unikernel Systems.
También existe el concepto más reciente y cada vez más popular de la implementación sin servidor, un enfoque que evita tener que elegir entre implementar servicios en contenedores o en máquinas virtuales. Veámoslo a continuación.
Despliegue sin servidor
AWS Lambda es un ejemplo de tecnología de despliegue sin servidor. Admite servicios Java, Node.js y Python. Para desplegar un microservicio, se empaqueta como un archivo ZIP y se sube a AWS Lambda. También se proporcionan metadatos que, entre otras cosas, especifican el nombre de la función que se invoca para gestionar una solicitud (también denominada evento). AWS Lambda ejecuta automáticamente suficientes instancias del microservicio para atender las solicitudes. Solo se factura cada solicitud en función del tiempo empleado y la memoria consumida. Por supuesto, el quid de la cuestión está en los detalles y, como verá en breve, AWS Lambda tiene limitaciones. Sin embargo, resulta sumamente atractiva la idea de que ni usted, como desarrollador, ni nadie de su organización tenga que preocuparse por ningún aspecto relacionado con servidores, máquinas virtuales o contenedores.
Una función Lambda es un servicio sin estado. Normalmente, gestiona las solicitudes invocando servicios de AWS. Por ejemplo, una función Lambda que se invoque cuando se cargue una imagen en un bucket de S3 podría insertar un elemento en una tabla de imágenes de DynamoDB y publicar un mensaje en un flujo de Kinesis para activar el procesamiento de imágenes. Una función Lambda también puede invocar servicios web de terceros.
Hay cuatro formas de invocar una función Lambda:
- Directamente, mediante una solicitud de servicio web
- Automáticamente, en respuesta a un evento generado por un servicio de AWS como S3, DynamoDB, Kinesis o Simple Email Service
- Automáticamente, a través de una puerta de enlace de API de AWS para gestionar las solicitudes HTTP de los clientes de la aplicación
- Periódicamente, según una programación similar a
cron‑like schedule
Como puede ver, AWS Lambda es una forma práctica de implementar microservicios. La tarificación basada en solicitudes implica que solo paga por el trabajo que realmente realizan sus servicios. Además, como no es responsable de la infraestructura de TI, puede centrarse en desarrollar su aplicación.
Sin embargo, existen algunas limitaciones importantes. No está pensado para desplegar servicios de larga duración, como un servicio que consume mensajes de un bróker de mensajes de terceros. Las solicitudes deben completarse en un plazo de 300 segundos. Los servicios deben carecer de estado, ya que, en teoría, AWS Lambda podría ejecutar una instancia independiente para cada solicitud. Deben estar escritos en uno de los lenguajes compatibles. Además, los servicios deben iniciarse rápidamente; de lo contrario, podrían superar el tiempo de espera y finalizarse.
Resumen
Desplegar una aplicación de microservicios es todo un reto. Hay decenas o incluso cientos de servicios escritos en diversos lenguajes y frameworks. Cada uno es una miniaplicación con sus propios requisitos específicos de despliegue, recursos, escalado y supervisión. Existen varios patrones de despliegue de microservicios, como una instancia de servicio por máquina virtual y una instancia de servicio por contenedor. Otra opción interesante para desplegar microservicios es AWS Lambda, un enfoque sin servidor. En la próxima y última parte de esta serie, veremos cómo migrar una aplicación monolítica a una arquitectura de microservicios.
Editor – Esta serie de siete artículos ya está completa:
- Introducción a los microservicios
- Creación de microservicios: uso de una puerta de enlace de API
- Creación de microservicios: comunicación entre procesos en una arquitectura de microservicios
- Descubrimiento de servicios en una arquitectura de microservicios
- Gestión de datos basada en eventos para microservicios
- Cómo elegir una estrategia de despliegue de microservicios (este artículo)
- Refactorización de un monolito en microservicios
También puede descargar la colección completa de artículos, junto con información sobre cómo implementar microservicios con NGINX Plus, en formato de libro electrónico: «Microservicios: del diseño a la implementación». Consulte también nuestra serie sobre la arquitectura de referencia de microservicios y la página de soluciones de microservicios.
El bloguero invitado Chris Richardson es el fundador de la plataforma original CloudFoundry.com, una de las primeras PaaS (plataforma como servicio) de Java para Amazon EC2. Actualmente asesora a organizaciones para mejorar la forma en que desarrollan e implementan aplicaciones. También publica regularmente sobre microservicios en https://microservices.io.
Sobre el autor
Artículos relacionados del blog

Únete a F5 NGINX en AppWorld 2024
Descubre las numerosas razones para asistir al evento insignia de F5, que incluirá un emocionante anuncio sobre la cartera de productos NGINX.
Rotación de certificados SSL/TLS sin reinicios en NGINX Open Source
La función de diccionario compartido permite configurar NGINX sin necesidad de reiniciarlo al renovar los certificados SSL/TLS.
Exposición de APIs en Kubernetes
La unidad 2 de Microservices March 2022 se centra en cómo exponer tus API en Kubernetes. Aquí tienes enlaces a los recursos que necesitas: la retransmisión en directo del 14 de marzo, artículos de blog y otros recursos de preparación, y el laboratorio práctico «Protege las API de Kubernetes mediante la limitación de solicitudes».
NGINX Sprint 2.0: visión clara, código renovado y nuevos compromisos con el código abierto
Hoy, en NGINX Sprint 2.0, anunciamos cómo respaldaremos nuestra visión del futuro de las aplicaciones modernas con una mayor presencia en la comunidad de código abierto, incluida la participación en el proyecto comunitario Kubernetes, nuevos proyectos de software de código abierto y la arquitectura de referencia para aplicaciones modernas.
Presentamos NGINX Plus R22
NGINX Plus R22 incorpora nuevas funcionalidades, como la compatibilidad con OCSP para verificar la revocación de certificados en TLS mutuo, el uso de varios proveedores de identidad OIDC en una configuración, el seguimiento en tiempo real de la limitación de solicitudes y conexiones en el panel de NGINX Plus y mejoras en NGINX JavaScript.
Presentamos NGINX Plus R17
NGINX Plus R17 incorpora compatibilidad con la limitación de velocidad en dos fases y con TLS 1.3, la versión más reciente del protocolo Transport Layer Security. La configuración de OpenID Connect es más sencilla y NGINX ModSecurity WAF es el doble de rápido que antes. También se ha actualizado el módulo JavaScript de NGINX.