En el cambiante mundo de la entrega de aplicaciones, las organizaciones están invirtiendo considerablemente en infraestructuras modernas, aplicaciones y automatización inteligente. Sin embargo, pese a esta inversión, muchas siguen enfrentándose a problemas que ya deberían estar resueltos: sistemas que fallan bajo presión, políticas de despliegue que no se mantienen entre distintos entornos y flujos de trabajo que se paralizan justo cuando más se necesita rapidez.
Dos de los diez principales retos de entrega a los que se enfrentan actualmente las organizaciones son especialmente reveladores: la falta de tolerancia a fallos y resiliencia, y la incompatibilidad entre las políticas de entrega. A primera vista, pueden parecer problemas de infraestructura o de herramientas, pero, al analizarlos más a fondo, queda claro que son síntomas de un defecto estructural más profundo: la complejidad de los flujos de trabajo operativos.
Esta complejidad no es solo una molestia. Perjudica activamente el rendimiento en tiempo de ejecución, socava la coherencia de las políticas e impide que las organizaciones aprovechen todo el potencial de sus inversiones en transformación digital.
La complejidad es el principal obstáculo operativo
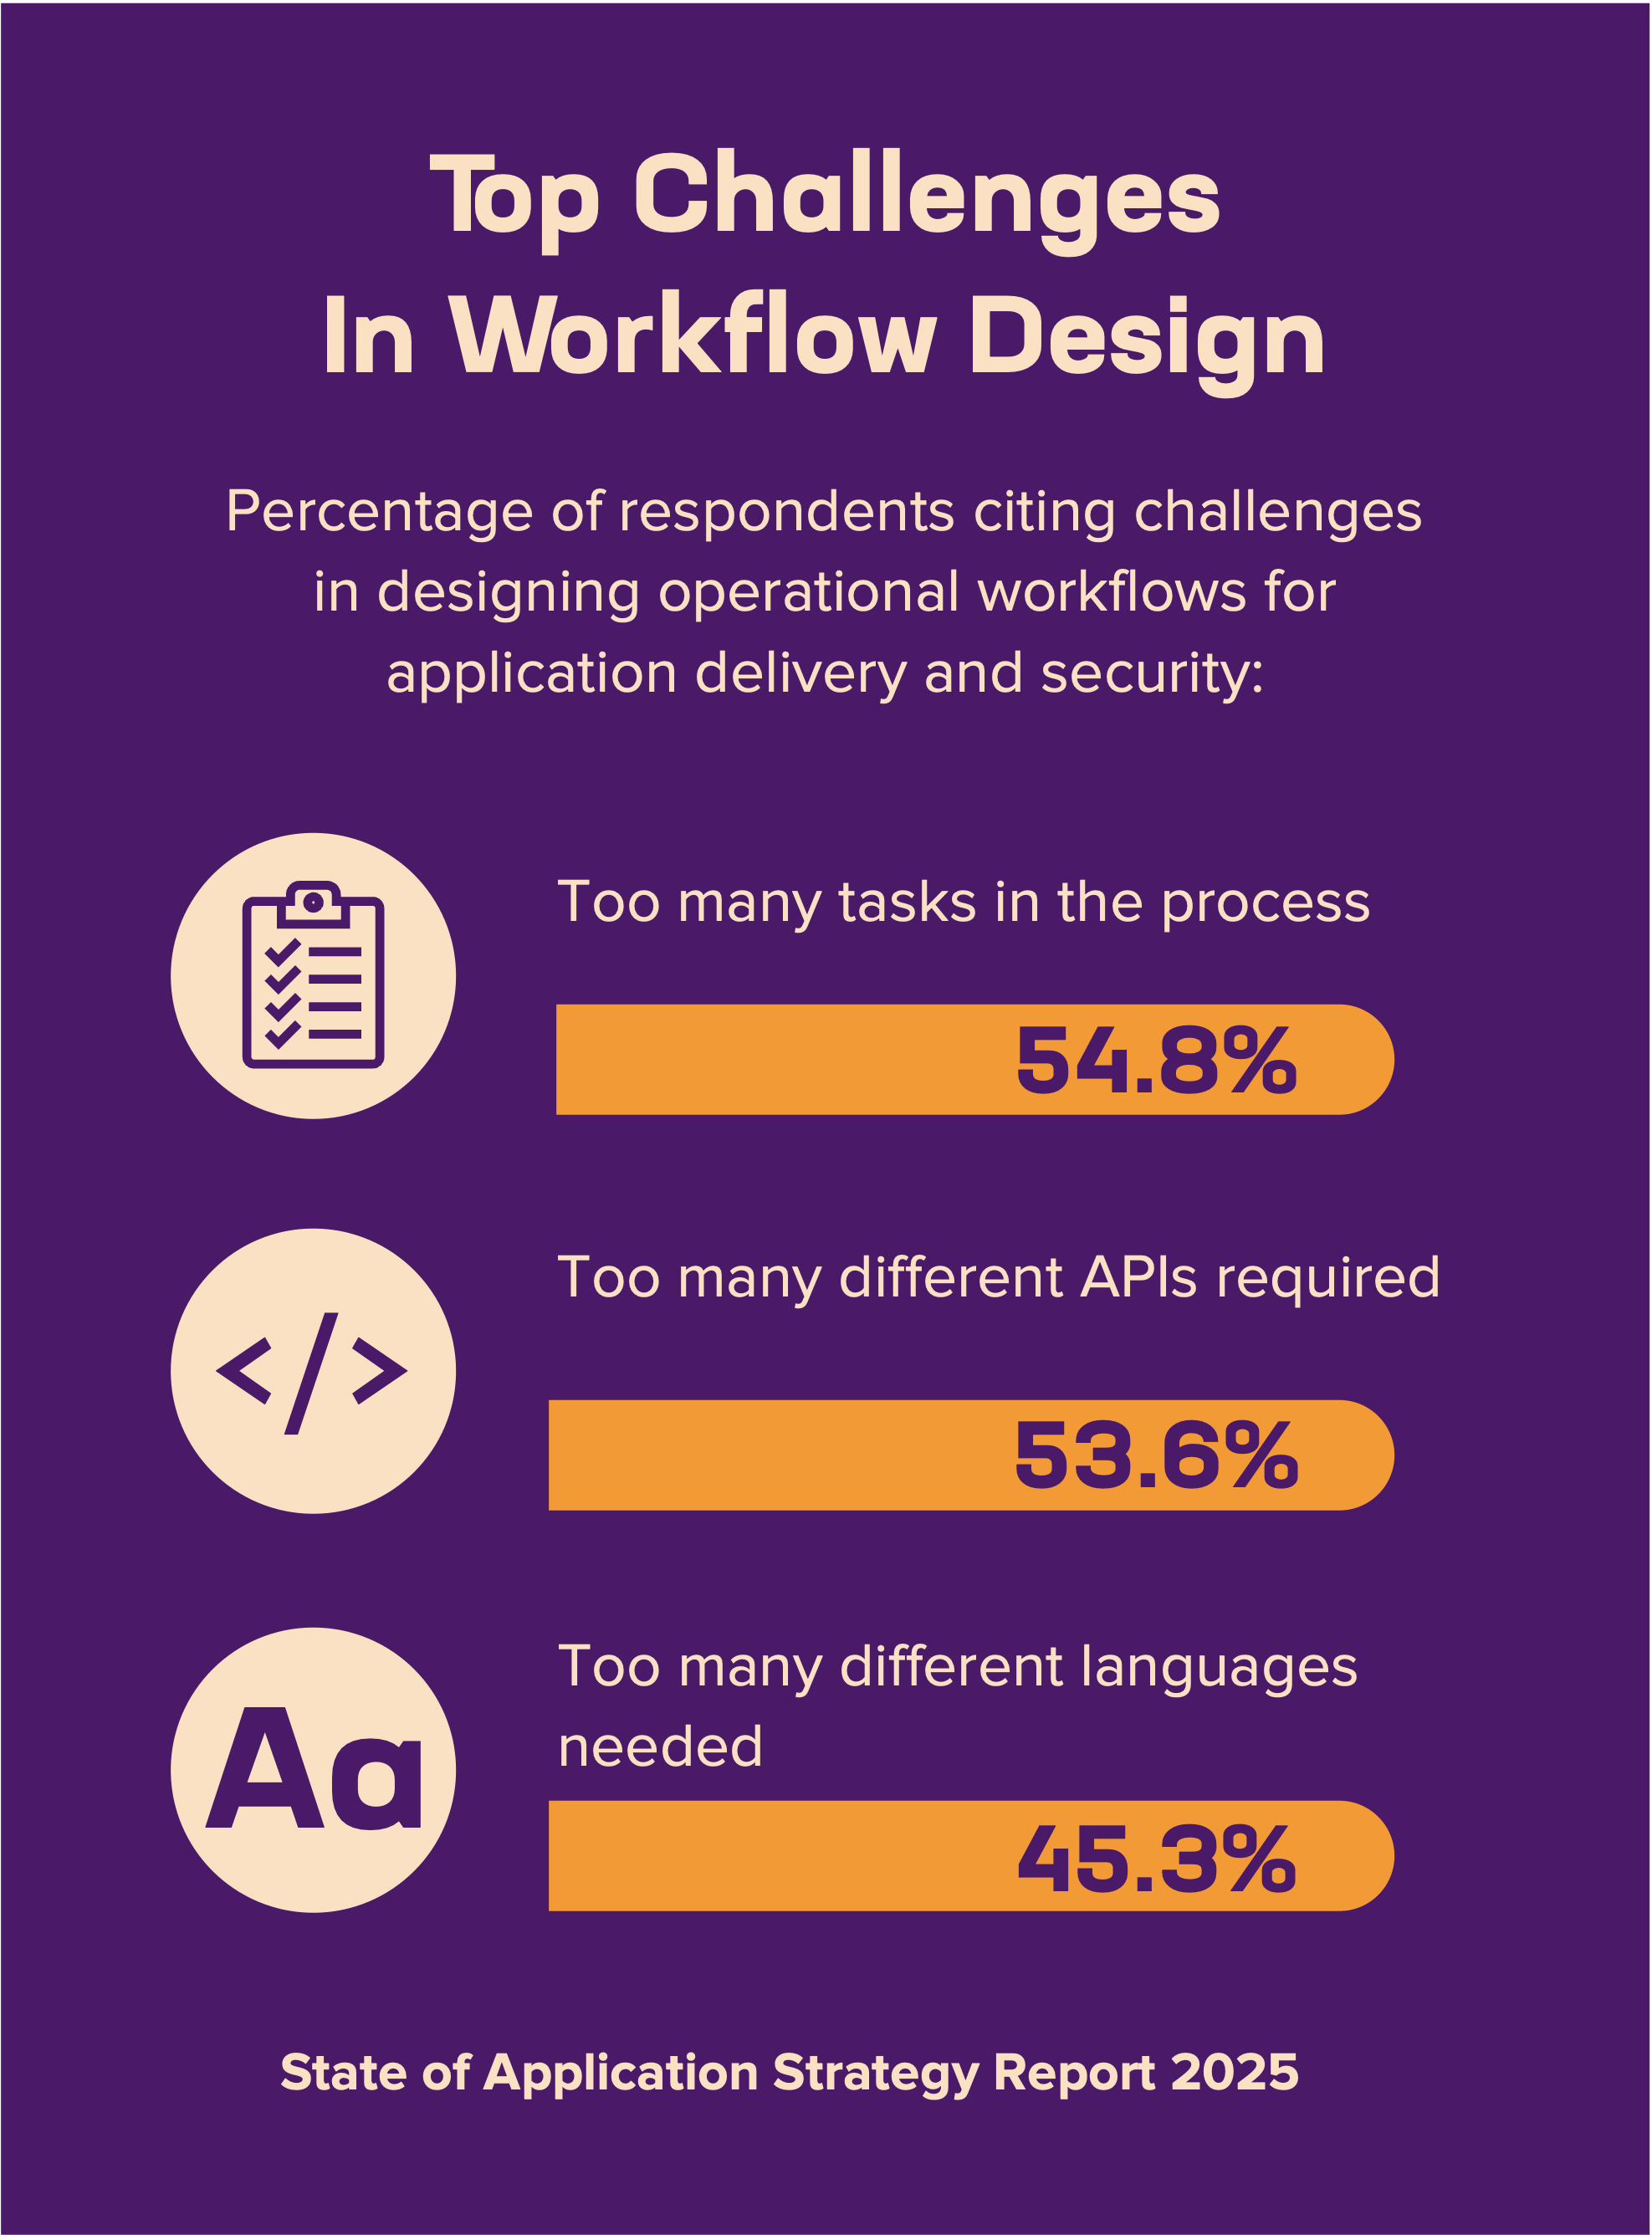
Y ese no es el único indicio. Casi el mismo porcentaje, un 53,6 %, afirmó que en sus flujos de trabajo intervienen «demasiadas API diferentes». Otro 45,3 % señaló como uno de los principales retos la «necesidad de utilizar demasiados lenguajes diferentes». Esto supone una fragmentación en la capa operativa: distintas herramientas, distintas sintaxis y distintos responsables. Todo ello aumenta la carga de trabajo y genera riesgos.
Estas cifras deberían preocupar a cualquiera que valore la disponibilidad, la experiencia de usuario o la agilidad operativa.
Cómo la complejidad debilita la resiliencia
Empecemos por ADC02 Falta de tolerancia a fallos y resiliencia. En una pila de aplicaciones moderna típica, puede haber media docena de capas diferentes responsables del enrutamiento, el equilibrio de carga, la detección de servicios, la autenticación, la telemetría y la aplicación de políticas. Cada una de estas capas podría estar a cargo de un equipo diferente. Cada una podría tener su propia API, su propio proceso de control de cambios y su propio lenguaje.
¿Qué ocurre cuando algo sale mal?
La conmutación por error no se activa porque la dependencia ascendente no detectó el fallo del nodo. Un nuevo despliegue dirige el tráfico de forma incorrecta porque la malla de servicios no estaba sincronizada con el equilibrador de carga. Se tarda varios minutos en aislar un pico de latencia porque las herramientas de observabilidad no estaban configuradas de forma coherente en todas las capas.
No se trata de casos extremos poco frecuentes. Son fallos operativos cotidianos provocados por la proliferación de flujos de trabajo. Y están directamente relacionados con los datos, que revelan que el 29 % de los encuestados aún depende de scripts personalizados para respaldar la automatización. Es una señal de alarma enorme. Crear scripts para sortear la complejidad no es automatizar, sino aplicar un parche frágil. Este falla cuando cambia el entorno y retrasa la recuperación cuando se degrada el rendimiento.
Cuando los flujos de trabajo operativos están saturados de traspasos, conocimiento no documentado y correcciones manuales, no existe una verdadera tolerancia a fallos. Solo queda confiar en que todo salga bien.
Cuando las políticas no acompañan a la aplicación
Cuando la mayoría de la gente oye hablar de «desviación de políticas», piensa en la seguridad. Sin embargo, la desviación en las políticas de entrega de aplicaciones —como las reglas de enrutamiento del tráfico, el comportamiento del balanceo de carga o las configuraciones de limitación de velocidad— puede ser igual de perjudicial. Esa es una de las causas de ADC07 Políticas de entrega incompatibles.
En una canalización bien orquestada, las políticas deberían acompañar a la aplicación desde el entorno de desarrollo hasta el de preproducción y, finalmente, el de producción. Sin embargo, en la práctica, las transiciones entre entornos suelen ser manuales, incoherentes y dependientes de las herramientas. Una regla de equilibrio de carga definida en preproducción puede no coincidir con la configurada en la nube pública. Una política de enrutamiento probada en desarrollo podría omitirse en producción debido a restricciones específicas del entorno o a un descuido. Los umbrales de las versiones canary, los comportamientos de almacenamiento en caché y la lógica de conmutación por error son políticas de la capa de entrega que suelen desviarse durante el despliegue.
La causa raíz es la misma que se señala en el informe State of Application Strategy 2025 de F5: la complejidad. Dado que el 45,3 % de los encuestados menciona que «se necesitan demasiados lenguajes diferentes» y el 53,6 % señala que hay «demasiadas API diferentes», está claro que los flujos de trabajo de entrega están fragmentados entre distintos ecosistemas de herramientas. Cada entorno puede utilizar modelos de configuración o plataformas de infraestructura como código diferentes, lo que exige realizar adaptaciones en cada etapa.
La traducción introduce riesgos. También provoca retrasos. Cuando las políticas de entrega deben reescribirse manualmente o adaptarse entre sistemas, la coherencia del despliegue se resiente. Y, en los sistemas distribuidos, la incoherencia suele ser peor que un fallo, porque genera un comportamiento impredecible.
Imagine un despliegue multirregional en el que una política de direccionamiento del tráfico solo se aplica en una zona. O una aplicación global con reglas de caché incoherentes entre los nodos perimetrales. El resultado es una experiencia de usuario deficiente cuyo origen es difícil de rastrear y aún más difícil de solucionar.
Para avanzar con rapidez sin que nada deje de funcionar, las organizaciones necesitan políticas de entrega declarativas, portátiles y aplicadas de forma coherente en todas las capas de la pila tecnológica. Esto es imposible cuando los flujos de trabajo dependen de una amalgama de procesos manuales y lógicas específicas de cada equipo.
Hasta que las políticas de entrega se traten como elementos de primer nivel —es decir, en igualdad de condiciones con el código de las aplicaciones y la configuración de la infraestructura—, las organizaciones seguirán teniendo problemas de divergencia, tiempos de inactividad y retrasos en las entregas. Simplificar esos flujos de trabajo es el primer paso y el más necesario.
La simplificación ya no es opcional
Reducir la complejidad de los flujos de trabajo no consiste en simplificar el diagrama de arquitectura ni en facilitar la vida a los equipos de operaciones (aunque lograría ambas cosas). Se trata de cumplir las promesas fundamentales de la infraestructura de aplicaciones moderna: velocidad, resiliencia y coherencia.
Las organizaciones que quieran mejorar el rendimiento en tiempo de ejecución y garantizar un comportamiento predecible en las entregas deben analizar detenidamente cuántas herramientas, equipos y transferencias intervienen en sus procesos. Y, lo que es más importante, deben preguntarse: ¿cuántos de estos pasos aportan valor y cuántos están ahí simplemente para sortear las limitaciones del sistema?
La respuesta no siempre es una herramienta nueva. A veces consiste en utilizar menos herramientas. Otras veces, consiste en una única plataforma unificada que aplica la lógica de entrega con la misma sintaxis y el mismo comportamiento en todos los entornos. Y otras veces consiste en automatizar no solo el despliegue, sino también la gobernanza, para que las políticas de entrega se apliquen como código y no como una lista de comprobación.
El camino hacia una entrega resiliente y fiable pasa por la simplificación. Hasta que no tratemos la complejidad como un riesgo crítico, seguirá socavando todo lo que hemos construido sobre ella.
Sobre el autor

Lori MacVittie es ingeniera distinguida y evangelista jefe en la Oficina del CTO de F5, y cuenta con una amplia experiencia en entrega de aplicaciones, estrategia de automatización e infraestructura. Es conocida por convertir la complejidad en claridad, ya sea definiendo mecanismos de protección para agentes de IA, analizando arquitecturas multinube frágiles o explorando los límites de los sistemas escalables. Aporta más de treinta años de experiencia en el sector en desarrollo de aplicaciones, arquitectura de TI y operaciones de redes y sistemas. Antes de incorporarse a F5, fue una galardonada editora de tecnología. MacVittie posee un máster en Informática y es una autora prolífica cuyas publicaciones abarcan la seguridad, la nube y la arquitectura empresarial. También es una apasionada de los juegos de mesa y los videojuegos, y expresa sin complejos sus firmes opiniones sobre el queso.
Más artículos de Lori Mac VittieArtículos relacionados del blog

Proteger los endpoints de las API dificulta la seguridad de las API
Descubre las complejidades de la seguridad de las API, los retos a los que se enfrentan las organizaciones, la evolución de los ataques contra endpoints de API y la necesidad de políticas de seguridad adaptadas.
¿Qué es el sesgo de la IA y por qué es importante para TI?
Descubre los fundamentos del aprendizaje de la IA. Aprende cómo pueden surgir sesgos en la IA y qué riesgos plantean para las TI y la transformación digital.
Redefiniendo la ciberseguridad en el extremo de la nube distribuida con IA y telemetría en tiempo real
La transformación digital y la adopción de tecnologías en la nube están provocando cambios en las arquitecturas de las aplicaciones. Estos cambios introducen nuevas superficies de ataque, que son el objetivo de métodos de ataque avanzados, altamente organizados y con motivaciones económicas. Mediante el uso del framework Morpheus de NVIDIA, F5 está investigando técnicas para detectar estas amenazas avanzadas con telemetría en tiempo real y análisis basados en IA.
El papel de la nube en las aplicaciones nativas del edge
No debería sorprender que, al igual que la aparición de la nube dio lugar a las aplicaciones nativas de la nube, el edge esté impulsando un conjunto de aplicaciones nativas del edge. Sin embargo, estas aplicaciones no residirán únicamente en el edge. Al mismo tiempo, están surgiendo nuevos patrones arquitectónicos que aprovechan las aplicaciones alojadas en la nube y en el centro de datos.
La creciente diversidad de ubicaciones y usuarios está impulsando a las empresas hacia el edge
En el contexto del ámbito de las aplicaciones, el término «usuario» siempre se ha referido a la entidad que interactúa con una aplicación. Del mismo modo que los cambios en las arquitecturas de las aplicaciones impulsan cambios en las tecnologías que permiten ofrecerlas y protegerlas, los cambios en la definición de usuario han provocado cambios en los lugares donde se despliegan las aplicaciones.
El edge está impulsando un renacimiento de las infraestructuras
A medida que las organizaciones aumentan la generación de datos y tratan de extraer valor empresarial de ellos, sin duda recurrirán a la analítica y la automatización basadas en la IA y el aprendizaje automático. Precisamente este tipo de cargas de trabajo son las que más se beneficiarían de una infraestructura optimizada y, sin embargo, hoy en día son las que menos probabilidades tienen de poder aprovecharla.