Ces derniers temps, dans les conseils d’administration, lors des conférences téléphoniques sur les résultats et dans un flot continu de tribunes, une même idée revient souvent : la prochaine avancée majeure dans l’économie de l’IA ne viendra pas uniquement de puces plus rapides.
L’argument est solide, mais l’enseignement à en tirer est plus large. Le premier effondrement du coût par jeton est le fruit d’avancées cumulées dans le matériel et les logiciels : accélérateurs plus rapides, meilleurs systèmes de mémoire, formats à précision réduite, PagedAttention, traitement continu par lots, optimisation du cache clé-valeur et frameworks d’inférence tels que vLLM. Le secteur est devenu nettement plus performant pour tirer parti de chaque accélérateur.
Le secteur a ensuite cherché le prochain domaine auquel appliquer la même rigueur, et s’est tourné vers le chemin des données, en particulier le stockage. Ce travail est essentiel, mais il ne représente que la moitié de l’équation.
Le chemin des données ne représente que la moitié du problème
Le stockage dans une usine d’IA n’est plus passif. Les modèles y sont chargés. Les points de contrôle y sont restaurés. La génération augmentée par récupération en dépend lorsque les contraintes de latence sont fortes. À une échelle suffisante, les niveaux de contexte et de cache peuvent s’étendre au-delà de la mémoire des GPU et de la mémoire système, car recalculer un travail déjà effectué mobilise coûteusement un accélérateur.
Mais l’économie de l’IA est façonnée par deux flux interconnectés. Le premier concerne le déplacement des données qui alimentent le modèle : l’endroit où résident les octets, la rapidité avec laquelle ils peuvent être récupérés et la fréquence à laquelle ils doivent être déplacés. Le second correspond au parcours d’une requête d’inférence : depuis un utilisateur, une application ou un agent, en passant par la gestion du trafic et l’application des politiques, jusqu’à un serveur de modèles, puis en sens inverse.
Ce second flux transporte des données en transit. Par rapport au calcul et au stockage, il reste insuffisamment mesuré et optimisé dans de nombreux environnements de production. C’est là que se décideront les prochains gains — et les prochains gaspillages.
La taxe sur les jetons
Sur un nœud GPU, le processeur central de l’hôte n’est pas inactif. Il gère le réseau, assure la terminaison du protocole TLS, applique les politiques, prend en charge le trafic est-ouest, génère des données de télémétrie et transfère les données entre les interfaces et les accélérateurs. Aucune de ces tâches ne produit directement de jetons. Lorsque le processeur devient un goulot d’étranglement, il réduit le volume utile de résultats d’inférence.
Appelons cela la taxe sur les jetons : une surcharge d’infrastructure qui mobilise les ressources de l’hôte et grève discrètement la rentabilité du nœud. La solution ne consiste pas toujours à utiliser un processeur hôte plus rapide. À grande échelle, les fonctions réseau, de chiffrement, de gestion du trafic et de sécurité qui s’y prêtent peuvent être transférées vers une infrastructure programmable déjà présente sur le chemin des données.
Lors de tests indépendants réalisés par The Tolly Group et commandés par F5, F5 BIG-IP Next for Kubernetes déployé sur des DPU NVIDIA BlueField-3 a offert un débit de jetons jusqu’à 40 % supérieur, un délai avant le premier jeton réduit de 61 % et une latence des requêtes réduite de 34 % par rapport aux solutions testées hébergées sur CPU.
L’incidence financière est claire. Si une infrastructure de taille fixe produit 1,4 fois plus de jetons commercialisables tout en respectant les objectifs de niveau de service requis, le coût d’infrastructure par jeton diminue d’environ 29 %. Le chiffre d’affaires par accélérateur peut également augmenter lorsque la demande est au rendez-vous. Cet argument commercial est plus pertinent que la simple affirmation selon laquelle le réseau est plus rapide.
Le routage est devenu de l’ordonnancement
L’équilibrage de charge classique répartit les requêtes. Cette approche fonctionne lorsque les requêtes sont globalement interchangeables. L’inférence des grands modèles de langage remet en cause cette hypothèse, car le coût d’une requête dépend de la longueur du contexte, de la longueur de la sortie, de l’état du cache, du modèle sélectionné, de la profondeur de la file d’attente et de la charge actuelle des accélérateurs.
- Une requête courte générant une réponse brève peut être plusieurs ordres de grandeur moins coûteuse qu’un contexte très long assorti d’une longue réponse.
- Une requête qui accède à un cache clé-valeur déjà alimenté peut éviter de recalculer la phase de préremplissage, une opération coûteuse.
- Les requêtes nécessitant beaucoup de préremplissage et celles nécessitant beaucoup de décodage peuvent interférer lorsqu’elles sont traitées par le même accélérateur.
- Un serveur de modèles avec huit requêtes en attente et un autre sans aucune requête peuvent sembler tout aussi sains lors d’un contrôle sans état.
Un gestionnaire de trafic qui n’a aucune visibilité sur ces conditions prendra nécessairement de mauvaises décisions de placement. Le coût se manifeste à deux niveaux : dans la latence ressentie par l’utilisateur, sous la forme du délai avant le premier jeton, et dans les recalculs que l’entreprise paie sous la forme de tâches effectuées en double.
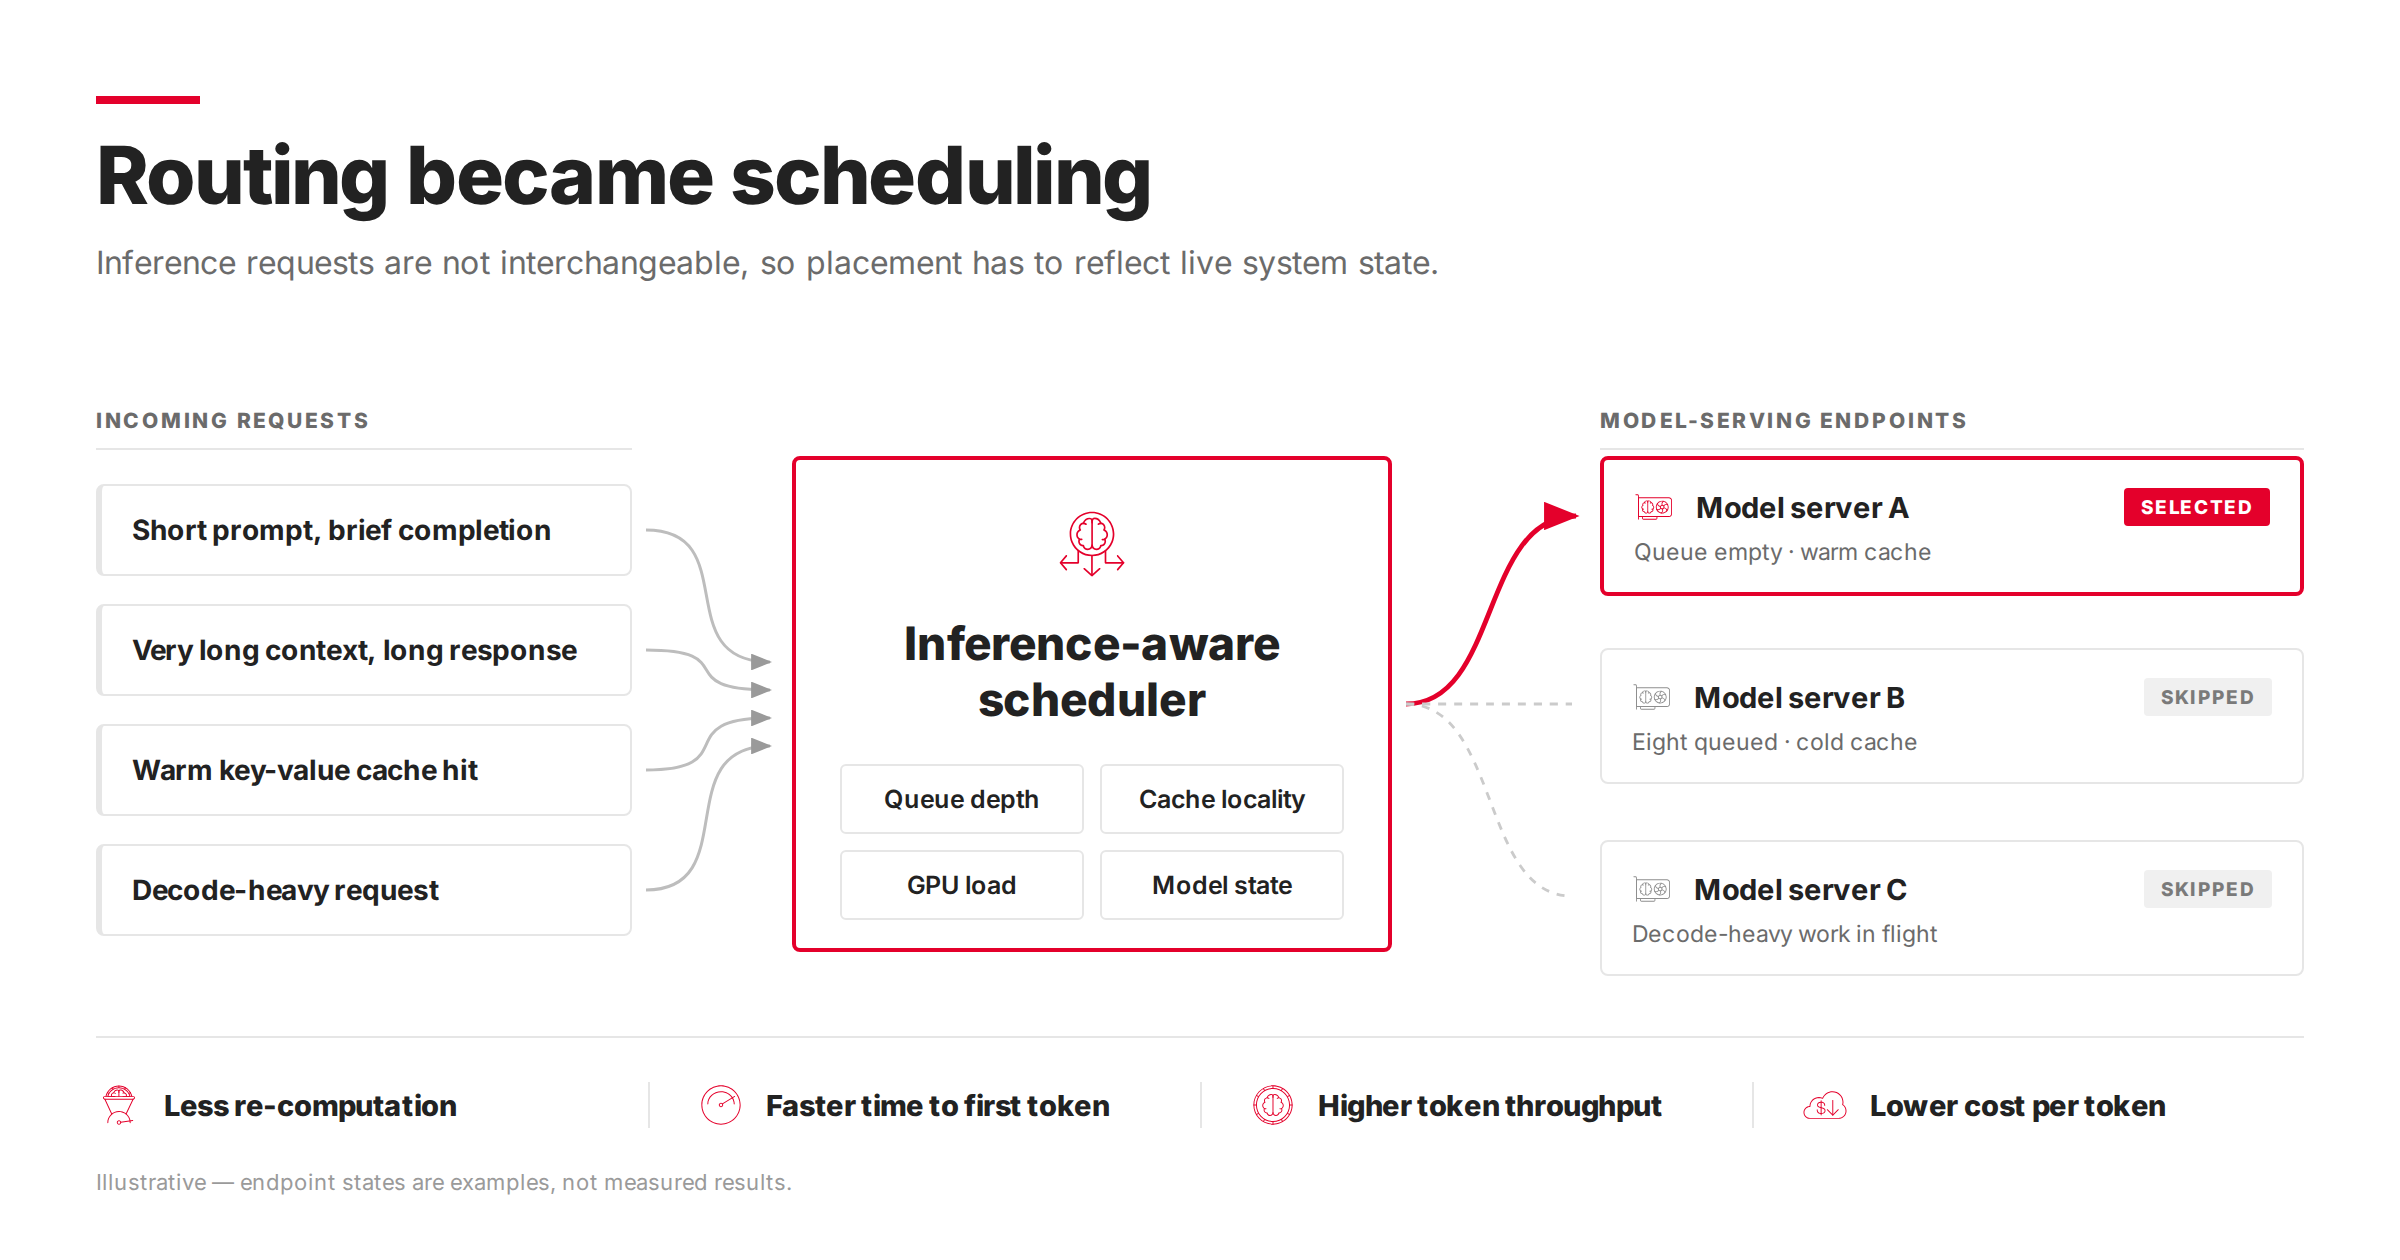
Le routage dans une usine d’IA n’est donc plus seulement une fonction réseau. Il s’agit d’une décision d’ordonnancement prise au sein du réseau. Cette décision s’appuie sur les mêmes données que celles dont tout ordonnanceur a besoin : l’état en temps réel des serveurs de modèles, la profondeur des files d’attente, la télémétrie des accélérateurs, la localité du cache et les signaux d’exécution provenant du framework d’inférence.
La sécurité est aussi une fonction de coût
La sécurité dans une usine d’IA est généralement abordée sous l’angle des risques : injection de prompts, fuite de données, agents outrepassant leurs autorisations et exposition aux risques réglementaires. Tous ces risques sont bien réels. Une étude de F5 révèle que 88 % des organisations signalent au moins un défi opérationnel ou de sécurité lié à l’IA.
Il faut également tenir compte de l’économie unitaire. Les requêtes bloquées avant l’exécution du modèle évitent des dépenses d’inférence inutiles. Celles qui ne sont évaluées qu’après la génération d’une réponse complète consomment des ressources de calcul avant que la politique ne soit appliquée. Si l’on multiplie cela par le trafic de scraping, les tempêtes de nouvelles tentatives, un agent bloqué dans une boucle ou les tentatives répétées de contournement des garde-fous, l’emplacement des mécanismes d’application commence à influer aussi bien sur les coûts que sur les risques.
Le principe n’est pas de regrouper tous les contrôles au même endroit. Certaines protections nécessitent une évaluation plus approfondie au niveau de l’application ou du modèle, et ces contrôles ont leur propre coût de calcul. L’objectif est d’appliquer le plus tôt possible le contrôle efficace le moins coûteux, puis de procéder à une inspection plus approfondie lorsqu’elle apporte une réelle valeur ajoutée.
Le trafic agentique accentue ce problème. Les agents réessaient, multiplient les requêtes en parallèle et appellent des outils qui sollicitent des modèles, lesquels en appellent d’autres. Ils génèrent un trafic à la vitesse des machines que les limites de débit conçues à l’échelle humaine ne sont pas prévues pour absorber. La défaillance ne se traduit pas toujours par une faille de sécurité. Parfois, elle se résume simplement à une facture.
La couche commerciale fait défaut
Si un opérateur ne peut pas comptabiliser les jetons par locataire, modèle, utilisateur et application, il devient difficile de fixer les prix, de mesurer l’utilisation, de refacturer les coûts, de garantir l’équité ou de préserver une marge. L’infrastructure peut disposer d’excellentes données télémétriques sur la consommation électrique et l’état de santé, tout en offrant une visibilité limitée sur l’attribution des revenus.
La mutualisation entre plusieurs locataires aggrave le problème. Une infrastructure GPU partagée dépourvue d’une isolation efficace et d’une comptabilisation par locataire signifie qu’un pic d’activité chez un locataire peut entraîner une violation des engagements de niveau de service pour un autre. Sur un cluster d’IA, un voisin bruyant n’est pas qu’une simple nuisance en matière de performances. Il peut provoquer une perte de clients.
Le chemin d’inférence offre le point d’observation transversal le plus cohérent, car il permet d’observer les requêtes et les réponses de l’ensemble des utilisateurs, applications, modèles et locataires. Les serveurs de modèles et les systèmes de facturation restent importants, mais c’est au niveau de ce chemin que les mesures et les règles peuvent être appliquées de manière uniforme.
Le plan de services d’inférence
En considérant ces problématiques dans leur ensemble, un troisième plan architectural se dessine. Le plan de calcul correspond aux GPU et aux accélérateurs que chacun intègre à son budget. Le chemin des données englobe le stockage, la récupération, la mise en cache et la mémoire. Le plan de service d’inférence régit la manière dont les requêtes parviennent aux accélérateurs, dont elles sont planifiées en fonction de l’état réel du système, ce qui est interrompu avant de consommer inutilement des ressources de calcul, ce qui est comptabilisé et à qui les coûts sont imputés.
Cette couche existe déjà, mais elle résulte souvent d’un assemblage fortuit de composants disparates : un équilibreur de charge ici, une passerelle API là, un maillage de services, un pare-feu d’applications web, des collecteurs de télémétrie et, au bout du compte, une feuille de calcul. Elle a rarement été conçue comme un système cohérent, doté d’une télémétrie partagée, de règles uniformes et de points d’application délibérément définis.
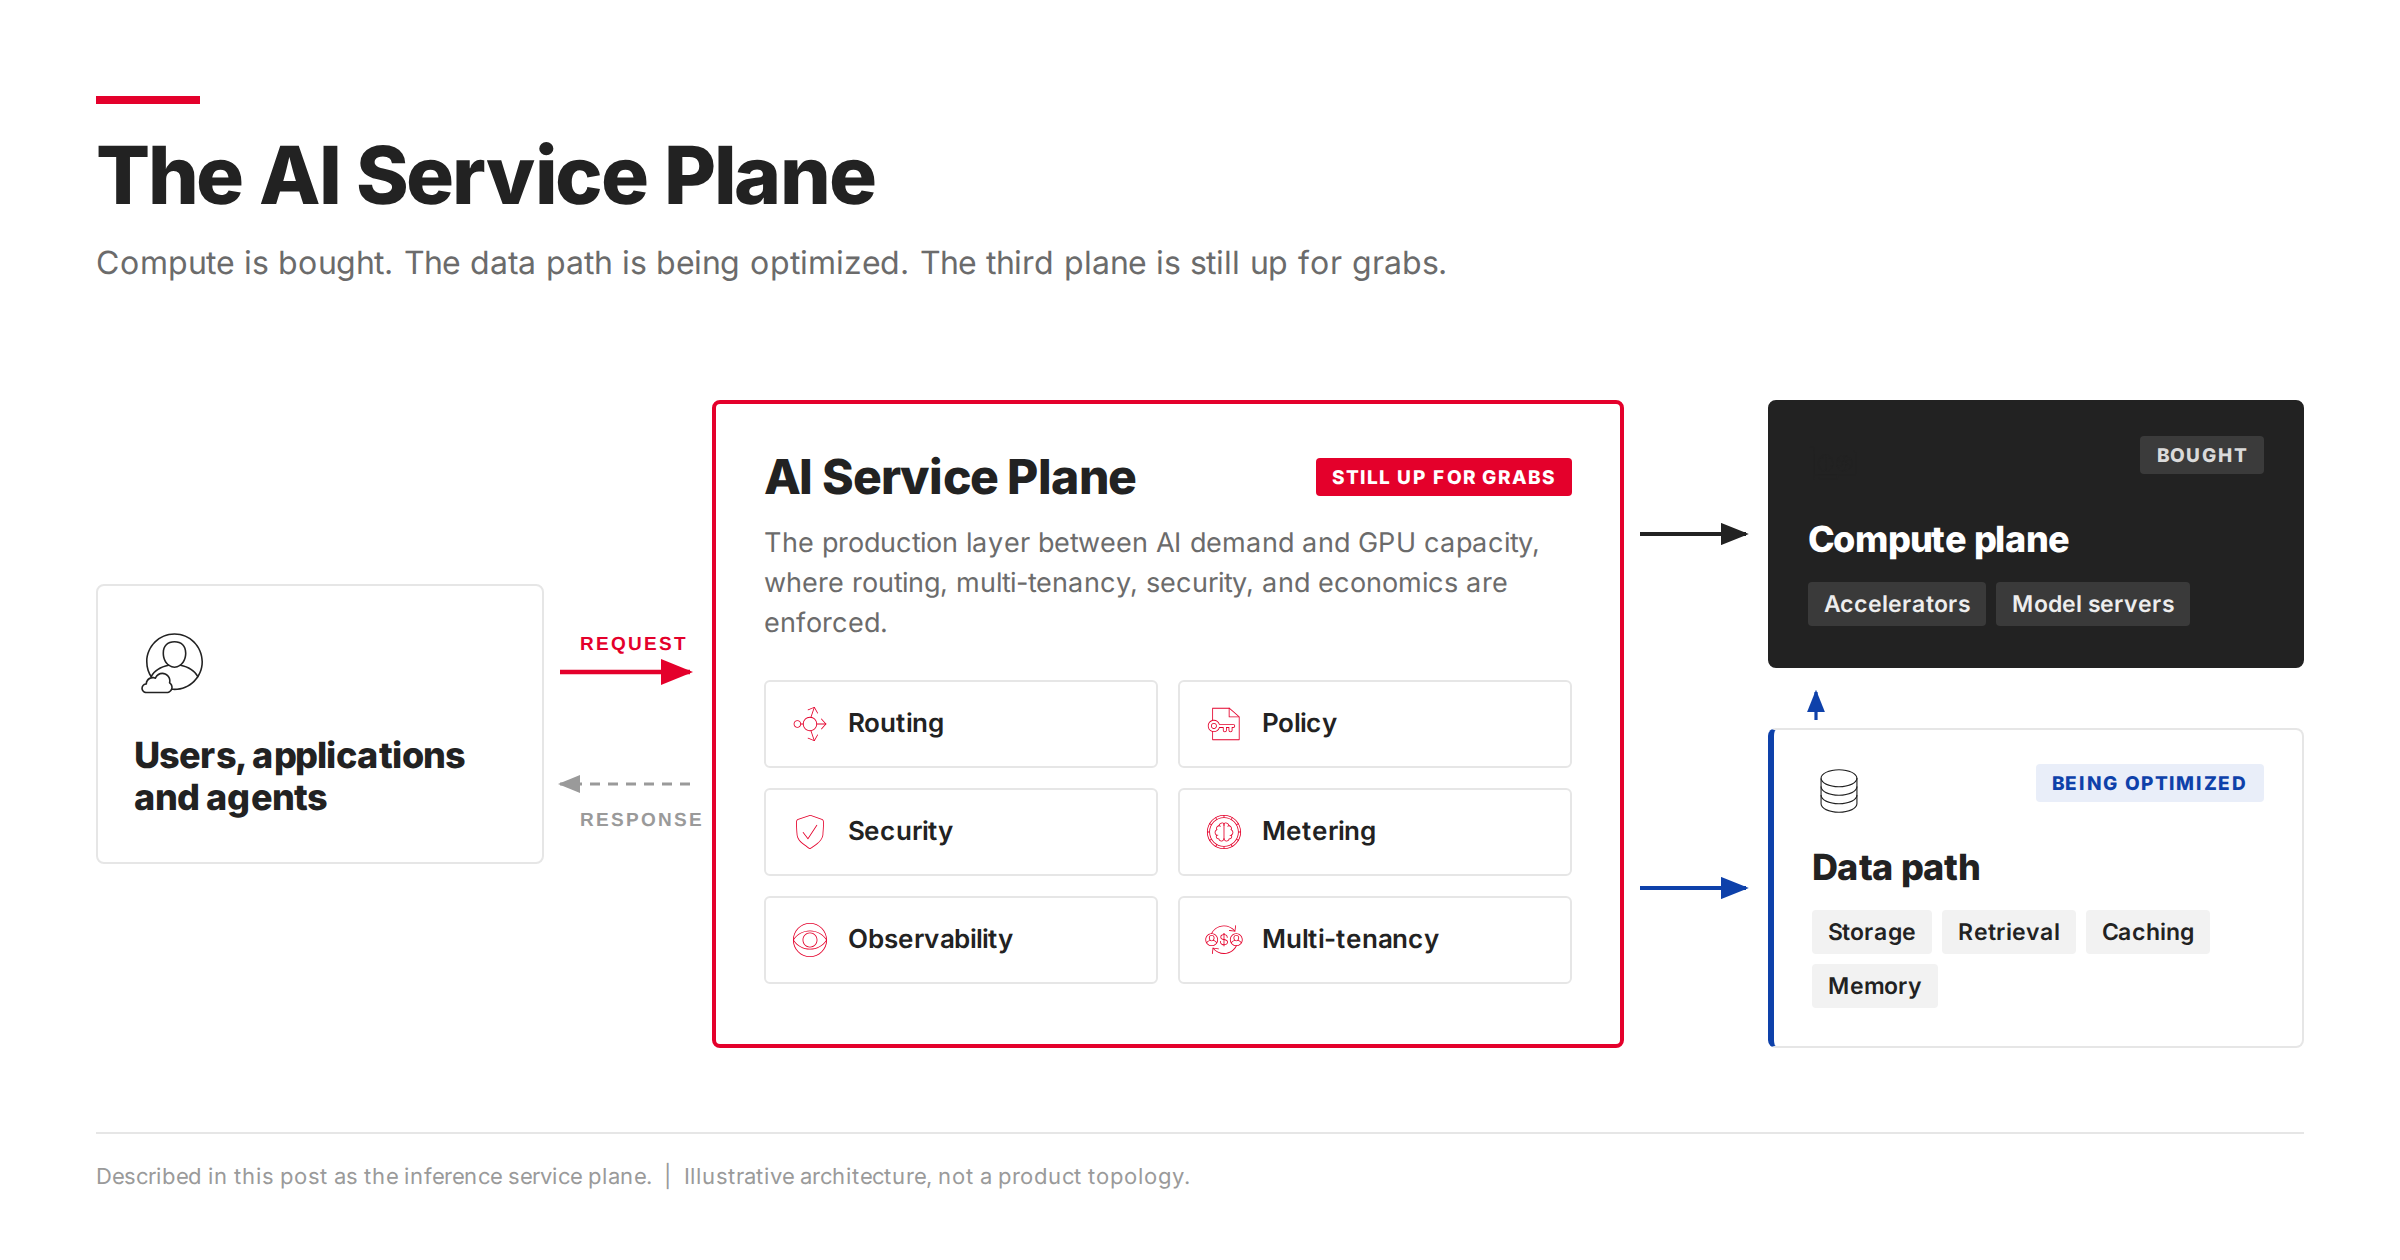
F5 BIG-IP Next for Kubernetes peut s’exécuter sur l’hôte ou sur des DPU NVIDIA BlueField. Cette solution assure la gestion du trafic native de Kubernetes, la sécurité, l’application de politiques mutualisées, l’observabilité, l’équilibrage de charge intelligent et la gouvernance des jetons sur l’ensemble du parcours d’inférence.
Au niveau de la couche applicative, F5 AI Gateway assure la gouvernance des modèles et des agents, le routage, la mise en cache, la mesure de l’utilisation, les contrôles de sécurité et l’auditabilité des invites, des réponses, des modèles et des outils.
L’orientation architecturale importe davantage que n’importe quel produit pris isolément : il faut définir clairement les politiques, les appliquer là où elles sont les plus efficaces et partager les données de télémétrie entre les couches d’infrastructure et d’application. C’est ainsi que les équipes d’exploitation réduisent les angles morts et évitent que des équipes distinctes maintiennent des contrôles divergents.
Concevez le parcours de manière intentionnelle
Trois questions doivent être abordées lors de la prochaine revue de l’infrastructure d’IA. Quel est le rendement en jetons utiles de la capacité d’accélération déjà provisionnée ? Quelle part du traitement hôte est consacrée à des tâches qui ne produisent pas directement de jetons ? Quel est le coût d’une requête rejetée lorsqu’elle atteint l’étape d’exécution du modèle avant que les règles ne soient appliquées ?
Dans l’ensemble du secteur, le débat se déplace de la capacité vers la conversion : il ne s’agit plus de savoir quelles infrastructures sont détenues, mais ce que l’on peut en tirer de manière fiable. La prochaine avancée majeure dans l’économie de l’IA ne viendra pas uniquement de puces plus rapides ni du seul stockage. Elle viendra d’une approche qui considère le parcours d’inférence comme un système économique.
Le plan de calcul est acquis. Le chemin des données est en cours d’optimisation. Le plan des services d’inférence reste à conquérir.
Pour en savoir plus, consultez le rapport sur les performances de l’IA.
À propos de l’auteur
Articles de blog associés

IA et cybersécurité
Découvrez comment l’IA et la cybersécurité fonctionnent de concert. Découvrez comment l’IA et le machine learning (ML) permettent à votre entreprise de rester sécurisée, efficace et prête à innover avec F5.

Suivre le rythme de l’innovation de pointe ne suffit pas à faire avancer l’entreprise : se préparer à la réglementation de l’IA
À mesure que la réglementation de l’IA évolue, réfléchissez aux mesures de protection que vous pouvez mettre en place dès maintenant.

Les contrôleurs de mise à disposition d’applications reviennent au cœur des priorités stratégiques
L’IA rebat les cartes de la livraison d’applications. Nirav Shah de F5 revient sur la nouvelle étude de Gartner® consacrée aux ADC et explique ce qu’elle implique pour les décisions des entreprises en matière d’infrastructure.

Ce que nos clients nous disent sur l’IA, le multicloud hybride et la sécurité des applications
Le nouveau vice-président senior du marketing produit de F5 explique les pressions liées à l’IA auxquelles sont confrontés les dirigeants d’entreprise et ce dont ils ont besoin pour renforcer leur organisation.

Cinq niveaux de cyberrésilience antifragile transforment les pratiques en résultats
Découvrez comment cinq niveaux de résilience antifragile transforment les perturbations en comportements adaptatifs qui limitent les défaillances et renforcent l’architecture multicloud hybride.

Optimiser les pipelines d’IA en éliminant les goulets d’étranglement dans les charges de travail modernes
À mesure que les charges de travail d’IA montent en puissance, les entreprises constatent des ralentissements provenant du pipeline de données en amont qui alimente le modèle d’IA. Voici comment F5 BIG-IP peut les aider.