
Les avantages d’une architecture de données bien conçue vont au-delà des processus opérationnels. Ils se traduisent par une efficacité opérationnelle accrue sur le plan stratégique, une compréhension plus approfondie de l’activité et la capacité à saisir des opportunités commerciales connexes, le tout avec une plus grande agilité.
L’application de livraison de repas, six mois plus tard…
Dans un précédent article, nous avons présenté un service fictif de commande et de livraison de repas, ainsi que plusieurs processus opérationnels clés du quotidien : le processus de commande client, le processus de collecte et de livraison des repas, et le traitement des paiements. Nous avons étudié comment une stratégie de données réfléchie, axée sur les principales données alimentant ces processus, permet de rendre les processus métier plus robustes, agiles et évolutifs.
Dans cet article, je souhaite aller au-delà de l’efficacité opérationnelle au quotidien et mettre en évidence les avantages plus stratégiques et à plus long terme d’une architecture de données pensée en amont. Projetons-nous six mois après notre scénario initial : en supposant que notre application ait rencontré le succès, les dirigeants de l’entreprise ont désormais identifié de nouvelles opportunités émergentes. Ils demandent à présent aux équipes techniques dans quelle mesure les systèmes sous-jacents peuvent évoluer et s’adapter rapidement et facilement à certaines opportunités et aux défis qui y sont associés :
- La croissance du service s’accélère, et l’entreprise souhaite s’étendre à d’autres villes.
- Dans le cadre de son expansion, le service souhaite pénétrer le marché californien, particulièrement lucratif, ce qui implique des exigences supplémentaires en matière de gouvernance des données.
- Les délais de livraison ont progressivement augmenté, souvent en raison de pics de demande imprévus. La technologie peut-elle contribuer à résoudre ce problème ?
- L’entreprise fait face à la concurrence de start-up émergentes, et certains restaurants ont évoqué la possibilité de passer à un service concurrent. Pouvons-nous démontrer notre valeur ajoutée à nos fournisseurs (les restaurants) afin de les fidéliser ?
Les quatre exemples de défis présentés peuvent être répartis en deux grandes catégories :
Premièrement, optimiser et améliorer l’efficacité des principaux processus opérationnels quotidiens (« tactiques »).
Deuxièmement, créer de nouvelles connaissances qui génèrent de la valeur à plus long terme (« stratégique ») pour l’entreprise, directement ou indirectement, par l’intermédiaire de ses clients.
Les deux premiers nouveaux défis — l’expansion territoriale et les exigences de conformité qui y sont associées — concernent des processus métier tactiques et sont donc de nature plus opérationnelle. Les deux derniers défis sont de nature plus stratégique.
Examinons d’abord les enjeux tactiques et opérationnels.
Améliorations de l’efficacité opérationnelle
Avec l’expansion géographique vers d’autres villes, nous pourrions rencontrer plusieurs difficultés. Dans le cadre du processus de livraison, l’une d’elles pourrait concerner l’ambiguïté des adresses postales : une même adresse (par exemple, « 100 Main St. ») peut exister dans plusieurs villes. Autre difficulté possible : les villes peuvent se trouver dans des fuseaux horaires différents. Si ce facteur n’était pas pris en compte, un colis récupéré à 18 h 00 MDT pourrait être livré avec une heure de retard dans une ville voisine située dans le fuseau PDT (à 18 h 30 PDT). L’architecture de données décrite dans notre article précédent intégrait le principe d’une représentation « normalisée » — et unique à l’échelle mondiale — des éléments de données. Elle répond ainsi à ces deux difficultés potentielles et permet à l’application de prendre implicitement en charge ces exigences supplémentaires.
La deuxième préoccupation d’ordre tactique concerne le respect des exigences supplémentaires de l’État de Californie en matière de gouvernance des données. L’ensemble des problématiques liées au California Consumer Privacy Act (CCPA) pourrait à lui seul faire l’objet de toute une série d’articles, mais l’un des enjeux consiste à pouvoir rassembler toutes les données relatives à un client, en indiquant la date de leur collecte ainsi que leur source. Comme indiqué précédemment, la mise en place d’un cadre d’architecture des données permettant au pipeline principal d’ingestion des données d’ajouter des annotations de métadonnées, telles que des horodatages, permet de répondre simplement à des exigences supplémentaires en matière de gouvernance des données, moyennant un effort additionnel minime.
Valeur stratégique
Outre la valeur commerciale générée par l’amélioration des flux de travail et des processus tactiques quotidiens de l’entreprise, un autre avantage — sans doute plus important — réside dans la valeur stratégique que représente la capacité à modifier les règles du jeu existantes tout en ouvrant de nouveaux terrains sur lesquels se positionner.
Réinventer les flux de travail opérationnels pour les applications adaptatives
L’un des avantages stratégiques réside dans la capacité à « changer les règles du jeu » en repensant la structure des principaux processus opérationnels. Il ne s’agit plus simplement de les optimiser, mais de les réinventer. Une architecture de données robuste et tournée vers l’avenir permet d’exploiter avec agilité et efficacité les capacités clés — agrégation et analyse des données — nécessaires pour remédier, grâce à une tarification dynamique, à l’allongement des délais de livraison dû aux fluctuations de la demande évoqué précédemment.
Plus précisément, grâce à la réflexion menée en amont sur l’architecture des données, celle-ci :
- Conserve l’horodatage de chaque commande et de chaque livraison, en utilisant une syntaxe et une sémantique cohérentes, même dans plusieurs tables de base de données
- Conserve un historique des lieux d’enlèvement et de livraison, là encore en utilisant une syntaxe et une sémantique cohérentes
Ainsi, les données issues de deux workflows distincts — la prise de commande et la livraison — peuvent être mises en corrélation, classées et agrégées. En outre, la souplesse de l’architecture des métadonnées permet d’annoter les données regroupées avec des informations contextuelles enrichies à des fins d’analyse. Prenons le délai global de livraison, c’est-à-dire le temps écoulé entre la prise de commande et la livraison du repas. Ce délai peut être calculé en mettant en corrélation les workflows de prise de commande et de livraison. Par ailleurs, comme la représentation des données de géolocalisation utilise également une syntaxe et une sémantique cohérentes dans les deux workflows, les calculs et les corrélations relatifs au délai de livraison peuvent être ventilés par zone géographique, par exemple par code postal. Ainsi, grâce à une stratégie de données pensée en amont, nous pouvons créer plus facilement un jeu de données sur le délai global de livraison, avec une granularité horaire et par code postal. Enfin, grâce à notre approche flexible des métadonnées, les statistiques horaires peuvent être enrichies d’informations contextuelles supplémentaires, telles que les conditions de circulation et les cumuls de précipitations.
À ce stade, nous disposons d’informations riches pour alimenter un pipeline analytique, qui peut ensuite utiliser des méthodes d’IA prédictive afin d’identifier les tendances corrélées à une augmentation du délai global de livraison, voire d’anticiper de telles conditions à l’avenir.
Pour conclure ce scénario, nous pouvons imaginer que l’entreprise repense désormais le processus de livraison comme une problématique d’offre et de demande, en utilisant la tarification pour équilibrer les deux. Concrètement, la rémunération du livreur pourrait être ajustée en fonction de l’heure et du lieu, soit selon un barème fixe, soit de manière dynamique, en fonction des conditions en temps réel. Cela permet de « boucler la boucle » du cycle des données : les données sont exploitées pour prendre des mesures concrètes (ajustements tarifaires) afin de répondre à un enjeu métier (la maîtrise du délai global de livraison), tandis qu’une boucle de rétroaction (ajustements tarifaires dynamiques en fonction du délai observé) rend le processus « adaptatif ».
Créer de la valeur commerciale directement monétisable à partir des données
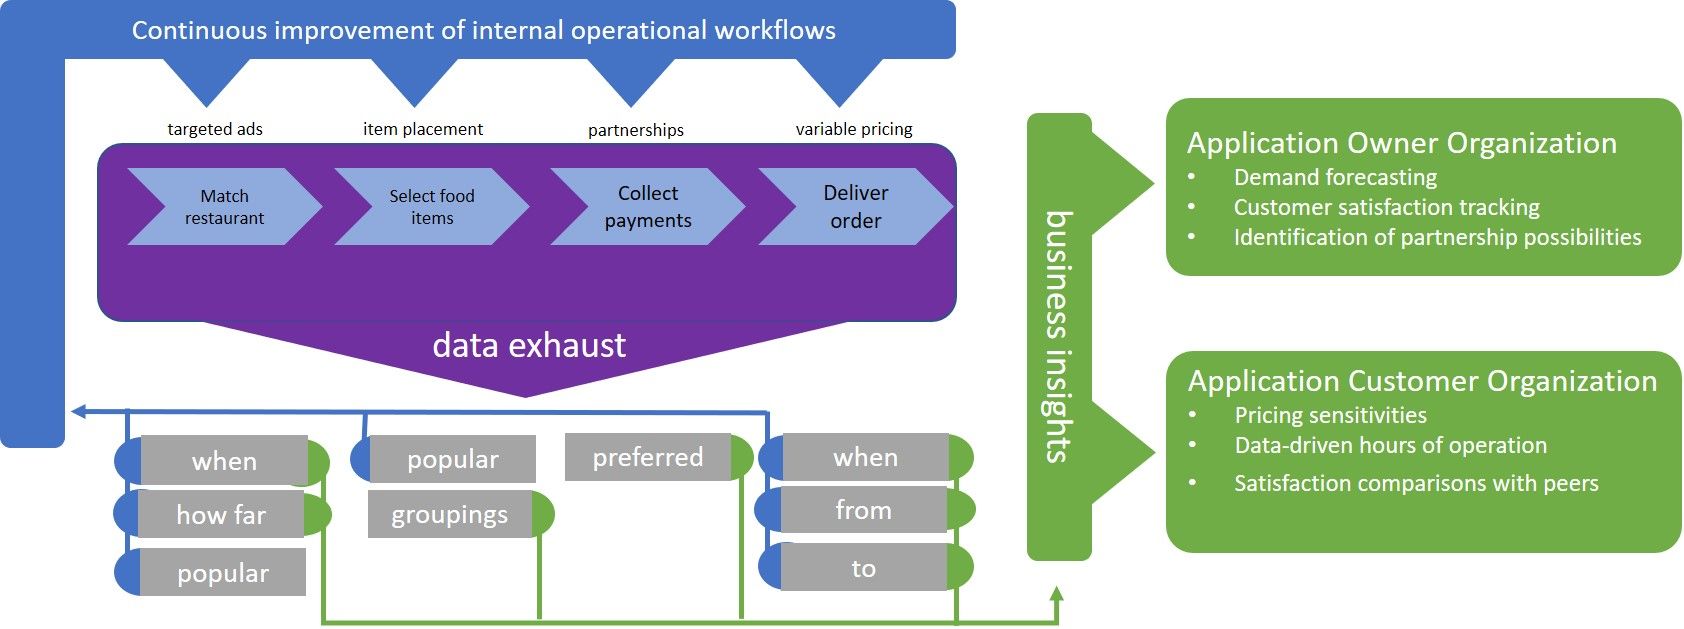
Une autre façon de tirer parti des données consiste à les utiliser pour « ouvrir de nouveaux horizons », en créant une valeur commerciale directement monétisable grâce aux avantages apportés aux clients. Notre scénario à six mois en donne un exemple : créer de la valeur pour nos partenaires fournisseurs, à savoir les restaurants. Pour répondre au besoin de fournir des informations pertinentes aux clients de notre application, nous pouvons une fois encore exploiter les données recueillies par les processus opérationnels de celle-ci, cette fois comme matière première afin d’en extraire des enseignements commerciaux destinés à nos clients et partenaires. Ces enseignements peuvent prendre différentes formes, par exemple :
- Une prévision anticipée d’une demande plus forte que la normale, afin que le partenaire puisse s’y préparer en conséquence.
- Des informations sur la tarification de certains plats de leur carte, afin de comprendre la sensibilité de la demande et de comparer leurs prix à ceux d’un ensemble de restaurants similaires.
- Des données quantifiables pour aider le restaurant dans sa planification stratégique, telles que l’impact prévisionnel sur le chiffre d’affaires d’une augmentation ou d’une réduction de ses horaires d’ouverture.
La découverte de ces informations stratégiques ne repose pas uniquement sur l’existence d’un vaste référentiel de données, mais aussi sur la stratégie de données qui consiste à annoter les données collectées de manière structurée, à l’aide d’un vocabulaire de métadonnées cohérent.
En examinant de plus près un cas particulier d’analyse métier, voyons comment il serait possible de dégager des enseignements sur la tarification des menus. En partant de la matière première — les données opérationnelles recueillies dans le cadre du processus de commande —, l’intérêt d’une stratégie de données enrichies de métadonnées devient immédiatement évident. En effet, le prix d’un article dans un restaurant donné n’est pas la seule information enregistrée : les métadonnées associées sont également conservées. Prenons les attributs descriptifs supplémentaires d’un aliment, tels que la taille de la portion, le « type » d’aliment (par exemple, « boisson sans alcool » ou « hamburger ») et les « caractéristiques » particulières (par exemple, « accompagnement inclus » ou « épicé »). Si l’architecture de données enrichit les données relatives aux aliments avec des métadonnées correspondant à ces attributs, en utilisant un vocabulaire cohérent de balises de métadonnées (par exemple, « portion en onces », « catégorie d’aliment », « caractéristiques ») ainsi qu’un ensemble normalisé de valeurs de métadonnées, les informations sur les aliments peuvent alors être comparées entre les restaurants. Par exemple, si la base de données de codes indique uniquement que le « Burger Basement » propose un Man Cave Burger et que le « Heart Attack Grill » propose le Double Bypass Burger, aucune comparaison pertinente n’est possible. En revanche, si nous ajoutons un vocabulaire d’annotation des métadonnées, nous pouvons effectuer des comparaisons et des analyses : le système comprendrait que les deux articles sont comparables, car ils appartiennent tous deux à la « catégorie d’aliment » « hamburger ». En outre, les analyses peuvent également exploiter les autres champs de métadonnées pour normaliser la taille des portions (par exemple, le « Man Cave » peut peser 8 onces et le « Double Bypass », 12 onces). Enfin, l’utilisation d’un ensemble standard de valeurs de « caractéristiques », telles que « fromage inclus », peut également permettre d’effectuer des ajustements supplémentaires en fonction de similitudes et/ou de différences secondaires. Une fois encore, la réflexion menée en amont sur l’architecture des données — cette fois-ci autour de la stratégie de métadonnées — a permis à l’entreprise de saisir rapidement de nouvelles opportunités commerciales en exploitant simplement les données résiduelles générées par les processus existants.
Résumé
La plupart des dirigeants d’entreprise sont pleinement conscients que leur réussite repose sur la planification de leurs processus opérationnels critiques, ainsi que sur la visibilité dont ils disposent quant à leur exécution. Les bons dirigeants comprennent également que leur capacité à obtenir ces informations rapidement et efficacement, puis à prendre des mesures, tant en interne qu’à l’externe, sur la base de celles-ci est essentielle à la pérennité de leur réussite.
En tant que professionnels des technologies, nous sommes chargés de concevoir des solutions permettant d’atteindre ces objectifs métier d’amélioration continue de l’efficacité opérationnelle et d’agilité. Malheureusement, les ingénieurs se concentrent trop souvent sur les composants logiciels de traitement des données de la solution, au détriment de l’architecture des données elle-même. Cela entraîne souvent des efforts considérables et des délais de déploiement qui ralentissent l’amélioration des processus internes et le lancement de nouvelles offres dérivées destinées aux clients. Comme le montre cet article, accorder dès le départ une attention particulière à l’architecture des données — vocabulaire, représentations et stratégie de métadonnées — constitue le socle technologique d’une entreprise agile, robuste et pilotée par les données.
À propos de l’auteur
Articles de blog associés

Pourquoi devriez-vous vous intéresser à WebAssembly ?
WebAssembly (Wasm) est un jeu d’instructions binaires portable, rapide et sécurisé, qui permet d’exécuter des applications hautes performances sur n’importe quelle plateforme.

Trois choses à savoir sur les applications d’IA
Les applications d’IA sont des applications modernes, mais elles présentent certaines particularités. Découvrez les points essentiels à connaître sur les applications basées sur l’IA.
État des lieux de la stratégie applicative 2022 : il est temps de moderniser les opérations
Il est devenu évident que, pour maintenir la dynamique de leur transformation numérique, les organisations doivent recentrer leurs efforts sur les fonctions métier. Si les expériences destinées aux clients restent prioritaires, il est également indispensable de permettre la numérisation de fonctions telles que les services juridiques, les ressources humaines et la finance. Les DSI prennent donc les commandes, tandis que la transformation numérique passe de la modernisation des applications à celle des opérations.
Clouds multiples ou multicloud : faciliter la transition
La gestion et la sécurisation des charges de travail deviennent complexes à mesure que les entreprises adoptent une stratégie de cloud connecté. Découvrez comment F5 répond au besoin d’une nouvelle approche de la mise en réseau multicloud.
L’expérience client dépend de la visibilité
Une enquête menée par Dimensional Research auprès de plus de 3 000 utilisateurs d’applications mobiles a confirmé ce que beaucoup d’entre nous pensent des attentes actuelles des clients.
Transformation numérique et explosion du portefeuille d’applications
La transformation numérique stimule la croissance des portefeuilles d’applications et modifie la manière dont celles-ci sont développées, déployées, intégrées et, en définitive, utilisées.