
Contexte
Dans deux articles précédents, nous nous sommes penchés sur les enjeux de la conception pilotée par les données, et plus particulièrement sur la manière dont les données d’entreprise recèlent une valeur latente pour l’activité. Le message essentiel était qu’une architecture de données structurée constitue le socle technique permettant d’exploiter cette valeur intrinsèque. Toutefois, ces articles se limitaient à présenter les sujets concernés sur le plan conceptuel. Aujourd’hui, je souhaite illustrer ces concepts à travers un exemple plus concret et parlant : un récit montrant comment envisager l’architecture d’une application selon une approche donnant la priorité aux données.
Mais d’abord, pourquoi devrais-je m’y intéresser ?
Mais avant d’entrer dans le vif du sujet, rappelons pourquoi les données sont aujourd’hui plus importantes qu’elles ne l’étaient autrefois. Historiquement, de nombreuses entreprises collectaient et stockaient des données principalement pour répondre à des impératifs de gouvernance, tels que l’audit et la conformité. La collecte et le stockage des données étaient donc considérés comme une sorte de « taxe » pesant sur les activités de l’entreprise, sans grande valeur opérationnelle directe perçue.
Ce qui a changé aujourd’hui, c’est que l’on comprend mieux que les données collectées peuvent être exploitées afin d’optimiser les processus métier et d’améliorer l’expérience client. Par exemple, selon une récente enquête menée auprès d’entreprises du commerce de détail numérique, ces deux objectifs — améliorer les processus métier et l’expérience client — constituaient les principaux moteurs de la transformation numérique pour 57 % de l’ensemble des entreprises interrogées. Le constat essentiel, au cœur de la question « pourquoi est-ce important ? », est que les workflows fondés sur les données ont une incidence sur l’entreprise aussi bien dans les domaines tournés vers l’extérieur, comme l’expérience client, que dans les domaines internes liés aux processus métier fondamentaux. C’est pourquoi une stratégie de données réfléchie et délibérée est indispensable pour garantir la qualité et la rentabilité des workflows métier les plus importants. En outre, lorsque les workflows sont équipés pour transmettre les données résiduelles observées à une infrastructure de collecte et d’analyse des données, ils peuvent eux-mêmes être analysés et améliorés en continu, ce qui permet d’obtenir des workflows métier constamment adaptés et optimisés.
À noter que la principale préoccupation de ces mêmes entreprises concernant la transformation numérique était de garantir la cybersécurité de ces processus numériques — un autre domaine dans lequel, en définitive, cette même approche fondée sur la télémétrie et l’analyse des données joue un rôle essentiel — mais je réserve ce sujet pour un prochain article.
L’application : commande et livraison de repas
Pour poursuivre notre expérience de pensée, j’ai choisi un scénario auquel beaucoup d’entre nous peuvent probablement s’identifier dans le mode de vie actuel, adapté au coronavirus : une application proposant un service en ligne de commande et de livraison de repas de restaurant. Les repas sont commandés en ligne auprès d’un restaurant choisi par le client, et l’utilisateur peut décider de venir récupérer lui-même sa commande ou de la faire livrer par le service.
Dans ce scénario, nous endosserons le rôle de responsable de l’application. À ce titre, nous devons répondre à de nombreuses préoccupations, que nous répartirons en deux catégories : d’une part, les activités opérationnelles indispensables et, d’autre part, les enjeux stratégiques à long terme.
Le premier ensemble — les activités opérationnelles requises — comprend notamment les préoccupations suivantes :
- Trouver et caractériser les restaurants, notamment leur emplacement et leurs horaires d’ouverture
- Regroupement des données sur les plats proposés et leurs prix
- Informer les restaurants des commandes
- Traitement des paiements
- Conservation des données relatives à la disponibilité des ressources humaines pour la collecte et la livraison des commandes
- Suivi de la préparation et de la livraison des commandes
La deuxième série de préoccupations concerne moins les opérations quotidiennes, mais n’en est pas moins importante. Si elles sont prises en compte en amont, ces questions permettront à l’entreprise de gagner en agilité, de s’adapter et de s’améliorer en continu. En voici quelques exemples :
- Comment peut-on prévoir la demande ? Il peut s’agir simplement de la demande globale selon l’heure de la journée ou le jour de la semaine, ou d’une prévision plus détaillée, par exemple pour chaque restaurant.
- Quels types d’outils, de processus ou de flux de travail permettent de fournir à mes fournisseurs (restaurants) des informations utiles à leur activité ?
- Comment les prix, qu’il s’agisse des plats ou de la livraison, peuvent-ils être ajustés de manière dynamique ?
- En supposant que mon application soit hébergée dans le cloud public, comment puis-je optimiser mes coûts d’infrastructure opérationnelle ?
Il ne s’agit bien sûr que d’un sous-ensemble de toutes les problématiques que nous aurions à prendre en compte, mais même cet ensemble plus restreint suffit à alimenter une discussion pertinente qui souligne l’importance d’une architecture de données structurée pour prendre en charge un pipeline de traitement des données extensible.
Architecture des données ou pipeline de données : l’œuf ou la poule
Dans le rôle fictif de responsable d’application, lorsque nous réfléchissons à notre stratégie globale en matière de données, nous pouvons commencer par recenser nos processus métier et déterminer les besoins de chacun en matière de traitement des données. Prenons l’exemple du processus qui repère les restaurants ouverts à proximité, puis affiche les plats proposés et leur prix : il devrait filtrer les restaurants selon leur emplacement et leurs horaires d’ouverture, puis rechercher les plats proposés par un restaurant donné, éventuellement en tenant également compte de la disponibilité des livreurs. Nous pourrions procéder ainsi pour chaque processus : traitement des paiements, mise en relation des livreurs avec les livraisons, etc.
Ou, de manière tout aussi raisonnable, nous pourrions plutôt commencer notre réflexion par les « atomes » de données fondamentaux, c’est-à-dire les éléments constitutifs nécessaires. Nous recenserions les atomes de données importants, en veillant tout particulièrement à ce qu’ils soient représentés de manière uniforme et que leur sémantique soit cohérente, ainsi qu’à définir tout vocabulaire de métadonnées nécessaire à la prise en charge de nos processus métier. Dans notre exemple d’application, les atomes de données comprendraient notamment : les données de localisation des restaurants, des clients et des livreurs ; les produits alimentaires nécessaires aux menus et aux factures ; le temps, utilisé pour le filtrage et le suivi de la qualité des livraisons ; et les informations de paiement, associées aux processus de paiement des clients et des livreurs.
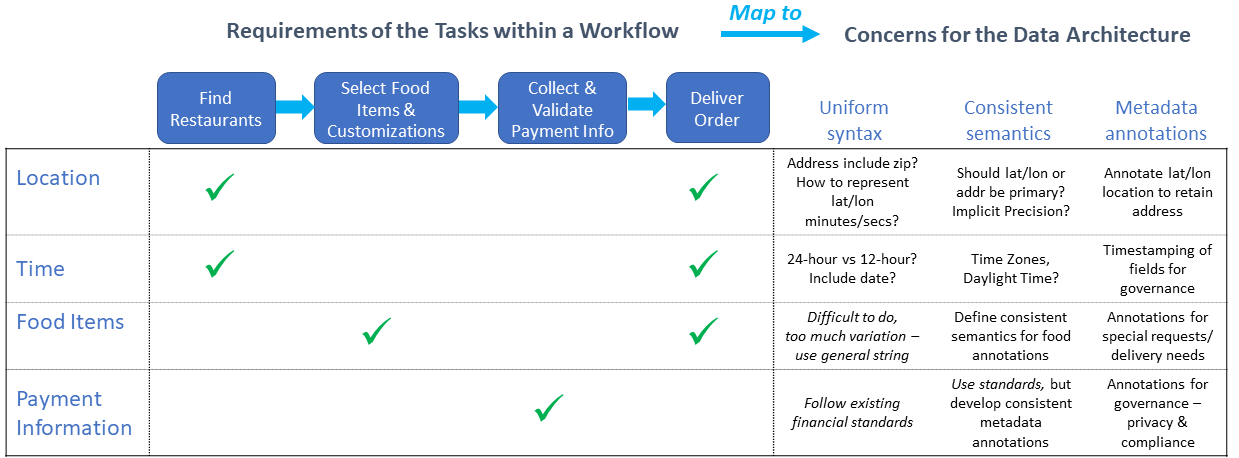
Le choix entre ces deux points de départ possibles pour notre stratégie de données — le pipeline de traitement des données des workflows ou, à l’inverse, les « atomes » de données — revient à se demander qui de la poule ou de l’œuf est apparu en premier. Les deux perspectives sont utiles et, surtout, interdépendantes. Nous ne pouvons pas réfléchir au pipeline de traitement des données sans tenir compte des atomes de données sous-jacents, pas plus que nous ne pouvons concevoir l’architecture des données sans prendre en considération les besoins du pipeline de traitement. Cela étant, je recommanderais généralement une approche consistant à effectuer un premier passage en revue des workflows afin de recenser les atomes de données, puis à aborder la conception structurée de l’architecture des données avant de procéder à la conception détaillée du pipeline de données. En effet, les workflows sont plus dynamiques : ils sont ajoutés et modifiés à mesure que l’entreprise évolue, tandis que les données sous-jacentes ont davantage d’historique et d’inertie. L’architecture des données bénéficie donc davantage d’une réflexion en amont.
Application d’une approche globale de l’architecture et du pipeline de données à des exemples concrets
Revenons à notre exemple et supposons qu’en tant que responsable d’application, nous ayons une vision assez précise des principaux workflows critiques pour l’entreprise et des atomes de données nécessaires à leur prise en charge. Plus tôt dans cette discussion, nous avions identifié certains des éléments de données fondamentaux requis pour nos workflows : le lieu, l’heure, les produits alimentaires et les informations de paiement. Pour récapituler les articles précédents, l’architecture des données doit permettre d’atteindre trois objectifs clés : l’uniformité de la syntaxe, la cohérence de la sémantique et la mise en place d’un vocabulaire de métadonnées permettant d’analyser et de gouverner les données. Nous pouvons maintenant appliquer ces principes afin d’examiner les considérations relatives à l’architecture des données pour les atomes de données spécifiques énumérés dans l’exemple d’aujourd’hui.
En examinant plus en détail l’atome de données « localisation », considérons chacun des trois objectifs clés de l’architecture des données.
- Tout d’abord, quelle est la syntaxe uniforme de représentation des données ?
On pourrait d’abord envisager de représenter un emplacement par une adresse postale, puisque c’est ainsi que les restaurants et les clients indiquent généralement leur emplacement. Toutefois, il faut tenir compte des besoins de localisation liés au suivi des livreurs : ils sont souvent en déplacement, parfois sur une autoroute ou à un endroit difficile à décrire par une adresse postale. L’utilisation de coordonnées de latitude et de longitude peut donc être plus adaptée pour représenter l’emplacement dans ce processus, et ce format conviendrait également aux emplacements des restaurants et des clients. Mais comme les livreurs doivent généralement se rendre dans un restaurant ou chez un client, il doit tout de même être possible de faire le lien entre l’emplacement d’un livreur (latitude/longitude) et celui d’un client (adresse postale). Par conséquent, un choix plus judicieux pourrait consister à normaliser toutes les données de localisation sous forme de coordonnées de latitude et de longitude (la représentation « canonique » requise), tout en permettant de convertir les adresses postales en coordonnées de latitude et de longitude lors de leur saisie initiale (un processus d’« ingestion »). - La deuxième considération concerne la cohérence sémantique.
En supposant que la localisation soit normalisée sous forme de latitude/longitude, cela est relativement simple, car il s’agit d’une norme bien établie dont l’interprétation est sans ambiguïté. Cependant, la cohérence sémantique porte également sur la précision, c’est-à-dire le degré d’exactitude implicite des données. Étant donné que les données GPS et cartographiques ont nécessairement une exactitude limitée, nous pouvons choisir d’indiquer la localisation avec une précision constante (par exemple, à la seconde d’arc près, soit environ 30 mètres) ou avec une précision variable, selon la qualité de la source de données. Si nous retenons cette dernière option pour sa souplesse, nous devons préciser, à l’aide des métadonnées décrites ci-après, la précision de chaque donnée de localisation. - Le troisième objectif de l’architecture des données est de permettre d’annoter et enrichir les éléments de données collectés.
Dans le cas de la localisation, cela peut inclure la précision des données, comme indiqué précédemment. Nous pouvons également vouloir annoter la localisation avec une adresse postale afin de la rendre plus compréhensible, et surtout de préserver les données d’adresse importées. Cela est particulièrement important lorsque plusieurs adresses postales peuvent correspondre aux mêmes coordonnées de latitude et de longitude, comme dans le cas d’un complexe résidentiel. Un autre enrichissement possible consiste à ajouter un horodatage indiquant le moment où les données de localisation ont été collectées, ce qui peut être pertinent pour un conducteur en déplacement, car ces données deviennent rapidement obsolètes.
Nous n’avons jusqu’ici abordé que les exigences relatives à la localisation et nous pourrions maintenant procéder à une analyse similaire pour chacun des autres champs de données. Toutefois, plutôt que d’énumérer tous les points à prendre en compte pour chacun des éléments de données, je vais mettre en évidence quelques observations notables :
- Concernant l’atome de données « Temps » : la représentation d’une valeur temporelle est notoirement complexe. Elle peut varier tant sur le plan syntaxique (par exemple, format sur 24 heures ou format sur 12 heures avec AM/PM) que sur le plan sémantique (par exemple, la notion de fuseau horaire et les variations liées à l’application de l’heure d’été). La représentation du temps devra donc probablement être normalisée (par exemple, en la convertissant en GMT ou, pour les utilisateurs d’Unix/Linux, en secondes écoulées « depuis l’époque Unix »).
- Produit alimentaire : les instances de données peuvent être très variées et présenter des besoins spécifiques. Comme ces atomes de données sont souvent de forme libre, un vocabulaire canonique de métadonnées est plus utile que de chercher à uniformiser la syntaxe. Certains champs de métadonnées décriraient des propriétés statiques propres à chaque produit, telles que « doit rester au froid » ou « contient des fruits à coque », tandis que d’autres seraient nécessaires pour fournir des informations propres à chaque instance (chaque commande), telles que le « niveau de piquant » ou les « condiments souhaités ». Dans les deux cas, l’objectif de conception exige une syntaxe uniforme et une sémantique cohérente pour les champs de métadonnées, afin qu’ils puissent être utilisés pour l’ensemble des produits proposés au menu.
- La conformité et la gouvernance des données constituent d’autres considérations essentielles. L’un des aspects concerne la politique de conservation des données, selon laquelle certains champs, tels que l’adresse IP d’un client ou l’historique de localisation d’un livreur, ne peuvent être conservés que pendant une courte période. Une autre considération courante tient au fait que certains champs peuvent être soumis à des contraintes de sécurité ou de confidentialité, comme les informations de paiement. L’enrichissement par des métadonnées permet de répondre à ces deux problématiques. Les métadonnées doivent servir à associer à une adresse IP ou à une donnée de localisation une date d’expiration aux fins de conservation des données. Dans le cas des informations de paiement, elles peuvent servir à indiquer des exigences de sécurité, telles que la nécessité de chiffrer les données au repos, ou à préciser les contraintes de géolocalisation du stockage persistant des données.
Bien que cet exemple n’ait fait qu’effleurer le sujet, il a mis en évidence bon nombre des problématiques propres aux situations réelles. Dans la pratique, toutefois, la réflexion sur la stratégie de données ne s’arrêterait pas là : elle s’inscrirait dans un processus itératif et continu. À mesure que les éléments de données alimenteraient les pipelines de traitement des données qui mettent en œuvre les workflows métier, l’architecture des données ferait l’objet d’ajustements et d’améliorations successifs. À mesure que les workflows existants seraient améliorés et que de nouveaux seraient ajoutés, nous découvririons de nouvelles exigences en matière d’architecture des données, tant pour les atomes de données existants que pour les nouveaux.
Réflexions finales
Bien que cet exemple ait été simplifié par souci de concision, il illustre néanmoins les principes clés de la mise en correspondance des flux de travail avec leurs implications sur l’architecture des données. Le processus commence toujours par la prise en compte des besoins de l’entreprise : l’expérience client et les processus métier nécessaires pour répondre à ces besoins. Ces processus métier définissent à leur tour les éléments d’un vocabulaire métier. À un niveau de détail supérieur, les processus sont associés à un pipeline de données qui s’appuie sur un vocabulaire de données.
Le principe clé est qu’une architecture de données robuste — qui définit la syntaxe, la sémantique et les annotations — établit une base permettant d’améliorer efficacement le pipeline de données et d’ajouter facilement de nouveaux workflows. Au niveau d’abstraction de la couche métier, cela signifie que les processus métier existants peuvent être aisément modifiés et que les processus métier nouveaux ou émergents peuvent être rapidement mis en service. À l’inverse, l’absence de décisions mûrement réfléchies dans l’un de ces domaines — vocabulaire des données, cadre d’architecture des données ou mise en adéquation de ces éléments avec les besoins métier — aboutira inévitablement à un système rigide et fragile, incapable de s’adapter avec agilité aux nouvelles exigences métier.
À propos de l’auteur
Articles de blog associés

Pourquoi devriez-vous vous intéresser à WebAssembly ?
WebAssembly (Wasm) est un jeu d’instructions binaires portable, rapide et sécurisé, qui permet d’exécuter des applications hautes performances sur n’importe quelle plateforme.

Trois choses à savoir sur les applications d’IA
Les applications d’IA sont des applications modernes, mais elles présentent certaines particularités. Découvrez les points essentiels à connaître sur les applications basées sur l’IA.
État des lieux de la stratégie applicative 2022 : il est temps de moderniser les opérations
Il est devenu évident que, pour maintenir la dynamique de leur transformation numérique, les organisations doivent recentrer leurs efforts sur les fonctions métier. Si les expériences destinées aux clients restent prioritaires, il est également indispensable de permettre la numérisation de fonctions telles que les services juridiques, les ressources humaines et la finance. Les DSI prennent donc les commandes, tandis que la transformation numérique passe de la modernisation des applications à celle des opérations.
Clouds multiples ou multicloud : faciliter la transition
La gestion et la sécurisation des charges de travail deviennent complexes à mesure que les entreprises adoptent une stratégie de cloud connecté. Découvrez comment F5 répond au besoin d’une nouvelle approche de la mise en réseau multicloud.
L’expérience client dépend de la visibilité
Une enquête menée par Dimensional Research auprès de plus de 3 000 utilisateurs d’applications mobiles a confirmé ce que beaucoup d’entre nous pensent des attentes actuelles des clients.
Transformation numérique et explosion du portefeuille d’applications
La transformation numérique stimule la croissance des portefeuilles d’applications et modifie la manière dont celles-ci sont développées, déployées, intégrées et, en définitive, utilisées.